损失函数
损失函数(loss function),也称为代价函数(cost function)、目标函数(objective function)、误差函数(error function)
作用
|作用|说明|
| ----------| ----------------------------------|
|评估性能|反映模型预测与真实值的匹配程度|
|指导优化|通过梯度下降最小化损失,优化参数|
衡量方式:比较网络输出和真实输出的差异
分类任务 损失函数
多分类任务 损失函数
实现:CrossEntropyLoss()
在多分类任务通常使用softmax将logits转换为概率的形式,故:多分类的交叉熵损失也叫做softmax损失,它的计算方法是:
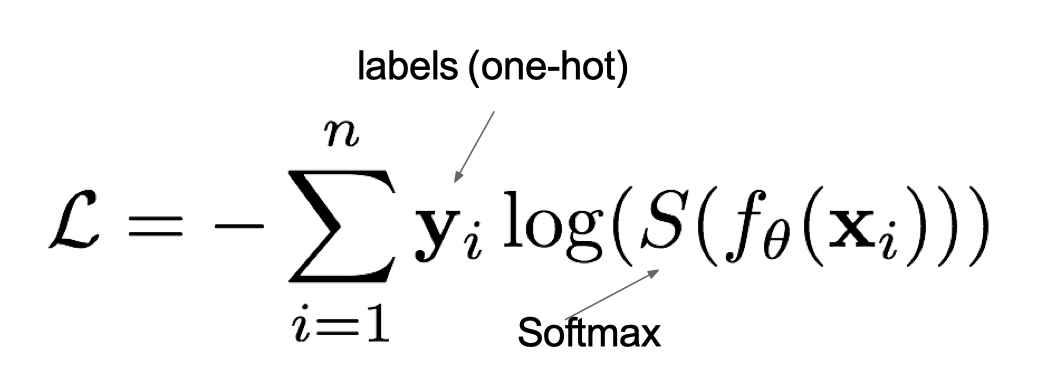
多分类交叉熵损失 = softmax() + 损失计算
是样本 属于某一个类别的真实概率
是样本属于某一类别的预测分数(加权求和)
是softmax激活函数,将属于某一类别的预测分数转换成概率
用来衡量真实值 和预测值 之间差异性的损失结果
例子:
交叉损失为:
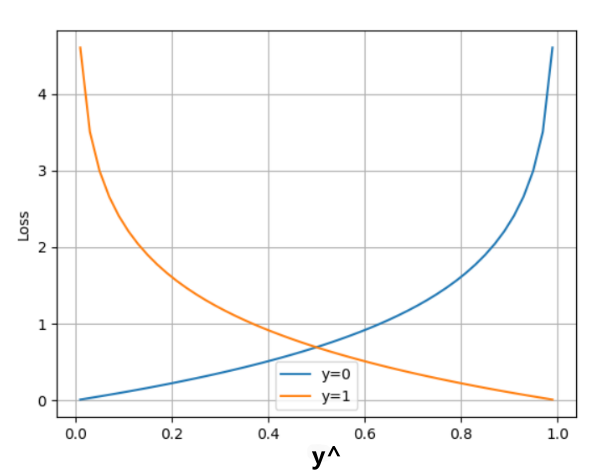
从概率角度理解,我们的目的是最小化正确类别所对应的预测概率的对数的负值(损失值最小),如下图所示:
二分类任务 损失函数
实现:BCELoss()
在处理二分类任务时,我们不再使用softmax激活函数,而是使用sigmoid激活函数,那损失函数也相应的进行调整,使用二分类的交叉熵损失函数:
其中:
是样本 属于某一类别的真实概率(0或1),是真实标签
是样本 属于某一类别的预测概率(经过sigmoid激活,范围在0到1之间)
是用来衡量真实值 与预测值 之间差异性的损失结果
回归任务 损失函数
MAE 损失函数
实现:L1Loss()
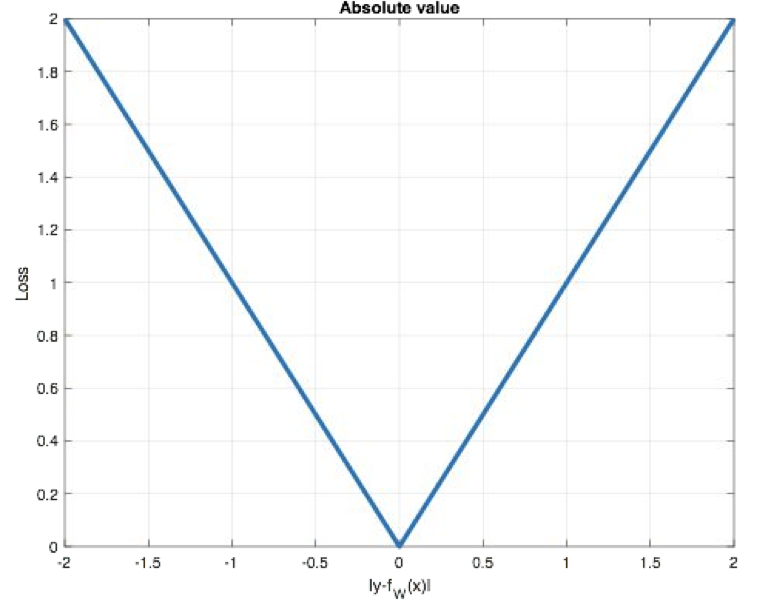
Mean absolute loss(MAE)也称为 L1 loss,是以绝对误差和的均值作为距离。
其中:
- 为真实值, 为预测值
特点:
- 由于 L1 loss 具有稀疏性,为了惩罚较大的值,因此常常将其作为正则项添加到其他 loss 中作为 约束
- L1 loss 的最大问题:梯度在零点不平滑,导致会跳过极小值
- 适用于回归问题中存在异常值或噪声数据时,可以减少对离群点的敏感性
MSE 损失函数
实现:MSELoss()
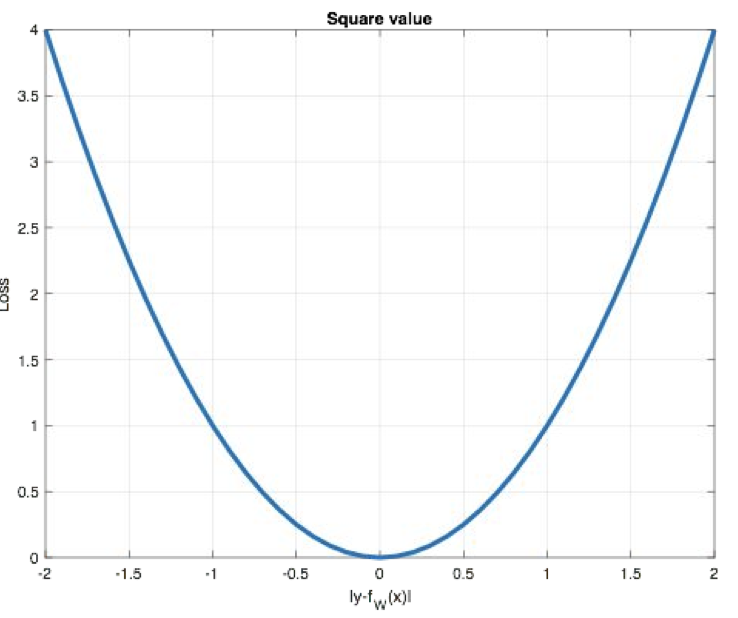
Mean Squared Loss / Quadratic Loss(MSE loss)也被称为 L2 loss、欧氏距离,它以误差的平方和的均值作为距离。
特点:
- L2 loss也常常作为正则项,对于离群点(outliers)敏感,因为平方项会放大大误差
- 当预测值与目标值相差很大时, 梯度容易爆炸
梯度爆炸:网络层之间的梯度(值大于1.0)重复相乘导致的指数级增长会产生梯度爆炸
- 适用于大多数标准回归问题,如房价预测、温度预测等
Smooth L1损失函数
实现:SmoothL1Loss()
smooth L1说的是光滑之后的L1,是一种结合了均方误差(MSE)和平均绝对误差(MAE)优点的损失函数。它在误差较小时表现得像 MSE,在误差较大时则更像 MAE。
特点是:
- 对离群点更加鲁棒:当误差较大时,损失函数会线性增加(而不是像MSE那样平方增加),因此它对离群点的惩罚更小,避免了MSE对离群点过度敏感的问题
- 计算梯度时更加平滑:与MAE相比,Smooth L1在小误差时表现得像MSE,避免了在训练过程中因使用绝对误差而导致的梯度不连续问题
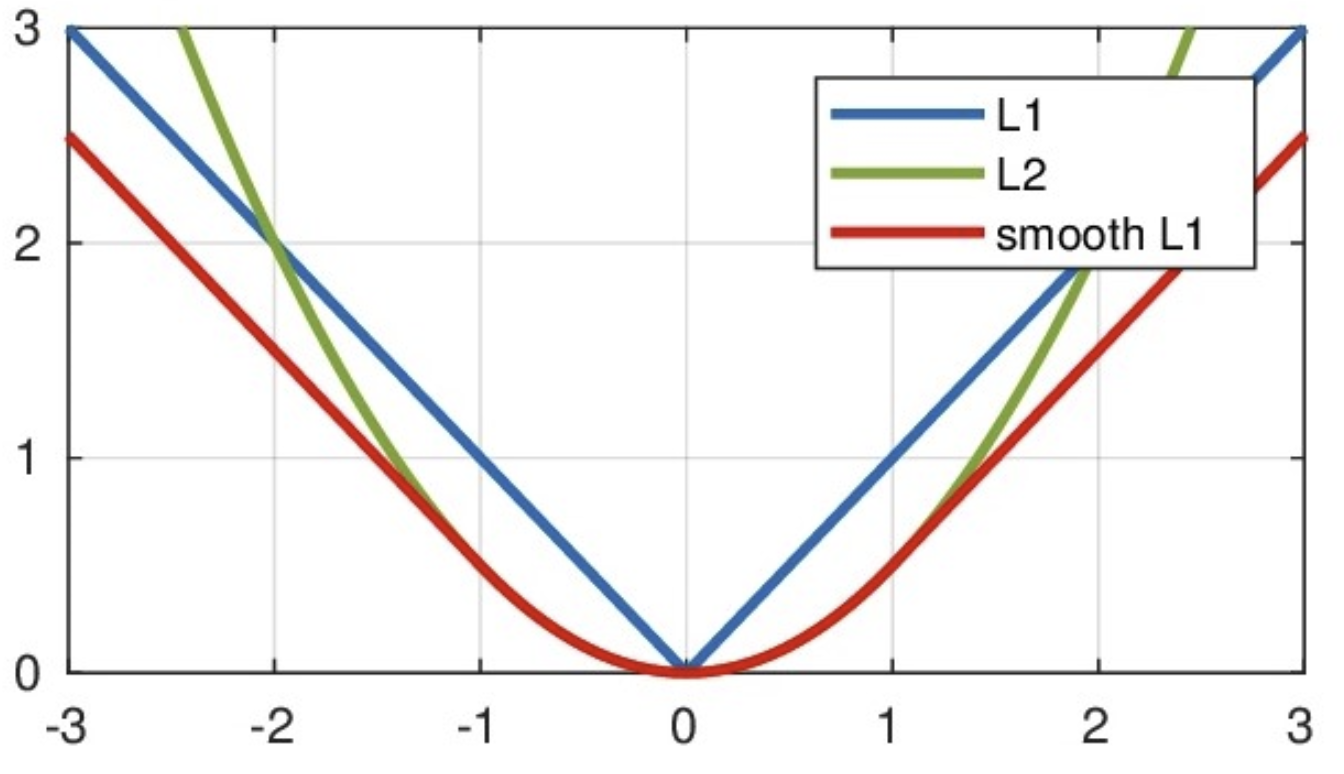
从上图中可以看出,该函数实际上就是一个分段函数
在 之间实际上就是 L2损失,这样解决了 L1的不光滑问题
在 区间外,实际上就是 L1损失,这样就解决了 离群点梯度爆炸的问题
代码示例
import torch


from torch import nn
CrossEntropyLoss()
原理:多分类任务 损失函数
'''多分类交叉熵损失'''


# 设置真实值


y_true = torch.tensor([1, 2], dtype=torch.int64)


# 设置预测值


y_pred = torch.tensor([[0.2, 0.6, 0.2],


                       [0.1, 0.8, 0.1]], requires_grad=True)


# 实例化交叉熵损失,默认求平均损失(源码:reduction: str = 'mean')


loss = nn.CrossEntropyLoss()


# 计算损失结果


loss1 = loss(y_pred, y_true)


loss2 = loss(y_pred, y_true).detach().numpy()


print('loss1:', loss1) # loss1: tensor(1.1201, grad_fn=<NllLossBackward0>)


print('loss2:', loss2) # loss2: 1.1200755
BCELoss()
原理:二分类任务 损失函数
# 设置真实值


y_true = torch.tensor([0, 1, 0], dtype=torch.float32)


# 设置预测值,预测值是sigmoid输出的结果


y_pred = torch.tensor([0.6901, 0.5459, 0.2469], requires_grad=True)


# 实例化二分类交叉熵损失


loss = nn.BCELoss()


# 计算损失


my_loss = loss(y_pred, y_true).detach().numpy()


print('loss:', my_loss)
L1Loss()
原理:MAE 损失函数
# 设置真实值和预测值


y_pred = torch.tensor([1.0, 1.0, 1.9], requires_grad=True)


y_true = torch.tensor([2.0, 2.0, 2.0], dtype=torch.float32)


# 实例MAE损失对象


loss = nn.L1Loss()


# 计算损失


my_loss = loss(y_pred, y_true).detach().numpy()


print('loss:', my_loss)
MSELoss()
原理:MSE 损失函数
# 设置真实值和预测值


y_pred = torch.tensor([1.0, 1.0, 1.9], requires_grad=True)


y_true = torch.tensor([2.0, 2.0, 2.0], dtype=torch.float32)


# 实例MSE损失对象


loss = nn.MSELoss()


# 计算损失


my_loss = loss(y_pred, y_true).detach().numpy()


print('myloss:', my_loss)
SmoothL1Loss()
原理:Smooth L1损失函数
# 设置真实值和预测值


y_true = torch.tensor([0, 3])


y_pred = torch.tensor([0.6, 0.4], requires_grad=True)


# 实例smmothL1损失对象


loss = nn.SmoothL1Loss()


# 计算损失


my_loss = loss(y_pred, y_true).detach().numpy()


print('loss:', my_loss)
训练流程基础
核心概念
|概念|定义|说明|
| ------| ----------| ------------------------------|
|Epoch|训练轮次|使用全部数据完成一次完整训练|
|Batch Size|批次大小|每次反向传播使用的样本数量|
|Iteration|迭代次数|完成一个 Batch 的训练次数|
关系计算
样本总数:1000


Batch Size:100


每 Epoch 的 Iteration = 1000 ÷ 100 = 10 次


总 Iteration(Epoch=2) = 2 × 10 = 20 次
反向传播
前向传播(Feedforward):数据输入到神经网络中,逐层向前传输,一直运算到输出层为止
反向传播(Back Propagation,BP):利用损失函数 ERROR值,从后往前,结合梯度下降算法,依次求各个参数的偏导,并进行参数更新
|传播方向|说明|
| ----------------------| --------------------------------------------------|
|前向传播(Feedforward)|数据从输入层→隐藏层→输出层,计算预测值|
|反向传播(Back Propagation)|从输出层→输入层,利用链式法则计算梯度,更新参数|
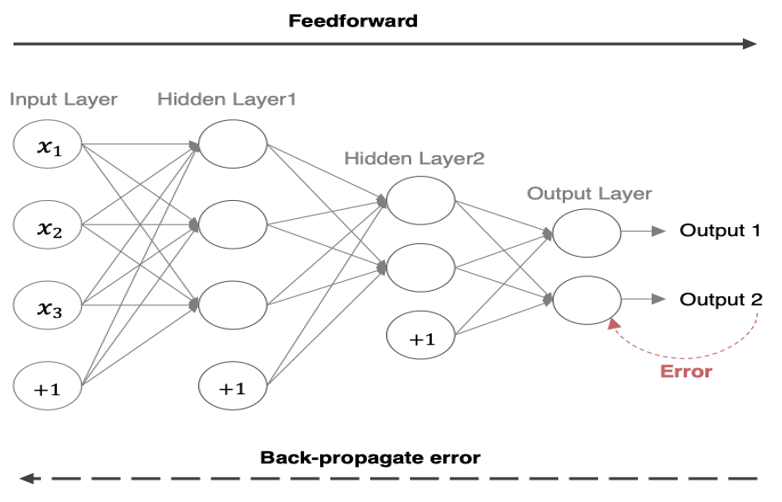
反向传播算法利用链式法则对神经网络中的各个节点的权重进行更新
链式法则:
参数更新:
:学习率
:损失、对权重的梯度
用一个简单的神经网络来举例(激活函数:sigmoid)
- 前向传播运算过程
- h1 的线性加权求和与非线性激活:
$net_{h1} = w_1 * i_1 + w_2 * i_2 + b_1 * 1 \\ net_{h1} = 0.15 * 0.05 + 0.2 * 0.1 + 0.35 * 1 = 0.3775 \\ out_{h1} = \frac{1}{1+e^{-net_{h1}}} = \frac{1} {1+e^{-0.3775}} = 0.593269992$
同理求 h2:$out_{h2} = 0.596884378$
- o1 的线性加权求和与非线性激活:
$net_{o1} = w_5 * out_{h1} + w_6 * out_{h2} + b_2 * 1 \\ net_{o1} = 0.4 * 0.593269992 + 0.45 * 0.596884378 + 0.6 * 1 = 1.105905967 \\ out_{o1} = \frac{1}{1+e^{-net_{o1}}} = \frac{1}{1+e^{-1.105905967}} = 0.75136507$
同理求 o2:$out_{o2} = 0.772928465$
- 计算损失值(均方误差,MSE)
$E_{total} = \sum \frac{1}{2}(target - output)^2 \\ E_{total} = E_{o1} + E_{o2} = \frac{1}{2} (target_{o1} - output_{o1})^2 + \frac{1}{2} (target_{o2} - output_{o2})^2 \\ = \frac{1}{2} (0.01 - 0.75136507)^2 + \frac{1}{2} (0.99 - 0.772928465)^2 \\ = 0.274811083 + 0.023560026 = 0.298371109 $
- 反向传播运算过程
- 求误差E对 的导数
先求误差E对out o1的导数,再求out o1对net o1的导数,最后再求 net o1对w5的导数
$$
\frac{\partial net_{o1}}{\partial w_5} * \frac{\partial out_{o1}}{\partial net_{o1}} * \frac{\partial E_{total}}{\partial out_{o1}} = \frac{\partial E_{total}}{\partial w_5}
$$
- 误差E对out o1的导数
$\begin{aligned} \frac{\partial E_{total}}{\partial out_{o1}} &= 2 * \frac{1}{2}(target_{o1} - out_{o1})^{2-1} * -1 + 0 \\ &= -(target_{o1} - out_{o1}) \\ &= -(0.01 - 0.75136507) \\ &= 0.74136507 \end{aligned}$
- out o1对net o1的导数
$\frac{\partial out_{o1}}{\partial net_{o1}} = out_{o1}(1 - out_{o1}) = 0.75136507(1 - 0.75136507) = 0.186815602$
- net o1对$w_5$的导数
$\frac{\partial net_{o1}}{\partial w_5} = 1 * out_{h1} * w_5^{(1-1)} + 0 + 0 = out_{h1} = 0.593269992$
- 误差E对$w_5$的导数
$\frac{\partial E_{total}}{\partial w_5} = 0.74136507 * 0.186815602 * 0.593269992 = 0.082167041$
- 参数更新
$w_5^+ = w_5 - \eta * \frac{\partial E_{total}}{\partial w_5} = 0.4 - 0.5 * 0.082167041 = 0.35891648$
- 同理,更新 ** **
$w_6^+ = 0.408666186 \\ w_7^+ = 0.511301270 \\ w_8^+ = 0.561370121$
- 求误差E对 的导数,并更新
$\frac{\partial E_{total}}{\partial w_1} = \frac{\partial E_{total}}{\partial out_{h1}} * \frac{\partial out_{h1}}{\partial net_{h1}} * \frac{\partial net_{h1}}{\partial w_1}$
$\frac{\partial E_{total}}{\partial w_1} = \left(\sum_{o} \frac{\partial E_{total}}{\partial out_o} * \frac{\partial out_o}{\partial net_o} * \frac{\partial net_o}{\partial out_{h1}}\right) * \frac{\partial out_{h1}}{\partial net_{h1}} * \frac{\partial net_{h1}}{\partial w_1} \\ w_1^+ = w_1 - \eta * \frac{\partial E_{total}}{\partial w_1} = 0.15 - 0.5 * 0.000438568 = 0.149780716$
神经网络 优化算法
梯度下降算法
算法思想:寻找使损失函数最小的方法
在深度学习中,梯度下降的几种方式的根本区别就在于 Batch Size 不同
|梯度下降方式|Training Set Size|Batch Size|Number of Batches|
| -----------------------------| ----------------------------------| ---------------------------| ----------------------------------|
|BGD(批量梯度下降)|N|N|1|
|SGD(随机梯度下降)|N|1|N|
|Mini-Batch(小批量梯度下降)|N|B| |
梯度下降 优化算法
梯度下降优化算法中,可能会碰到以下情况:
碰到平缓区域,梯度值较小,参数优化变慢
碰到 “鞍点” ,梯度为0,参数无法优化
碰到局部最小值,参数不是最优
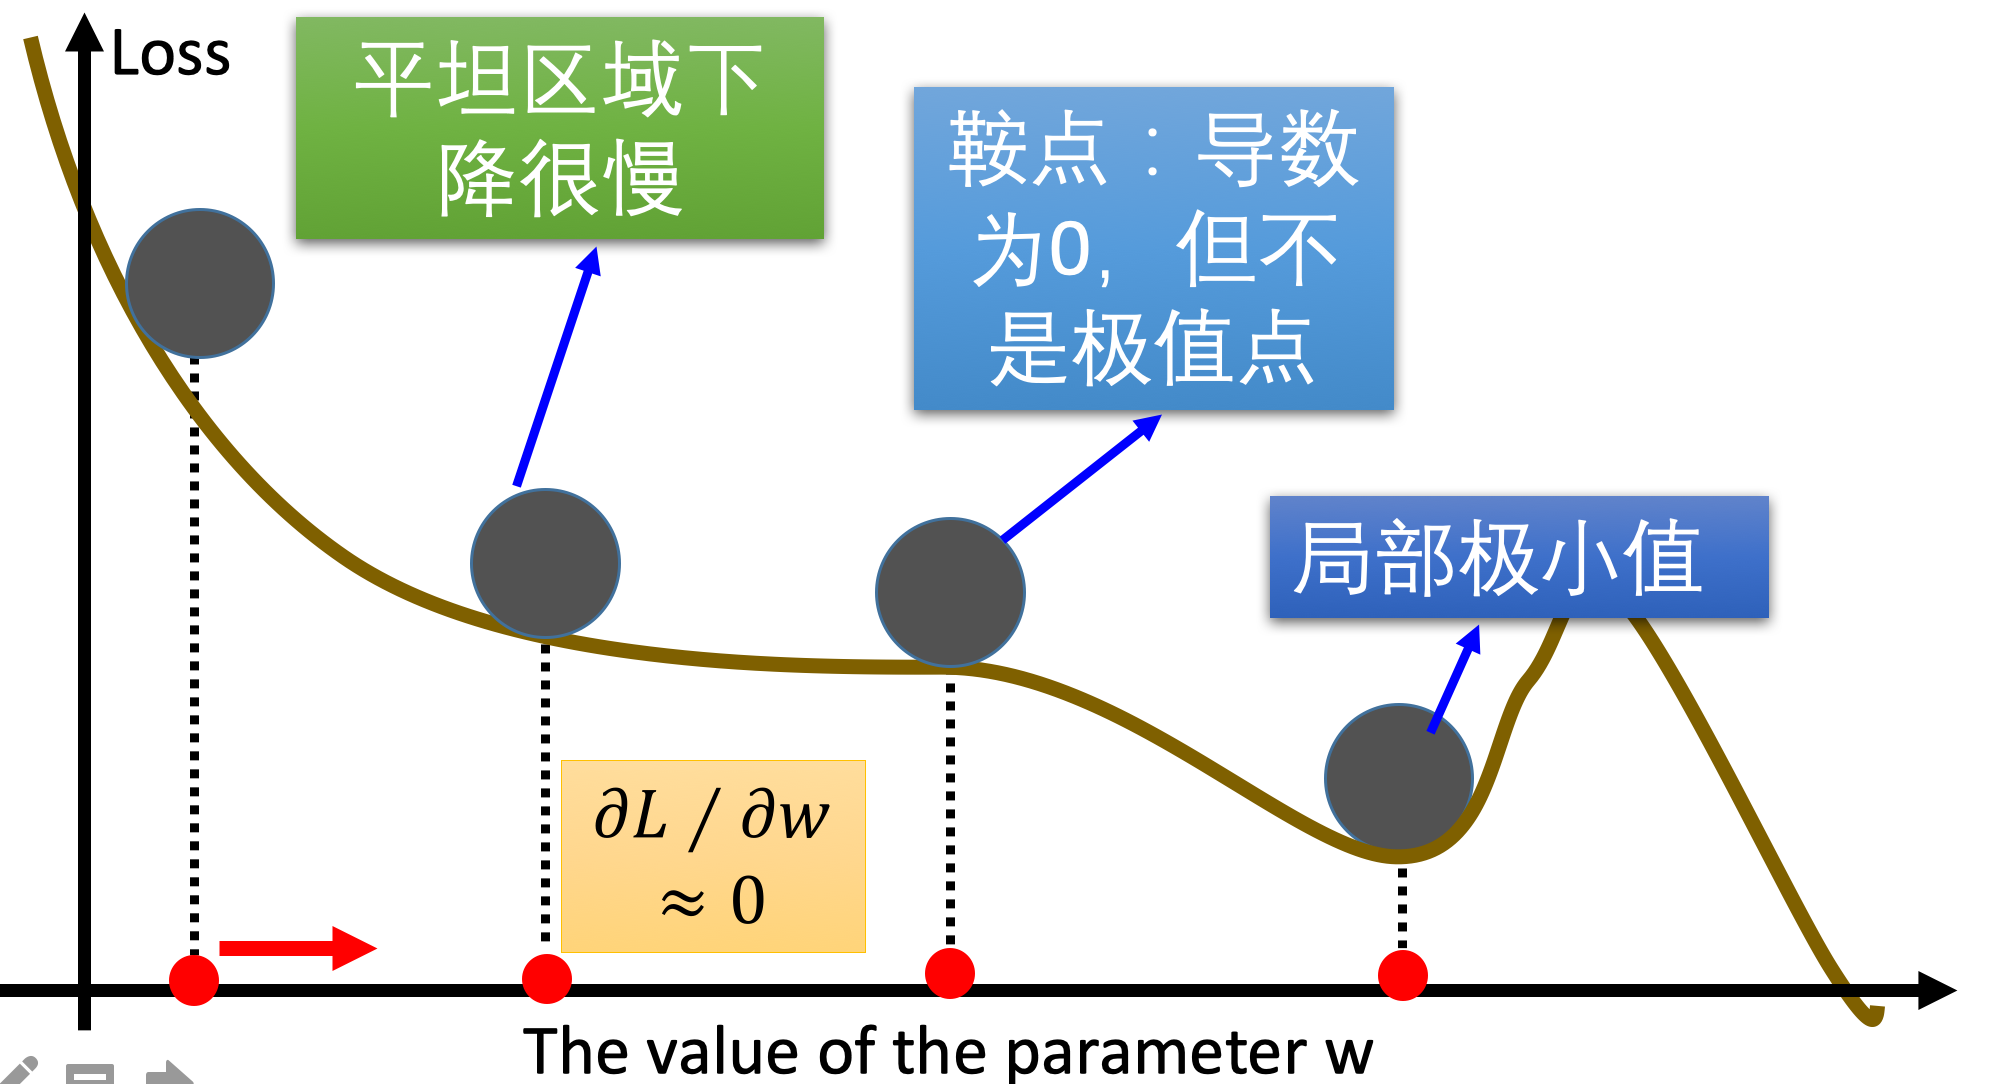
对于这些问题, 出现了一些对梯度下降算法的优化方法,例如:Momentum、AdaGrad、RMSprop、Adam 等
指数移动加权平均
用于平滑当前时刻的数据(如梯度),通过累积历史信息来减少震荡,从而加速收敛并提升优化过程的稳定性
不是梯度下降优化方法,是 Momentum、AdaGrad、RMSprop、Adam 底层公式要用到的
- 算数平均:将所有数加起来除以数的个数,每个数的权重是相同的。
- 指数加权平均:给每个数赋予不同的权重求得平均数。
- 移动平均数:计算最近邻的 N 个数来获得平均数。
指数移动加权平均则是参考各数值,并且各数值的权重都不同,距离越远的数字对平均数计算的贡献就越小(权重较小),距离越近则对平均数的计算贡献就越大(权重越大)。
比如:明天气温怎么样,和昨天气温有很大关系,而和一个月前的气温关系就小一些。
当前的平滑值 = 大部分的上一步平滑值 + 小部分的当前真实值
:当前时刻 t 的指数加权平均值(即平滑后的值)
:当前时刻 t 的真实观测值
β:权重衰减系数(或平滑因子)( ),控制历史数据的权重衰减速度。该值越大平均数越平缓,对当前梯度影响越小,历史信息保留得越久。
第100天的指数加权平均值为:
第100填的指数加权平均值由 相加而成,前边系数越来越小,离100天越近的系数越大,离100天越远的系数越小
当 t=0 时,EMA初始化为第一个观测值
当 t>0 时,当前EMA值由前一时刻的EMA值和当前观测值加权平均得到
【测试】下面通过代码来看结果,随机产生 30 天的气温数据:
- 代码
python
import torch
import matplotlib.pyplot as plt
ELEMENT_NUMBER = 30
1. 实际平均温度
def tes01():
# 固定随机数种子
torch.manual_seed(0)
# 产生30天的随机温度
temperature = torch.randn(size=[ELEMENT_NUMBER,]) * 10
print(temperature)
# 绘制平均温度
days = torch.arange(1, ELEMENT_NUMBER + 1, 1)
plt.plot(days, temperature, color='r')
plt.scatter(days, temperature)
plt.show()
2. 指数加权平均温度
def tes02(beta=0.9):
# 固定随机数种子
torch.manual_seed(0)
# 产生30天的随机温度
temperature = torch.randn(size=[ELEMENT_NUMBER,]) * 10
print(temperature)
exp_weight_avg = []
# idx从1开始
for idx, temp in enumerate(temperature, 1):
# 第一个元素的 EWA 值等于自身
if idx == 1:
exp_weight_avg.append(temp)
continue
# 第二个元素的 EWA 值等于上一个 EWA 乘以 β + 当前气温乘以 (1-β)
# idx-2:2-2=0,exp_weight_avg列表中第一个值的下标值
new_temp = exp_weight_avg[idx - 2] * beta + (1 - beta) * temp
exp_weight_avg.append(new_temp)
days = torch.arange(1, ELEMENT_NUMBER + 1, 1)
plt.plot(days, exp_weight_avg, color='r')
plt.scatter(days, temperature)
plt.show()
if name == 'main':
tes01() # 权重一致,不考虑权重系数
tes02(0.5)
tes02(0.9)
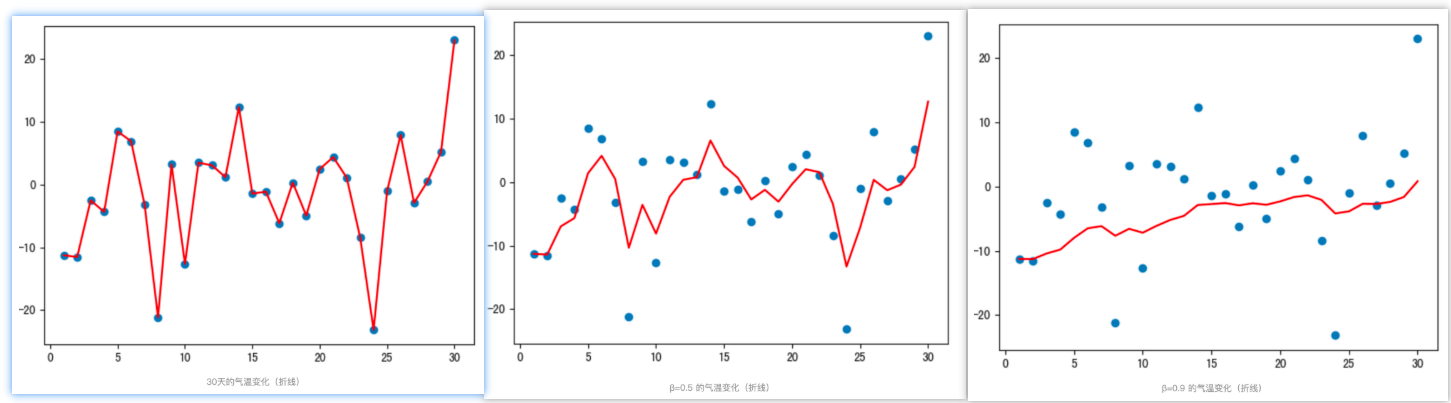
从程序运行结果可以看到:
- 指数加权平均绘制出的气温变化曲线更加平缓
- β 的值越大,则绘制出的折线==越加平缓,波动越小==(1-β越小,t时刻的 越不依赖 的值)
- β 值一般默认都是 0.9
动量算法 Momentum
梯度计算公式:
:当前时刻指数加权平均梯度值
:历史指数加权平均梯度值
:当前时刻的梯度值
:调节权重系数,通常取 0.9 或 0.99
参数更新公式:
:学习率
:当前时刻模型权重参数
例子,假设:权重 β 为 0.9,例如:
第一次梯度值:
第二次梯度值:
第三次梯度值:
第四次梯度值:
梯度下降公式中梯度的计算,就不再是当前时刻t的梯度值,而是历史梯度值的指数移动加权平均值。
Monmentum 优化方法是如何一定程度上克服 “平缓”、”鞍点”、”峡谷” 的问题呢?
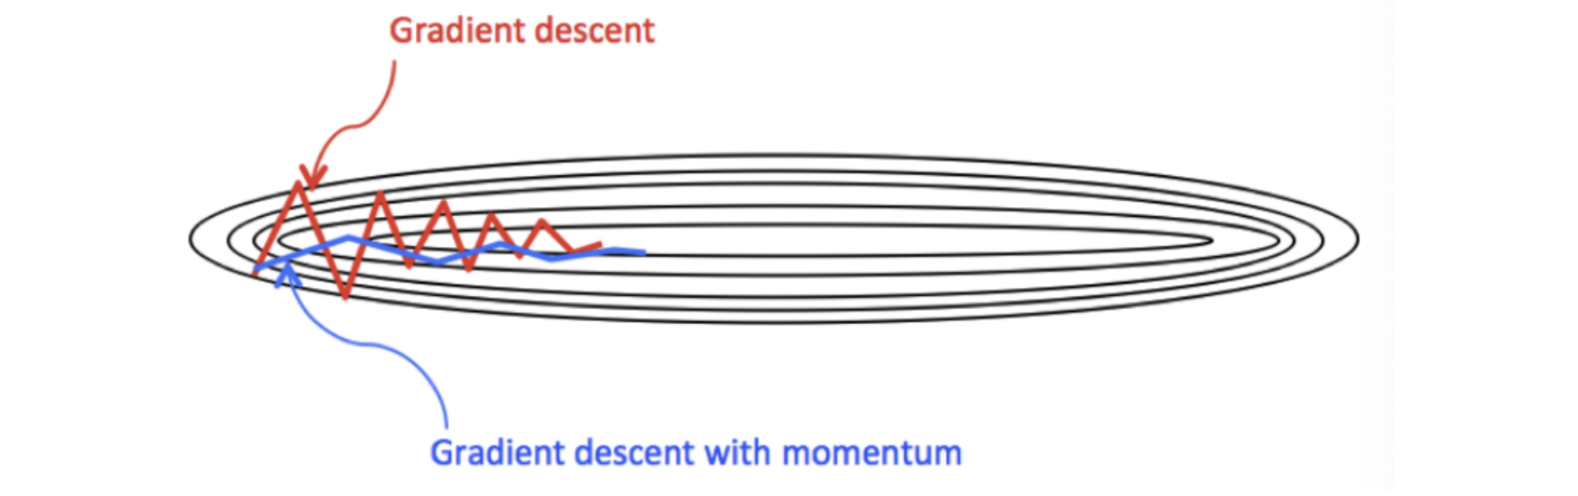
- 当处于鞍点位置时,由于当前的梯度为 0,参数无法更新。但是 Momentum 动量梯度下降算法已经在先前积累了一些梯度值,很有可能使得跨过鞍点。
- 由于 mini-batch 普通的梯度下降算法,每次选取少数的样本梯度确定前进方向,可能会出现震荡,使得训练时间变长。Momentum 使用移动加权平均,平滑了梯度的变化,使得前进方向更加平缓,有利于加快训练过程。一定程度上有利于降低 “峡谷” 问题的影响。
API
python# 随机梯度下降(SGD)优化器,momentum=0.9 添加动量项,可以加速收敛并减少震荡 optim.SGD(params=[w], lr=0.01, momentum=0.9)在pytorch中动量梯度优化法编程实践如下:
pythonimport torch import torch.nn as nn import torch.optim as optim def momentum_method(): # 1 初始化权重参数 w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32) loss = ((w ** 2) / 2.0).sum() # 2 实例化优化方法:SGD 指定参数beta=0.9 optimizer = optim.SGD(params=[w], lr=0.01, momentum=0.9) # 3 第1次更新 计算梯度:梯度清零+反向传播+参数更新 optimizer.zero_grad() loss.backward() optimizer.step() print('第1次: 梯度w.grad: %f, 更新后的权重:%f' % (w.grad.numpy(), w.detach().numpy())) # 4 第2次更新 计算梯度,并对参数进行更新 # 使用更新后的参数机选输出结果 loss = ((w ** 2) / 2.0).sum() optimizer.zero_grad() loss.backward() optimizer.step() print('第2次: 梯度w.grad: %f, 更新后的权重:%f' % (w.grad.numpy(), w.detach().numpy()))结果显示:
python第1次: 梯度w.grad: 1.000000, 更新后的权重:0.990000 第2次: 梯度w.grad: 0.990000, 更新后的权重:0.971100
自适应学习率 AdaGrad
AdaGrad(Adaptive Gradient Estimation) 通过对不同的参数分量使用不同的学习率,AdaGrad 的学习率总体会逐渐减小
学习率总体会逐渐减小是因为 AdaGrad 认为:在起初时,我们距离最优目标仍较远,可以使用较大的学习率,加快训练速度,随着迭代次数的增加,学习率逐渐下降。
其计算步骤如下:
初始化学习率 η、初始化参数w、小常数
初始化梯度累计变量 s = 0
从训练集中采样 m 个样本的小批量,计算梯度
累积平方梯度: , 表示各个分量相乘
学习率 η 的计算公式如下:
权重参数更新公式如下:
重复 3-7 步骤
AdaGrad 缺点:可能会使得学习率过早、过量的降低,导致模型训练后期学习率太小,较难找到最优解。
在PyTorch中AdaGrad优化法编程实践如下:
pythonimport torch import torch.nn as nn import torch.optim as optim def adaGrad_method(): # 1 初始化权重参数 w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32) loss = ((w ** 2) / 2.0).sum() # 2 实例化优化方法:adagrad优化方法 optimizer = optim.Adagrad(params=[w], lr=0.01) # 3 第1次更新 计算梯度,并对参数进行更新 optimizer.zero_grad() loss.backward() optimizer.step() print('第1次: 梯度w.grad: %f, 更新后的权重:%f' % (w.grad.numpy(), w.detach().numpy())) # 4 第2次更新 计算梯度,并对参数进行更新 # 使用更新后的参数机选输出结果 loss = ((w ** 2) / 2.0).sum() optimizer.zero_grad() loss.backward() optimizer.step() print('第2次: 梯度w.grad: %f, 更新后的权重:%f' % (w.grad.numpy(), w.detach().numpy()))结果显示:
python第1次: 梯度w.grad: 1.000000, 更新后的权重:0.990000 第2次: 梯度w.grad: 0.990000, 更新后的权重:0.982965
自适应学习率 RMSProp
RMSProp(Root Mean Square Propagation) 优化算法是对 AdaGrad 的优化。最主要的不同是,其使用指数加权平均梯度替换历史梯度的平方和。对梯度的累积方式不同,对于每个梯度分量仍然使用不同的学习率。
其计算步骤如下:
初始化学习率 η、初始化参数w、小常数
初始化梯度累计变量 s = 0
从训练集中采样 m 个样本的小批量,计算梯度
使用指数加权平均累计历史梯度, 表示各个分量相乘,公式如下:
学习率 η 的计算公式如下:
权重参数更新公式如下:
重复 3-7 步骤
RMSProp 通过引入衰减系数β,控制历史梯度对历史梯度信息获取的多少,被证明在神经网络非凸条件下的优化更好,学习率衰减更加合理一些。
需要注意的是:AdaGrad 和 RMSProp 都是对于不同的参数分量使用不同的学习率,如果某个参数分量的梯度值较大,则对应的学习率就会较小,如果某个参数分量的梯度较小,则对应的学习率就会较大一些。
在PyTorch中RMSprop梯度优化法,编程实践如下:
pythonimport torch import torch.nn as nn import torch.optim as optim def rmsprop_method(): # 1 初始化权重参数 w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32) loss = ((w ** 2) / 2.0).sum() # 2 实例化优化方法:RMSprop算法,其中alpha对应beta optimizer = optim.RMSprop(params=[w], lr=0.01, alpha=0.9) # 3 第1次更新 计算梯度,并对参数进行更新 optimizer.zero_grad() loss.backward() optimizer.step() print('第1次: 梯度w.grad: %f, 更新后的权重:%f' % (w.grad.numpy(), w.detach().numpy())) # 4 第2次更新 计算梯度,并对参数进行更新 # 使用更新后的参数机选输出结果 loss = ((w ** 2) / 2.0).sum() optimizer.zero_grad() loss.backward() optimizer.step() print('第2次: 梯度w.grad: %f, 更新后的权重:%f' % (w.grad.numpy(), w.detach().numpy()))结果显示:
python第1次: 梯度w.grad: 1.000000, 更新后的权重:0.968377 第2次: 梯度w.grad: 0.968377, 更新后的权重:0.945788
自适应矩估计 Adam
Momentum 使用指数加权平均计算当前的梯度值
AdaGrad、RMSProp 使用自适应的学习率
Adam优化算法(Adaptive Moment Estimation,自适应矩估计)将 Momentum 和 RMSProp 算法结合在一起
修正梯度:使用梯度的指数加权平均
修正学习率:使用梯度平方的指数加权平均
原理:Adam 是结合了 Momentum 和 RMSProp 优化算法的优点的自适应学习率算法。它计算了梯度的一阶矩(平均值)和二阶矩(梯度的方差)的自适应估计,从而动态调整学习率。
梯度计算公式:
权重参数更新公式:
其中, 是梯度的一阶矩估计, 是梯度的二阶矩估计, 和 是偏差校正后的估计。
在PyTroch中,Adam梯度优化法编程实践如下:
pythonimport torch import torch.nn as nn import torch.optim as optim def adam_method(): # 1 初始化权重参数 w = torch.tensor([1.0], requires_grad=True) loss = ((w ** 2) / 2.0).sum() # 2 实例化优化方法:Adam算法,其中betas是指数加权的系数 optimizer = optim.Adam(params=[w], lr=0.01, betas=[0.9, 0.99]) # 3 第1次更新 计算梯度,并对参数进行更新 optimizer.zero_grad() loss.backward() optimizer.step() print('第1次: 梯度w.grad: %f, 更新后的权重:%f' % (w.grad.numpy(), w.detach().numpy())) # 4 第2次更新 计算梯度,并对参数进行更新 # 使用更新后的参数机选输出结果 loss = ((w ** 2) / 2.0).sum() optimizer.zero_grad() loss.backward() optimizer.step() print('第2次: 梯度w.grad: %f, 更新后的权重:%f' % (w.grad.numpy(), w.detach().numpy()))结果显示:
python第1次: 梯度w.grad: 1.000000, 更新后的权重:0.990000 第2次: 梯度w.grad: 0.990000, 更新后的权重:0.980003
总结
动量算法 Momentum,梯度下降公式:w新 = w旧 - 学习率*当前时刻指数加权平均梯度值
自适应学习率 AdaGrad,梯度下降公式:w新 = w旧 - 调整后的学习率*梯度值
自适应学习率 RMSProp,对 AdaGrad 的优化,在梯度计算引入衰减系数β, 使用指数加权平均累计历史梯度
自适应矩估计 Adam,结合了 Momentum 和 RMSProp 优点的自适应学习率算法
|优化算法|优点|缺点|适用场景|
| ----------| -----------------------------------------------------| --------------------------------------------------------| ------------------------------------------------------|
|SGD|简单、容易实现。|收敛速度较慢,容易震荡,特别是在复杂问题中。|用于简单任务,或者当数据特征分布相对稳定时。|
|Momentum|可以加速收敛,减少震荡,特别是在高曲率区域。|需要手动调整动量超参数,可能会在小步长训练中过度更新。|用于非平稳优化问题,尤其是深度学习中的应用。|
|AdaGrad|自适应调整学习率,适用于稀疏数据。|学习率会在训练过程中逐渐衰减,可能导致早期停滞。|适合稀疏数据,如 NLP 或推荐系统中的特征。|
|RMSProp|解决了 AdaGrad 学习率过早衰减的问题,适应性强。|需要选择合适的超参数,更新可能会过于激进。|适用于动态问题、非平稳目标函数,如深度学习训练。|
|Adam|结合了 Momentum 和 RMSProp 的优点,适应性强且稳定。|需要调节更多的超参数,训练过程中可能会产生较大波动。|广泛适用于各种深度学习任务,特别是非平稳和复杂问题。|
优化算法选择指南
|场景|推荐算法|
| -----------------------| -----------------------------|
|默认首选|Adam|
|简单任务/小模型|SGD 或 Momentum|
|复杂任务/大数据|Adam|
|稀疏数据(NLP、推荐)|AdaGrad 或 RMSProp|
|需要精确收敛|SGD + Momentum + 学习率衰减|
优化辅助策略
学习率衰减
一种在训练过程中动态调整优化器步长的策略,通过逐步减小学习率,使模型在训练初期快速收敛、后期精细微调,从而平衡收敛速度与稳定性。
为什么要进行学习率优化
在训练神经网络时,一般情况下学习率都会随着训练而变化。这主要是由于,在神经网络训练的后期:如果学习率过高,会造成loss的振荡,甚至不收敛(梯度爆炸); 但是如果学习率减小的过慢,又会造成收敛变慢的情况。
代码演示:学习率如何影响梯度下降
pythonimport torch import matplotlib.pyplot as plt # x看成是权重,y看成是loss,下面通过代码来理解学习率的作用 def func(x_t): return torch.pow(2*x_t, 2) # y = 4 x ^2 def test_multiple_learning_rates(): learning_rates = [0.01, 0.05, 0.1, 0.125, 0.2, 0.3] # 创建 3行4列的子图布局 fig, axes = plt.subplots(3, 4, figsize=(16, 12)) for idx, lr in enumerate(learning_rates): # 计算在当前行中的位置 row = idx // 2 # 每行放2个学习率 (0, 1 -> row 0; 2, 3 -> row 1; 4, 5 -> row 2) col_in_pair = idx % 2 # 在当前配对中的位置 (0 或 1) # 在指定行中,第一个学习率的两个图放在前两列,第二个学习率的两个图放在后两列 if col_in_pair == 0: # 第一个学习率 (在每对中的第一个) col_loss = 0 # 损失图放在第0列 col_path = 1 # 路径图放在第1列 else: # 第二个学习率 (在每对中的第二个) col_loss = 2 # 损失图放在第2列 col_path = 3 # 路径图放在第3列 # 重置x值 x = torch.tensor([2.], requires_grad=True) iter_rec, loss_rec, x_rec = [], [], [] max_iteration = 4 for i in range(max_iteration): y_val = func(x) y_val.backward() # 记录数据 x_rec.append(x.item()) iter_rec.append(i) loss_rec.append(y_val.item()) # 更新参数 x.data.sub_(lr * x.grad) x.grad.zero_() # 左侧子图:损失 vs 迭代次数 ax_loss = axes[row, col_loss] ax_loss.plot(iter_rec, loss_rec, '-o', label=f'lr={lr}') ax_loss.grid() ax_loss.set_xlabel("Iteration") ax_loss.set_ylabel("Loss value") ax_loss.set_title(f"Loss vs Iteration (LR: {lr})") ax_loss.legend() # 右侧子图:优化路径在函数曲线上 ax_path = axes[row, col_path] # 生成x值用于绘制函数曲线 x_t = torch.linspace(-0.5, 2.5, 100) y_func = func(x_t) # 绘制函数曲线 ax_path.plot(x_t.detach().numpy(), y_func.detach().numpy(), 'k--', label="y = 4*x^2", alpha=0.5) # 绘制优化路径 y_rec = [func(torch.tensor(i)).item() for i in x_rec] ax_path.plot(x_rec, y_rec, '-o', label=f'lr={lr}', markersize=6) ax_path.grid() ax_path.set_xlabel("X value") ax_path.set_ylabel("Y value") ax_path.set_title(f"Optimization Path (LR: {lr})") ax_path.legend() plt.tight_layout() plt.show() # 打印最终结果总结 print("\n=== 总结 ===") for lr in learning_rates: x = torch.tensor([2.], requires_grad=True) iter_rec, loss_rec, x_rec = [], [], [] max_iteration = 4 for i in range(max_iteration): y_val = func(x) y_val.backward() x_rec.append(x.item()) x.data.sub_(lr * x.grad) x.grad.zero_() iter_rec.append(i) loss_rec.append(y_val.item()) final_x = x_rec[-1] final_loss = loss_rec[-1] print(f"学习率 {lr}: 最终x={final_x:.6f}, 最终loss={final_loss:.6f}") test_multiple_learning_rates()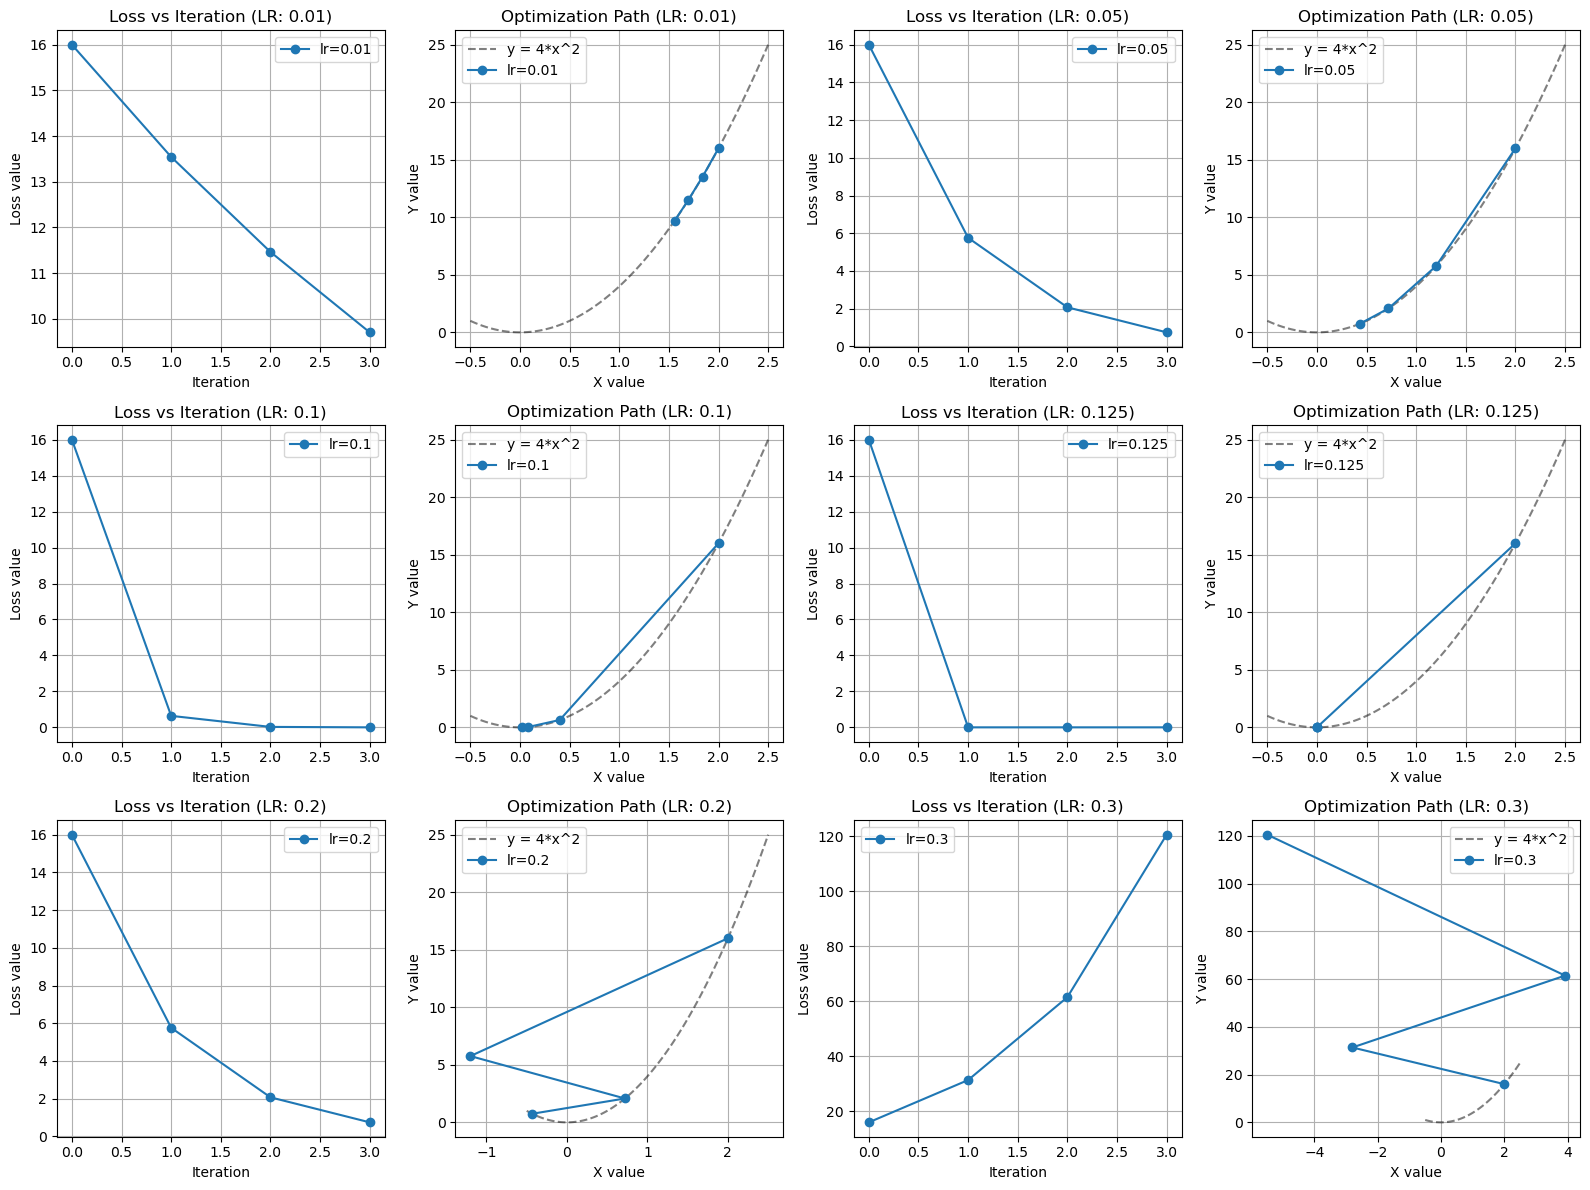
可以看出:采用较小的学习率,梯度下降的速度慢;采用较大的学习率,梯度下降太快越过了最小值点,导致震荡,甚至不收敛(梯度爆炸)。
学习率为0.2时出现了震荡,而学习率为0.3时出现梯度爆炸
衰减策略
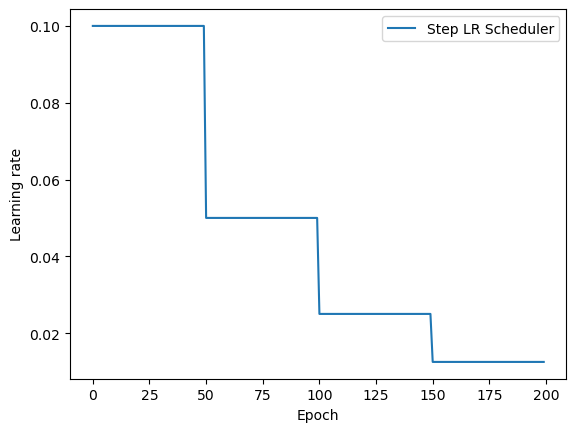
StepLR 等间隔衰减
API
pythontorch.optim.lr_scheduler.StepLR( # 创建步长衰减学习率调度器 optimizer, # 【必填】优化器实例,如 torch.optim.SGD/Adam,调度器会直接修改其 lr step_size, # 【必填】衰减周期(单位:epoch),每隔 step_size 轮衰减一次 gamma=0.1, # 衰减系数,新_lr = 旧_lr × gamma,默认0.1(即每次变为原来的10%) last_epoch=-1, # 当前epoch索引,-1表示从头开始;断点续训时设为已完成的epoch数 verbose=False # 是否打印学习率更新日志,调试时设为True ) # 核心方法: # .step(epoch=None): 在每个epoch结束时调用,触发学习率更新(⚠️不要每个batch调用) # .get_last_lr(): 获取当前实际学习率列表(PyTorch≥1.4) # .state_dict(): 保存调度器状态,用于断点续训 # .load_state_dict(): 加载调度器状态示例代码
pythonimport torch from torch import optim import matplotlib.pyplot as plt def test_StepLR(): # 0.参数初始化 LR = 0.1 # 设置学习率初始化值为0.1 iteration = 10 # 设置迭代次数 max_epoch = 200 # 设置最大迭代轮数 # 1 初始化参数 y_true = torch.tensor([0]) # 真实值 x = torch.tensor([1.0]) # 输入特征 w = torch.tensor([1.0], requires_grad=True) # 权重参数 # 2.优化器(动量) optimizer = optim.SGD([w], lr=LR, momentum=0.9) # 3.设置学习率下降策略 scheduler_lr = optim.lr_scheduler.StepLR(optimizer, step_size=50, gamma=0.5) # 4.获取学习率的值和当前的epoch lr_list, epoch_list = [], [] # 5.迭代训练 for epoch in range(max_epoch): # eppoch: 0 ~ 199 # 获取当前lr 和 epoch lr_list.append(scheduler_lr.get_last_lr()) epoch_list.append(epoch) for _ in range(iteration): # 遍历每一个batch数据 loss = (w*x-y_true)**2 # 目标函数(损失函数) # 梯度清零 + 反向传播 + 参数更新 optimizer.zero_grad() loss.backward() optimizer.step() # 更新下一个epoch的学习率 scheduler_lr.step() # 6.绘制学习率变化的曲线 plt.plot(epoch_list, lr_list, label="Step LR Scheduler") plt.xlabel("Epoch") plt.ylabel("Learning rate") plt.legend() plt.show() test_StepLR()
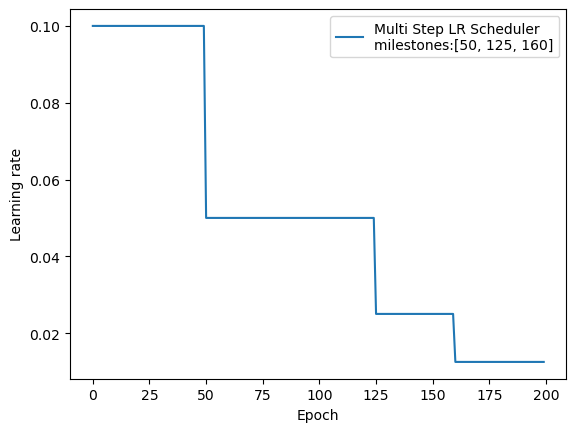
MultiStepLR 指定间隔衰减
API
pythontorch.optim.lr_scheduler.MultiStepLR( # 创建多节点衰减学习率调度器 optimizer, # 【必填】优化器实例,如 torch.optim.SGD/Adam,调度器会直接修改其 lr milestones, # 【必填】衰减节点列表(单位:epoch),例如 [30, 80],到达这些 epoch 时衰减 gamma=0.1, # 衰减系数,新_lr = 旧_lr × gamma,默认0.1(即每次变为原来的10%) last_epoch=-1, # 当前epoch索引,-1表示从头开始;断点续训时设为已完成的epoch数 verbose=False # 是否打印学习率更新日志,调试时设为True(新版PyTorch可能已弃用) ) # 核心方法: # .step(epoch=None): 在每个epoch结束时调用,触发学习率更新(⚠️不要每个batch调用) # .get_last_lr(): 获取当前实际学习率列表(PyTorch≥1.4) # .state_dict(): 保存调度器状态,用于断点续训 # .load_state_dict(): 加载调度器状态示例代码:
pythonimport torch from torch import optim import matplotlib.pyplot as plt def test_MultiStepLR(): torch.manual_seed(1) LR = 0.1 iteration = 10 max_epoch = 200 y_true = torch.tensor([0]) x = torch.tensor([1.0]) w = torch.tensor([1.0], requires_grad=True) optimizer = optim.SGD([w], lr=LR, momentum=0.9) # 设定调整时刻数 milestones = [50, 125, 160] # 设置学习率下降策略 scheduler_lr = optim.lr_scheduler.MultiStepLR(optimizer, milestones=milestones, gamma=0.5) lr_list, epoch_list = list(), list() for epoch in range(max_epoch): lr_list.append(scheduler_lr.get_last_lr()) epoch_list.append(epoch) for _ in range(iteration): loss = (w*x-y_true)**2 optimizer.zero_grad() loss.backward() optimizer.step() # 更新下一个epoch的学习率 scheduler_lr.step() plt.plot(epoch_list, lr_list, label="Multi Step LR Scheduler\nmilestones:{}".format(milestones)) plt.xlabel("Epoch") plt.ylabel("Learning rate") plt.legend() plt.show() test_MultiStepLR()
ExponentialLR 指数衰减
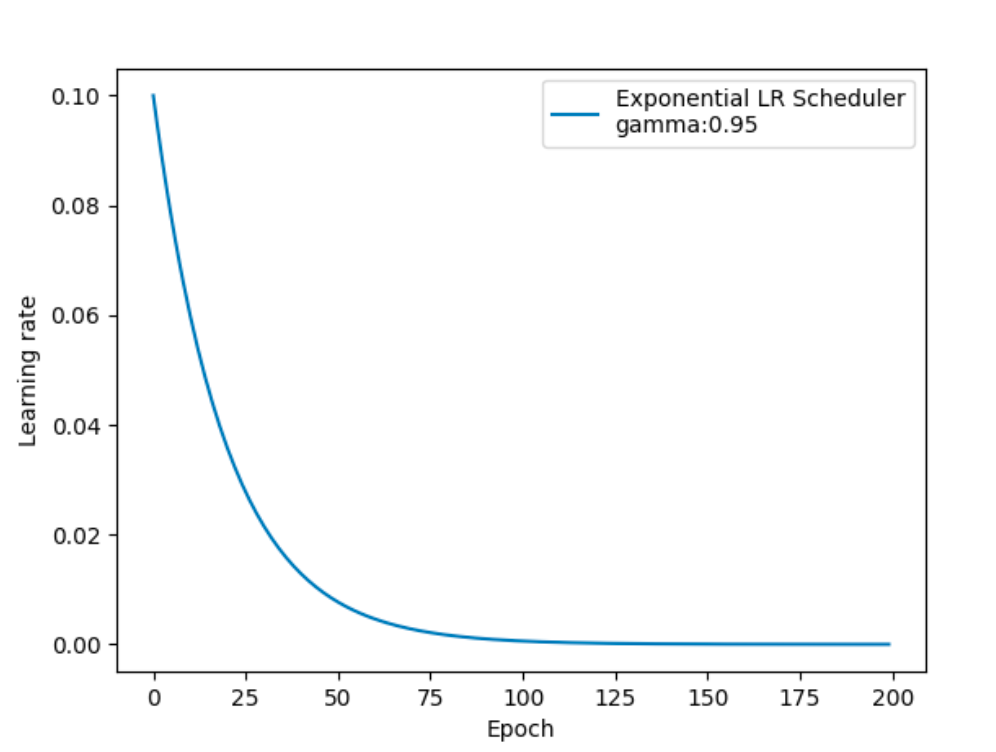
API:
pythontorch.optim.lr_scheduler.ExponentialLR( # 创建指数衰减学习率调度器 optimizer, # 【必填】优化器实例,如 torch.optim.SGD/Adam,调度器会直接修改其 lr gamma, # 【必填】衰减系数(0<gamma<1),每个 epoch 结束 lr = 旧_lr × gamma^epoch last_epoch=-1, # 当前 epoch 索引,-1 表示从头开始;断点续训时设为已完成的 epoch 数 verbose=False # 是否打印学习率更新日志,调试时设为 True(新版 PyTorch 可能已弃用) ) # 核心方法: # .step(epoch=None): 在每个 epoch 结束时调用,触发学习率更新(⚠️不要每个 batch 调用) # .get_last_lr(): 获取当前实际学习率列表(PyTorch≥1.4) # .state_dict(): 保存调度器状态,用于断点续训 # .load_state_dict(): 加载调度器状态示例代码
pythonimport torch from torch import optim import matplotlib.pyplot as plt def test_ExponentialLR(): # 0.参数初始化 LR = 0.1 # 设置学习率初始化值为0.1 iteration = 10 max_epoch = 200 # 1 初始化参数 y_true = torch.tensor([0]) x = torch.tensor([1.0]) w = torch.tensor([1.0], requires_grad=True) # 2.优化器 optimizer = optim.SGD([w], lr=LR, momentum=0.9) # 3.设置学习率下降策略 scheduler_lr = optim.lr_scheduler.ExponentialLR(optimizer, gamma=0.95) # 4.获取学习率的值和当前的epoch lr_list, epoch_list = list(), list() for epoch in range(max_epoch): lr_list.append(scheduler_lr.get_last_lr()) epoch_list.append(epoch) for _ in range(iteration): # 遍历每一个batch数据 loss = (w*x-y_true)**2 optimizer.zero_grad() loss.backward() optimizer.step() # 更新下一个epoch的学习率 scheduler_lr.step() # 5.绘制学习率变化的曲线 plt.plot(epoch_list, lr_list, label="Multi Step LR Scheduler") plt.xlabel("Epoch") plt.ylabel("Learning rate") plt.legend() plt.show() test_ExponentialLR()
总结
|方法|等间隔学习率衰减 (Step Decay)|指定间隔学习率衰减 (Exponential Decay)|指数学习率衰减
(Exponential Moving Average Decay)
|
| ----------| ----------------------------------| --------------------------------------------| -------------------------------------------------------|
|衰减方式|固定步长衰减|指定步长衰减|平滑指数衰减,历史平均考虑|
|实现难度|简单易实现|相对简单,容易调整|需要额外历史计算,较复杂|
|适用场景|大型数据集、较为简单的任务|对训练平稳性要求较高的任务|高精度训练,避免过快收敛|
|优点|直观,易于调试,适用于大批量数据|易于调试,稳定训练过程|平滑且考虑历史更新,收敛稳定性较强|
|缺点|学习率变化较大,可能跳过最优点|在某些情况下可能衰减过快,导致优化提前停滞|超参数调节较为复杂,可能需要更多的计算资源|
正则化
什么是正则化
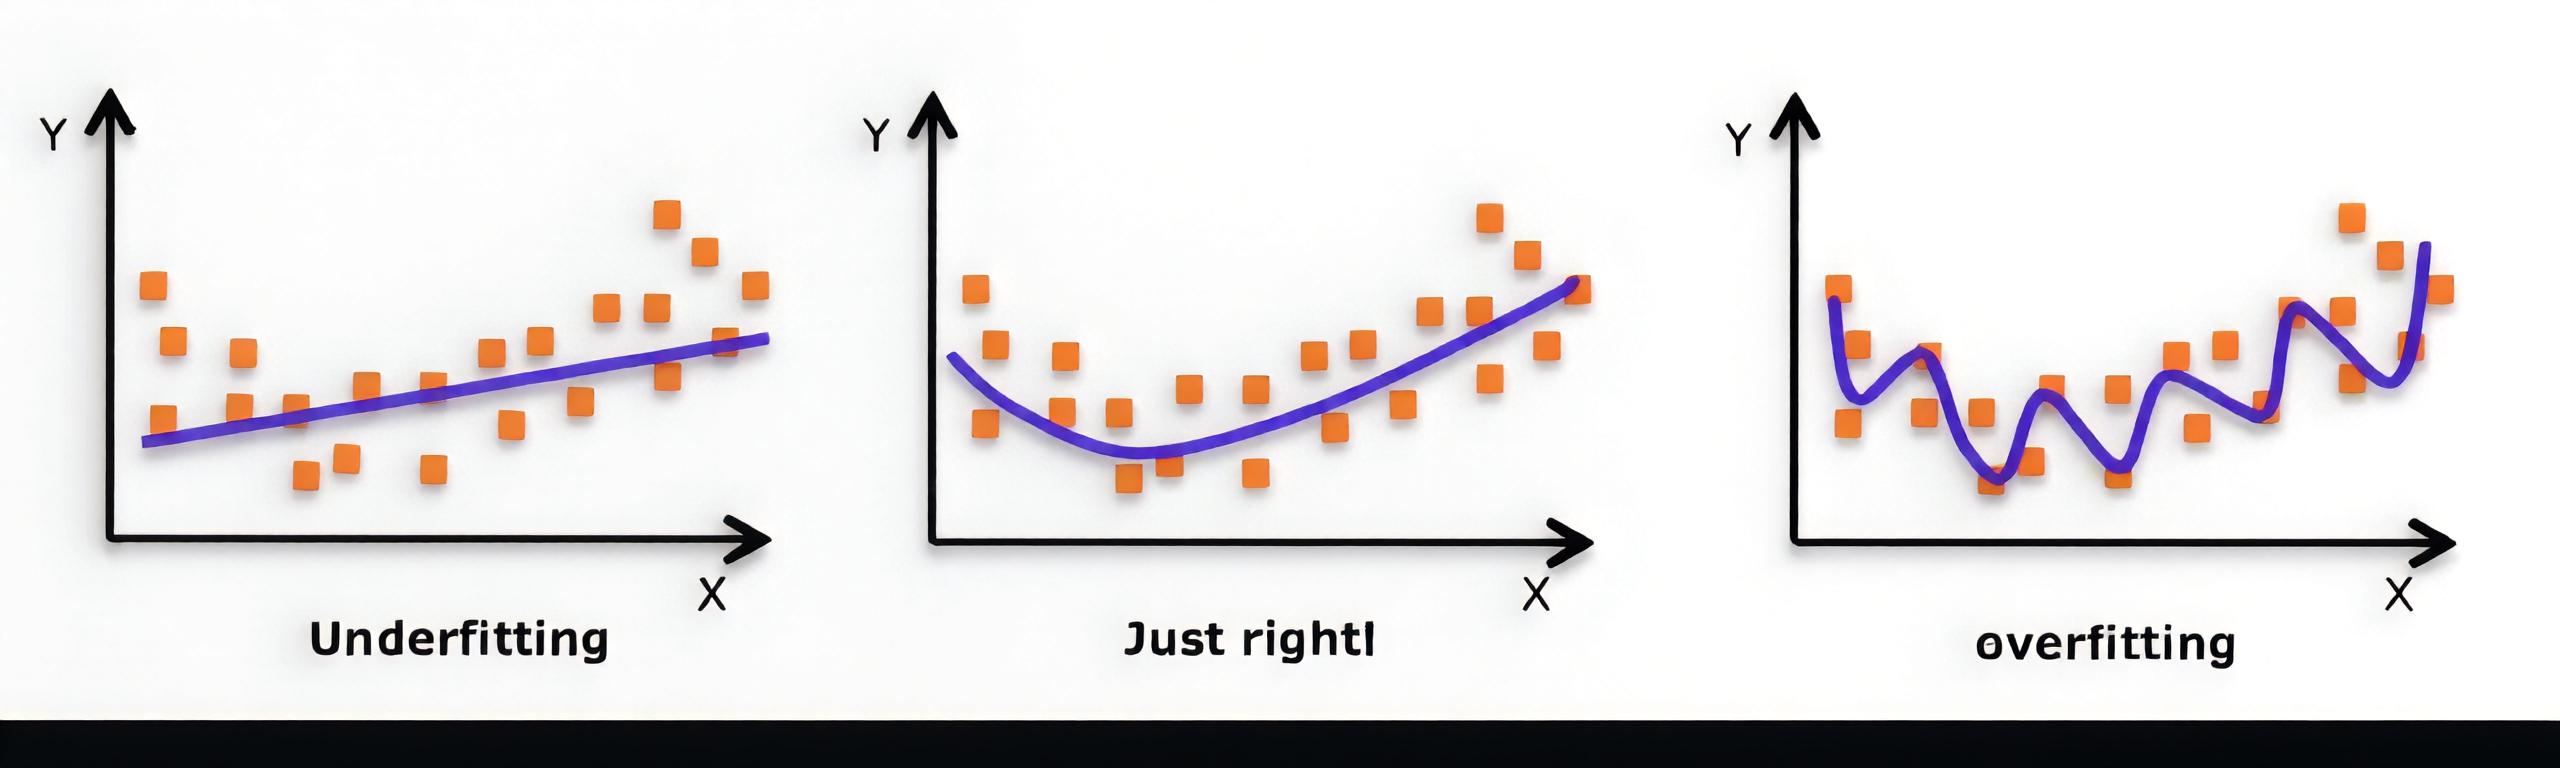
在设计机器学习算法时希望在新样本上的泛化能力强。许多机器学习算法都采用相关的策略来减小测试误差,这些策略被统称为正则化
神经网络强大的表示能力经常遇到过拟合,所以需要使用不同形式的正则化策略
目前在深度学习中使用较多的策略有:范数惩罚、DropOut、特殊的网络层等
目的:防止过拟合,提升模型泛化能力
L1/L2 正则化
|类型|公式|特点|
| ------| ------| --------------------------|
|L1| |权重可变为 0,相当于降维|
|L2| |权重接近 0,不会等于 0|
Dropout正则化
在训练深层神经网络时,由于模型参数较多,在数据量不足的情况下,很容易过拟合。Dropout(随机失活)是一个简单有效的正则化方法。
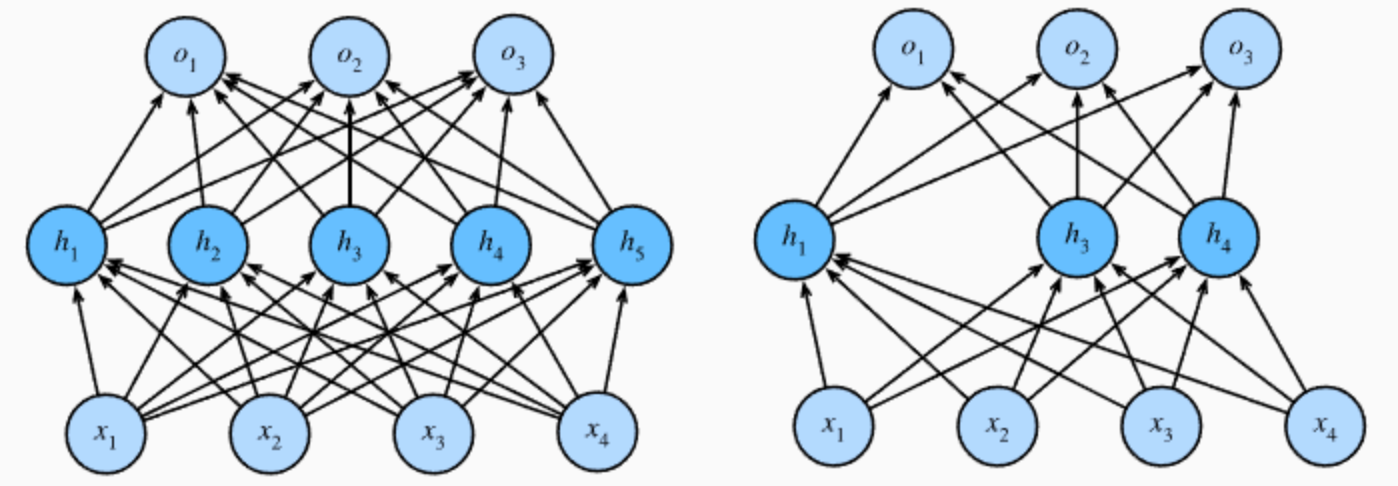
在训练过程中,Dropout的实现是让神经元以超参数p(丢弃概率)的概率停止工作或者激活被置为0,未被置为0的进行缩放,缩放比例为 1/(1-p) 。训练过程可以认为是对完整的神经网络的一些子集进行训练,每次基于输入数据只更新子网络的参数
在实际应用中,Dropout参数p的概率通常取值:0.2 ~ 0.5
对于较小的模型或较复杂的任务,丢弃率可以选择0.3或更小
对于非常深的网络,较大的丢弃率(如0.5或0.6)可能会有效防止过拟合
实际应用中,通常会在全连接层(激活函数后)之后添加 Dropout层
在测试过程中,随机失活不起作用(只在训练时起作用)
在测试阶段,使用所有的神经元进行预测,以获得更稳定的结果
直接使用训练好的模型进行测试,由于所有的神经元都参与计算,输出的期望值会比训练阶段高。测试阶段的期望输出是
测试/推理模式:model.eval()
缩放的必要性
在训练阶段,期望输出为 比原来的 小
把训练时保留的神经元输出放大到
期望输出变为 ,与测试阶段的期望输出一致
训练模型:model.train()
【示例代码】
pythonimport torch import torch.nn as nn def test(): # 初始化输入数据:表示某一层的weight信息 inputs = torch.randint(0, 10, size=[1, 4]).float() print("输入数据:\n", inputs) # 初始化全连接层, 输入维度为4,输出维度为5 layer = nn.Linear(4,5) y = layer(inputs) # 加权求和 print("FC层的输出结果:\n", y) y = torch.relu(y) # 激活函数, relu: y = max(0,x) print("未失活FC层的输出结果:\n", y) # 初始化随机失活层,p 为失活概率 dropout = nn.Dropout(p=0.4) y = dropout(y) print("失活后FC层的输出结果:\n", y) test()输出结果:
python输入数据: tensor([[0., 5., 8., 4.]]) FC层的输出结果: tensor([[-2.7994, 0.6970, -1.6318, -3.4943, 0.8844]], grad_fn=<AddmmBackward0>) 未失活FC层的输出结果: tensor([[0.0000, 0.6970, 0.0000, 0.0000, 0.8844]], grad_fn=<ReluBackward0>) 失活后FC层的输出结果: tensor([[0.0000, 1.1617, 0.0000, 0.0000, 1.4740]], grad_fn=<MulBackward0>)上述代码将Dropout层的丢弃概率p设置为0.4,此时经过Dropout层计算的张量中就出现了很多0, 未变为0的按照(1/(1-0.4))进行处理。
Batch Normalization(批量归一化)
问题:在神经网络的训练过程中,流经网络的数据都是一个batch,每个batch之间的数据分布变化非常剧烈,这就使得网络参数频繁的进行大的调整以适应流经网络的不同分布的数据,给模型训练带来非常大的不稳定性,使得模型难以收敛。如果我们对每一个batch的数据进行标准化之后,数据分布就变得稳定,参数的梯度变化也变得稳定,有助于加快模型的收敛。
解决办法:通过标准化每一层的输入,使其均值接近0,方差接近1,从而加速训练并提高泛化能力。
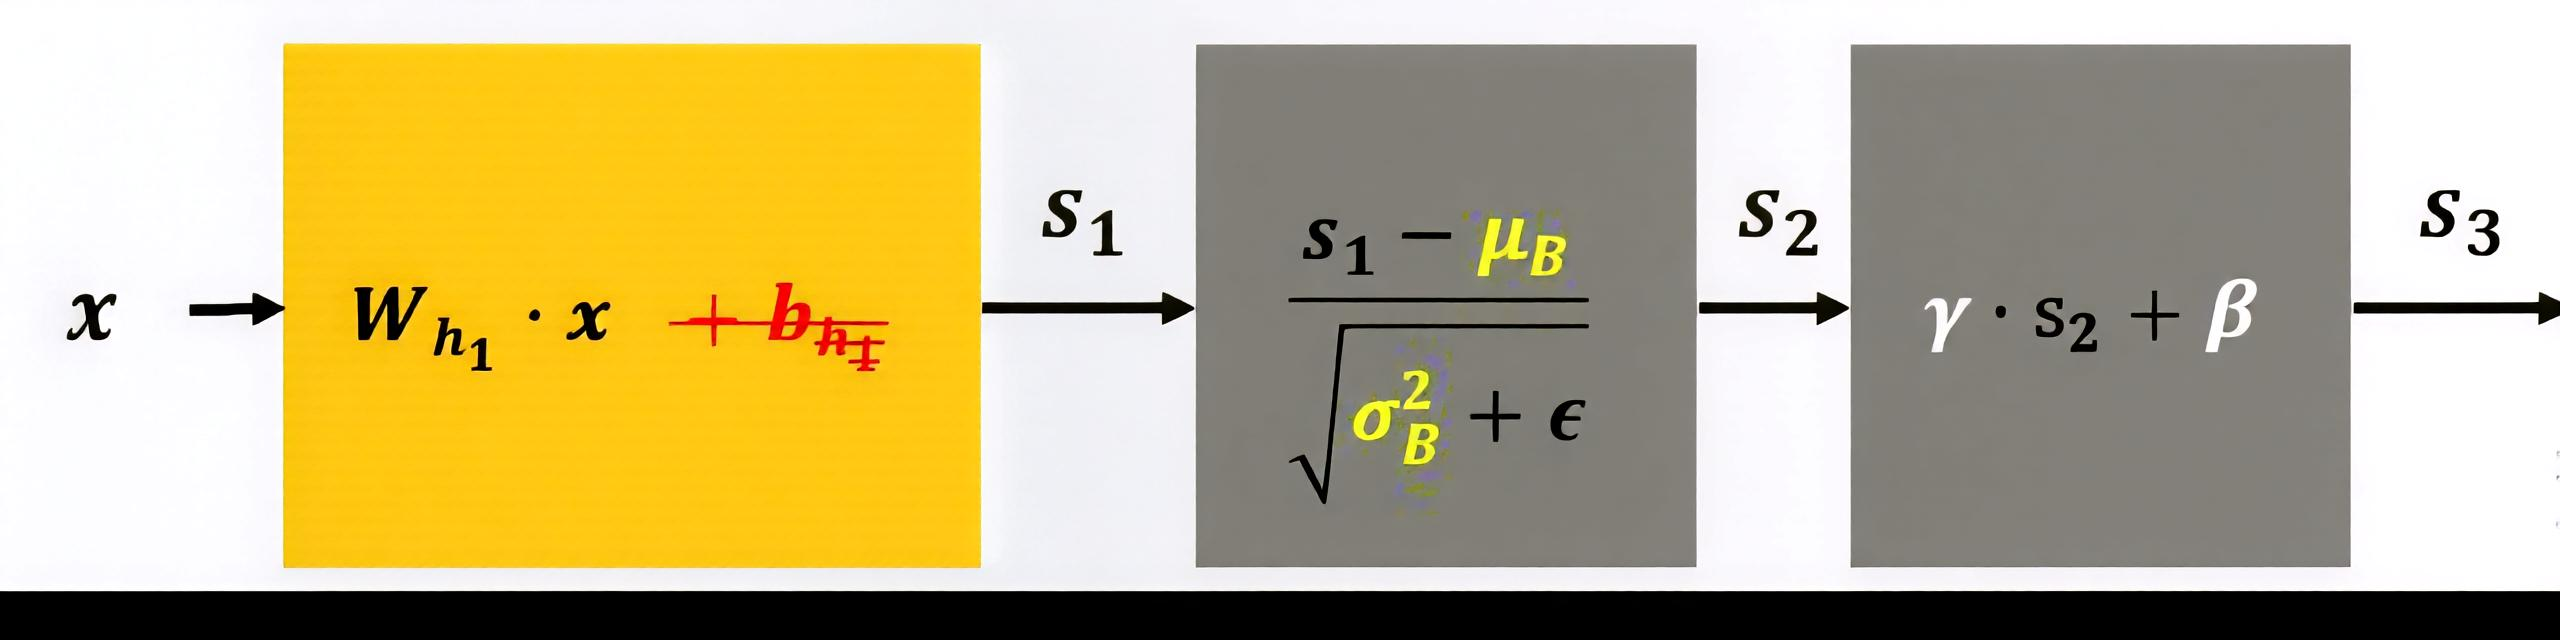
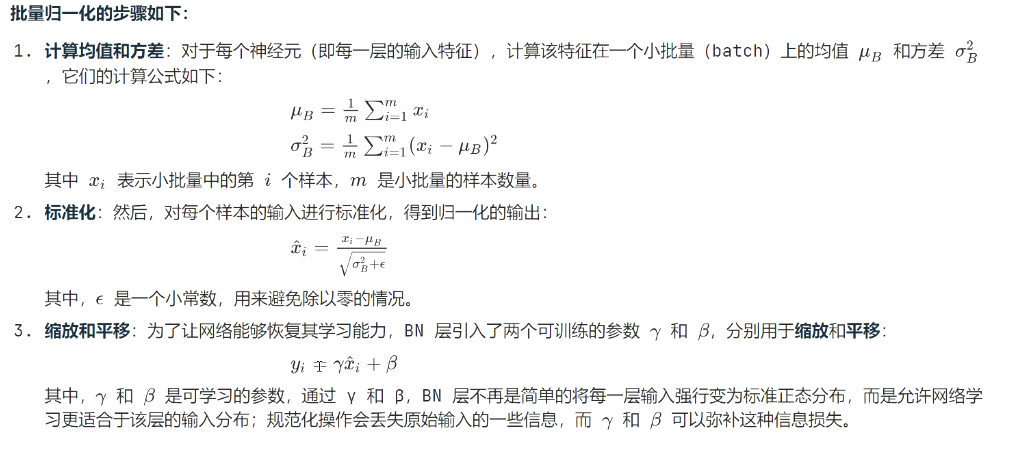
加权求和后,先对数据标准化,再对数据重构(缩放+平移),写成公式如下所示:
和 :是可学习的参数,相当于对标准化后的值做了一个线性变换( 为系数, 为偏置);
eps :通常指为 ,避免分母为 0;
E(x) 或 μ :表示变量的均值;
Var(x) 或 σ2 :表示变量的方差(Variance);
:是一个很小的常数,用于数值稳定性(防止除以零)
批量归一化的作用:
减少内部协方差偏移:通过对每层的输入进行标准化,减少了输入数据分布的变化,从而加速了训练过程,并使得网络在训练过程中更加稳定。
加速训练:
在没有批量归一化的情况下,神经网络的训练通常会很慢,尤其是深度网络。因为在每层的训练过程中,输入数据的分布(特别是前几层)会不断变化,这会导致网络学习速度缓慢。
批量归一化通过确保每层的输入数据在训练时分布稳定,有效减少了这种变化,从而加速了训练过程。
起到正则化作用:批量归一化可以视作一种正则化方法,因为它引入了对训练样本的噪声(不同批次的统计信息不同,批次较小的均值和方差估计会更加不准确),使得模型不容易依赖特定的输入特征,从而起到一定的正则化效果,减少了对其他正则化技术(如Dropout)的需求。
提升泛化能力:由于其正则化效果,批量归一化能帮助网络在测试集上取得更好的性能。
API
pythondropout = torch.nn.Dropout(p) # p 为失活概率 y = dropout(y) # 随机失活 """ BatchNorm1d:主要应用于全连接层或处理一维数据的网络,例如文本处理。它接收形状为 (N, num_features) 的张量作为输入。 BatchNorm2d:主要应用于卷积神经网络,处理二维图像数据或特征图。它接收形状为 (N, C, H, W) 的张量作为输入。 BatchNorm3d:主要用于三维卷积神经网络 (3D CNN),处理三维数据,例如视频或医学图像。它接收形状为 (N, C, D, H, W) 的张量作为输入。 """ torchnn.BatchNorm2d(num_features=2, eps=1e-05, momentum=0.1, affine=True) # num_features:输入特征数 = 图片通道数 # eps:噪声值(小常熟),防止除以0的错误,默认为 1e-5 # momentum:动量系数,计算移动平均统计量的 # affine:默认为True,γ和β被使用(缩放和平移),让BN层更加灵活【示例代码】
pythonimport torch import torch.nn as nn """ BatchNorm1d:主要应用于全连接层或处理一维数据的网络,例如文本处理。它接收形状为 (N, num_features) 的张量作为输入。 BatchNorm2d:主要应用于卷积神经网络,处理二维图像数据或特征图。它接收形状为 (N, C, H, W) 的张量作为输入。 BatchNorm3d:主要用于三维卷积神经网络 (3D CNN),处理三维数据,例如视频或医学图像。它接收形状为 (N, C, D, H, W) 的张量作为输入。 """ def tes01(): # 创建测试样本, 假设是经过卷积层(Conv2d)处理后的特征图 # (N, C, H, W): 一张图, 2个通道, 每个通道3行4列 # 可以创建1个样本, 图像的BN是对每个通道的特征图(行列数据)进行标准化 input_2d = torch.randn(size=(1, 2, 3, 4)) print("input-->", input_2d) # num_features:输入特征数 = 图片通道数 # eps:噪声值(小常熟),防止除以0的错误,默认为 1e-5 # momentum:动量系数,计算移动平均统计量的 # affine:默认为True,γ和β被使用(缩放和平移),让BN层更加灵活 bn2d = nn.BatchNorm2d(num_features=2, eps=1e-05, momentum=0.1, affine=True) output = bn2d(input_2d) print("output-->", output) print("output.size-->", output.size()) print(bn2d.weight) print(bn2d.bias) def tes02(): # 创建测试样本 # 2个样本, 1个特征 # 不能创建1个样本, 无法统计均值和方差 input_1d = torch.randn(size=(2, 2)) # 创建线性层对象 linear1 = nn.Linear(in_features=2, out_features=3) # 创建BN层对象 # num_features:输入特征数 bn1d = nn.BatchNorm1d(num_features=3) # 20 output features output_1d = linear1(input_1d) # 进行批量归一化 output = bn1d(output_1d) print("output-->", output) print("output.size-->", output.size()) # (32, 20) tes01() tes02()输出结果:
pythoninput--> tensor([[[[ 1.6903, 0.2124, 0.6304, -0.7917], [ 0.7295, 0.7947, -1.1080, -3.2000], [-0.6661, 0.5589, -1.2133, -0.3589]], [[-0.6129, -0.5044, -0.7959, 0.3621], [ 1.1717, -0.6193, 1.6340, 0.9356], [-0.5217, -1.1937, -0.8516, 1.3156]]]]) output--> tensor([[[[ 1.5526, 0.3557, 0.6942, -0.4575], [ 0.7744, 0.8273, -0.7136, -2.4078], [-0.3557, 0.6363, -0.7989, -0.1069]], [[-0.6729, -0.5587, -0.8654, 0.3529], [ 1.2048, -0.6795, 1.6911, 0.9563], [-0.5768, -1.2839, -0.9240, 1.3561]]]], grad_fn=<NativeBatchNormBackward0>) output.size--> torch.Size([1, 2, 3, 4]) Parameter containing: tensor([1., 1.], requires_grad=True) Parameter containing: tensor([0., 0.], requires_grad=True) output--> tensor([[ 1.0000, -0.9999, -0.9991], [-1.0000, 0.9999, 0.9991]], grad_fn=<NativeBatchNormBackward0>) output.size--> torch.Size([2, 3])
总结
L1正则化:权重可以变为0,相当于:降维
L2正则化:权重可以无限接近0
DropOut:每批次样本训练时,随机让一部分神经元死亡,防止一些特征对结果的影响较大(防止过拟合)
BN(批量归一化):对数据标准化,再对数据重构(缩放+平移)