RNN 核心概念
什么是 RNN
定义:循环神经网络(Recurrent Neural Network, RNN)是专门处理序列数据的神经网络,通过 “循环” 结构保留前序时间步信息
序列数据的核心是 “后序数据与前序数据存在关联”,RNN 通过隐藏状态实现这种时序依赖的建模。
示例:
- 文本:"我爱北京" → "北京"的理解依赖前面的"我爱"
- 时间序列:明天的股价与今天相关
- 语音:当前音素与前后音素相关
- 视频:当前帧与前后帧连续
核心:隐藏状态(** ** ) 传递时序上下文(区别于前馈神经网络无记忆性)。
与前馈神经网络的区别:
- 前馈网络:无记忆性,每个输入独立处理
- RNN:有记忆性,当前输出依赖前序信息
应用
自然语言处理(NLP) :文本生成、语言建模、机器翻译、情感分析等。
时间序列预测:股市预测、气象预测、传感器数据分析等。
语音识别:将语音信号转换为文字。
音乐生成:通过学习音乐的时序模式来生成新乐曲。
自然语言处理
自然语言处理(Nature language Processing, NLP)让计算机能够理解、生成和处理人类语言,实现人与机器之间通过自然语言进行有效交互。
NLP涵盖了从文本到语音、从语音到文本的各个方面,它涉及多种技术,包括语法分析、语义理解、情感分析、机器翻译等。
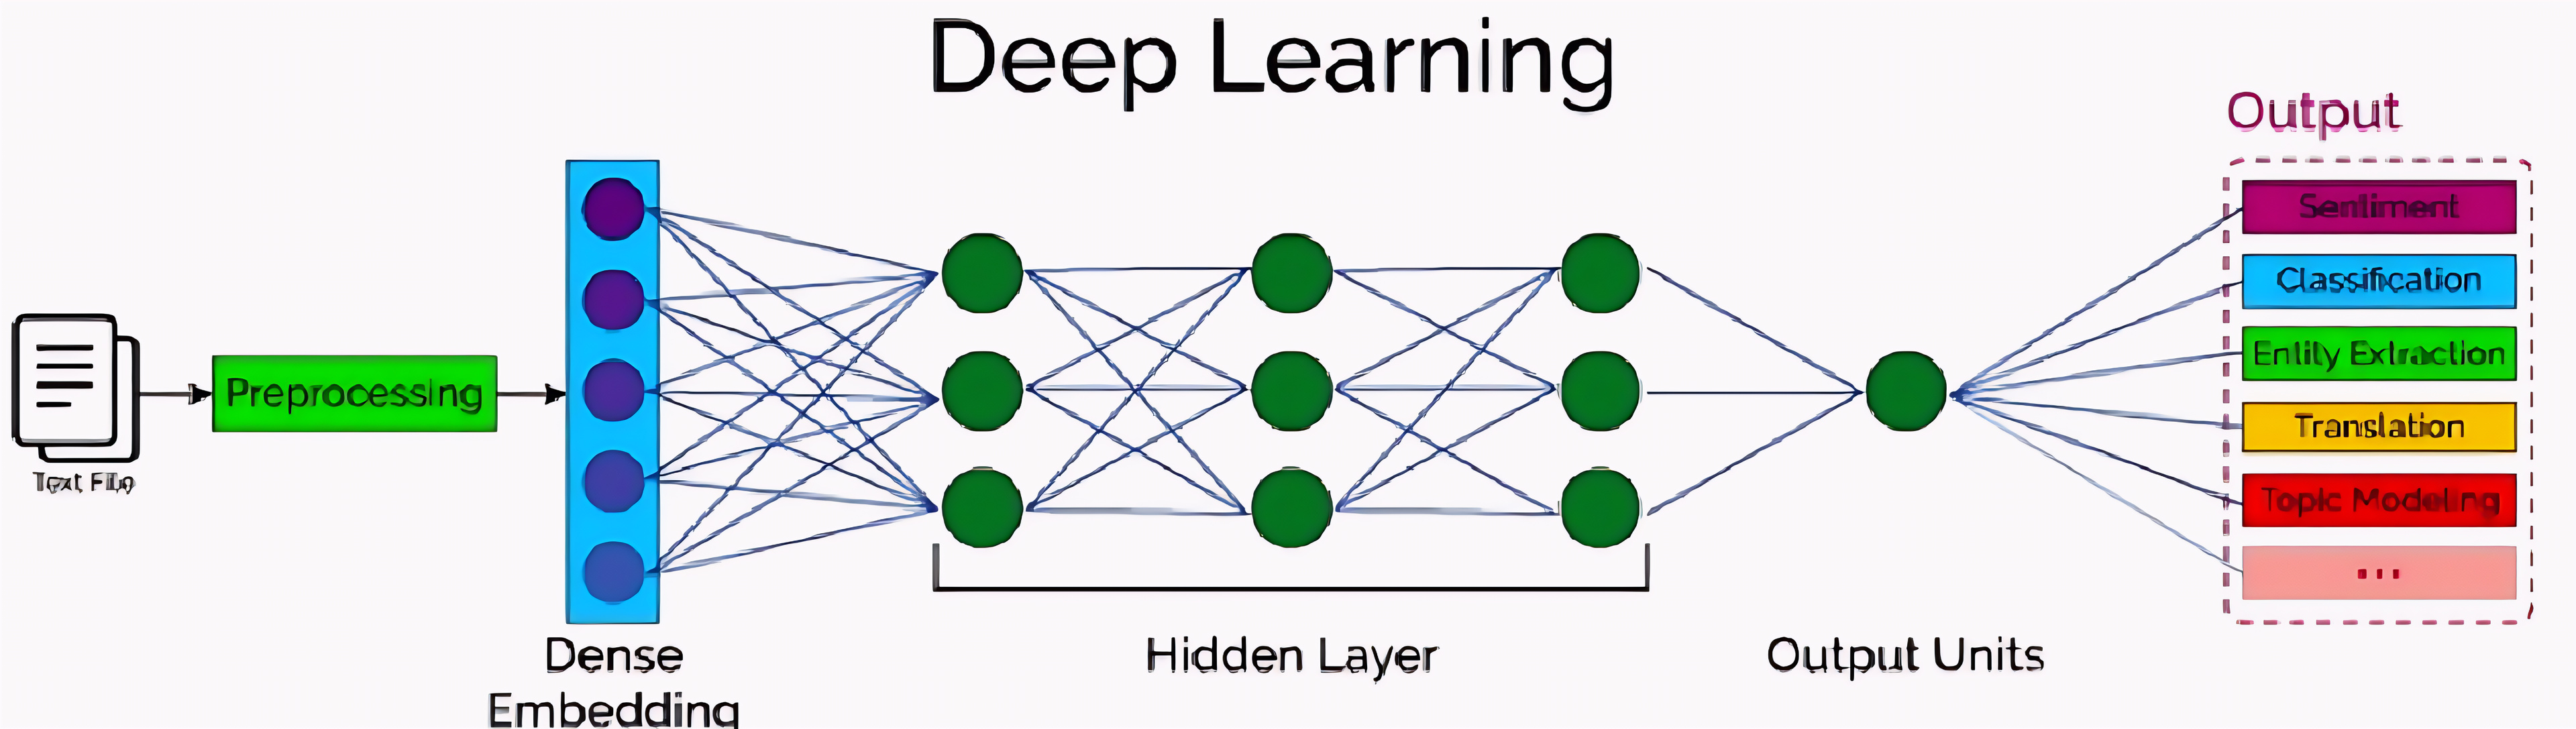
词嵌入层
作用:将离散词索引转为低维稠密向量(替代高维稀疏的 one-hot 编码),捕捉词间语义相似性,降低计算量,作为 RNN 的输入层。
将文本转换成向量
工作流程
文本 → 分词 → 词索引 → 词嵌入层 → 词向量 → RNN初始化词向量(随机 / 预训练如 Word2Vec / GloVe)
输入词索引
查找对应词向量
输入 RNN
API
nn.Embedding(num_embeddings, embedding_dim)


'''


num_embeddings:词的总数(词汇表大小)


embedding_dim:词向量的维度


'''
代码示例:
import jieba


import torch


import torch.nn as nn


def func():


    text = '北京冬奥的进度条已经过半,不少外国运动员在完成自己的比赛后踏上归途。'


    # 分词


    words = jieba.lcut(text)


    print(words)


    # 词嵌入层


    embedding = nn.Embedding(num_embeddings=len(words), embedding_dim=10)


    # 词对象索引


    for i, word in enumerate(words):  # enumerate()函数: 遍历列表,返回索引和值


        print(i, word)


        '''词索引 -> 词向量'''


        word_vector = embedding(torch.tensor([i]))


        print(word_vector)


func()
循环网络层
- 作用:循环网络层(RNN层)用于处理序列数据,通过内部的循环连接保留历史信息,使网络具备记忆能力。它在每个时间步结合当前输入和上一时刻的隐藏状态,逐步更新状态,从而捕捉序列中的时间依赖关系和动态模式。最终输出可以用于序列预测、分类或生成等任务。
RNN 单元结构图 和 公式
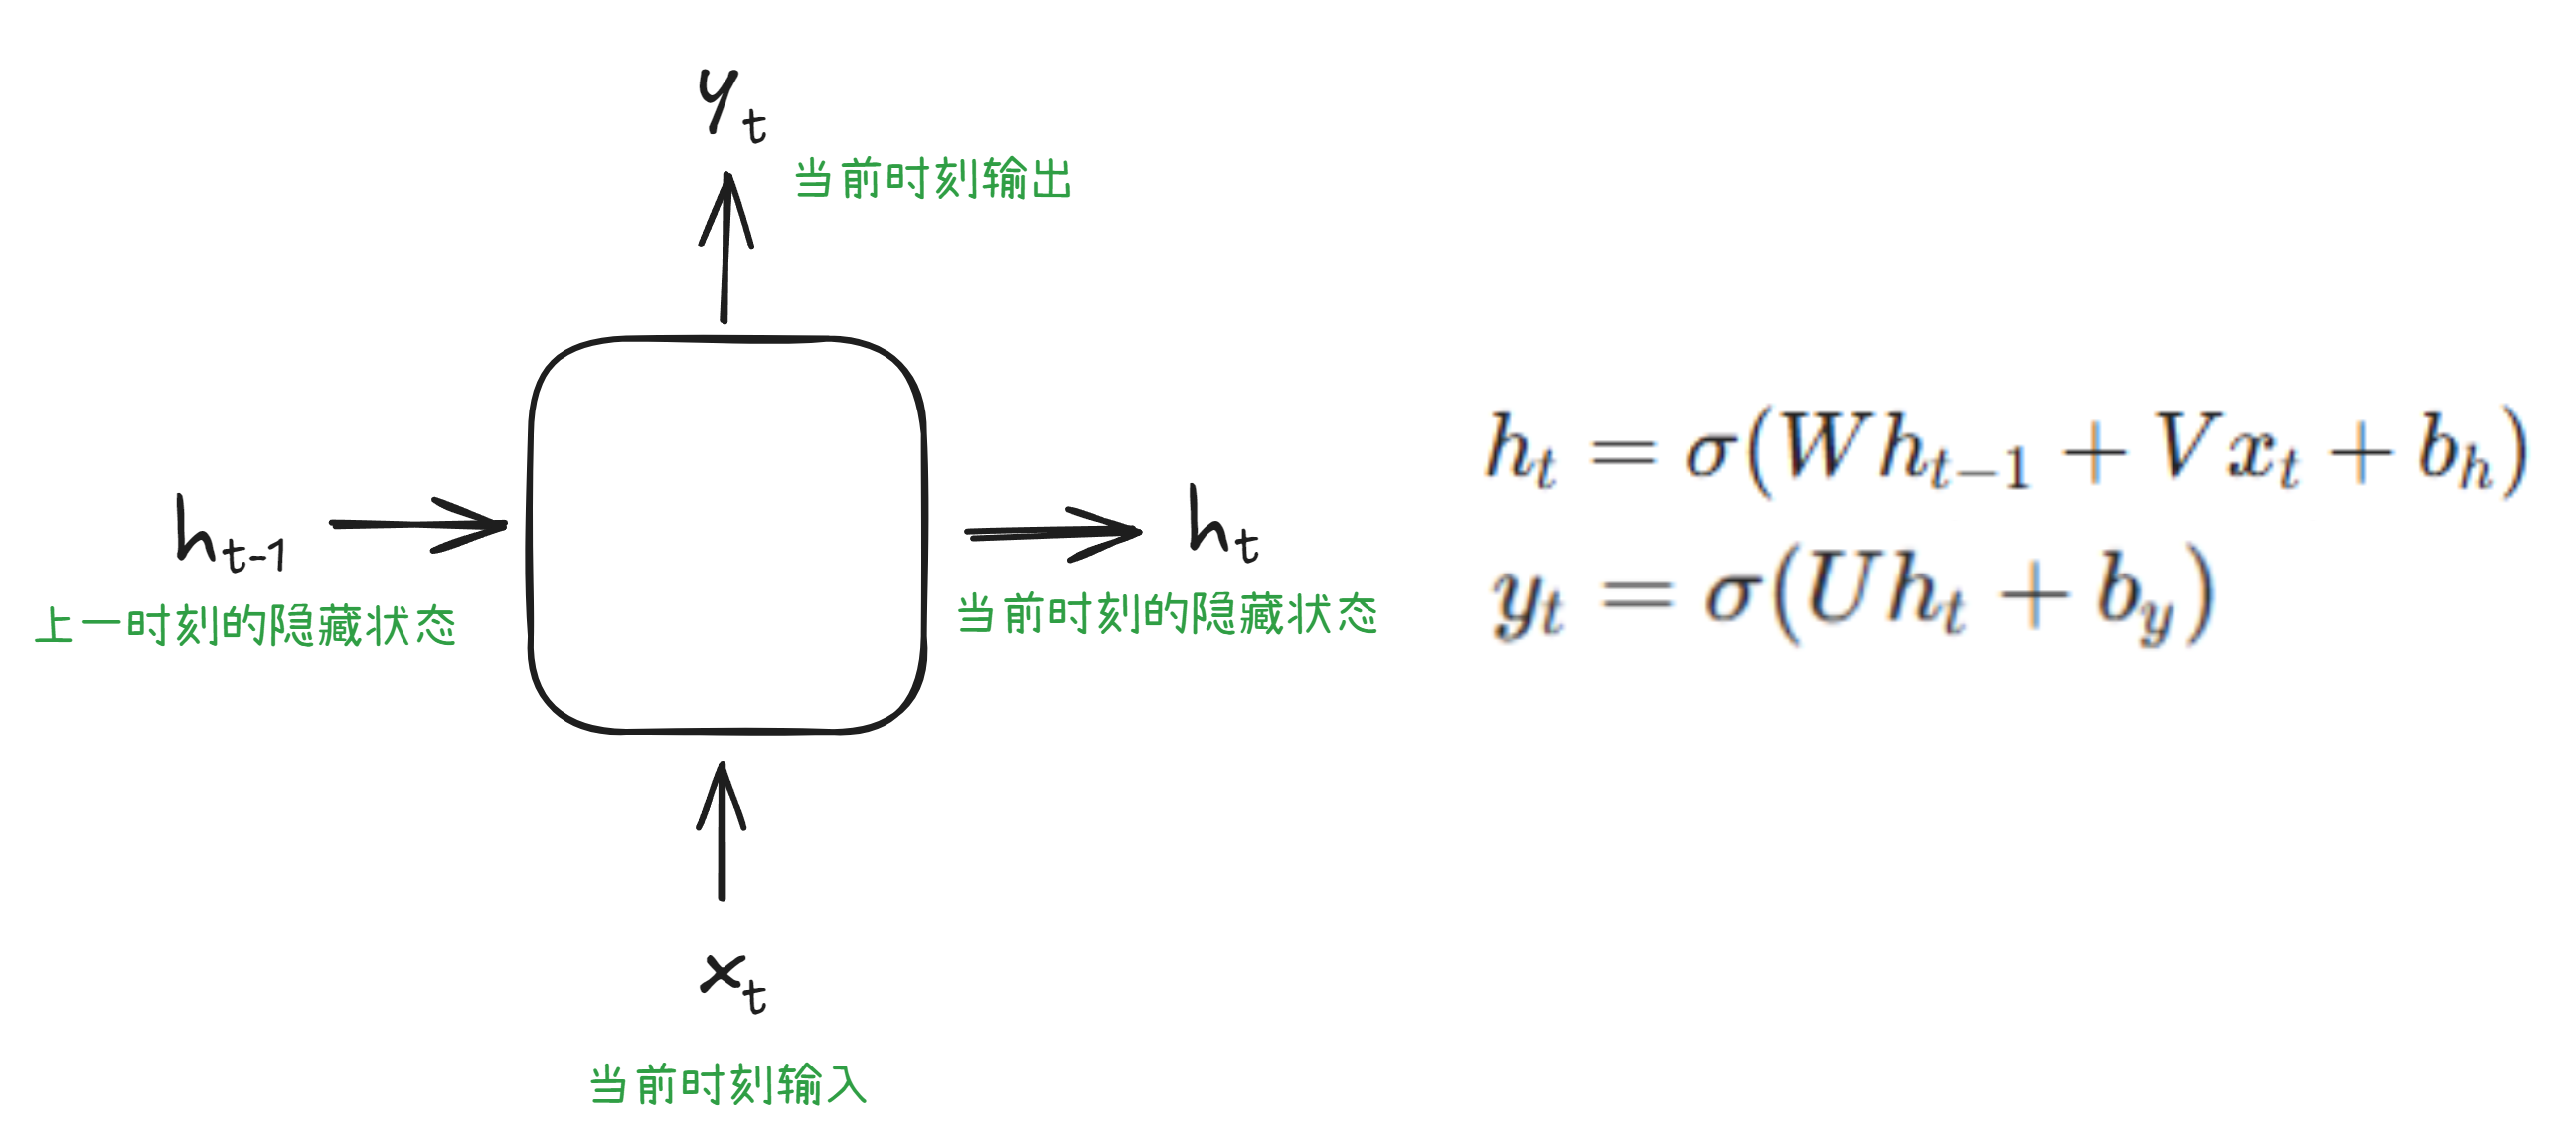
:激活函数
:权重矩阵
:偏置矩阵
RNN 结构特点
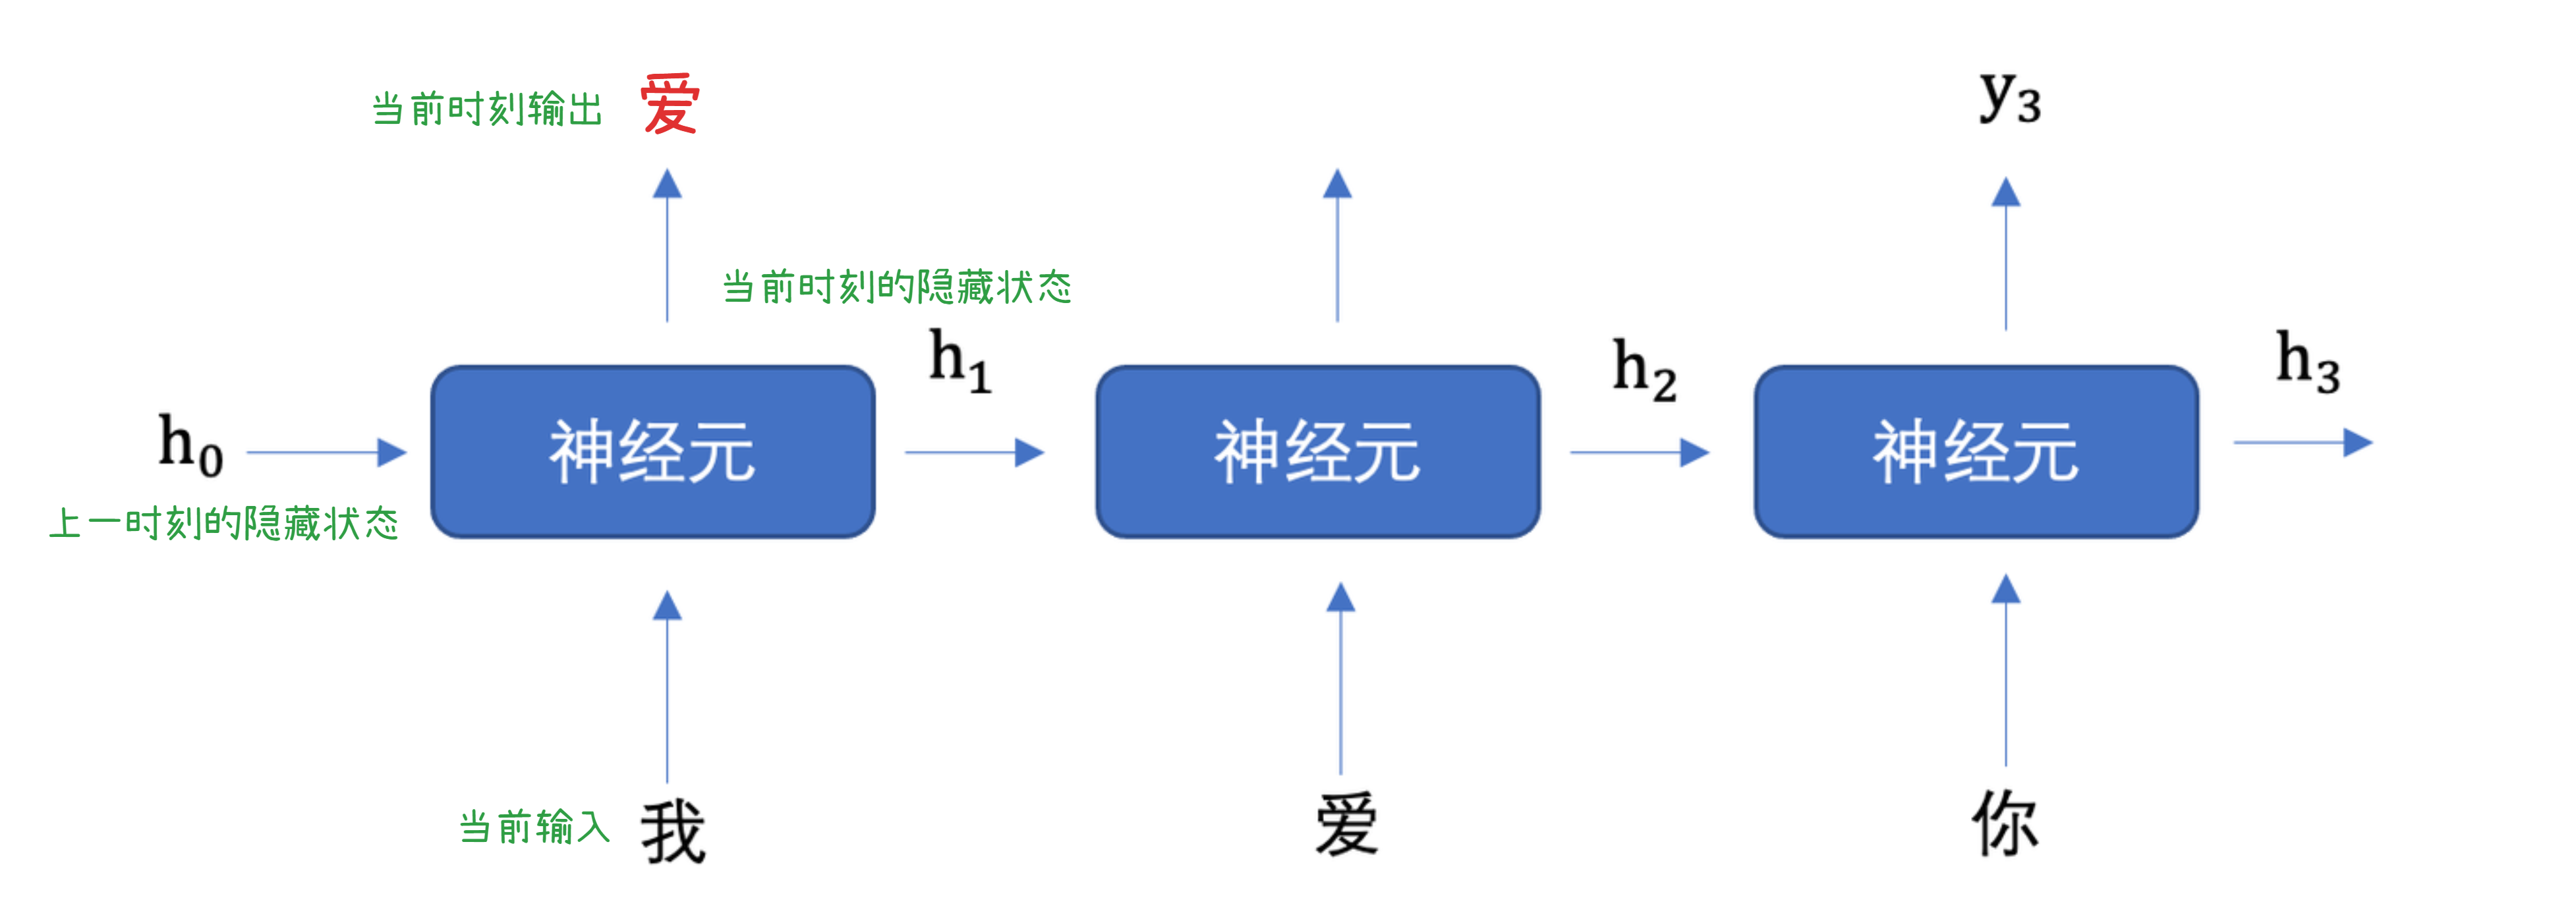
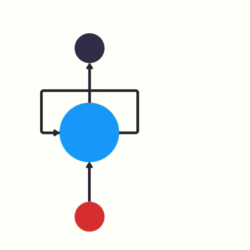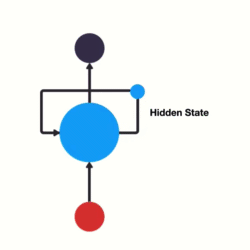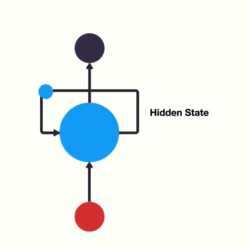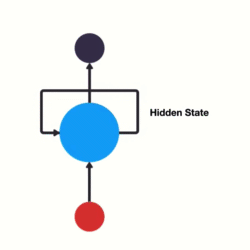
关键理解:
虽然画了多个神经元,实际上只有一个神经元
"我爱你"三个字是重复输入到同一个神经元
每个时间步共享相同的权重参数
核心公式
隐藏状态更新:
tanh:激活函数, :输出数据
:输出隐藏状态, :输入隐藏状态
:输入数据的权重, :输入隐藏状态的权重
:输入数据的偏置, :输入隐藏状态的偏置
网络输出:
当前时刻输出 = 输出层的权重矩阵 * 当前时刻隐藏状态 + 输出层的偏置项
隐藏状态映射为当前时间步输出
词汇表映射: 是一个向量,经过全连接层后得到 y_pred,其中每个元素代表当前时刻生成词汇表中某个词的得分(或概率)。
概率最大的 → 最终预测结果
API
RNN = nn.RNN(input_size, hidden_size,num_layers)


'''


input_size:词向量维度(输入数据维度)


hidden_size:隐藏层维度


num_layers:隐藏层数


'''
output, hn = RNN(x, h0)


'''


输入:x→[seq_len, batch, input_size]


       [句子长度, batch大小, 词向量维度]


输出:output→[seq_len, batch, hidden_size]


            [隐藏层的层数, batch大小, 隐藏层的维度]


初始隐藏状态:h0→[num_layers, batch, hidden_size]


最终隐藏状态:hn→[num_layers, batch, hidden_size]


               [句子长度, batch大小, 输出向量维度]


'''
代码示例:
import torch


import torch.nn as nn


def func():


    # 循环网络层


    rnn = nn.RNN(input_size=128, hidden_size=256, num_layers=1, batch_first=False)


    # 定义变量:输入 x


    x = torch.randn(5, 32, 128)


    # 定义变量:上一时刻的隐藏状态 h


    h0 = torch.randn(1, 32, 256)


    # 调用RNN,返回 预测值 output 和 隐藏状态 h_n


    output, h_n = rnn(x, h0)


    print(output.shape)


    print(h_n.shape)


func()