RNN
人名分类器
案例介绍
目的:基于给定的人名,判断其属于哪个国家
关于人名分类问题:
以一个人名为输入, 使用模型帮助我们判断它最有可能是来自哪一个国家的人名, 这在某些国际化公司的业务中具有重要意义, 在用户注册过程中, 会根据用户填写的名字直接给他分配可能的国家或地区选项, 以及该国家或地区的国旗, 限制手机号码位数等等
数据格式说明:每一行第一个单词为人名,第二个单词为国家名。中间用制表符tab(\t)分割
pythonAng Chinese AuYong Chinese Yuasa Japanese Yuhara Japanese Yunokawa Japanese
导入模块
import time     # 时间处理


import string   # 字符串处理


import torch    # 张量计算相关


import torch.nn as nn  # 神经网络


import torch.nn.functional as F # 常见的函数库,激活函数、损失函数等等


import torch.optim as optim     # 优化器


import matplotlib.pyplot as plt # 绘图


from torch.utils.data import Dataset, DataLoader  # 数据集,数据加载器


from tqdm import tqdm  # 进度条


plt.rcParams['font.sans-serif'] = ['SimHei']


plt.rcParams['axes.unicode_minus'] = False
数据预处理
获取常用的字符数量
python# 获取所有常用字符包括字母和常用标点 all_letters = string.ascii_letters + " .,;'" # 获取常用字符数量 n_letters = len(all_letters) print("n_letter:", n_letters)国家名种类数和个数
python# 国家名 种类数 categories = ['Italian', 'English', 'Arabic', 'Spanish', 'Scottish', 'Irish', 'Chinese', 'Vietnamese', 'Japanese', 'French', 'Greek', 'Dutch', 'Korean', 'Polish', 'Portuguese', 'Russian', 'Czech', 'German'] # 国家名 个数 category_num = len(categories) print('categorynum:', category_num)读取数据到内存
pythondef read_data(file_path): """ 读取数据,将人名(特征)和国家(标签)分别存储到列表中 :param file_path: 文件路径 :return: my_list_x, my_list_y """ my_list_x, my_list_y = [], [] with open(file_path, encoding='utf-8') as f: for line in f.readlines(): if len(line) <= 1: continue # 过滤无效数据 x, y = line.strip().split('\t') my_list_x.append(x) my_list_y.append(y) return my_list_x, my_list_y my_list_x, my_list_y = read_data('./data/name_classfication.txt') print('数据集大小:', len(my_list_x), len(my_list_y)) # 20074 20074 print('数据集:', my_list_x[:5], my_list_y[:5])构建数据源
pythonclass NameClassDataset(Dataset): """ 原始数据 -> 数据集 Dataset """ def __init__(self, my_list_x, my_list_y): self.my_list_x = my_list_x # 人名 self.my_list_y = my_list_y # 国家 self.sample_len = len(my_list_x) # 样本数量 # 获取数据集样本总数 def __len__(self): return self.sample_len # 获取指定索引的样本数据 def __getitem__(self, index): # 索引范围校验 index = min(max(index, 0), self.sample_len - 1) x = self.my_list_x[index] # Size = [名字的字母数量, 57] y = self.my_list_y[index] # (18个国家中的某个索引) # 人名数据 -> one-hot 张量 tensor_x = torch.zeros(len(x), n_letters) # 遍历人名,获取每个字母,生成one-hot张量 for li, letter in enumerate(x): tensor_x[li][all_letters.find(letter)] = 1 # 国家数据 -> 张量 tensor_y = torch.tensor(categories.index(y), dtype=torch.long) return tensor_x, tensor_y train_dataset = NameClassDataset(my_list_x, my_list_y) tensor_x, tensor_y = train_dataset[0] # Abl print(tensor_x, tensor_x.shape) print(tensor_y, tensor_y.shape)构建迭代器遍历数据
pythondef get_dataloader(): """ 数据集 Dataset -> 数据加载器 DataLoader """ my_list_x, my_list_y = read_data('./data/name_classfication.txt') name_class_dataset = NameClassDataset(my_list_x, my_list_y) dataLoader = DataLoader(name_class_dataset, batch_size=1, shuffle=True) # shfuffle=True 打乱数据 return dataLoader dataLoader = get_dataloader() x_count, y_count = 0, 0 for x, y in dataLoader: x_count, y_count = x_count + 1, y_count + 1 print(x.shape, y.shape) print(x_count, y_count)
构建RNN模型
传统RNN
pythonclass RNN_base(nn.Module): def __init__(self, input_size, hidden_size, output_size, num_layers=1): super().__init__() self.input_size = input_size self.hidden_size = hidden_size self.output_size = output_size self.num_layers = num_layers self.rnn = nn.RNN(self.input_size, self.hidden_size, self.num_layers) self.fc = nn.Linear(self.hidden_size, self.output_size) self.logsoftmax = nn.LogSoftmax(dim=-1) def forward(self, input, hidden): input = input.unsqueeze(1) # [seq_len, input_size] -> [seq_len, batch_size, input_size] # RNN output, hn = self.rnn(input, hidden) # 全连接层 tmp_output = output[-1] # 提取最后一个时间步的输出, 提取整个序列的最终特征表示 tmp_output = self.fc(tmp_output) # Softmax output = self.logsoftmax(tmp_output) return output, hn # 预测的类别概率分布, 最后一个时间步的隐藏状态 # 初始化隐藏状态 def init_hidden(self): return torch.zeros(self.num_layers, 1, self.hidden_size) # [num_layers, batch_size, hidden_size]pythondef t_rnn_model(): model = RNN_base(57, 128, 18) print(model) input = torch.randn(6, 57) h0 = model.init_hidden() output, hn = model(input, h0) print(output.shape, hn.shape) t_rnn_model()LSTM
pythonclass RNN_LSTM(nn.Module): def __init__(self, input_size, hidden_size, output_size, num_layers=1): super().__init__() self.input_size = input_size self.hidden_size = hidden_size self.output_size = output_size self.num_layers = num_layers self.lstm = nn.LSTM(self.input_size, self.hidden_size, self.num_layers) self.fc = nn.Linear(self.hidden_size, self.output_size) self.logsoftmax = nn.LogSoftmax(dim=-1) def forward(self, input, hidden, cell): input = input.unsqueeze(1) # [seq_len, input_size] -> [seq_len, batch_size, input_size] # LSTM output, (hn, cn) = self.lstm(input, (hidden, cell)) # output: 所有时间步的隐藏状态 # 全连接层 tmp_output = output[-1] # 提取最后一个时间步的输出, 提取整个序列的最终特征表示 tmp_output = self.fc(tmp_output) # Softmax output = self.logsoftmax(tmp_output) return output, (hn, cn) # 预测的类别概率分布, 最后一个时间步的隐藏状态, 最后一个时间步的细胞状态 # 初始化隐藏状态 def init_hidden(self): hidden = cell = torch.zeros(self.num_layers, 1, self.hidden_size) # [num_layers, batch_size, hidden_size] return hidden, cellpythondef t_rnn_model(): model = RNN_LSTM(57, 128, 18) print(model) input = torch.randn(6, 57) h0, c0 = model.init_hidden() output, (hn, cn) = model(input, h0, c0) print(output.shape, hn.shape, cn.shape) t_rnn_model()GRU
pythonclass RNN_GRU(nn.Module): def __init__(self, input_size, hidden_size, output_size, num_layers=1): super().__init__() self.input_size = input_size self.hidden_size = hidden_size self.output_size = output_size self.num_layers = num_layers self.gru = nn.GRU(self.input_size, self.hidden_size, self.num_layers) self.fc = nn.Linear(self.hidden_size, self.output_size) self.logsoftmax = nn.LogSoftmax(dim=-1) def forward(self, input, hidden): input = input.unsqueeze(1) # [seq_len, input_size] -> [seq_len, batch_size, input_size] # GRU output, hn = self.gru(input, hidden) # 全连接层 tmp_output = output[-1] # 提取最后一个时间步的输出, 提取整个序列的最终特征表示 tmp_output = self.fc(tmp_output) # Softmax output = self.logsoftmax(tmp_output) return output, hn # 预测的类别概率分布, 最后一个时间步的隐藏状态 # 初始化隐藏状态 def init_hidden(self): return torch.zeros(self.num_layers, 1, self.hidden_size) # [num_layers, batch_size, hidden_size]pythondef t_rnn_model(): model = RNN_base(57, 128, 18) print(model) input = torch.randn(6, 57) h0 = model.init_hidden() output, hn = model(input, h0) print(output.shape, hn.shape) t_rnn_model()对三个模型进行测试
pythondef t_rnn_lstm_gru(): # 数据处理 dataLoader = get_dataloader() # 创建模型 input_size, n_hidden, output_size = n_letters, 128, category_num rnn = RNN_base(input_size, n_hidden, output_size) lstm = RNN_LSTM(input_size, n_hidden, output_size) gru = RNN_GRU(input_size, n_hidden, output_size) print("模型结构:\n", rnn, lstm, gru) # 测试模型 for i, (x, y) in enumerate(dataLoader): if i == 1: break print(i, x, y) input = x[0] # RNN hidden = rnn.init_hidden() output, hn = rnn(input, hidden) print("RNN:\n", output, output.shape, hn.shape) # LSTM hidden, cell = lstm.init_hidden() output, (hn, cn) = lstm(input, hidden, cell) print("LSTM:\n", output, output.shape, hn.shape, cn.shape) # GRU hidden = gru.init_hidden() output, hn = gru(input, hidden) print("GRU:\n", output, output.shape, hn.shape) t_rnn_lstm_gru()
训练模型
lr, epochs = 1e-3, 10
def save_results(total_time, total_loss_list, total_acc_list, save_result, result_file):


    # 保存结果到文件


    if save_result:


        import pickle


        results = {


            'total_time': total_time,


            'total_loss_list': total_loss_list,


            'total_acc_list': total_acc_list,


        }


        import os


        os.makedirs(os.path.dirname(result_file), exist_ok=True)  # 创建目录


        with open(result_file, 'wb') as f:


            pickle.dump(results, f)


        print(f"训练结果已保存到 {result_file}")
def train_rnn(save_result=True, result_file='./results/rnn_results.pkl'):


    dataLoader = get_dataloader()


    input_size, n_hidden, output_size = n_letters, 128, category_num  # 48, 128, 18


    rnn = RNN_base(input_size, n_hidden, output_size)


    criterion = nn.NLLLoss()  # CrossEntropyLoss() = NLLLoss() + LogSoftmax()


    optimizer = optim.Adam(rnn.parameters(), lr)


    start_time= time.time()  # 开始时间


    total_iter_num = 0 # 已训练的样本数


    total_loss, total_loss_list = 0.0, []  # 总损失, 损失列表(每100个样本求一次平均损失,形成损失列表)


    total_acc_num, total_acc_list = 0, []  # 总准确数, 准确率列表(每100个样本求一次平均准确数,形成准确率列表)


    # 按轮次遍历数据集


    for epoch in range(epochs):


        print(f'Epoch:{epoch + 1}/{epochs}轮训练开始...')


        dataLoader = get_dataloader()


        # 按批次训练


        for i, (x, y) in enumerate(tqdm(dataLoader)):


            output, hidden = rnn(x[0], rnn.init_hidden())


            loss = criterion(output, y)


            # 梯度清零 + 反向传播 + 优化器更新参数


            optimizer.zero_grad()


            loss.backward()


            optimizer.step()


            # 统计数据


            total_iter_num += 1


            total_loss += loss.item()


            pred_tag = output.argmax(dim=1).item()  # 预测值


            total_acc_num += (1 if pred_tag == y.item() else 0)


            if total_iter_num % 100 == 0:


                avg_loss = total_loss / total_iter_num    # 平均损失


                total_loss_list.append(avg_loss)


                avg_acc = total_acc_num / total_iter_num  # 平均准确率


                total_acc_list.append(avg_acc)


            # 每2000个样本打印一次训练信息


            if total_iter_num % 2000 == 0:


                print(f'平均损失:{avg_loss:.4f}, 平均准确率:{avg_acc:.4f}, 训练时长:{time.time() - start_time:.0f}s')


        torch.save(rnn.state_dict(), f'./model/rnn/rnn_{epoch + 1}.bni')


        print(f'第{epoch + 1}轮训练结束,平均损失:{avg_loss:.4f}, 平均准确率:{avg_acc:.4f}, 训练时长:{time.time() - start_time:.0f}s')


    # 训练结束


    total_time = time.time() - start_time


    print(f'训练结束,总时长:{total_time:.0f}s, 共训练了{total_iter_num}个样本')


    # 保存结果到文件


    save_results(total_time, total_loss_list, total_acc_list, save_result, result_file)


    return total_time, total_loss_list, total_acc_list
def train_lstm(save_result=True, result_file='./results/lstm_results.pkl'):


    dataLoader = get_dataloader()


    input_size, n_hidden, output_size = n_letters, 128, category_num  # 48, 128, 18


    rnn = RNN_LSTM(input_size, n_hidden, output_size) # ******


    criterion = nn.NLLLoss()  # CrossEntropyLoss() = NLLLoss() + LogSoftmax()


    optimizer = optim.Adam(rnn.parameters(), lr)


    start_time= time.time()  # 开始时间


    total_iter_num = 0 # 已训练的样本数


    total_loss, total_loss_list = 0.0, []  # 总损失, 损失列表(每100个样本求一次平均损失,形成损失列表)


    total_acc_num, total_acc_list = 0, []  # 总准确数, 准确率列表(每100个样本求一次平均准确数,形成准确率列表)


    # 按轮次遍历数据集


    for epoch in range(epochs):


        print(f'Epoch:{epoch + 1}/{epochs}轮训练开始...')


        dataLoader = get_dataloader()


        # 按批次训练


        for i, (x, y) in enumerate(tqdm(dataLoader)):


            hidden, c = rnn.init_hidden()


            output, (hidden, c) = rnn(x[0], hidden, c)  # ******


            loss = criterion(output, y)


            # 梯度清零 + 反向传播 + 优化器更新参数


            optimizer.zero_grad()


            loss.backward()


            optimizer.step()


            # 统计数据


            total_iter_num += 1


            total_loss += loss.item()


            pred_tag = output.argmax(dim=1).item()  # 预测值


            total_acc_num += (1 if pred_tag == y.item() else 0)


            if total_iter_num % 100 == 0:


                avg_loss = total_loss / total_iter_num    # 平均损失


                total_loss_list.append(avg_loss)


                avg_acc = total_acc_num / total_iter_num  # 平均准确率


                total_acc_list.append(avg_acc)


            # 每2000个样本打印一次训练信息


            if total_iter_num % 2000 == 0:


                print(f'平均损失:{avg_loss:.4f}, 平均准确率:{avg_acc:.4f}, 训练时长:{time.time() - start_time:.0f}s')


        torch.save(rnn.state_dict(), f'./model/lstm/lstm_{epoch + 1}.bni')


        print(f'第{epoch + 1}轮训练结束,平均损失:{avg_loss:.4f}, 平均准确率:{avg_acc:.4f}, 训练时长:{time.time() - start_time:.0f}s')


    # 训练结束


    total_time = time.time() - start_time


    print(f'训练结束,总时长:{total_time:.0f}s, 共训练了{total_iter_num}个样本')


    # 保存结果到文件


    save_results(total_time, total_loss_list, total_acc_list, save_result, result_file)


    return total_time, total_loss_list, total_acc_list
def train_gru(save_result=True, result_file='./results/gru_results.pkl'):


    dataLoader = get_dataloader()


    input_size, n_hidden, output_size = n_letters, 128, category_num  # 48, 128, 18


    rnn = RNN_GRU(input_size, n_hidden, output_size)


    criterion = nn.NLLLoss()  # CrossEntropyLoss() = NLLLoss() + LogSoftmax()


    optimizer = optim.Adam(rnn.parameters(), lr)


    start_time= time.time()  # 开始时间


    total_iter_num = 0 # 已训练的样本数


    total_loss, total_loss_list = 0.0, []  # 总损失, 损失列表(每100个样本求一次平均损失,形成损失列表)


    total_acc_num, total_acc_list = 0, []  # 总准确数, 准确率列表(每100个样本求一次平均准确数,形成准确率列表)


    # 按轮次遍历数据集


    for epoch in range(epochs):


        print(f'Epoch:{epoch + 1}/{epochs}轮训练开始...')


        dataLoader = get_dataloader()


        # 按批次训练


        for i, (x, y) in enumerate(tqdm(dataLoader)):


            output, hidden = rnn(x[0], rnn.init_hidden())


            loss = criterion(output, y)


            # 梯度清零 + 反向传播 + 优化器更新参数


            optimizer.zero_grad()


            loss.backward()


            optimizer.step()


            # 统计数据


            total_iter_num += 1


            total_loss += loss.item()


            pred_tag = output.argmax(dim=1).item()  # 预测值


            total_acc_num += (1 if pred_tag == y.item() else 0)


            if total_iter_num % 100 == 0:


                avg_loss = total_loss / total_iter_num    # 平均损失


                total_loss_list.append(avg_loss)


                avg_acc = total_acc_num / total_iter_num  # 平均准确率


                total_acc_list.append(avg_acc)


            # 每2000个样本打印一次训练信息


            if total_iter_num % 2000 == 0:


                print(f'平均损失:{avg_loss:.4f}, 平均准确率:{avg_acc:.4f}, 训练时长:{time.time() - start_time:.0f}s')


        torch.save(rnn.state_dict(), f'./model/gru/gru_{epoch + 1}.bni')


        print(f'第{epoch + 1}轮训练结束,平均损失:{avg_loss:.4f}, 平均准确率:{avg_acc:.4f}, 训练时长:{time.time() - start_time:.0f}s')


    # 训练结束


    total_time = time.time() - start_time


    print(f'训练结束,总时长:{total_time:.0f}s, 共训练了{total_iter_num}个样本')


    # 保存结果到文件


    save_results(total_time, total_loss_list, total_acc_list, save_result, result_file)


    return total_time, total_loss_list, total_acc_list
if __name__ == '__main__':


    train_rnn()


    train_lstm()


    train_gru()
绘图:对比三个模型
import pickle


# 从保存的文件中加载结果


def load_data(file_path):


    with open(file_path, 'rb') as f:


        results = pickle.load(f)


    # 返回训练时间、损失列表和准确率列表


    return results['total_time'], results['total_loss_list'], results['total_acc_list']
def test_train_rnn_lstm_gru():


    total_time_rnn, total_loss_list_rnn, total_acc_list_rnn = load_data('./results/rnn_results.pkl')


    total_time_lstm, total_loss_list_lstm, total_acc_list_lstm = load_data('./results/lstm_results.pkl')


    total_time_gru, total_loss_list_gru, total_acc_list_gru = load_data('./results/gru_results.pkl')


    # 绘制:损失曲线(评估:模型的收敛速度)


    plt.figure(0, figsize=(10, 5))


    plt.plot(total_loss_list_rnn, label='RNN')


    plt.plot(total_loss_list_lstm, label='LSTM')


    plt.plot(total_loss_list_gru, label='GRU')


    plt.title('模型损失对比曲线')


    plt.xlabel('训练步数(每100步)')


    plt.ylabel('平均损失值')


    plt.grid(True, linestyle='--', alpha=0.5)  # 网格线


    plt.legend(loc='upper left')  # 图例


    plt.savefig('./img/RNN_LSTM_GRU_loss.png')


    plt.show()


    # 绘制:训练耗时对比柱状图(评估:模型的计算效率)


    plt.figure(1, figsize=(10, 5))


    plt.bar(range(len(['RNN','LSTM','GRU'])),


            [total_time_rnn, total_time_lstm, total_time_gru],


            tick_label=['RNN','LSTM','GRU'],


            )


    plt.title('模型耗时对比柱状图')


    plt.savefig('./img/RNN_LSTM_GRU_time.png')


    plt.show()


    # 绘制:准确率对比曲线(评估:模型预测的准确度)


    plt.figure(2, figsize=(10, 5))


    plt.plot(total_acc_list_rnn, label='RNN')


    plt.plot(total_acc_list_lstm, label='LSTM')


    plt.plot(total_acc_list_gru, label='GRU')


    plt.title('模型准确率对比曲线')


    plt.ylabel('平均准确率')


    plt.legend(loc='upper left')


    plt.savefig('./img/RNN_LSTM_GRU_acc.png')


    plt.show()


test_train_rnn_lstm_gru()
模型预测
rnn_model = './model/rnn/rnn_10.bni'


lstm_model = './model/lstm/lstm_10.bni'


gru_model = './model/gru/gru_10.bni'


# 将要预测的人名转成 one-hot 编码


def lineToTensor(line):


    # 初始化张量:[文本长度, 字符表长度]


    tensor_x = torch.zeros(len(line), n_letters)


    # 遍历文本,获取每个字符及其索引


    for li, letter in enumerate(line):


        # 查找字符在全局字符表中的索引,并将该索引位置置为 1


        tensor_x[li][all_letters.find(letter)] = 1


    return tensor_x


def predict_rnn(x):


    n_letter, n_hidden, n_categories = n_letters, 128, category_num


    x_tensor = lineToTensor(x)


    rnn = RNN_base(n_letter, n_hidden, n_categories)


    rnn.load_state_dict(torch.load(rnn_model))


    # 进行预测,不计算梯度


    with torch.no_grad():


        output, hidden = rnn(x_tensor, rnn.init_hidden())


        # 从预测结果中去概率最大的3个类别


        # (取前3个最大的元素, 取概率最大的元素的维度, 是否对结果进行排序)


        topv, topi = output.topk(3, 1, largest=True)


        print(f'rnn -> {x}')  # 打印预测结果


        # 解析预测结果


        for i in range(3):  # 遍历预测结果


            value = topv[0][i].item()    # 概率值 -> 标量


            category_idx = topi[0][i].item()    # 索引


            category = categories[category_idx] # 类别


            print(f'value:{value:.4f}, category:{category}')


predict_rnn('zhang')
Seq2seq 英译法
案例介绍
使用 基于GRU的seq2seq模型架构 实现翻译
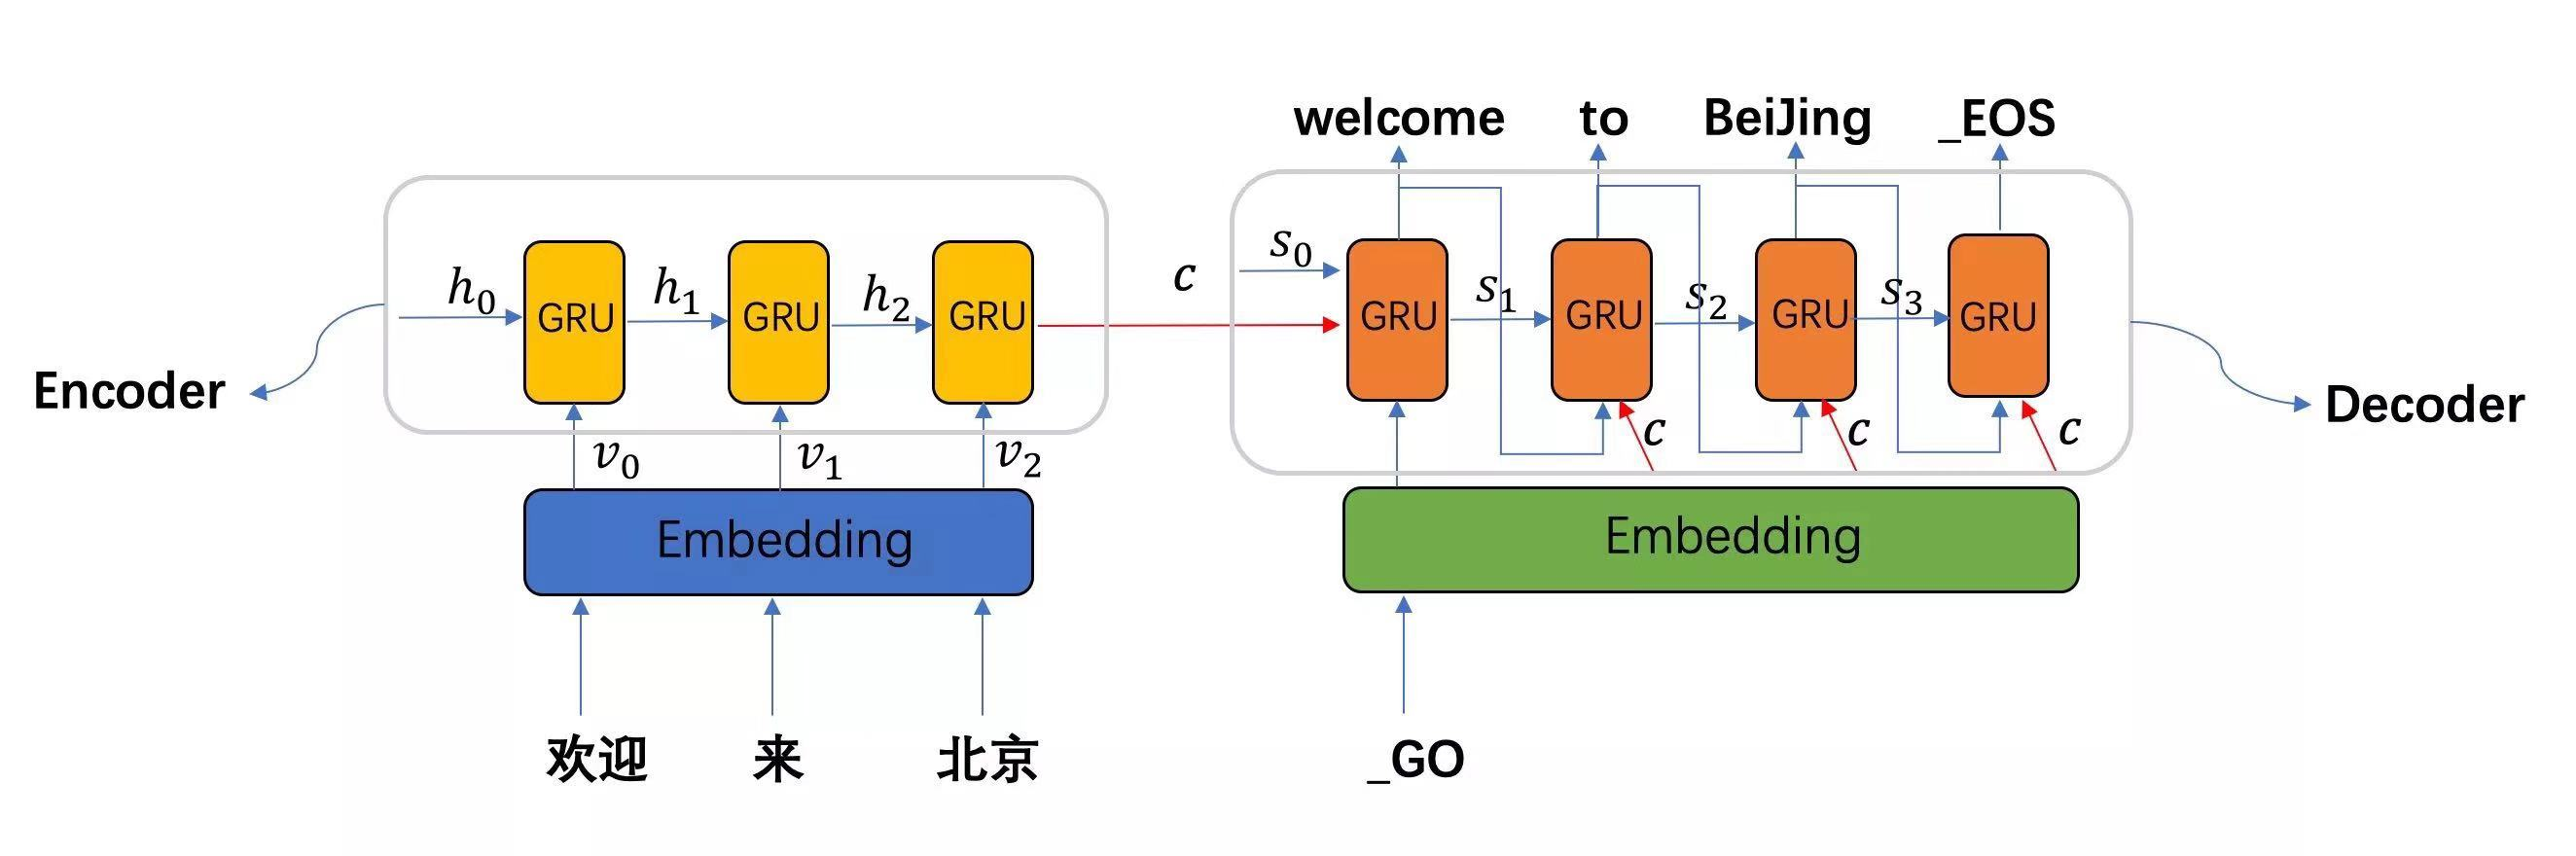
seq2seq模型架构分析:
seq2seq模型架构包括三部分,分别是encoder(编码器)、decoder(解码器)、中间语义张量c。其中编码器和解码器的内部实现都使用了GRU模型
图中表示的是一个中文到英文的翻译:欢迎 来 北京 → welcome to BeiJing。编码器首先处理中文输入"欢迎 来 北京",通过GRU模型获得每个时间步的输出张量,最后将它们拼接成一个中间语义张量c;接着解码器将使用这个中间语义张量c以及每一个时间步的隐层张量, 逐个生成对应的翻译语言
数据集介绍
eng-fra-v2.txtpythoni am from brazil . je viens du bresil . i am from france . je viens de france . i am from russia . je viens de russie . i am frying fish . je fais frire du poisson . i am not kidding . je ne blague pas . i am on duty now . maintenant je suis en service . i am on duty now . je suis actuellement en service . i am only joking . je ne fais que blaguer . i am out of time . je suis a court de temps . i am out of work . je suis au chomage . i am out of work . je suis sans travail . i am paid weekly . je suis payee a la semaine . i am pretty sure . je suis relativement sur . i am truly sorry . je suis vraiment desole . i am truly sorry . je suis vraiment desolee .
导入模块
模块
python# 用于正则表达式 import re # 用于构建网络结构和函数的torch工具包 import torch import torch.nn as nn import torch.nn.functional as F from torch.utils.data import Dataset, DataLoader import torch.optim as optim # torch中预定义的优化方法工具包 import time # 用于计算时间 import random # 用于随机生成数据 import matplotlib.pyplot as plt # 用于绘图 from tqdm import tqdm # 进度条 # 解决显示中文乱码问题 plt.rcParams['font.sans-serif'] = ['SimHei'] plt.rcParams['axes.unicode_minus'] = False设备选择
python# 设备选择, 选择在cuda或者cpu上运行 device = torch.device("cuda" if torch.cuda.is_available() else "cpu") print(device)指定特殊token
python# 指定特殊token SOS_token = 0 # 起始标志 EOS_token = 1 # 结束标志 MAX_LENGTH = 10 # 最大句子长度 (包含标点) data_path = './data/Seq2Seq/eng-fra-v2.txt'
数据预处理
字符串规范化处理
python# 字符串规范化处理 def normalizeString(s): """ 字符串规范化 :param s: 需要处理的字符串 :return: 规范化后的字符串 """ s = s.lower().strip() # 转小写并去除空格 s = re.sub(r"([.!?])", r" \1", s) # 在 .!? 前添加空格 s = re.sub(r"[^a-zA-Z.!?]+", r" ", s) # 过滤非标准字符,保留大小写字母和基本标点符号 return s # res = normalizeString('HELLO world! #@$%^&*()_+-= 你好') # print(res)构建文本字典
python# 构建文本字典 def get_data(): with open(data_path, 'r', encoding='utf-8') as src_f: lines = src_f.readlines() # 读取所有行 # 清洗数据并构建双语句子树 pairsrc_data = [[normalizeString(s) for s in line.split('\t')] for line in lines] # 构建 英语词汇表和法语词汇表 # 构建 "单词到索引" 的字典映射表 english_word2index = {"SOS": SOS_token, "EOS": EOS_token} french_word2index = {"SOS": SOS_token, "EOS": EOS_token} english_word_n = 2 # 英语词汇表大小计数器 french_word_n = 2 # 法语词汇表大小计数器 # 构建词汇表 for pair in pairsrc_data: # 将英语句子转换成单词列表,并添加到英语词汇表中 word_list = pair[0].split(' ') for word in word_list: if word not in english_word2index: english_word2index[word] = english_word_n english_word_n += 1 # 将法语句子转换成单词列表,并添加到法语词汇表中 for word in pair[1].split(' '): if word not in french_word2index: french_word2index[word] = french_word_n french_word_n += 1 # 构建"索引到单词的字典映射表(反向映射表) english_index2word = {index: word for word, index in english_word2index.items()} french_index2word = {index: word for word, index in french_word2index.items()} return english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data # english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() # print(len(english_word2index)) # 2803 # print(len(french_word2index)) # 4345 # print(english_word_n, french_word_n) # 2803 4345 # print(pairsrc_data[:2]) # # [['i m .', 'j ai ans .'], ['i m ok .', 'je vais bien .']]构建 数据集对象
python# 构建 数据集对象(DataSet) class PairsDataset(Dataset): def __init__(self, pairsrc_data): # 双语句子对数据 self.pairsrc_data = pairsrc_data # [[e_sen1, f_sen1], [e_sen2, f_sen2], ...]] # 样本总数 self.sample_len = len(self.pairsrc_data) # 获取样本总数 def __len__(self): return self.sample_len # 获取样本 def __getitem__(self, index): # 修正索引值:索引值越界处理 index = min(max(index, 0), self.sample_len - 1) # 获取数据:双语句子对 x = self.pairsrc_data[index][0] y = self.pairsrc_data[index][1] # 文本转数值:文本 -> 索引列表 x = [english_word2index[word] for word in x.split(' ')] x.append(english_word2index['EOS']) y = [french_word2index[word] for word in y.split(' ')] y.append(french_word2index['EOS']) # 数值转张量:list -> tensor x_tensor = torch.tensor(x, dtype=torch.long, device=device) y_tensor = torch.tensor(y, dtype=torch.long, device=device) return x_tensor, y_tensor # 英语句子,法语句子 # 构建 数据加载器对象(DataLoader) def get_dataloader(batch_size=1): # 实例化 数据集对象 dataset = PairsDataset(pairsrc_data) # 创建 数据加载器对象 dataloader = DataLoader(dataset, batch_size=batch_size, shuffle=True) return dataloader # english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() # dataloader = get_dataloader() # for i ,(x, y) in enumerate(dataloader): # print(x.shape, y.shape) # if i == 5: break
模型搭建
构建编码器
python# 构建编码器 Encoder(基于GRU) class EncoderRNN(nn.Module): def __init__(self, input_size, hidden_size=256): """ :param input_size: 编码器词嵌入层的输入维度,即词汇表的大小 :param hidden_size: 编码器隐藏层的维度,即:隐藏层单元的个数 """ super().__init__() self.input_size = input_size self.hidden_size = hidden_size self.embedding = nn.Embedding(input_size, hidden_size) # GRU # batch_first=True: [batch_size, seq_len, hidden_size] 而不是 [seq_len, batch_size, hidden_size] self.gru = nn.GRU(hidden_size, hidden_size, batch_first=True) def forward(self, input, hidden): """ :param input: 输入的索引序列,维度为 [batch_size, seq_len] :param hidden: 隐藏层初始状态,维度为 [num_layers, batch_size, hidden_size] :return: 输出和隐藏层状态 """ embedded = self.embedding(input) output, hidden = self.gru(embedded, hidden) return output, hidden def init_hidden(self): """ 初始化隐藏层状态 :return: 隐藏层状态,维度为 [num_layers, batch_size, hidden_size] """ return torch.zeros(1, 1, self.hidden_size, device=device)构建解码器(无Attention)
python# 构建解码器(无Attention) class DecoderRNN(nn.Module): def __init__(self, output_size, hidden_size=256): """ :param output_size: 解码器输出的维度,即:输出词表的大小 :param hidden_size: 解码器隐藏层的维度,即:每个词向量的特征数 """ super().__init__() self.output_size = output_size self.hidden_size = hidden_size # [batch_size, seq_len] -> [batch_size, seq_len, hidden_size] self.embedding = nn.Embedding(output_size, hidden_size) # GRU # batch_first=True: [seq_len, batch_size, hidden_size] -> [batch_size, seq_len, hidden_size] self.gru = nn.GRU(hidden_size, hidden_size, batch_first=True) self.out = nn.Linear(hidden_size, output_size) self.softmax = nn.LogSoftmax(dim=-1) def forward(self, input, hidden): embedded = self.embedding(input) relu = F.relu(embedded) out, hidden = self.gru(relu, hidden) out = self.out(out[0]) # [batch_size, seq_len, hidden_size] -> [batch_size, hidden_size] output = self.softmax(out) # [batch_size, hidden_size] -> [batch_size, output_size] return output, hidden def init_hidden(self): """ 初始化隐藏层状态 :return: 隐藏层状态,维度为 [num_layers, batch_size, hidden_size] """ return torch.zeros(1, 1, self.hidden_size, device=device)测试编码器和解码器
python# 测试编码器 def encoder_test(): english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() dataloader = get_dataloader() encoder = EncoderRNN(english_word_n).to(device) print(encoder) for i, (x, y) in enumerate(dataloader): if i == 5: break h0 = encoder.init_hidden() output, hn = encoder(x, h0) print(output.shape) # 测试解码器 def dncoder_test(): english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() dataloader = get_dataloader() decoder = DecoderRNN(english_word_n).to(device) print(decoder) for i, (x, y) in enumerate(dataloader): if i == 5: break h0 = decoder.init_hidden() output, hn = decoder(x, h0) print(output.shape) # 测试编码器和解码器 def encoder_decoder_test(): english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() dataloader = get_dataloader() encoder = EncoderRNN(english_word_n).to(device) decoder = DecoderRNN(french_word_n).to(device) for i, (x, y) in enumerate(dataloader): if i == 5: break # print("英语句子:", x.shape, x) # [1, 词数] # print("法语句子:", y.shape, y) # [1, 词数] # 编码 h0 = encoder.init_hidden() output, hn = encoder(x, h0) for w in range(y.shape[1]): # 遍历句子的每个时间步 # y[0][w] 获取batch中的第一个句子的第w个单词 # view(1, -1) 改变tmp的形状为[1, 1],匹配解码器输入的要求 tmp = y[0][w].view(1, -1) # 解码 output, hidden = decoder(tmp, hn) print("输出:", output.size(), output) # english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() # encoder_test() # dncoder_test() # encoder_decoder_test()构建解码器(带Attention)
python# 构建解码器(带Attention) class AttnDecoderRNN(nn.Module): def __init__(self, output_size, hidden_size=256, dropout_p=0.1, max_length=MAX_LENGTH): """ :param output_size: 解码器输出的维度,即:输出词表的大小 :param hidden_size: 解码器隐藏层的维度,即:每个词向量的特征数 :param dropout: 随机失活概率,防止过拟合 :param max_length: 句子最大长度,限制注意力计算的范围 """ super().__init__() self.output_size = output_size self.hidden_size = hidden_size self.dropout_p = dropout_p self.max_length = max_length # 词嵌入层 # [batch_size, seq_len] -> [batch_size, seq_len, hidden_size] self.embedding = nn.Embedding(output_size, hidden_size) # 注意力权重计算层:计算 查询张量 和 编码器输出张量 的匹配程度 # (查询张量和隐藏状态, 注意力权重分布) self.attn = nn.Linear(self.hidden_size * 2, self.max_length) # 随机失活层 self.dropout = nn.Dropout(self.dropout_p) # 注意力融合层:将 词嵌入和注意力权重 进行融合 self.attn_combine = nn.Linear(self.hidden_size * 2, self.hidden_size) # GRU:处理序列数据,维持隐藏状态 # batch_first=True: [seq_len, batch_size, hidden_size] -> [batch_size, seq_len, hidden_size] self.gru = nn.GRU(hidden_size, hidden_size, batch_first=True) # 输出层 self.out = nn.Linear(hidden_size, output_size) # 激活层 self.softmax = nn.LogSoftmax(dim=-1) def forward(self, input, hidden, encoder_outputs): """ :param input: 输入张量,维度为 [batch_size, 1] :param hidden: 隐藏层状态,维度为 [1, batch_size, hidden_size] :param encoder_outputs: 编码器所有时间步的输出,维度为 [batch_size, seq_len, hidden_size] :return: 输出张量,维度为 [batch_size, output_size] :return: 隐藏层状态,维度为 [1, batch_size, hidden_size] """ embedded = self.embedding(input) # 词嵌入层 embedded = self.dropout(embedded) # 随机失活 attn = self.attn(torch.cat((embedded[0], hidden[0]), -1)) # 融合(词嵌入和隐藏状态),然后映射到注意力长度,即:[1:Max_Length] attn_weights = F.softmax(attn, dim=-1) # 注意力权重 attn_applied = torch.bmm(attn_weights.unsqueeze(0), encoder_outputs.unsqueeze(0)) # 计算注意力上下文 self.attn_combined = self.attn_combine(torch.cat((embedded[0], attn_applied[0]), -1)).unsqueeze(0) # 注意力融合层(词嵌入和注意力权重) relu = F.relu(self.attn_combined) # 激活层 out, hidden = self.gru(relu, hidden) # GRU层 out = self.out(out[0]) # 输出层 output = self.softmax(out) # 激活层 return output, hidden, attn_weights def init_hidden(self): """ 初始化隐藏层状态 :return: 隐藏层状态,维度为 [num_layers, batch_size, hidden_size] """ return torch.zeros(1, 1, self.hidden_size, device=device)测试编码器和解码器(带Attention)
python# 测试编码器和解码器(带Attention) def encoder_atte_decoder_test(): english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() dataloader = get_dataloader() encoder = EncoderRNN(english_word_n).to(device) decoder = AttnDecoderRNN(french_word_n).to(device) for i, (x, y) in enumerate(dataloader): print("输入:", x) # 编码 h0 = encoder.init_hidden() output, hn = encoder(x, h0) # 中间语义张量C: [batch_size, seq_len, hidden_size] -> [seq_len, hidden_size] # 创建1个固定大小的张量,用于存储编码器的输出,[句长最大长度, 隐藏层维度] encoder_outputs = torch.zeros(MAX_LENGTH, encoder.hidden_size, device=device) for index in range(output.shape[1]): encoder_outputs[index] = output[0][index] print("编码器输出:", encoder_outputs.size(), encoder_outputs) # 解码 for w in range(y.shape[1]): # 遍历句子的每个时间步 # y[0][w] 获取batch中的第一个句子的第w个单词 # view(1, -1) 改变tmp的形状为[1, 1],匹配解码器输入的要求 tmp = y[0][w].view(1, -1) # 解码 output, hidden, attn_wights = decoder(tmp, hn, encoder_outputs) print("输出:", output.size(), output) print("隐藏层:", hidden.size()) print("注意力权重:", attn_wights.size(), attn_wights) print("-" * 20) break # english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() # encoder_atte_decoder_test()
模型训练
- teacher_forcing
一种用于序列生成任务的训练技巧
在seq2seq架构中, 根据循环神经网络理论,解码器每次应该使用上一步的结果作为输入的一部分, 但是训练过程中,一旦上一步的结果是错误的,就会导致这种错误被累积,无法达到训练效果
因为训练时我们是已知正确的输出应该是什么,因此可以强制将上一步结果设置成正确的输出,这种方式就叫做 teacher_forcing
能够在训练的时候矫正模型的预测,避免在序列生成的过程中误差进一步放大
能够极大的加快模型的收敛速度,令模型训练过程更快更平稳
纠正错误,避免“错误越来越离谱”
加速训练,让摩西你“学得更快,更稳”
模型训练参数
python# 模型训练参数 # 学习率,训练轮数,teacher_forcing_ratio比例为0.5,输出预测结果间隔轮数,绘图间隔轮数 lr, epochs, teacher_forcing_ratio, print_interval_num, plot_interval_num = 1e-3, 1, 0.5, 1000, 100模型内部迭代训练
python# 模型内部迭代训练,即:单批次训练 def train_iters(x, y, encoder_rnn, attn_decoder_rnn, adam_encoder, adam_decoder, cross_entropy_loss): """ 实现:单批次训练,完成1个样本的 编码 -> 解码 -> 反向传播 -> 优化参数 ... :param x: 输入序列 -> [batch_size=1, seq_len] :param y: 目标序列 -> [batch_size=1, seq_len] :param encoder_rnn: 编码器 :param attn_decoder_rnn: 解码器(带attention) :param adam_encoder: 编码模型 优化器 :param adam_decoder: 解码模型 优化器 :param cross_entropy_loss: 损失函数 :return: 平均损失 """ # 1. 编码 encoder_hidden = encoder_rnn.init_hidden() encoder_output, encoder_hidden = encoder_rnn(x, encoder_hidden) # 固定大小存储 编码输出序列 encoder_output_c = torch.zeros(MAX_LENGTH, encoder_rnn.hidden_size, device=device) for i in range(x.size(0)): # 遍历编码输出序列 encoder_output_c[i] = encoder_output[0][i] # 2. 解码 decoder_hidden = encoder_hidden input_y = torch.tensor([[SOS_token]], device=device) # 初始输入:[batch_size=1, seq_len=1] loss = 0.0 # 是否使用教师 forcing use_teacher_forcing = True if random.random() < teacher_forcing_ratio else False if use_teacher_forcing: for i in range(y.shape[1]): # 遍历目标序列 output_y, decoder_hidden, attn_weight = attn_decoder_rnn(input_y, decoder_hidden, encoder_output_c) # 获取真实标签 target_y = y[0][i].view(1) # 计算损失 loss += cross_entropy_loss(output_y, target_y) # 更新输入:直接使用真实标签 input_y = target_y.view(1, -1) else: for i in range(y.shape[1]): # 遍历目标序列 output_y, decoder_hidden, attn_weight = attn_decoder_rnn(input_y, decoder_hidden, encoder_output_c) # 获取真实标签 target_y = y[0][i].view(1) # 计算损失 loss += cross_entropy_loss(output_y, target_y) # 获取预测标签 _, top_index = output_y.topk(1) # topk 取最大值 # 如何预测标签为结束标签,则结束循环 if top_index.squeeze().item() == EOS_token: break input_y = top_index.detach() # [batch_size=1, seq_len=1] # 3. 反向传播 + 优化参数 adam_encoder.zero_grad() adam_decoder.zero_grad() loss.backward() adam_encoder.step() adam_decoder.step() return loss.item() / y.shape[1] # 平均损失模型训练
pythondef train_seq2seq(): dataLoader = get_dataloader() encoder_rnn = EncoderRNN(english_word_n).to(device) decoder_rnn = AttnDecoderRNN(french_word_n).to(device) adam_encoder = optim.Adam(encoder_rnn.parameters(), lr) adam_decoder = optim.Adam(decoder_rnn.parameters(), lr) loss_fn = nn.NLLLoss() # cross_entropy = log_softmax + nll_loss plot_loss_list = [] # 绘图时使用的损失列表 # 循环训练 for epoch in range(1, epochs+1): print_loss_total, plot_loss_total = 0.0, 0.0 # 打印时总损失,绘图时的损失 start_time = time.time() # 循环数据集 for i, (x, y) in enumerate(tqdm(dataLoader), start=1): x, y = x.to(device), y.to(device) loss = train_iters(x, y, encoder_rnn, decoder_rnn, adam_encoder, adam_decoder, loss_fn) print_loss_total += loss plot_loss_total += loss # 打印训练日志 if i % print_interval_num == 0: print_loss_avg = print_loss_total / print_interval_num print_loss_total = 0.0 # 重置打印时总损失 print(f"轮次:{epoch}/{epochs},总损失:{print_loss_avg:.4f},耗时:{time.time()-start_time:.2f}s") # 绘图 if i % plot_interval_num == 0: plot_loss_avg = plot_loss_total / plot_interval_num plot_loss_list.append(plot_loss_avg) plot_loss_total = 0.0 # # 【测试代码】训练3000个样本后结束训练 # if i == 3000: # break # 保存模型 torch.save(encoder_rnn.state_dict(), f"./model/seq2seq/encoder_{epoch}.pth") torch.save(decoder_rnn.state_dict(), f"./model/seq2seq/decoder_{epoch}.pth") # 绘制损失曲线 plt.figure() plt.plot(plot_loss_list) plt.savefig("./img/seq2seq/avg_loss.png") plt.show() return plot_loss_list # 返回损失列表, 每训练100个样本的平均损失 # english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() # train_seq2seq()
模型评估
内部评估代码
python# 用训练好的模型进行翻译 def evaluate_seq2seq(x, encoder, decoder): # 关闭梯度计算,节省内存并加速推理 with torch.no_grad(): # 编码:输入的英文句子 -> 隐藏状态 encoder_hidden = encoder.init_hidden() encoder_output, encoder_hidden = encoder(x, encoder_hidden) encoder_output_c = torch.zeros(MAX_LENGTH, encoder.hidden_size, device=device) for index in range(x.shape[1]): encoder_output_c[index] = encoder_output[0, index] # 解码:隐藏状态 -> 法文句子 decoder_hidden = encoder_hidden input_y = torch.tensor([[SOS_token]], device=device) # 存储翻译结果列表 decode_words = [] # 注意力矩阵 decoder_attentions = torch.zeros(MAX_LENGTH, MAX_LENGTH) # 开始解码 for index in range(MAX_LENGTH): output_y, decoder_hidden, attn_wight = decoder(input_y, decoder_hidden, encoder_output_c) decoder_attentions[index] = attn_wight # 记录注意力矩阵 topy, topi = output_y.topk(1) # 预测下一个词(概率最高的词) if topi.squeeze().item() == EOS_token: # 若预测的词是结束词,则添加结束符并结束解码 decode_words.append('<EOS>') break else: # 否则,添加预测的词到翻译结果列表中 decode_words.append(french_index2word[topi.squeeze().item()]) input_y = topi.detach() # 将预测的词作为 下一次输入 return decode_words, decoder_attentions[:index + 1]模型评估
python# 模型评估:加载模型并对自定义样本进行翻译 def evaluate_seq2seq_test(): encoder = EncoderRNN(english_word_n).to(device) # map_location: 正常在GPU训练就用GPU预测,而通过map_location 模型可以在CPU预测 # weights_only: True 只加载模型参数,不加载优化器参数 encoder.load_state_dict(torch.load(path1, map_location=device, weights_only=True), strict=False) print(f'encoder模型架构:{encoder}') decoder = AttnDecoderRNN(french_word_n).to(device) decoder.load_state_dict(torch.load(path2, map_location=device, weights_only=True), strict=False) print(f'decoder模型架构:{decoder}') # 自定义样本 samplepairs = [ ['i m impressed with your french .', 'je suis impressionne par votre francais .'], ['i m more than a friend .', 'je suis plus qu une amie .'], ['she is beautiful like her mother .', 'elle est belle comme sa mere .'] ] # 翻译 for index, pair in enumerate(samplepairs): x = pair[0] y = pair[1] # 1. 文本数值化,文本 -> 索引 tmpx = [english_word2index[word] for word in x.split(' ')] tmpx.append(EOS_token) tensor_x = torch.tensor(tmpx, dtype=torch.long, device=device).view(1, -1) # 2. 模型预测,索引 -> 文本 decode_words, _ = evaluate_seq2seq(tensor_x, encoder, decoder) # 3. 拼接成句子 output_sentence = ' '.join(decode_words) # 打印翻译结果 print(f'{index + 1}. {x} -> {output_sentence} |(原始法语) {y}') path1 = './model/seq2seq/encoder_5.pth' path2 = './model/seq2seq/decoder_5.pth' english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() evaluate_seq2seq_test()注意力图
python# 注意力图 def attention_plot(): encoder = EncoderRNN(english_word_n).to(device) decoder = AttnDecoderRNN(french_word_n).to(device) encoder.load_state_dict(torch.load(path1, map_location=device, weights_only=True), strict=False) decoder.load_state_dict(torch.load(path2, map_location=device, weights_only=True), strict=False) # 自定义样本 sentence = "we re both teachers ." # 模型预测 # 1. 文本数值化,文本 -> 索引 tmpx = [english_word2index[word] for word in x.split(' ')] tmpx.append(EOS_token) tensor_x = torch.tensor(tmpx, dtype=torch.long, device=device).view(1, -1) # 2. 模型预测,索引 -> 文本 decode_words, attention_wight = evaluate_seq2seq(tensor_x, encoder, decoder) # 绘图 plt.matshow(attention_wight.numpy()) # 以矩阵列表的方式绘制 plt.savefig('./img/seq2seq/attention.png') plt.show() path1 = './model/seq2seq/encoder_5.pth' path2 = './model/seq2seq/decoder_5.pth' english_word2index, english_index2word, english_word_n, french_word2index, french_index2word, french_word_n, pairsrc_data = get_data() attention_plot()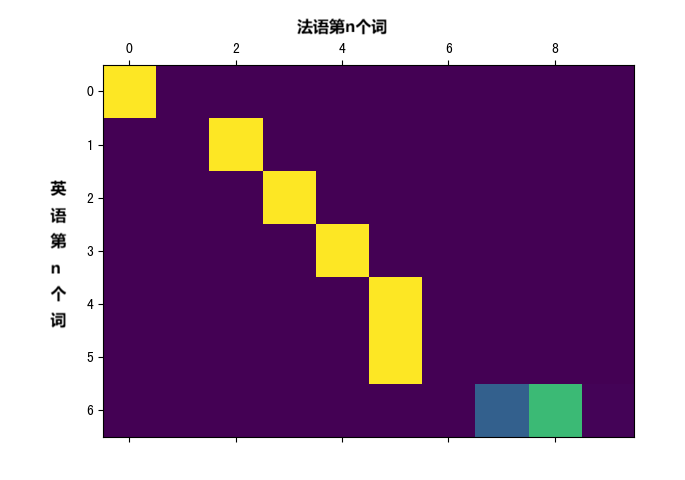
Attention图像的纵坐标代表输入的源语言各个词汇对应的索引, 0-6分别对应["we", "re", "both", "teachers", ".", ""], 纵坐标代表生成的目标语言各个词汇对应的索引, 0-7代表['nous', 'sommes', 'toutes', 'deux', 'enseignantes', '.', '']
图中浅色小方块(颜色越浅说明影响越大)代表词汇之间的影响关系
比如源语言的第1个词汇对生成目标语言的第1个词汇影响最大, 源语言的第4,5个词对生成目标语言的第5个词会影响最大, 通过这样的可视化图像, 我们可以知道Attention的效果好坏, 与我们人为去判定到底还有多大的差距. 进而衡量我们训练模型的可用性.
迁移学习
中文分类
- 任务介绍:直接加载预训练模型进行输入文本的特征表示, 后接自定义网络进行微调输出结果
- 数据集介绍:train.csv,test.csv,validation.csv(数据样式一样)
python
1,选择珠江花园的原因就是方便,有电动扶梯直接到达海边,周围餐馆、食廊、商场、超市、摊位一应俱全。酒店装修一般,但还算整洁。 泳池在大堂的屋顶,因此很小,不过女儿倒是喜欢。 包的早餐是西式的,还算丰富。 服务吗,一般
1,15.4寸笔记本的键盘确实爽,基本跟台式机差不多了,蛮喜欢数字小键盘,输数字特方便,样子也很美观,做工也相当不错
0,房间太小。其他的都一般。。。。。。。。。
0,"1.接电源没有几分钟,电源适配器热的不行. 2.摄像头用不起来. 3.机盖的钢琴漆,手不能摸,一摸一个印. 4.硬盘分区不好办."
1,"今天才知道这书还有第6卷,真有点郁闷:为什么同一套书有两种版本呢?当当网是不是该跟出版社商量商量,单独出个第6卷,让我们的孩子不会有所遗憾。"
label(1-好评,0-差评)、text(评论内容)
import time


import torch


import torch.nn as nn


from torch.utils.data import DataLoader  # 数据加载器


from datasets import load_dataset  # 数据集加载工具,可加载本地数据和公开数据源


from transformers import BertTokenizer, BertModel  # 文本分词器,bert模型


from torch.optim import AdamW  # tensorflow的Adam优化器(内置权重衰减)


from tqdm import tqdm  # 进度条


from rich import print # 打印格式化


# 设置GPU/CPU设备


device = torch.device("cuda" if torch.cuda.is_available() else "cpu")


# 加载分词器和模型


tokenizer = BertTokenizer.from_pretrained("./model/transformers/bert-base-chinese")


pre_model = BertModel.from_pretrained("./model/transformers/bert-base-chinese").to(device)


print(f"设备:{device}")
查看数据
# csv文件 -> dataset


def file2dataset():


    # 1. 加载训练集


    ## 写法一:


    train_dataset = load_dataset(


        path="./data/transfer_learning",    # 数据集路径


        data_files="train.csv",             # 文件名


        split="train"  # 将加载的数据标记为 训练集(读取同一份文件时分别可标记:train、test、validation)


        )


    ## 写法二:


    train_dataset = load_dataset(


        path="csv",                                         # 数据集类型


        data_files="./data/transfer_learning/train.csv",    # 数据集路径


        split="train"


        )


    ## 打印数据集


    print(f"train_dataset: {train_dataset}")


    print(train_dataset[:5])


    # 2. 加载验证集


    valid_dataset = load_dataset("csv", data_files="./data/transfer_learning/validation.csv", split="train")


    print(f"valid_dataset: {valid_dataset}")


    # 3. 加载测试集


    test_dataset = load_dataset("csv", data_files="./data/transfer_learning/test.csv", split="train")


    print(f"test_dataset: {test_dataset}")


    return train_dataset, valid_dataset, test_dataset


train_dataset = file2dataset()[0]


print(train_dataset[:5])
数据预处理
# 数据处理函数:将批次数据作为模型输入数据


def collator_fn(batch_data):


    # i 代表一条数据,即 {"label": 0, "text": "文本"}


    labels = [i["label"] for i in batch_data]


    texts = [i["text"] for i in batch_data]


    # 将标签转为张量


    labels = torch.tensor(labels)


    # 编码文本


    inputs = tokenizer.batch_encode_plus(


        texts, padding="max_length", return_tensors="pt",


        truncation=True, max_length=32


        )


    return labels, inputs["input_ids"], inputs["attention_mask"], inputs["token_type_ids"]


# 数据加载器


def get_dataloader(dataset):


    dataloader = DataLoader(


        dataset=dataset,  # 数据集


        batch_size=8,           # 批次大小


        shuffle=True,           # 是否打乱数据


        collate_fn=collator_fn, # 指定数据处理函数


        drop_last=True,         # 是否丢弃最后一批数据(当样本数量不能被批次大小整除时)


        )


    return dataloader


# 测试数据加载器


dataloader = get_dataloader(file2dataset()[0])


for data in dataloader:


    print(data)


    break
微调模型
# 定义下游任务模型


class AiModel(nn.Module):


    def __init__(self):


        super().__init__()


        # 将BERT模型的768维映射到2维(二分类)


        self.fc = nn.Linear(768, 2)


    def forward(self, input_ids, token_type_ids, attention_mask):


        # 关闭梯度计算


        with torch.no_grad():


            outputs = pre_model(input_ids, token_type_ids, attention_mask)


        # 获取最后一层输出


        pooler_output = outputs.pooler_output


        # 通过全连接层映射


        logits = self.fc(pooler_output)


        return logits  # 返回分类结果


dataloader = get_dataloader(file2dataset()[0])


model = AiModel().to(device)


for labels, input_ids, token_type_ids, attention_mask in dataloader:


    labels = labels.to(device)


    input_ids = input_ids.to(device)


    token_type_ids = token_type_ids.to(device)


    attention_mask = attention_mask.to(device)


    output = model(input_ids, token_type_ids, attention_mask)


    print(f"output: \n{output} {output.shape}")  # [batch_size, 2]


    break
模型训练
# 模型训练


def train_model():


    # 加载模型


    model = AiModel().to(device)


    # 冻结参数


    for param in pre_model.parameters():  # parameters() : 返回模型中所有可训练参数


        param.requires_grad = False


    # 损失函数


    criterion = nn.CrossEntropyLoss(reduction='mean')


    # 优化器


    optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)


    # 训练


    pre_model.train()


    epochs = 1


    # 数据加载器


    dataloader = get_dataloader(file2dataset()[0])


    for epoch in range(epochs):


        start_time = time.time()


        # 本轮训练


        for i, (labels, input_ids, token_type_ids, attention_mask) in tqdm(enumerate(dataloader)):


            # 将数据传入GPU


            labels = labels.to(device)


            input_ids = input_ids.to(device)


            token_type_ids = token_type_ids.to(device)


            attention_mask = attention_mask.to(device)


            # 前向传播


            outputs = model(input_ids, token_type_ids, attention_mask)


            # 计算损失


            loss = criterion(outputs, labels)


            # 反向传播


            optimizer.zero_grad()


            loss.backward()


            optimizer.step()


            # 打印损失


            if i % 20 == 0:


                # 预测结果


                preds = torch.argmax(outputs, dim=1)


                # 计算准确率


                acc = (preds == labels).sum().item() / len(labels)


                # 使用时间


                used_time = time.time() - start_time


                print(f'Epoch: {epoch+1}/{epochs}, preds: {preds}, labels: {labels}, loss: {loss:.2f}, acc: {acc:.2f}, used_time: {used_time:.2f}s')


        # 保存模型


        torch.save(model.state_dict(), f'./model/chinese_text_classification/model_{epoch+1}.bin')


train_model()
模型评估
# 评估模型


def evaluate_model():


    test_dataset = file2dataset()[2]


    dataloader = get_dataloader(test_dataset)


    # 加载模型


    model = AiModel().to(device)


    model.load_state_dict(torch.load('./model/chinese_text_classification/model_1.bin'))


    # 初始化评估参数


    correct, total = 0, 0


    # 模型评估


    model.eval()


    for i, (labels, input_ids, token_type_ids, attention_mask) in enumerate(tqdm(dataloader), start=1):


        # 将数据拷贝到GPU上


        labels = labels.to(device)


        input_ids = input_ids.to(device)


        token_type_ids = token_type_ids.to(device)


        attention_mask = attention_mask.to(device)


        # 关闭梯度计算


        with torch.no_grad():


            # 前向传播


            logits = model(input_ids, token_type_ids, attention_mask)


            # 获取预测结果(最大值的索引)


            preds = torch.argmax(logits, dim=1)


            # 统计预测正确的样本数


            correct += torch.sum(preds == labels).item()


            # 统计总样本数


            total += len(labels)


            # 输出预测结果


            if i % 20 == 0:


                acc = correct / total


                # 解码第一个样本的文本


                text_list = tokenizer.decode(input_ids[0], skip_special_tokens=True)


                print(f'原始文本:{text_list}')


                print(f'真实标签:{labels[0]}, 预测标签:{preds[0]}, 准确率:{acc:.4f}')


evaluate_model()
中文完型填空
- 任务介绍
输入一句话,MASK 一个字,训练模型进行填空
[CLS] 选 择 珠 江 花 园 的 原 因 就 是 方 便,有 [MASK] 动 扶 梯 直 达 海 边 ,周 围 餐 馆 [SEP]
- 数据集介绍:train.csv,test.csv,validation.csv(数据样式一样)
python
1,选择珠江花园的原因就是方便,有电动扶梯直接到达海边,周围餐馆、食廊、商场、超市、摊位一应俱全。酒店装修一般,但还算整洁。 泳池在大堂的屋顶,因此很小,不过女儿倒是喜欢。 包的早餐是西式的,还算丰富。 服务吗,一般
1,15.4寸笔记本的键盘确实爽,基本跟台式机差不多了,蛮喜欢数字小键盘,输数字特方便,样子也很美观,做工也相当不错
0,房间太小。其他的都一般。。。。。。。。。
0,"1.接电源没有几分钟,电源适配器热的不行. 2.摄像头用不起来. 3.机盖的钢琴漆,手不能摸,一摸一个印. 4.硬盘分区不好办."
1,"今天才知道这书还有第6卷,真有点郁闷:为什么同一套书有两种版本呢?当当网是不是该跟出版社商量商量,单独出个第6卷,让我们的孩子不会有所遗憾。"
label(1-好评,0-差评)、text(评论内容)
import time


import torch


import torch.nn as nn


from torch.utils.data import DataLoader


from torch.optim import AdamW


from datasets import load_dataset


from transformers import BertTokenizer, BertModel


from tqdm import tqdm


from rich import print


device = torch.device("cuda" if torch.cuda.is_available() else "cpu")


tokenizer = BertTokenizer.from_pretrained("./model/transformers/bert-base-chinese")  # 加载分词器


pre_model = BertModel.from_pretrained("./model/transformers/bert-base-chinese")  # 加载模型


print(f"设备:{device}")
数据预处理
# 数据处理


def collate_fn(batch_data):


    # 获取该批次数据的所有句子的 label和text


    # i 代表一条数据,即 {"label": 0, "text": "文本"}


    labels = [i["label"] for i in batch_data]


    texts = [i["text"] for i in batch_data]


    # 编码文本


    inputs = tokenizer(


        texts, padding="max_length", return_tensors="pt",


        truncation=True, max_length=32


        )


    # 提取编码结果:输入token_id,注意力掩码,token类型的id


    input_ids, attention_mask, token_type_ids = inputs["input_ids"], inputs["attention_mask"], inputs["token_type_ids"]


    # 假设第16个位置为 [MASK],基于其它的字符,对该位置做填充


    ## 获取第16个词汇的真实token_id,也就是 label


    labels = input_ids[:, 16].reshape(-1).clone()


    ## 对第16个词进行MASK编码


    # input_ids[:, 16] = tokenizer.get_vocab()['[MAKS]']


    input_ids[:, 16] = tokenizer.mask_token_id


    labels = torch.LongTensor(labels)


    return labels, input_ids, attention_mask, token_type_ids


def get_dataloader(data):


    if data is None:


        data = load_dataset("csv", data_files="./data/transfer_learning/train.csv",split="train")


    dataset = data.filter(lambda x: len(x['text']))


    dataloader = DataLoader(


        dataset = dataset,


        batch_size = 8,


        shuffle = True,


        collate_fn=collate_fn,


        drop_last = True


    )


    return dataloader


def eval_dataloader():


    dataloader = get_dataloader(data=None)


    for data in dataloader:


        print(data)


        break


eval_dataloader()
微调模型
# 定义下游任务模型


class AiModel(nn.Module):


    def __init__(self, pre_model):


        super().__init__()


        self.pre_model = pre_model


        # 将BERT模型的768维映射到 21128维(词汇表大小)


        self.fc = nn.Linear(768, tokenizer.vocab_size, bias=False)


    def forward(self, input_ids, token_type_ids, attention_mask):


        # 关闭梯度计算


        with torch.no_grad():


            outputs = self.pre_model(input_ids, token_type_ids, attention_mask)


        # 获取第16个位置的预测概率值


        output = self.fc(outputs.last_hidden_state[:, 16])


        # 返回分类结果


        return output


# 测试模型函数


def eval_AiModel():


    dataloader = get_dataloader(data=None)


    model = AiModel(pre_model).to(device)


    for labels, input_ids, token_type_ids, attention_mask in dataloader:


        labels = labels.to(device)


        input_ids = input_ids.to(device)


        token_type_ids = token_type_ids.to(device)


        attention_mask = attention_mask.to(device)


        output = model(input_ids, token_type_ids, attention_mask)


        print(f"output: \n{output} {output.shape}")  # [batch_size, 2]


        break


eval_AiModel()
模型训练
# 模型训练


def train_model():


    # 加载模型


    model = AiModel(pre_model).to(device)


    # 冻结参数


    for param in pre_model.parameters():  # parameters() : 返回模型中所有可训练参数


        param.requires_grad = False


    # 损失函数


    criterion = nn.CrossEntropyLoss(reduction='mean')


    # 优化器


    optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)


    # 训练


    pre_model.train()


    epochs = 1


    # 数据加载器


    dataloader = get_dataloader(data=None)


    for epoch in range(epochs):


        start_time = time.time()


        # 本轮训练


        for i, (labels, input_ids, token_type_ids, attention_mask) in tqdm(enumerate(dataloader)):


            # 将数据传入GPU


            labels = labels.to(device)


            input_ids = input_ids.to(device)


            token_type_ids = token_type_ids.to(device)


            attention_mask = attention_mask.to(device)


            # 前向传播


            outputs = model(input_ids, token_type_ids, attention_mask)


            # 计算损失


            loss = criterion(outputs, labels)


            # 反向传播


            optimizer.zero_grad()


            loss.backward()


            optimizer.step()


            # 打印损失


            if i % 20 == 0:


                # 预测结果


                preds = torch.argmax(outputs, dim=1)


                # 计算准确率


                acc = (preds == labels).sum().item() / len(labels)


                # 使用时间


                used_time = time.time() - start_time


                print(f'Epoch: {epoch+1}/{epochs}, preds: {preds}, labels: {labels}, loss: {loss:.2f}, acc: {acc:.2f}, used_time: {used_time:.2f}s')


        # 保存模型


        torch.save(model.state_dict(), f'./model/fill_mask/model_{epoch+1}.bin')


train_model()
模型测试
# 评估模型


def evaluate_model():


    test_dataset = load_dataset(path="csv", data_files="./data/transfer_learning/test.csv", split="train")


    dataloader = get_dataloader(test_dataset)


    # 加载模型


    model = AiModel(pre_model).to(device)


    model.load_state_dict(torch.load('./model/fill_mask/model_1.bin'))


    # 初始化评估参数


    correct, total = 0, 0


    # 模型评估


    model.eval()


    for i, (labels, input_ids, token_type_ids, attention_mask) in enumerate(tqdm(dataloader), start=1):


        # 将数据拷贝到GPU上


        labels = labels.to(device)


        input_ids = input_ids.to(device)


        token_type_ids = token_type_ids.to(device)


        attention_mask = attention_mask.to(device)


        # 关闭梯度计算


        with torch.no_grad():


            # 前向传播


            logits = model(input_ids, token_type_ids, attention_mask)


            # 获取预测结果(最大值的索引)


            preds = torch.argmax(logits, dim=1)


            # 统计预测正确的样本数


            correct += torch.sum(preds == labels).item()


            # 统计总样本数


            total += len(labels)


            # 输出预测结果


            if i % 20 == 0:


                acc = correct / total


                # 解码第一个样本的文本


                text_list = tokenizer.decode(input_ids[0], skip_special_tokens=True)


                print(f'原始文本:text_list')


                print(f'真实标签:{tokenizer.decode(labels[0])}, 预测标签:{tokenizer.decode(preds[0])}, 准确率:{acc:.4f}')


evaluate_model()
中文句子关系
- 任务介绍
下一句话任务(Next Sentence Prediction,NSP)中文句子关系任务。输入2句话,判断第2句是否为第1句话的下半句
- 数据集介绍:train.csv,test.csv,validation.csv(数据样式一样)
python
1,选择珠江花园的原因就是方便,有电动扶梯直接到达海边,周围餐馆、食廊、商场、超市、摊位一应俱全。酒店装修一般,但还算整洁。 泳池在大堂的屋顶,因此很小,不过女儿倒是喜欢。 包的早餐是西式的,还算丰富。 服务吗,一般
1,15.4寸笔记本的键盘确实爽,基本跟台式机差不多了,蛮喜欢数字小键盘,输数字特方便,样子也很美观,做工也相当不错
0,房间太小。其他的都一般。。。。。。。。。
0,"1.接电源没有几分钟,电源适配器热的不行. 2.摄像头用不起来. 3.机盖的钢琴漆,手不能摸,一摸一个印. 4.硬盘分区不好办."
1,"今天才知道这书还有第6卷,真有点郁闷:为什么同一套书有两种版本呢?当当网是不是该跟出版社商量商量,单独出个第6卷,让我们的孩子不会有所遗憾。"
label(1-好评,0-差评)、text(评论内容)
import time


import random


import torch


import torch.nn as nn


from torch.utils.data import DataLoader  # 数据加载器


from datasets import load_dataset, Dataset


from transformers import BertTokenizer, BertModel  # 文本分词器,bert模型


from torch.optim import AdamW  # tensorflow的Adam优化器(内置权重衰减)


from tqdm import tqdm  # 进度条


from rich import print # 打印格式化


# 设置GPU/CPU设备


device = torch.device("cuda" if torch.cuda.is_available() else "cpu")


# 加载分词器和模型


tokenizer = BertTokenizer.from_pretrained("./model/transformers/bert-base-chinese")


pre_model = BertModel.from_pretrained("./model/transformers/bert-base-chinese").to(device)
加载数据
class MyDataSet(Dataset):


    def __init__(self, data_path):


        super(Dataset).__init__()


        data = load_dataset("csv", data_files=data_path, split="train")


        dataset_item = data.filter(lambda x:len(x['text']) > 44)


        self.dataset_item = dataset_item


    def __len__(self):


        return len(self.dataset_item)


    def __getitem__(self, index):


        # 将 label 初始化为 1


        label = 1  # 1-有关系,0-没有关系


        # 根据索引获取句子


        text = self.dataset_item[index]['text']


        # 构造句子(默认有关系)


        sent1 = text[: 22]      # 上半句话


        sent2 = text[22: 44]    # 下半句话


        # 构造负样本,随机设置 某些句子的第2句话 为 其它句子的第2句话


        if random.randint(0, 1) == 0:  # 随机构成负样本


            # 随机获取1个句子,用他的sent2 来替换 当前句子的sent2


            j = random.randint(0, len(self.dataset_item) - 1)


            sent2 = self.dataset_item[j]['text'][22:44]


            # 构造为负样本


            label = 0


        # 返回:样本数据(上),样本数据(下),标签


        return sent1, sent2, label
数据预处理
# 数据处理


def collate_fn(batch_data):


    # 获取样本数据(上下两个句子)


    sents = [item[:2] for item in batch_data]


    # 获取标签


    labels = [item[2] for item in batch_data]


    # 编码文本


    inputs = tokenizer(


        sents, padding="max_length", return_tensors="pt",


        truncation=True, max_length=50  # CLS + 句子1 + SEP + 句子2 + SEP


        )


    # 提取编码结果:输入token_id,注意力掩码,token类型的id


    input_ids, attention_mask, token_type_ids = inputs["input_ids"], inputs["attention_mask"], inputs["token_type_ids"]


    # 标签 -> tensor


    labels = torch.LongTensor(labels)


    return labels, input_ids, attention_mask, token_type_ids


def get_dataloader(data_set=None):


    if data_set is None:


        data_set = MyDataSet(data_path="./data/transfer_learning/train.csv")


    dataloader = DataLoader(


        dataset = data_set,


        batch_size = 8,


        shuffle = True,


        collate_fn=collate_fn,


        drop_last = True


    )


    return dataloader


def eval_dataloader():


    dataloader = get_dataloader(data_set=None)


    for data in dataloader:


        print(data)


        break


eval_dataloader()
微调模型
# 定义下游任务模型


class AiModel(nn.Module):


    def __init__(self):


        super().__init__()


        # 将BERT模型的768维映射到 2维(二分类)


        self.fc = nn.Linear(768, 2)


    def forward(self, input_ids, token_type_ids, attention_mask):


        # 关闭梯度计算


        with torch.no_grad():


            outputs = pre_model(input_ids, token_type_ids, attention_mask)


        # 获取第16个位置的预测概率值


        output = self.fc(outputs.pooler_output)


        # 返回分类结果


        return output


# 测试模型函数


def eval_AiModel():


    dataloader = get_dataloader(data_set=None)


    model = AiModel().to(device)


    for labels, input_ids, token_type_ids, attention_mask in dataloader:


        labels = labels.to(device)


        input_ids = input_ids.to(device)


        token_type_ids = token_type_ids.to(device)


        attention_mask = attention_mask.to(device)


        output = model(input_ids, token_type_ids, attention_mask)


        print(f"output: \n{output} {output.shape}")  # [batch_size, 2]


        break


eval_AiModel()
模型训练
# 模型训练


def train_model():


    # 加载模型


    model = AiModel().to(device)


    # 冻结参数


    for param in pre_model.parameters():  # parameters() : 返回模型中所有可训练参数


        param.requires_grad = False


    # 损失函数


    criterion = nn.CrossEntropyLoss(reduction='mean')


    # 优化器


    optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)


    # 训练


    pre_model.train()


    epochs = 1


    # 数据加载器


    dataloader = get_dataloader(data_set=None)


    for epoch in range(epochs):


        start_time = time.time()


        # 本轮训练


        for i, (labels, input_ids, token_type_ids, attention_mask) in tqdm(enumerate(dataloader)):


            # 将数据传入GPU


            labels = labels.to(device)


            input_ids = input_ids.to(device)


            token_type_ids = token_type_ids.to(device)


            attention_mask = attention_mask.to(device)


            # 前向传播


            outputs = model(input_ids, token_type_ids, attention_mask)


            # 计算损失


            loss = criterion(outputs, labels)


            # 反向传播


            optimizer.zero_grad()


            loss.backward()


            optimizer.step()


            # 打印损失


            if i % 20 == 0:


                # 预测结果


                preds = torch.argmax(outputs, dim=1)


                # 计算准确率


                acc = (preds == labels).sum().item() / len(labels)


                # 使用时间


                used_time = time.time() - start_time


                print(f'Epoch: {epoch+1}/{epochs}, preds: {preds}, labels: {labels}, loss: {loss:.2f}, acc: {acc:.2f}, used_time: {used_time:.2f}s')


        # 保存模型


        torch.save(model.state_dict(), f'./model/nsp/model_{epoch+1}.bin')


train_model()
模型评估
# 评估模型


def evaluate_model():


    dataset = MyDataSet(data_path="./data/transfer_learning/test.csv")


    dataloader = get_dataloader(dataset)


    # 加载模型


    model = AiModel().to(device)


    model.load_state_dict(torch.load('./model/nsp/model_1.bin'))


    # 初始化评估参数


    correct, total = 0, 0


    # 模型评估


    model.eval()


    for i, (labels, input_ids, token_type_ids, attention_mask) in enumerate(tqdm(dataloader), start=1):


        # 将数据拷贝到GPU上


        labels = labels.to(device)


        input_ids = input_ids.to(device)


        token_type_ids = token_type_ids.to(device)


        attention_mask = attention_mask.to(device)


        # 关闭梯度计算


        with torch.no_grad():


            # 前向传播


            logits = model(input_ids, token_type_ids, attention_mask)


            # 获取预测结果(最大值的索引)


            preds = torch.argmax(logits, dim=1)


            # 统计预测正确的样本数


            correct += torch.sum(preds == labels).item()


            # 统计总样本数


            total += len(labels)


            # 输出预测结果


            if i % 20 == 0:


                acc = correct / total


                # 解码第一个样本的文本


                text_list = tokenizer.decode(input_ids[0], skip_special_tokens=False)


                print(f'原始文本:{text_list}')


                print(f'真实标签:{labels[0].item()}, 预测标签:{preds[0].item()}, 准确率:{acc:.4f}')


evaluate_model()