核心工具
PyTorch框架
什么是 PyTorch
一个基于 python 语言的深度学习框架,它将数据封装成张量(Tensor)来进行处理
可用于构建、训练和部署机器学习和深度学习模型
PyTorch 的特点
数据类型是张量类型,类似于 Numpy 的张量计算
自动微分模块,自动求导/梯度(结合反向传播使用)
深度学习库
动态计算图
可以在GPU/TPU/NPU上运行,加速运行(CUDA支持)
支持多种应用场景
兼容各种平台 系统/硬件(显卡)
张量
什么是张量
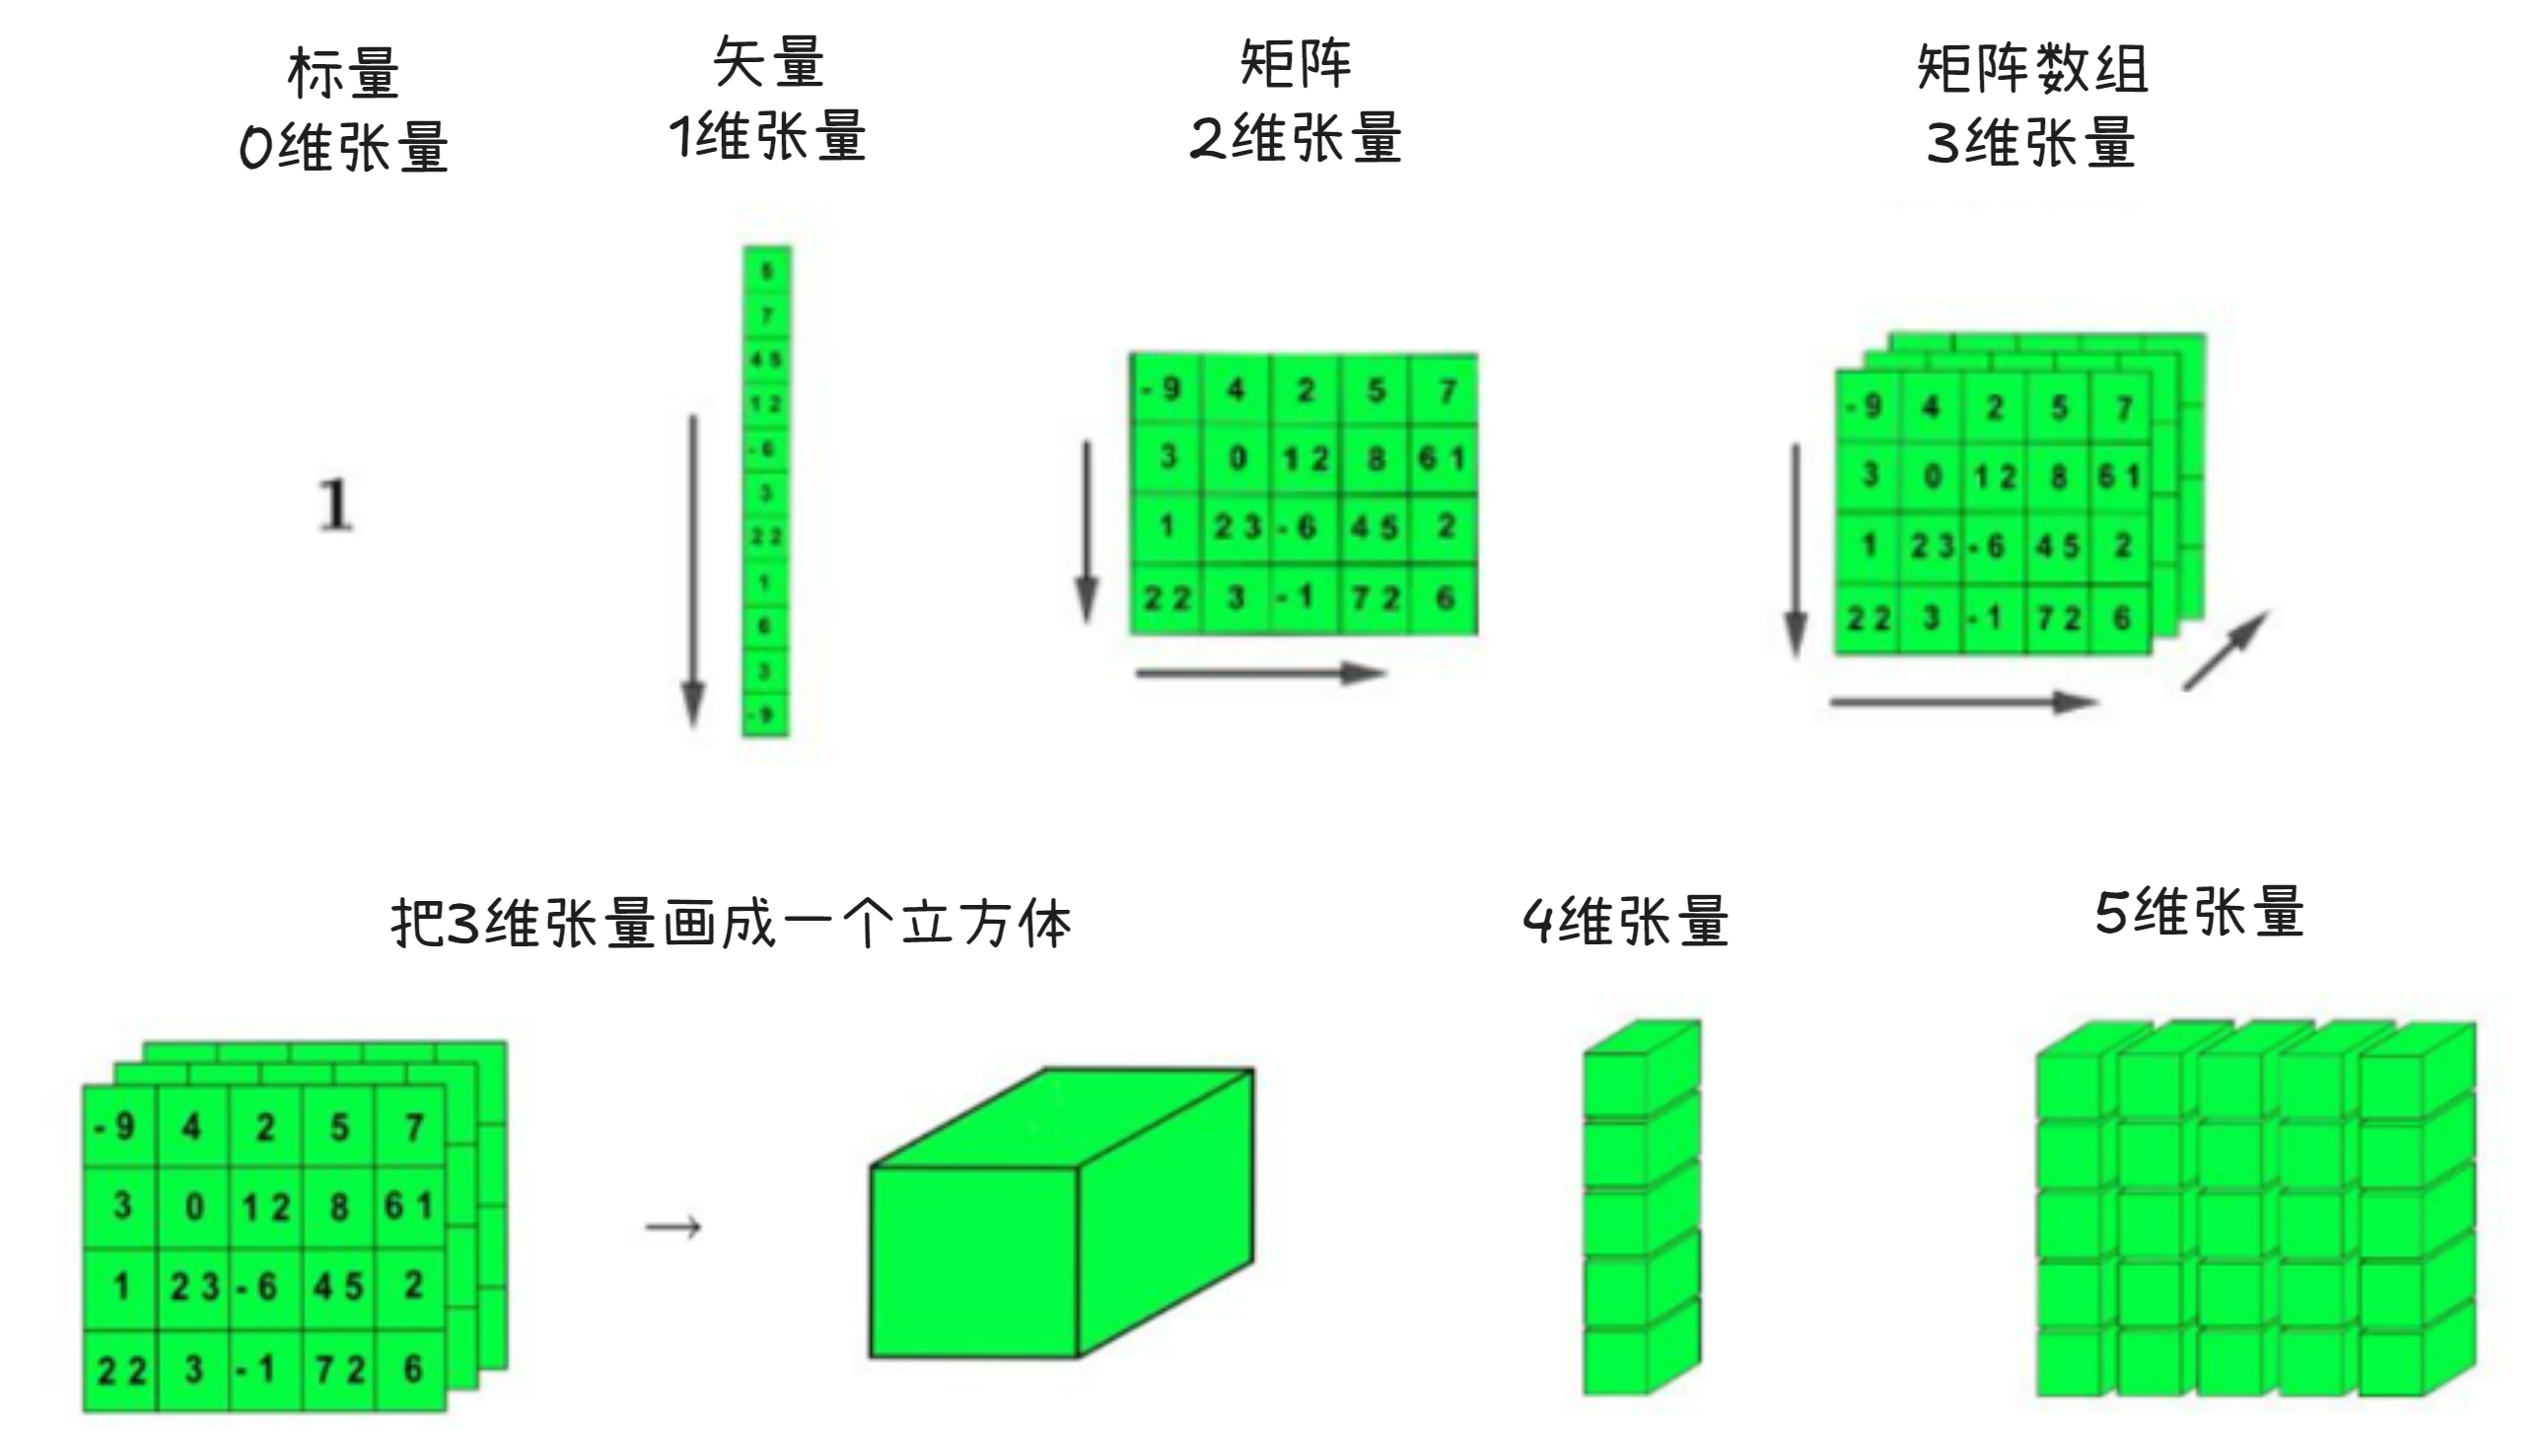
PyTorch 中的张量就是元素为同一种数据类型的多维矩阵。
在PyTorch中,张量以“类”的形式封装起来,对张量的一些运算、处理的方式被封装在类中。
PyTorch 张量与 Numpy数组类似,但PyTorch 的张量具有GPU加速的能力(通过CUDA),这使得深度学习模型能够高效地在GPU上运行
张量是 PyTorch中的核心数据抽象,PyTorch 支持各种张量类型。
通常地,一维张量称为向量/矢量(vector),二维张量称为矩阵(matrix)
自动微分模块
自动微分模块 = 对损失函数求导,结合反向传播,更新权重参数 w,b
训练神经网络时,最常用的算法就是反向传播。在该算法中,参数(模块权重)会根据损失函数关于对应参数的梯度进行调整。
支持任意计算图的自动梯度计算
torch.autograd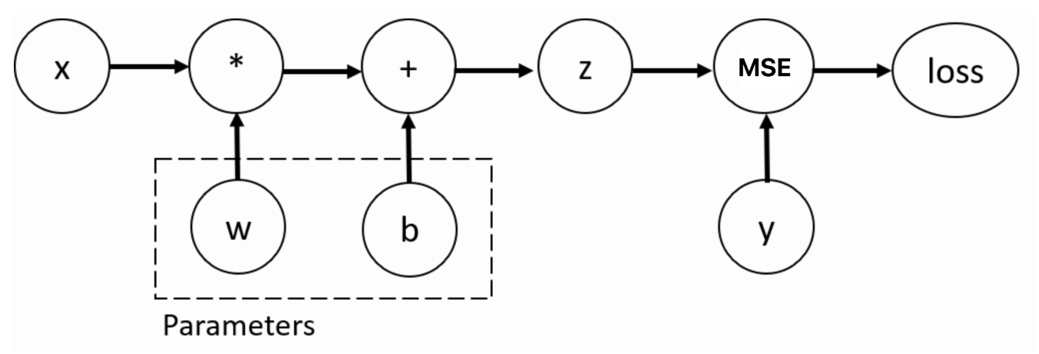
PyTorch 不支持向量张量对向量张量的求导,只支持标量张量对向量张量的求导
x 如果是张量, 必须是标量(一个值)才可以进行求导
计算梯度:
y.backward(), 是一个标量获取x点的梯度值:
x.grad,会累加上一次的梯度
正向传播:
forward()
python
w = torch.tensor(10, requires_grad=True, dtype=torch.float)


                        # requires_grad 表示是否需要计算梯度(仅支持浮点型)
python
# 计算梯度,梯度 = 损失函数的导数(loss为损失函数)


loss.sum().backward()   # 计算结果返回到 w.grad


                        # 使用 sum() 可保证loss结果为标量
梯度基本计算
梯度下降最优解
detach()
python
t2 = t1.detach()  # 返回一个新张量 t2,它与 t1 共享底层数据内存


                  # 不可自动微分(自动梯度计算),用于阻断梯度反向传播


# 解决:requires_grad=True 自动微分,无法直接转换为numpy
【案例】模拟线性回归