fasttext
初始fasttext
- 作用:文本分类 和 训练词向量
- 优势:能够在保持较高精度的情况下,快速地进行训练和预测
架构极简:单层线性模型,无深层网络,参数量少 计算优化:层次 Softmax / 负采样 替代 全量 Softmax,复杂度从 降至 子词赋能:字符级 n-gram 子词解决 OOV 问题,共享形态特征,小样本下仍保高精度
- 安装:
pip install fasttext若安装失败则尝试pip install fasttext-wheel
模型架构
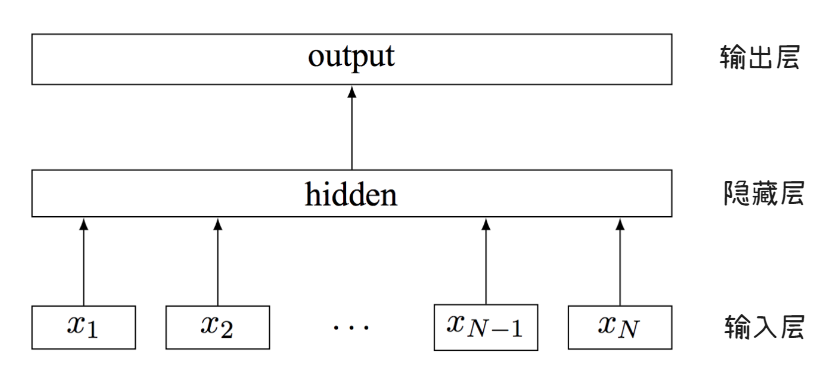
FastText 的模型分为三层架构:
- 输入层: 是对文档 embedding 之后的词向量, 包含 N-gram 特征
- 隐藏层: 是对输入数据的求和平均,得到特征向量
- 输出层: 是文档对应的 label(预测标签)
层次 softmax
为提高计算效率,在 fasttext 中使用哈夫曼树,即 层次化的softmax(hierarchical softmax)来进行概率计算
哈夫曼树
定义:由 n 个带权节点构建的二叉树中,带权路径长度(WPL)最小的树称为最优二叉树,又称赫夫曼树或哈夫曼树。 核心特点:权值越大的节点距离根节点越近,以此实现整体路径长度最小化
- 二叉树:每个节点最多有两个子树(左、右),且子树有序(不可颠倒)。
- 叶子节点:没有子节点的节点。
- 路径 与 路径长度
- 路径:从某节点到其子孙节点的通路。
- 路径长度:路径上经过的分支数。
- 节点的权 与 带权路径长度
- 权:节点被赋予的数值含义。
- 带权路径长度:从根节点到该节点的路径长度 × 该节点的权。
- 树的带权路径长度(WPL)
树中所有叶子节点的带权路径长度之和。 WPL:最小的二叉树即为哈夫曼树
构建哈夫曼树
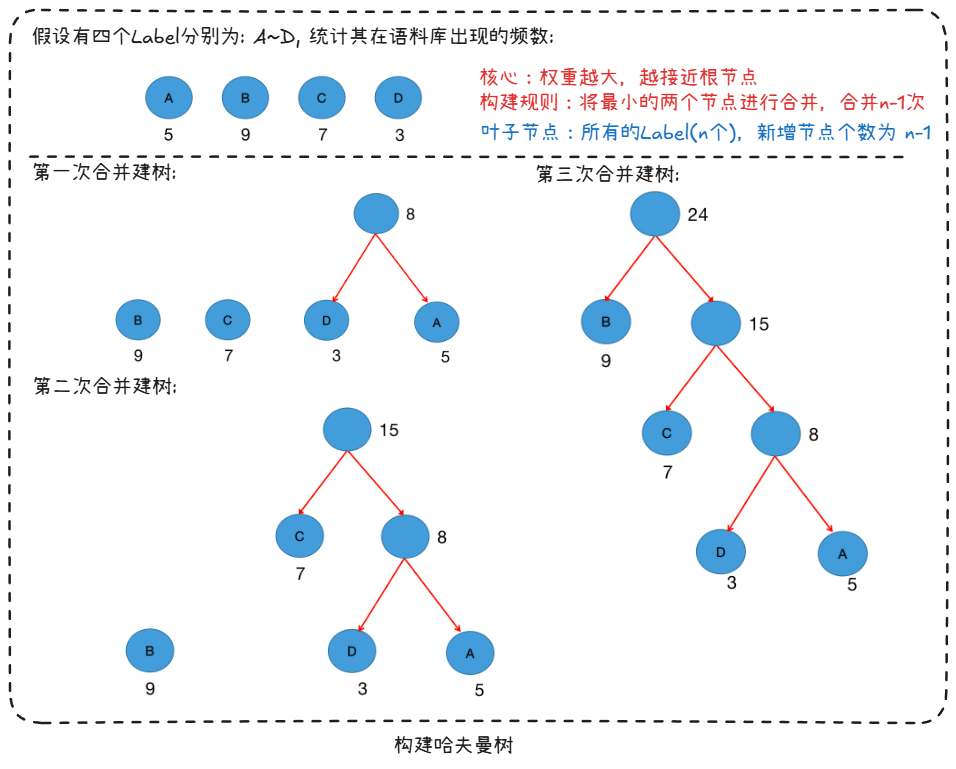
假设有n个权值, 则构造出的哈夫曼树有 n个叶子节点。n个权值分别设为 , 则哈夫曼树的构造规则为:
- 步骤1: 将 看成是有 n 棵树的森林(每棵树仅有一个节点);
- 步骤2: 在森林中选出两个根节点的权值最小的树合并, 作为一颗新树的左、右子树, 且新树的根节点权值为其左、右子树根节点权值之和;
- 步骤3: 从森林中删除选取的两棵树, 并将新树加入森林;
- 步骤4: 重复2-3步骤, 直到森林只有一颗树为止, 该树就是所求的哈夫曼树.
哈夫曼树编码
哈夫曼编码:规定哈夫曼树中的左分支为 0, 右分支为 1, 从根节点到每个叶节点所经过的分支对应的 0 和 1 组成的序列便为该节点对应字符的编码 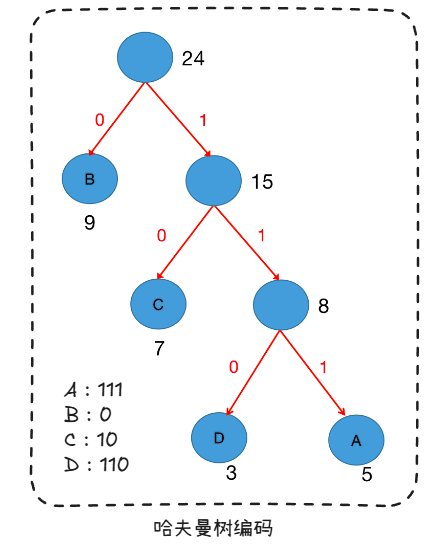
负采样
定义:为大幅降低计算量,将原本需要计算全部词表概率的多分类任务,转化为「正样本(目标上下文词)+ 少量随机采样的负样本(非目标词)」的二分类任务,仅更新正样本和采样负样本对应的模型权重
随机采样负样本,多分类转二分类 示例:10000 词表、300 维隐层,全量需更新 300 万权重,负采样仅更新 个权重,仅占 0.06%。
优势:
- 提高训练速度,选择部分数据进行损失计算
- 改进效果,增加部分负样本,能够模拟真实场景下的噪声情况,能够让模型的稳健性更强
fasttext 文本分类
多数文本分类是通过机器学习从训练数据中提取分类规则,并进行分类,故构建文本分类器需要带标签的数据 文本分类的种类:
- 二分类:文本被分类两个类别中, 往往这两个类别是对立面(二元交叉熵损失,BCELoss)
- 比如: 判断一句评论是好评还是差评
- 单标签多分类: 文本被分类到多个类别中, 且每条文本只能属于某一个类别(即被打上某一个标签)(softmax+CrossEntropyLoss,多分类交叉熵)
- 比如: 输入一个人名, 判断它是来自哪个国家的人名.
- 多标签多分类:文本被分类到多个类别中, 但每条文本可以属于多个类别(即被打上多个标签)
- 比如: 输入一段描述, 判断可能是和哪些兴趣爱好有关, 一段描述中可能即讨论了美食, 又太讨论了游戏爱好.
文本分类的过程:
- 获取数据
- 训练集与验证集的划分
- 训练模型
- 模型预测与评估
- 模型调优
- 模型保存与重加载
数据集
前十条数据:
__label__sauce __label__cheese How much does potato starch affect a cheese sauce recipe? __label__food-safety __label__acidity Dangerous pathogens capable of growing in acidic environments
__label__cast-iron __label__stove How do I cover up the white spots on my cast iron stove? __label__restaurant Michelin Three Star Restaurant; but if the chef is not there __label__knife-skills __label__dicing Without knife skills, how can I quickly and accurately dice vegetables?
__label__storage-method __label__equipment __label__bread What's the purpose of a bread box? __label__baking
__label__food-safety __label__substitutions __label__peanuts how to seperate peanut oil from roasted peanuts at home?
__label__chocolate American equivalent for British chocolate terms __label__baking __label__oven __label__convection Fan bake vs bake __label__sauce __label__storage-lifetime __label__acidity __label__mayonnaise Regulation and balancing of readymade packed mayonnaise and other sauces
其中的标签均以
__label__为前缀,这是 fasttext 识别标签或单词的方式,标签之后的便是文本信息
模型 训练/预测/测试
import fasttext

def fasttext_model(test_path, parameter):
    # 模型训练
    model = fasttext.train_supervised(**parameter)
    # 模型预测
    result1 = model.predict("What can I use instead of corn syrup?")
    print(f"预测结果1:{result1}")
    result2 = model.predict("Are stone or metal grinding wheels better for flour?")
    print(f"预测结果2:{result2}")
    # 模型测试
    result = model.test(test_path)
    print(f"(测试集)测试结果:{result}")  # (样本数量,准确率,召回率)
    print(f"词表大小:{len(model.get_words())},标签总数:{len(model.get_labels())}")
手动调参
# 使用经过“数据预处理”的训练集和测试集
train_path, test_path = "./data/fasttext/cooking.pre.train", "./data/fasttext/cooking.pre.valid"
parameter = {
    "input":train_path,
    "epoch":30, # 增加训练轮数,默认为5
    "lr":1,  # 文本分类任务学习率通常要调高一点,默认为0.1
    "wordNgrams":5,  # 添加n-gram,默认为1
    "loss":"hs"  # 损失函数,默认为softmax
}
fasttext_model(test_path, parameter)  # (3000, 0.583, 0.25212627937148624)
自动调参
train_path, test_path = "./data/fasttext/cooking.pre.train", "./data/fasttext/cooking.pre.valid"
parameter = {
    "input": train_path,  # 训练集
    "autotuneValidationFile": test_path,  # 验证集
    "autotuneDuration": 600,  # 自动调参时间,默认5min
}
fasttext_model(test_path, parameter)  # (3000, 0.5666666666666667, 0.24506270722214213)
多标签多分类
import fasttext

def fasttext_model(test_path, parameter):
    # 模型训练
    model = fasttext.train_supervised(**parameter)
    # 模型预测
    # k: 预测的标签数,k=-1时返回所有标签(尽可能多的显示)
    # threshold: 阈值,只有大于阈值的标签才会被保留
    result1 = model.predict("What can I use instead of corn syrup?", k=3, threshold=0.6)
    print(f"预测结果1:{result1}")
    result2 = model.predict("Are stone or metal grinding wheels better for flour?", k=-1)
    print(f"预测结果2:{result2}")
    # 模型测试
    result = model.test(test_path)
    print(f"(测试集)测试结果:{result}")  # (样本数量,准确率,召回率)
    print(f"词表大小:{len(model.get_words())},标签总数:{len(model.get_labels())}")

# 使用经过“数据预处理”的训练集和测试集
train_path, test_path = "./data/fasttext/cooking.pre.train", "./data/fasttext/cooking.pre.valid"
parameter = {
    "input": train_path,    # 训练集
    "epoch": 20,            # 训练轮数
    "lr": 0.3,              # 学习率
    "wordNgrams": 2,         # 词的N-gram
    "loss": "ova"           # one vs all
}
fasttext_model(test_path, parameter)  # (3000, 0.6063333333333333, 0.2622170967276921)
模型保存与重加载
import fasttext

def fasttext_model(train_path, model_path):
    # 模型训练
    model = fasttext.train_supervised(train_path, epoch=30, lr=1, wordNgrams=2)
    # 模型保存
    model.save_model(model_path)
    # 模型加载
    model2 = fasttext.load_model(model_path)
    # 模型预测
    result = model2.predict("What can I use instead of corn syrup?", k=3, threshold=0.3)
    print(f"预测结果:{result}")


train_path, model_path = "./data/fasttext/cooking.pre.train", "./model/fasttext/cooking.model"
fasttext_model(train_path, model_path)  # (('__label__substitutions',), array([0.46127668]))
fasttext 训练词向量
文本分类的过程:
- 获取数据
- 训练词向量
- 模型超参数设定
- 模型效果检验
- 模型保存与重加载 数据集:
由空格分割的单词
anarchism originated as a term of abuse first used against early working class# 训练词向量
# 无监督训练模式: 'skipgram' 或者 'cbow', 默认为'skipgram', 在实践中,skipgram模式在利用子词方面比cbow更好.
# 词嵌入维度dim: 默认为100, 但随着语料库的增大, 词嵌入的维度往往也要更大.
# 数据循环次数epoch: 默认为5, 但当你的数据集足够大, 可能不需要那么多次.
# 学习率lr: 默认为0.05, 根据经验, 建议选择[0.01,1]范围内.
# 使用的线程数thread: 默认为12个线程, 一般建议和你的cpu核数相同.
model = fasttext.train_unsupervised('data_path', "cbow", dim=300, epoch=1, lr=0.1, thread=8)
model.get_word_vector("the") # 查看单词对应的词向量
# 模型效果检验
model.get_nearest_neighbors('sports') # 查看其邻近单词词向量迁移
在本地任务中,使用已在大型语料库上训练好的 词向量模型(可迁移的词向量)
fasttext 中可迁移的词向量:
- Wiki word vectors,在Wikipedia语料(294种语言)上进行训练(skipgram模式)的可迁移词向量模型,维度为300
- Word vectors for 157 languages,在CommonCrawl和Wikipedia语料上进行训练(CBOW模式)的可迁移词向量模型,维度为300
第一步: 下载词向量模型压缩的bin.gz文件
python# 这里我们以迁移在CommonCrawl和Wikipedia语料上进行训练的中文词向量模型为例: # 下载中文词向量模型(bin.gz文件) wget https://dl.fbaipublicfiles.com/fasttext/vectors-crawl/cc.zh.300.bin.gz第二步: 解压bin.gz文件到bin文件
python# 使用gunzip进行解压, 获取cc.zh.300.bin文件 gunzip cc.zh.300.bin.gz第三步: 加载bin文件获取词向量
pythonmodel = fasttext.load_model("cc.zh.300.bin") # 加载模型 model.words[:100] # 查看前100个词 model.get_word_vector("音乐") # 查看词向量第四步: 利用邻近词进行效果检验
pythonmodel.get_nearest_neighbors("音乐") # 查看其邻近词
迁移学习
迁移学习是一种旨在将从一个或多个源任务中习得的知识,迁移到与之相关但数据分布或任务设定不同的目标任务中,以提升模型在目标任务上收敛速度、泛化能力与预测精度的学习框架,是解决小样本、跨领域场景的核心技术。
模型一般分两部分:
底层特征层:提取通用规律(边缘、颜色、语义、语法)
顶层任务层:做具体分类(猫狗、情感、食谱标签)
迁移学习就是:复用底层,只训练顶层 或者 底层微调,顶层重训
迁移学习的方式:
- 特征提取(Feature Extraction),冻住底层
- 微调(Fine-tuning),全部 / 部分更新
- 领域自适应(Domain Adaptation),换场景不换任务
- 零样本 / 少样本学习(Zero / Few-Shot),几乎不给数据
NLP 常用的预训练模型
当下NLP中流行的预训练模型:
- BERT
- GPT
- GPT-2
- Transformer-XL
- XLNet
- XLM
- RoBERTa
- DistilBERT
- ALBERT
- T5
- XLM-RoBERTa
以上的预训练模型及其变体都是以transformer为基础,只是在模型结构如神经元连接方式,编码器隐层数,多头注意力的头数等发生改变,这些改变方式的大部分依据都是由在标准数据集上的表现而定。
对于我们使用者而言,不需要从理论上深度探究这些预训练模型的结构设计的优劣,只需要在自己处理的目标数据上,尽量遍历所有可用的模型对比得到最优效果即可.
BERT 及其变体
- bert-base-uncased: 编码器具有12个隐层, 输出768维张量, 12个自注意力头, 共110M参数量, 在小写的英文文本上进行训练而得到.
- bert-large-uncased: 编码器具有24个隐层, 输出1024维张量, 16个自注意力头, 共340M参数量, 在小写的英文文本上进行训练而得到.
- bert-base-cased: 编码器具有12个隐层, 输出768维张量, 12个自注意力头, 共110M参数量, 在不区分大小写的英文文本上进行训练而得到.
- bert-large-cased: 编码器具有24个隐层, 输出1024维张量, 16个自注意力头, 共340M参数量, 在不区分大小写的英文文本上进行训练而得到.
- bert-base-multilingual-uncased: 编码器具有12个隐层, 输出768维张量, 12个自注意力头, 共110M参数量, 在小写的102种语言文本上进行训练而得到.
- bert-large-multilingual-uncased: 编码器具有24个隐层, 输出1024维张量, 16个自注意力头, 共340M参数量, 在小写的102种语言文本上进行训练而得到.
- bert-base-chinese: 编码器具有12个隐层, 输出768维张量, 12个自注意力头, 共110M参数量, 在简体和繁体中文文本上进行训练而得到.
GPT
- openai-gpt: 解码器具有12个隐层, 输出768维张量, 12个自注意力头, 共110M参数量, 由OpenAI在英文语料上进行训练而得到.
GPT-2 及其变体
- gpt2: 编码器具有12个隐层, 输出768维张量, 12个自注意力头, 共117M参数量, 在OpenAI GPT-2英文语料上进行训练而得到.
- gpt2-xl: 编码器具有48个隐层, 输出1600维张量, 25个自注意力头, 共1558M参数量, 在大型的OpenAI GPT-2英文语料上进行训练而得到.
Transformer-XL
- transfo-xl-wt103: 编码器具有18个隐层, 输出1024维张量, 16个自注意力头, 共257M参数量, 在wikitext-103英文语料进行训练而得到.
XLNet 及其变体
- xlnet-base-cased: 编码器具有12个隐层, 输出768维张量, 12个自注意力头, 共110M参数量, 在英文语料上进行训练而得到.
- xlnet-large-cased: 编码器具有24个隐层, 输出1024维张量, 16个自注意力头, 共240参数量, 在英文语料上进行训练而得到.
XLM
- xlm-mlm-en-2048: 编码器具有12个隐层, 输出2048维张量, 16个自注意力头, 在英文文本上进行训练而得到.
RoBERTa 及其变体
- roberta-base: 编码器具有12个隐层, 输出768维张量, 12个自注意力头, 共125M参数量, 在英文文本上进行训练而得到.
- roberta-large: 编码器具有24个隐层, 输出1024维张量, 16个自注意力头, 共355M参数量, 在英文文本上进行训练而得到.
DistilBERT 及其变体
- distilbert-base-uncased: 基于bert-base-uncased的蒸馏(压缩)模型, 编码器具有6个隐层, 输出768维张量, 12个自注意力头, 共66M参数量.
- distilbert-base-multilingual-cased: 基于bert-base-multilingual-uncased的蒸馏(压缩)模型, 编码器具有6个隐层, 输出768维张量, 12个自注意力头, 共66M参数量.
ALBERT
- albert-base-v1: 编码器具有12个隐层, 输出768维张量, 12个自注意力头, 共125M参数量, 在英文文本上进行训练而得到.
- albert-base-v2: 编码器具有12个隐层, 输出768维张量, 12个自注意力头, 共125M参数量, 在英文文本上进行训练而得到, 相比v1使用了更多的数据量, 花费更长的训练时间.
T5 及其变体
- t5-small: 编码器具有6个隐层, 输出512维张量, 8个自注意力头, 共60M参数量, 在C4语料上进行训练而得到.
- t5-base: 编码器具有12个隐层, 输出768维张量, 12个自注意力头, 共220M参数量, 在C4语料上进行训练而得到.
- t5-large: 编码器具有24个隐层, 输出1024维张量, 16个自注意力头, 共770M参数量, 在C4语料上进行训练而得到.
XLM-RoBERTa 及其变体
- xlm-roberta-base: 编码器具有12个隐层, 输出768维张量, 8个自注意力头, 共125M参数量, 在2.5TB的100种语言文本上进行训练而得到.
- xlm-roberta-large: 编码器具有24个隐层, 输出1027维张量, 16个自注意力头, 共355M参数量, 在2.5TB的100种语言文本上进行训练而得到.