什么是神经网络
定义
人工神经网络(Artificial Neural Network,ANN,也简称为神经网络 NN)是一种模仿生物神经网络结构和功能的计算模型。
生物神经元 vs 人工神经元
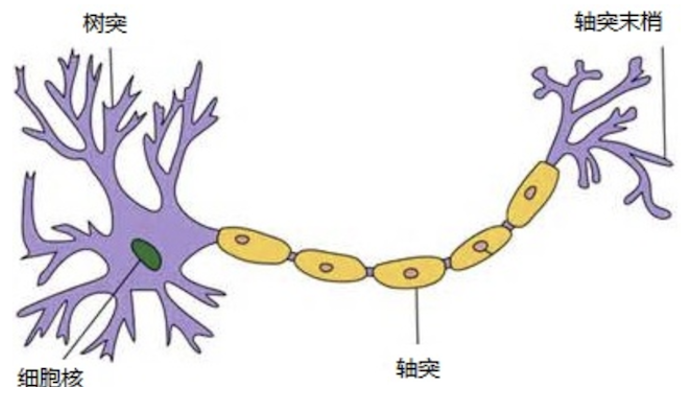
人脑可以看做是一个生物神经网络,由众多的神经元连接而成。各个神经元传递复杂的电信号,树突接收到输入信号,然后对信号进行处理,通过轴突和轴突末梢输出信号。
生物神经元:
树突:接收输入信号
细胞核:处理信号
轴突:输出信号
当电信号通过树突进入到细胞核时,会逐渐聚集电荷。达到一定的电位后,细胞会被激活,通过轴突发出电信号。
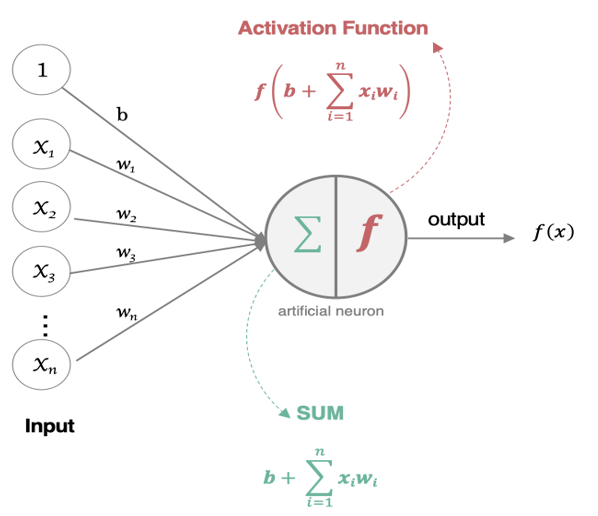
人工神经元:
接收多个输入信号
加权求和
通过激活函数输出
神经网络的优缺点
|优点|缺点|
| ---------------------------------| -------------------------------|
|✅ 精度高,性能优于传统机器学习|❌ 黑箱,难以解释|
|✅ 可近似任意非线性函数|❌ 训练时间长,需要大量计算力|
|✅ 大量框架和库可供调用|❌ 需要调整超参数|
|✅ 某些领域超过人类水平|❌ 小数据集上容易过拟合|
神经网络结构
基本组成
神经网络是由多个神经元组成,构建神经网络就是在构建神经元。
多个神经元构建神经网络,相邻层之间的神经元互相连接,并给每一个连接分配一个强度。(同层神经元之间相互隔离)
神经网络中信息只向一个方向移动,即从输入节点向前移动,通过隐藏节点,再向输出节点移动。
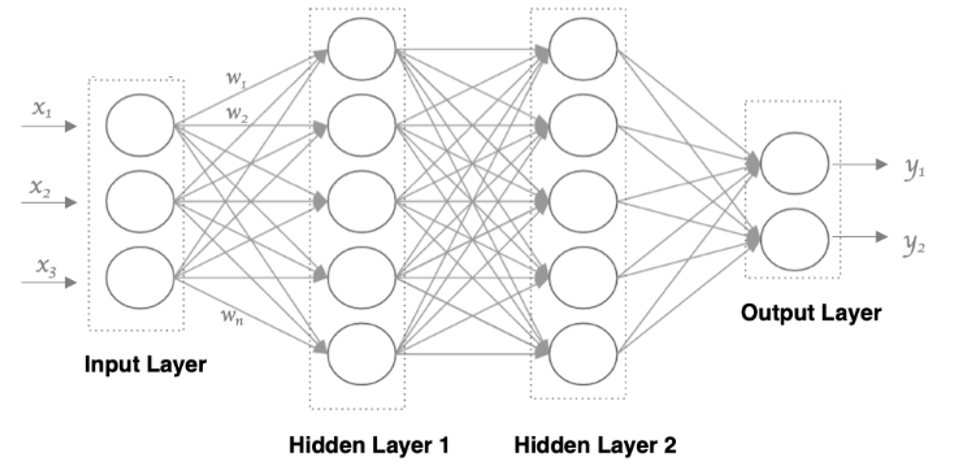
神经网络的基本组成结构:
输入层(Input Layer)
接收输入数据 (如图像、文本、声音等)
每个输入特征对应一个神经元
将数据传递给下一层的神经元
输出层(Output Layer)
输出结果
根据网络任务(回归、分类等)生成最终预测结果
隐藏层(Hidden Layers)
位于输入层和输出层之间
神经网络的"深度"由隐藏层数量决定
神经元通过加权和激活函数处理输入,并将结果传递到下一层
全连接神经网络的特点
|特点|说明|
| ------------| ----------------------------------------------------------|
|同层无连接|同一层的神经元之间没有连接|
|全连接结构|第N层的每个神经元与第N-1层的所有神经元相连(full connected)|
|数据维度|接收的样本数据是二维的,层间以二维形式传递|
|信息流向|第 N-1层的输出 = 第N层的输入|
|权重参数|每个连接都有权重值(w系数 和 b系数)|
内部状态值和激活值
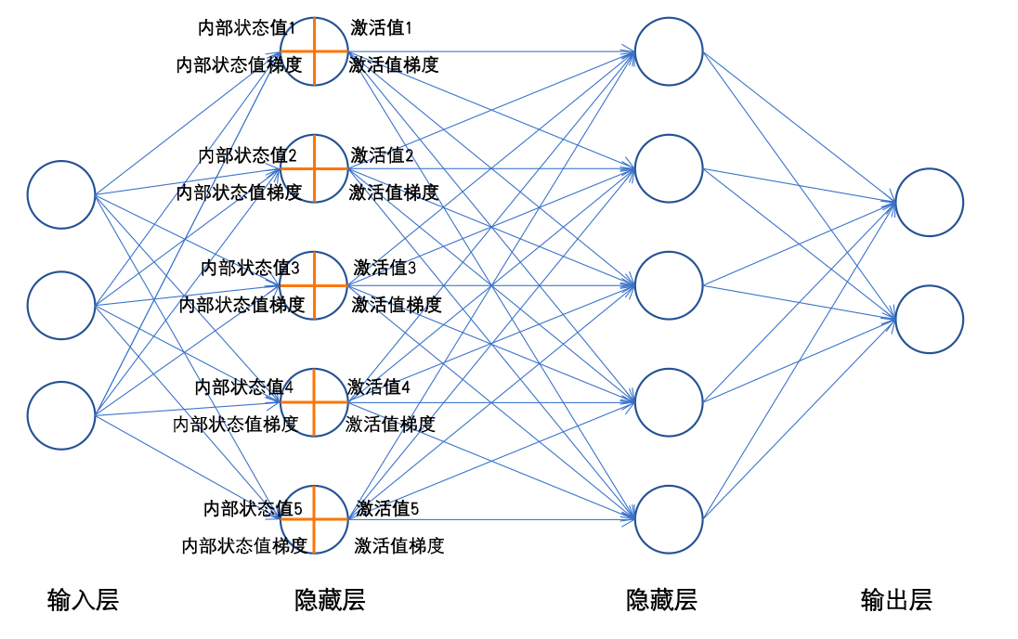
每个神经元工作时,前向传播会产生两个值,内部状态值(加权求和值)和激活值,反向传播会产生激活值梯度和内部状态值梯度
内部状态值(加权求和值):神经元或隐藏单元的内部存储值,反映当前神经元接收到的输入、历史信息以及网络内部的权重计算结果。
:权重矩阵, :输入值, :偏置(bias)
激活值:通过激活函数对内部状态值进行非线性变换后得到的结果,决定了当前神经元的最终输出。
:激活函数(如 ReLU、Sigmoid、Tanh), :内部状态值, :激活值(即神经元输出)
激活函数
作用
作用:用于对每层的输出数据进行变换,进而为整个网络注入了非线性因素。此时,神经网络就可以拟合各种曲线。
为什么需要非线性?
- 没有引入非线性因素的网络等价于使用一个线性模型来拟合。
- 通过给网络输出增加激活函数,实现引入非线性因素,使得网络模型可以逼近任意函数
- 提升网络对复杂问题的拟合能力。
sigmoid
公式:
求导公式:
图像:
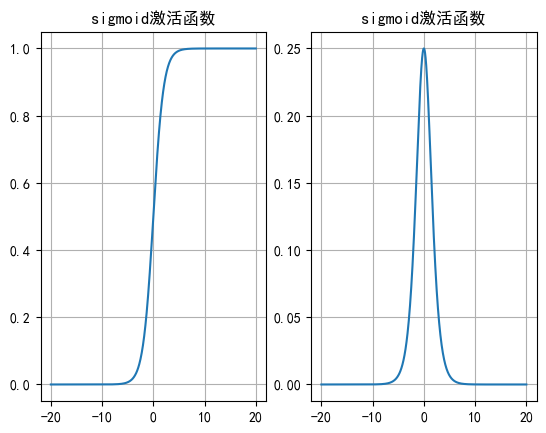
特性:
|特性|说明|
| ----------| -------------------------|
|输出范围|[0, 1]|
|信号特性|只有正数,无负数|
|概率解释|输出可理解为概率值|
|最大梯度|0.25(在 x=0 处)|
|有效区间|[-6, 6],之外梯度趋近 0|
缺点:梯度消失
python梯度连乘效应:0.25 × 0.25 × 0.25 × ... ≈ 0 ↑层数越多,梯度越接近0|网络深度|可用性|说明|
| :-----------------: | :---------: | :-------------------------------|
|浅层网络(≤5层)|⚠️ 可用|层数少,梯度消失不严重|
|深层网络(>5层)|❌ 不推荐|梯度消失严重,前面层几乎学不到|
使用建议:
|场景|是否推荐|原因|
| -----------------| -----------| ---------------------------------|
|二分类输出层|✅ 推荐|输出 [0,1] 天然适合概率解释|
|隐藏层(≤5层)|⚠️ 可用|层数少,梯度消失不严重|
|隐藏层(>5层)|❌ 不推荐|梯度消失,改用 ReLU|
tanh
公式:
求导公式
图像:
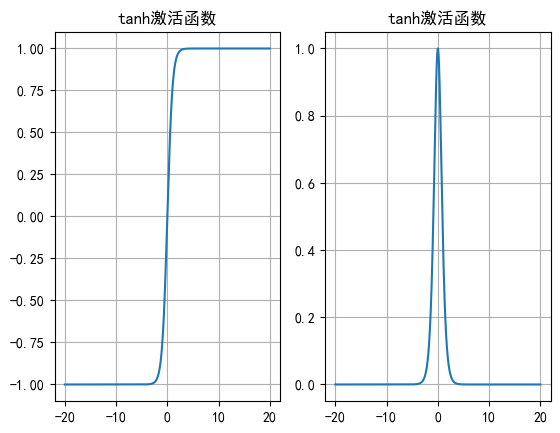
特性
输出特性(值域)
输出范围:[−1,1]
信号特性:有正有负,以0为中心对称
模型学习:能同时学习到"正信号"和"负信号",输出均值为0
有效输入区间
|加权求和值 |激活值分布|状态|
| :-----------: | :------------: | :-----------------------: |
| | |✅ 线性区,梯度正常传播|
| 或 |趋近 1 或 -1|❌ 饱和区,失去区分度|
梯度特性(导数)
导数值范围:
最大梯度:1(在 处取得)
有效区间:加权求和值在 时,梯度分布在 ,否则梯度趋近0
缺点:梯度消失
python梯度连乘效应:1 × 0.5 × 0.1 × 0.01 × ... ≈ 0 ↑层数越多,梯度越接近0 # 虽然tanh最大梯度为1,但非零输入区的梯度仍<1 # 深层网络中依然会出现梯度消失|网络深度|可用性|说明|
| :-----------------: | :---------: | :---------------------------|
|浅层网络(≤5层)|✅ 可用|梯度还能有效传播|
|深层网络(>5层)|❌ 不推荐|梯度消失,前面层几乎学不到|
使用建议
|场景|是否推荐|原因|
| :-----------------------| :-----------------: | :-------------------------------------------|
|隐藏层(≤5层)|⚠️ 可用|层数少,梯度消失不严重;零中心化有助于学习|
|隐藏层(>5层)|❌ 不推荐|梯度消失,改用 ReLU 或 LeakyReLU|
|二分类输出层|⚠️ 可用但非最佳|输出 需映射到 ,不如sigmoid直接|
|需要零中心化输出的场景|✅ 推荐|如某些RNN隐藏层、特征需要正负表示时|
relu
公式:
求导公式
图像
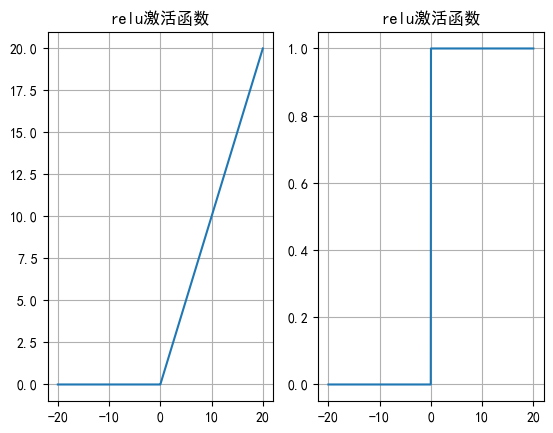
特性
输出特性(值域)
输出范围:
信号特性:只有正数,没有负数(负数区域直接截断为0)
模型学习:只能学习到"正信号",负信号被完全抑制
有效输入区间
|加权求和值 |激活值分布|状态|
| :-----------: | :----------: | :---------------------: |
| | |✅ 线性区,梯度恒为1|
| | |❌ 死亡区,神经元失活|
梯度特性(导数)
导数值:只有 0 或 1 两种取值
z>0 时:导数 = 1(梯度完全保留)
z≤0 时:导数 = 0(梯度完全阻断)
梯度传播:正区间不会出现梯度消失,负区间不会出现梯度爆炸
python梯度连乘效应(正区间):1 × 1 × 1 × ... = 1 ✅ 梯度健康传播 梯度连乘效应(负区间):0 × ? × ? × ... = 0 ❌ 神经元死亡,梯度断裂
缺点:神经元死亡(Dead ReLU)
python# 当神经元输出持续 ≤ 0 时: ReLU(z) = 0 → 梯度 = 0 → 权重不更新 → 神经元永久失活 # 常见原因: 1. 学习率过大:权重更新过猛,直接跳到负区间 2. 初始化不当:初始权重导致大部分输出为负 3. 数据分布偏移:输入数据经过BN后仍有较大负值|网络深度|可用性|说明|
| :--------: | :-----------------: | :---------------------------------------|
|浅层网络|✅ 可用|神经元死亡风险较低|
|深层网络|⚠️ 可用但需优化|配合He初始化、BatchNorm、LeakyReLU使用|
使用建议
|场景|是否推荐|原因|
| :-------------------| :-----------------: | :----------------------------------------|
|隐藏层(默认首选)|✅ 强烈推荐|计算简单、无梯度消失、收敛极快|
|深层网络(>10层)|⚠️ 配合优化使用|建议用 LeakyReLU / PReLU 防止神经元死亡|
|输出层|❌ 不推荐|无界输出不适合概率/回归任务|
|需要稀疏表示的场景|✅ 推荐|自然产生稀疏激活(约50%神经元为0)|
softmax
二分类函数 sigmoid 在多分类上的推广,二分类时,Softmax等价于Sigmoid
目的:将多分类的结果以概率的形式展现出来
将网络输出的 logits 通过 softmax 函数,映射成为(0,1)的值,而这些值的累加和为1(满足概率的性质),即选取概率最大(值对应最大)的节点,作为预测目标的类别。
公式:
其它常见的激活函数
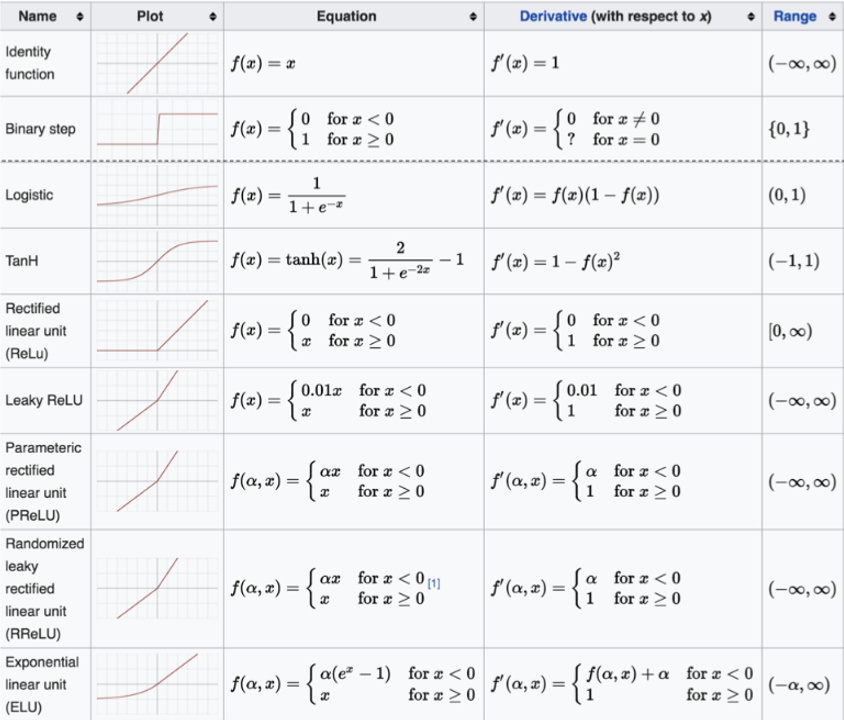
|函数|特点|适用场景|
| ------------| --------------------------------| --------------------------|
|Leaky ReLU|负区间有小斜率,防止神经元死亡|深层网络|
|ELU|指数线性单元,平滑负区间|深层网络|
|Swish/SiLU|自门控特性,性能优秀|Transformer|
|GELU|高斯误差线性单元|Transformer(BERT、GPT)|
如何选择激活函数
|网络类型/场景|隐藏层推荐|输出层推荐|
| ---------------| -------------------------------| ------------|
|浅层网络(1-2层)|Tanh / Sigmoid|根据任务定|
|深层CNN/MLP|ReLU|根据任务定|
|易神经元坏死|Leaky ReLU / ELU|根据任务定|
|RNN/LSTM|Tanh(内部)+ Sigmoid(门控)|根据任务定|
|Transformer|GELU / Swish|Softmax|
|二分类|ReLU|Sigmoid|
|多分类|ReLU|Softmax|
|回归|ReLU|无/线性|
总结:
隐藏层:深度网络首选ReLU,有问题换Leaky ReLU / ELU
输出层:根据任务选择 Sigmoid(二分类) / Softmax(多分类) / 线性(回归)
激活函数的代码示例
import torch


import matplotlib.pyplot as plt


plt.rcParams['font.sans-serif'] = ['SimHei']  # 用来正常显示中文标签


plt.rcParams['axes.unicode_minus'] = False  # 用来正常显示负号
sigmoidpython# sigmoid激活值: torch.sigmoid(x) # 创建x值, 线性模型输出值作为激活函数的输入值 x = torch.linspace(-20, 20, 1000) # 计算激活值 y = torch.sigmoid(input=x) # 创建画布对象和坐标轴对象 _, axes = plt.subplots(1, 2) # 一行两列, 绘制两个子图 axes[0].plot(x, y) axes[0].grid() axes[0].set_title('sigmoid激活函数') # 创建x值,可以自动微分, 线性模型输出值作为激活函数的输入值 x = torch.linspace(-20, 20, 1000, requires_grad=True) torch.sigmoid(input=x).sum().backward() axes[1].plot(x.detach().numpy(), x.grad) axes[1].grid() axes[1].set_title('sigmoid激活函数') plt.show()
tanhpython# 创建x值, 线性模型输出值作为激活函数的输入值 x = torch.linspace(-20, 20, 1000) # 计算激活值 y = torch.tanh(input=x) # 创建画布对象和坐标轴对象 _, axes = plt.subplots(1, 2) # 一行两列, 绘制两个子图 axes[0].plot(x, y) axes[0].grid() axes[0].set_title('tanh激活函数') # 创建x值,可以自动微分, 线性模型输出值作为激活函数的输入值 x = torch.linspace(-20, 20, 1000, requires_grad=True) torch.tanh(input=x).sum().backward() axes[1].plot(x.detach().numpy(), x.grad) axes[1].grid() axes[1].set_title('tanh激活函数') plt.show()
relupython# 创建x值, 线性模型输出值作为激活函数的输入值 x = torch.linspace(-20, 20, 1000) # 计算激活值 y = torch.relu(input=x) # torch.leaky_relu() # torch.prelu() # 创建画布对象和坐标轴对象 _, axes = plt.subplots(1, 2) # 一行两列, 绘制两个子图 axes[0].plot(x, y) axes[0].grid() axes[0].set_title('relu激活函数') # 创建x值,可以自动微分, 线性模型输出值作为激活函数的输入值 x = torch.linspace(-20, 20, 1000, requires_grad=True) torch.relu(input=x).sum().backward() axes[1].plot(x.detach().numpy(), x.grad) axes[1].grid() axes[1].set_title('relu激活函数') plt.show()
softmaxpython# 创建输出层加权求和值 y = torch.tensor(data=[[0.2, 0.02, 0.15, 0.15, 1.3, 0.5, 0.06, 1.1, 0.05, 3.75], [0.2, 0.02, 0.15, 3.75, 1.3, 0.5, 0.06, 1.1, 0.05, 0.15]]) # softmax激活函数转换成概率值 # 1轴按列计算 # y_softmax = torch.softmax(input=y, dim=-1) y_softmax = torch.softmax(input=y, dim=1) print('y_softmax->', y_softmax)python# 输出: y_softmax-> tensor([[0.0212, 0.0177, 0.0202, 0.0202, 0.0638, 0.0287, 0.0185, 0.0522, 0.0183, 0.7392], [0.0212, 0.0177, 0.0202, 0.7392, 0.0638, 0.0287, 0.0185, 0.0522, 0.0183, 0.0202]])
参数初始化
需要初始化的参数主要有:权重和偏置(偏置一般初始化为0)
作用
防止梯度消失或爆炸:初始权重值过大或过小会导致梯度在反向传播中指数级增大或缩小。
提高收敛速度:合理的初始化使得网络的激活值分布适中,有助于梯度高效更新。
保持对称性破除:权重的初始化需要打破对称性,否则网络的学习能力会受到限制。
常见参数初始化 方法
均匀分布初始化(随机初始化)
权重参数初始化从区间均匀随机取值,默认区间为 。可以设置为在 均匀分布中生成当前神经元的权重,其中 d 为神经元的输入数量
正态分布初始化(全0、1初始化)
随机初始化从均值为 0 ,标准差是 1 的高斯分布中取样,使用一些很小的值对参数 W 进行初始化
全0初始化
将神经网络中的所有权重参数初始化为 0
全1初始化
将神经网络中的所有权重参数初始化为 1
固定值初始化
将神经网络中的所有权重参数初始化为某个固定值
kaiming 初始化,也叫做 HE 初始化
HE 初始化分为 正态分布的 HE 初始化 和 均匀分布的 HE 初始化
正态分布的 he 初始化
w权重值从均值为0,标准差为std 中抽取样本的,
std值越大,w权重值离均值0分布相对较广,计算得到的内部状态值有较大的正值或负值。
均匀分布的 he 初始化
从 中的均匀分布中抽取样本,
xavier 初始化,也叫做 Glorot 初始化
xavier(泽维尔) 初始化分为 正态分布的 xavier 初始化 和 均匀分布的 xavier 初始化
正态化的 Xavier 初始化
从 中抽取样本的,
均匀分布的 Xavier 初始化
从 中的均匀分布中抽取样本,
fan_in :输入层神经元的个数。当前层接受的来自上一层的神经元的数量。
fan_out :输出层神经元个数。当前层输出的神经元的数量,也就是当前层会传递给下一层的神经元的数量。
总结
||优点|缺点|适用场景|
| --------------------------------| --------------------------------------------------| ------------------------------------------------------------------------------------------------------------| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
|随机初始化|能有效打破对称性|- 随机选择范围不当可能导致梯度问题|浅层网络或低复杂度模型,隐藏层1-3层,总层数不超过5层|
|正态分布 初始化|能有效打破对称性|- 随机选择范围不当可能导致梯度问题||
|全0 初始化|实现简单|- 无法打破对称性,所有神经元更新方向相同,无法有效训练|几乎不使用,仅用于偏置项的初始化|
|全1 初始化|实现简单|- 无法打破对称性,所有神经元更新方向相同,无法有效训练
- 会导致激活值在网络中呈指数增长,容易出现梯度爆炸|- 测试或调试:比如验证神经网络是否能正常前向传播和反向传播
- 特殊模型结构:某些稀疏网络或特定的自定义网络中可能需要手动设置部分参数为1
- 偏置初始化:偶尔可以将偏置初始化为小的正值(如0.1),但很少用1作为偏置的初始值|
|固定值 初始化|实现简单|- 无法打破对称性,所有神经元更新方向相同,无法有效训练
- 初始权重过大或过小可能导致梯度爆炸或梯度消失|- 测试或调试|
|kaiming 初始化|适合 ReLU,能保持梯度稳定|对非 ReLU 激活函数效果一般|深度网络(10层及以上),使用 ReLU、Leaky ReLU 激活函数|
|xavier 初始化|适用于Sigmoid、Tanh 等激活函数,解决梯度消失问题|对 ReLU 等激活函数表现欠佳|深度网络(10层及以上),使用 Sigmoid 或 Tanh 激活函数|
API
import torch.nn as nn


linear = nn.Linear(in_features=5, out_features=8)  # 线性层


tensor = linear.weight  # 权重


tensor = linear.bias    # 偏置


'''常用初始化方法'''


nn.init.uniform_(tensor,a,b)			# 均匀分布 初始化


nn.init.normal_(tensor, mean=1, std=2)	# 正态分布 初始化


nn.init.zeros_(tensor)  	# 全0 初始化


nn.init.ones_(tensor)  		# 全1 初始化


nn.init.constant_(tensor, val=0.1)	# 全固定值 初始化


nn.init.kaiming_uniform_()  # 恺明均匀分布 初始化


nn.init.kaiming_normal_()  	# 恺明正态分布 初始化


nn.init.xavier_uniform_()  	# xavier均匀分布 初始化


nn.init.xavier_normal_()  	# xavier正态分布 初始化
神经网络搭建
定义网络
在pytorch中定义深度神经网络其实就是层堆叠的过程,继承自nn.Module,实现两个方法:
__init__方法中定义网络中的层结构,主要是全连接层,并进行初始化
forward方法,在调用神经网络模型对象的时候,底层会自动调用该函数。作用:该函数中为初始化定义的 layer传入数据,进行前向传播等。
torchsummary
可视化模型架构和统计参数量
from torchsummary import summary


model = Net()


summary(model, input_size=(3,), device='cpu')