图像基础知识
图像的基本概念
在计算机中,按照颜色和灰度的多少可以将图像分为四种基本类型。
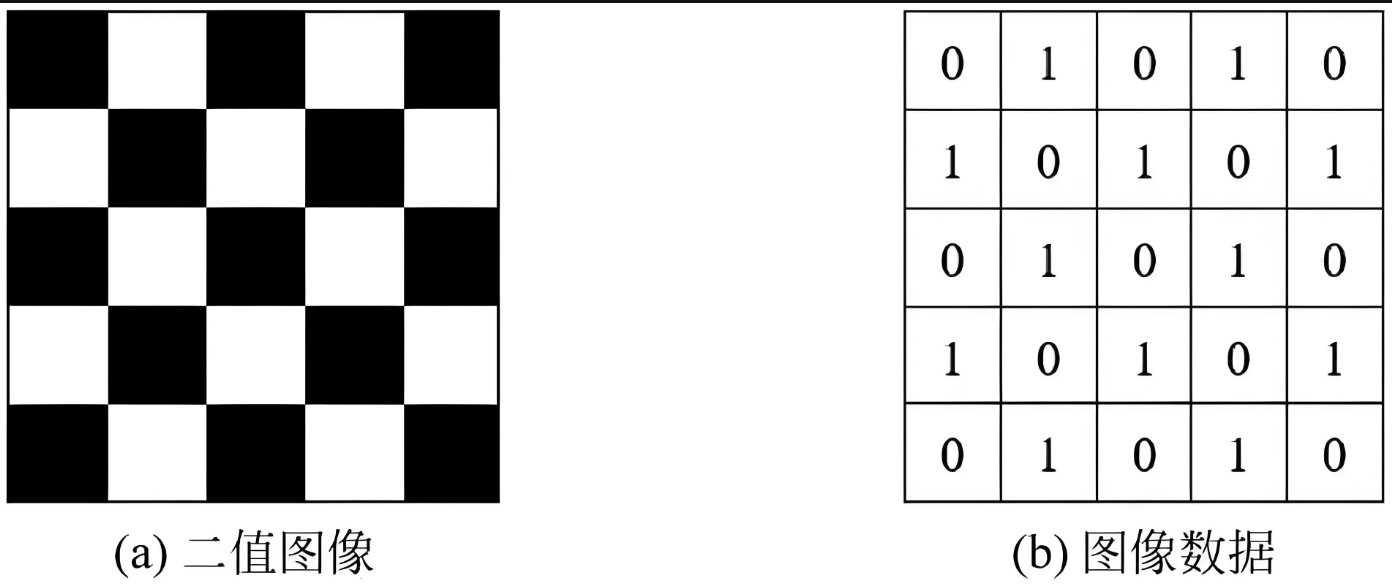
二值图像
一幅二值图像的二维矩阵仅由0、1两个值构成,“0”代表黑色,“1”代白色。由于每一像素(矩阵中每一元素)取值仅有0、1两种可能,所以计算机中二值图像的数据类型通常为1个二进制位。二值图像通常用于文字、线条图的扫描识别(OCR)和掩膜图像的存储。
灰度图像
灰度图像矩阵元素的取值范围通常为[0,255]。因此其数据类型一般为8位无符号整数的(int8),这就是人们经常提到的256灰度图像。“0”表示纯黑色,“255”表示纯白色,中间的数字从小到大表示由黑到白的过渡色。
二值图像可以看成是灰度图像的一个特例。
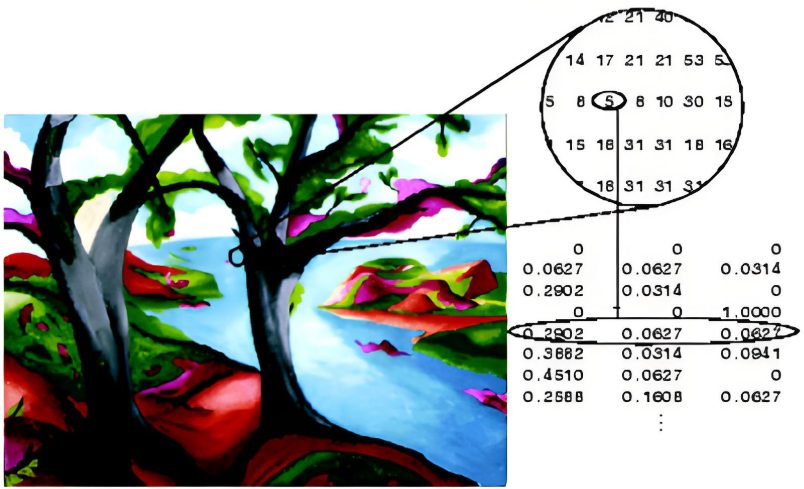
索引图像
索引图像可以简单理解为“用编号来涂颜色的图像”。它包含两个部分:
数据矩阵:一张二维表格,每个格子存放一个数字(索引),比如 0、1、2……这个数字不代表颜色本身,而是一个“颜色编号”。
颜色映射表(调色板) :一张列表,每一行对应一个编号,并存储该编号实际的红、绿、蓝(RGB)颜色值。
当我们要显示图像时,计算机先看数据矩阵里的每个数字,然后拿着这个数字去颜色映射表里找到对应的颜色,最后把颜色画在屏幕上。
真彩色RGB图像
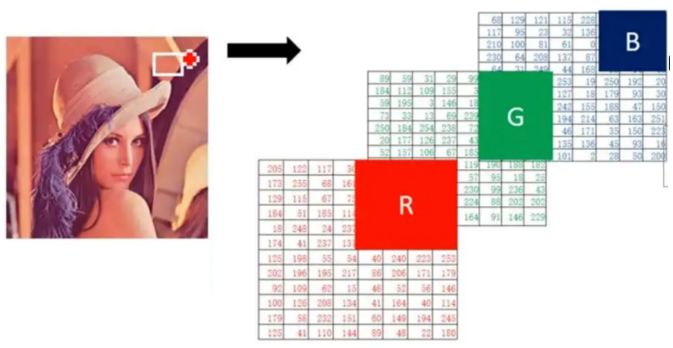
在真彩色 RGB 图像中,M 和 N 分别代表图像的行数(高度)和列数(宽度)。每个像素的颜色直接用 R、G、B 三个 0~255 的数值精确描述,总共可以组合出 256×256×256 ≈ 1670 万种颜色,人眼几乎无法区分这么多颜色,所以称为“真彩色”。
每个像素的颜色由红(R)、绿(G)、蓝(B)三个分量混合而成。所以,计算机需要为每个像素记录三个数值(分别代表 R、G、B 的亮度)。为了存储整张图,我们通常会用到三个独立的二维矩阵:
一个 R 矩阵:大小是 M×N,里面每个数字代表对应位置像素的红色亮度。
一个 G 矩阵:大小也是 M×N,代表绿色亮度。
一个 B 矩阵:大小同样是 M×N,代表蓝色亮度。
把这三个矩阵叠在一起,就组成了一个完整的 RGB 图像数据。在编程中,我们常用一个 M×N×3 的三维数组 来表示,其中最后一维是 3,分别对应 R、G、B 三个通道。
【注意】通道的顺序是 BGR 而不是 RGB。
|图像类型|通道数|像素值范围|主要特点|常见用途|
| ----------| ------------------| ------------------| ------------------------------------------| ----------------------------------|
|二值图像|1通道|0 或 1|每个像素只有黑与白两种值|形态学操作、二值化、轮廓检测|
|灰度图像|1通道|0 到 255|每个像素表示灰度(亮度)|图像预处理、物体检测、人脸识别|
|索引图像|1通道|0 到 255(索引)|像素值为颜色表的索引,颜色表决定实际颜色|存储压缩、较少颜色的图像表示|
|RGB图像|3通道(R、G、B)|0 到 255|每个像素由红、绿、蓝三个通道组成|普通彩色图像显示、图像处理与分析|
简单的讲:图像是由像素点组成的,每个像素点的取值范围为: [0, 255] 。像素值越接近于0,颜色越暗,接近于黑色;像素值越接近于255,颜色越亮,接近于白色。
在深度学习中,我们使用的图像大多是彩色图,彩色图由RGB的3个通道组成,如下图所示:
图像加载
import torch


import numpy as np


import matplotlib.pyplot as plt
# HWC, Height, Width, Channel


img1 = np.zeros((200, 200, 3))  # 黑色图像


img2 = np.ones((200, 200, 3))   # 白色图像


fig, axes = plt.subplots(1, 2, figsize=(10, 5))  # 1行2列


axes[0].imshow(img1)


axes[0].set_title('Image 1')


axes[0].axis('off')


axes[1].imshow(img2)


axes[1].set_title('Image 2')


axes[1].axis('off')


plt.show()
# 加载图像


img = plt.imread('./data/img.jpg')


plt.imshow(img)


plt.show()


# 保存图像


plt.imsave('./data/img.png', img)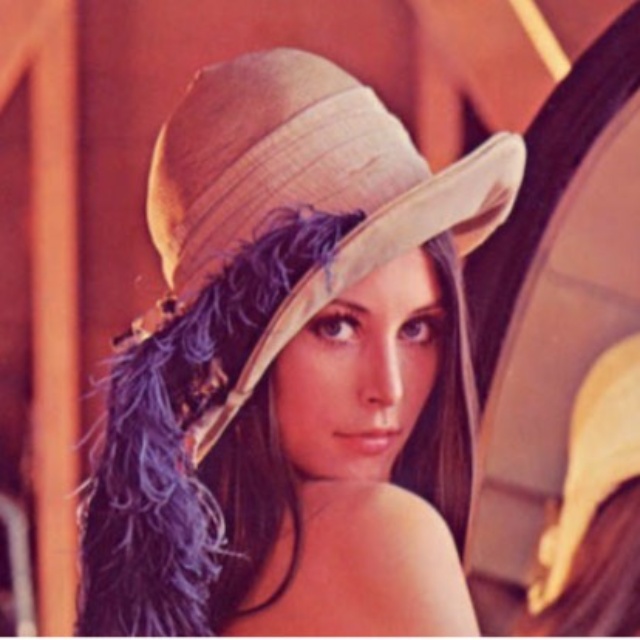
CNN 概述
什么是卷积神经网络
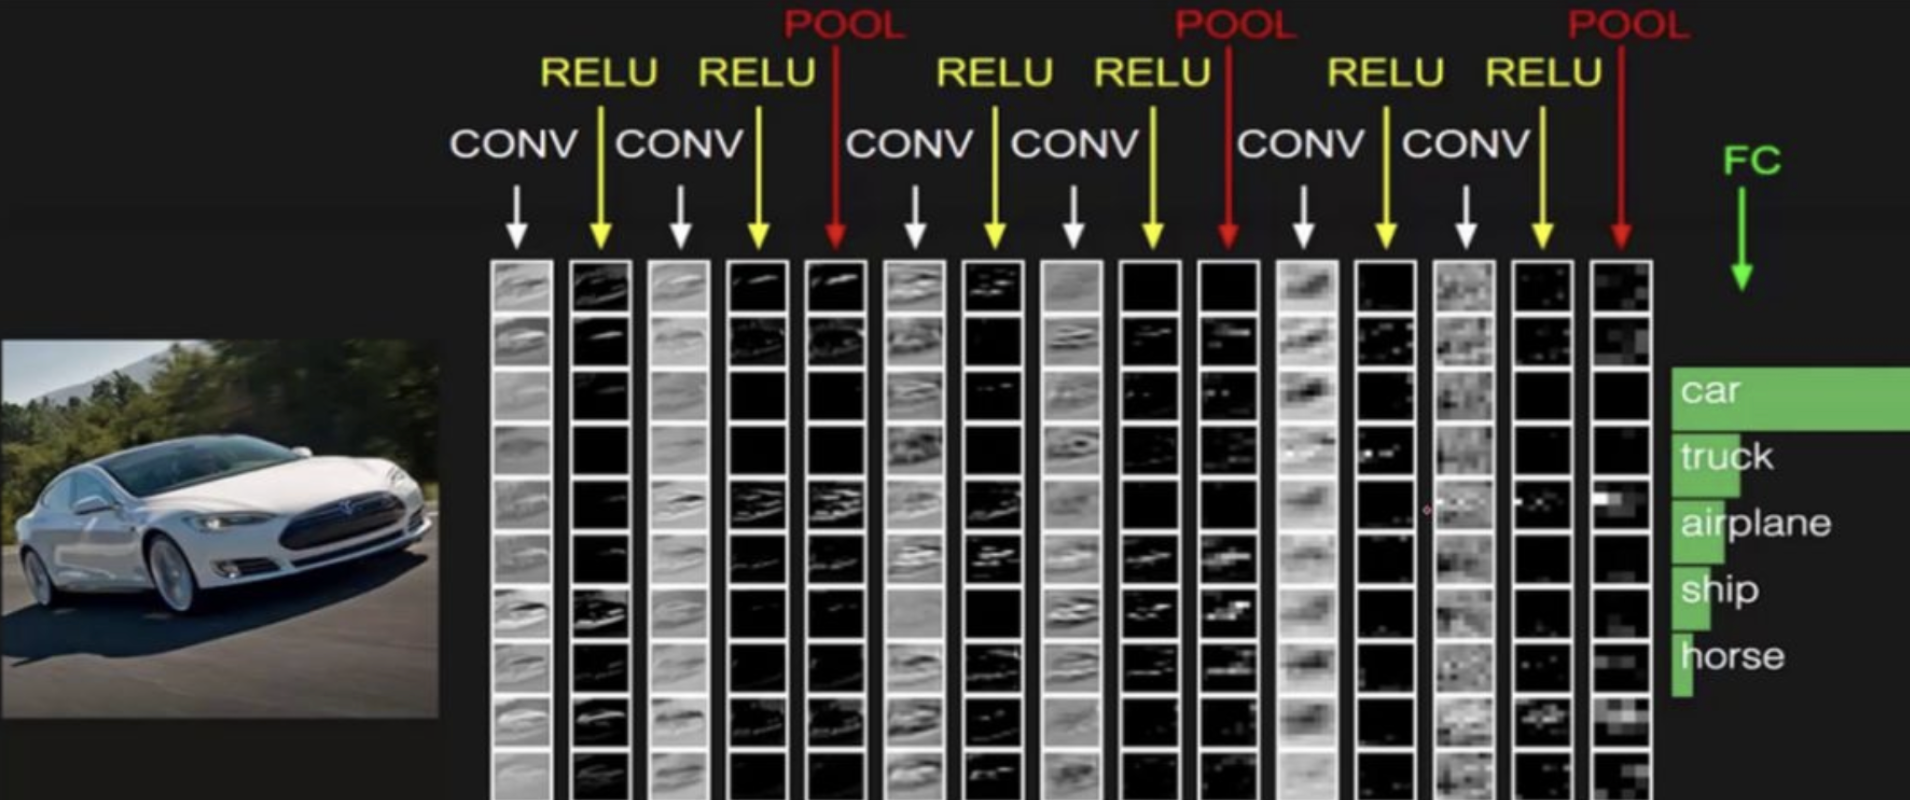
卷积神经网络(Convolutional Neural Network)是含有卷积层的神经网络,卷积层的作用就是用来:自动学习、提取图像的特征。
CNN网络主要由三部分构成:卷积层、池化层、全连接层
卷积层负责提取图像中的局部特征
池化层用来大幅降低参数量级(降维)
全连接层类似人工神经网络的部分,用来输出想要的结果
优势:权重共享、局部连接、参数少、适合图像
基本层级结构
输入 → 卷积层 → 激活函数 → 池化层 → ... → 全连接层 → 输出


              ↓           ↓


          特征提取    降维压缩
|层级|作用|
| ----------| ----------------------------------------|
|卷积层(CONV)|提取图像局部特征(边缘、纹理、形状等)|
|激活函数(ReLU)|引入非线性,增强表达能力|
|池化层(POOL)|降维,减少参数量,防止过拟合|
|全连接层(FC)|整合特征,输出分类结果|
数据输入层处理
对输入数据做预处理:
去均值:减去训练集均值(验证集/测试集也用训练集均值)
归一化:缩放到 [0,1] 或 标准化为 N(0,1)
PCA:主成分分析(可选)
基础组件
卷积层
基本概念
核心定义:CNN的“特征提取器”,通过卷积核滑动提取从边缘到语义的层级特征
主要作用:特征提取、权重共享、局部连接、空间不变性
核心计算规则 (单通道)
计算本质:滑动窗口 + 对应元素相乘 + 全局求和,最终得到输出特征图的 1 个像素值
计算流程:
卷积核(滤波器)以固定步长,在输入特征图上逐行逐列滑动
每滑动到一个位置,卷积核与覆盖的输入区域做元素级相乘
所有相乘结果相加,得到输出特征图对应位置的像素值
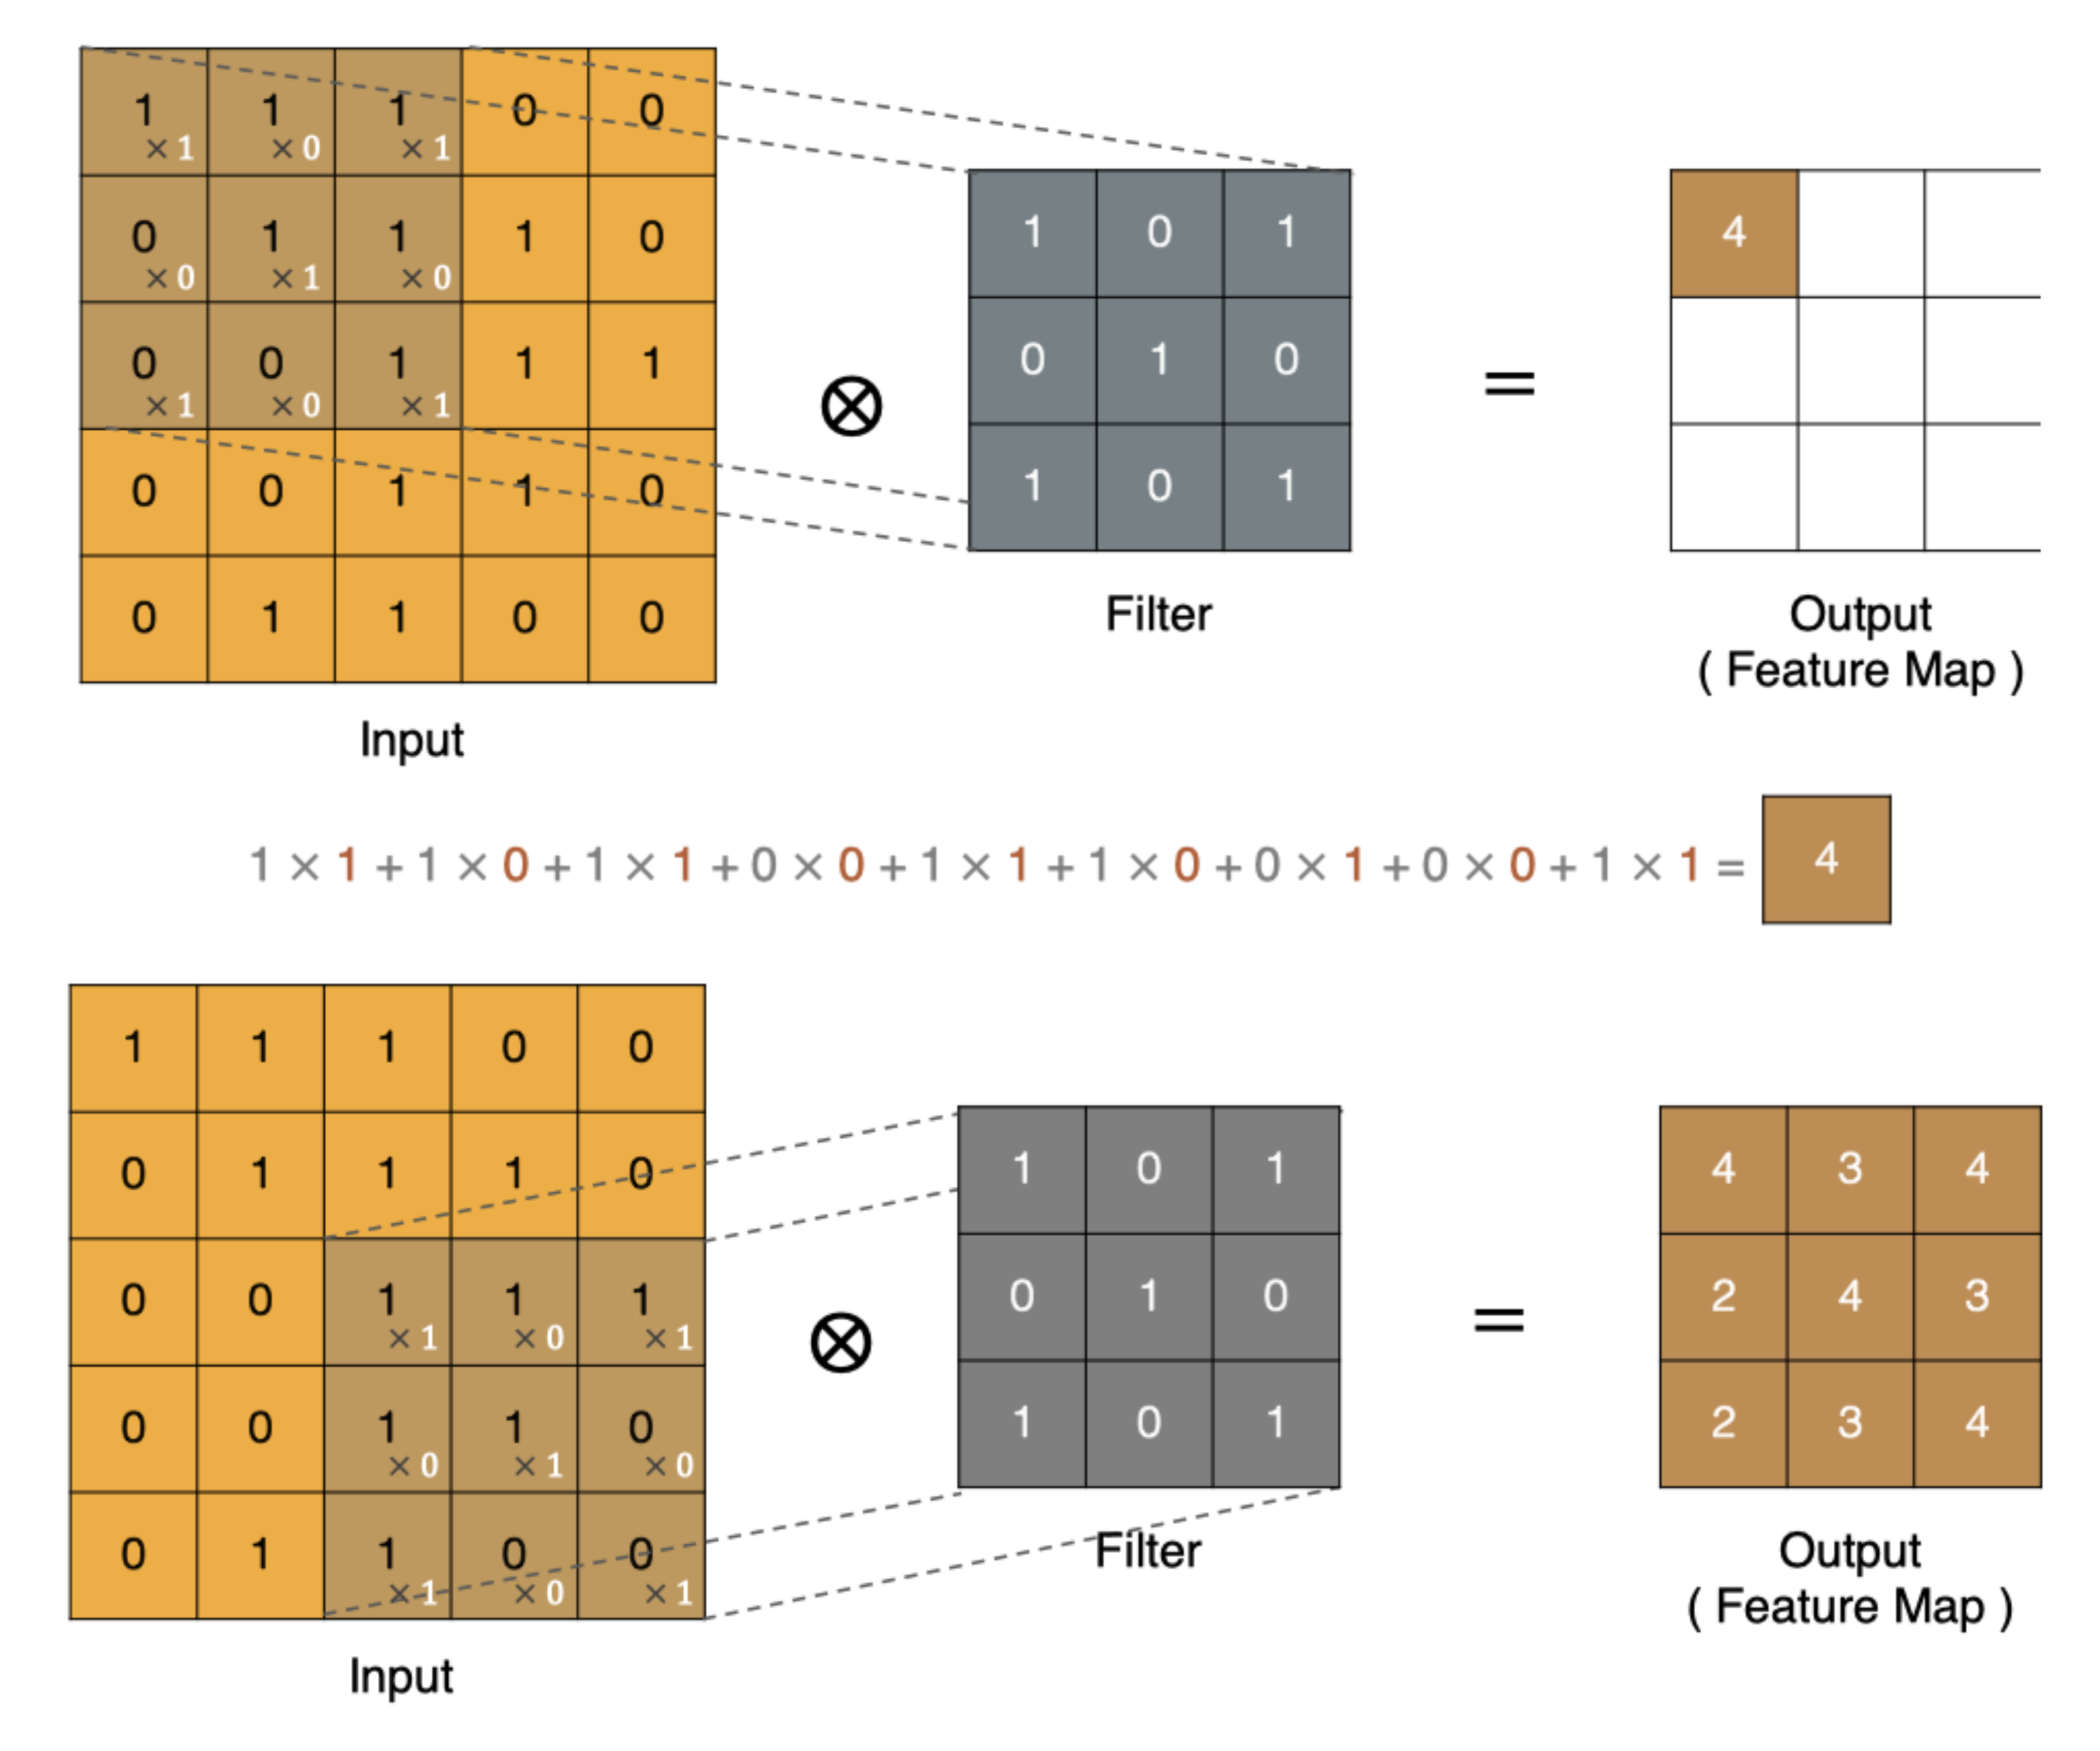
Filter 表示卷积核, 也叫做滤波器(滤波矩阵)
一组固定的权重,因为每个神经元的多个权重固定,所以又可以看做一个恒定的滤波器filter
非严格意义上来讲,下图中红框框起来的部分便可以理解为一个滤波器,即带着一组固定权重的神经元。多个滤波器叠加便成了卷积层
一个卷积核就是一个神经元
assets/20160822134955264-20260206112120-j1wy8sk
不同的滤波器filter会得到不同的输出数据,比如颜色深浅、轮廓。
输出尺寸公式(特征图)
结果不是整数:向下取整
核心参数
|参数|核心定义|核心作用|工程常用值|必背考点|高频易错点|
| ------| :-----------------------------------------| :-------------------------------------------------------------------------------| :------------------------------------------| :----------------------------------------------------------------------------------------------------------------| :-------------------------------------------------------------|
|卷积核大小 kernel_size|卷积核的宽 × 高,默认宽高相等|决定单次卷积覆盖的输入区域,直接影响感受野|3×3(首选) 、1×1、5×5|2 个 3×3 卷积堆叠 = 1 个 5×5 卷积的感受野,参数量更少、非线性更强;优先用奇数尺寸|偶数卷积核无法实现完美等尺寸填充,易出现特征偏移|
|步长 Stride|卷积核滑动时,每次移动的像素数|1. 控制输出尺寸,步长越大,输出越小;
2. 实现下采样,减少计算量,增大感受野
|1(网络早期层) 、 >1(网络后期层或需要快速降维)|步长 > 1 时,即使 Same Padding,输出尺寸也会小于输入|计算输出尺寸时,非整数结果需向下取整,不是四舍五入|
|填充 Padding|在输入特征图边缘填充像素(默认填 0)|1. 控制输出尺寸,避免卷积后过度缩小;
2. 保留边缘特征,防止边缘信息丢失
|0(Valid)、(kernel_size-1)/2(Same)|1. Valid Padding:无填充,输出缩小,丢失边缘信息;
2. Same Padding:步长 = 1 时,输出尺寸 = 输入尺寸
|误以为步长 > 1 时,Same Padding 也能保证输入输出尺寸一致|
|输入通道数 in_channels|输入特征图的通道数(如 RGB 图为 3 通道)|决定卷积核的通道数,匹配输入特征维度|浅层 16/32,深层 64/128/256|卷积核通道数必须和 in_channels 完全一致|混淆输入 / 输出通道数,导致卷积核维度设置错误|
|输出通道数 out_channels|输出特征图的通道数|决定可学习的特征类型数量,通道越多,特征越丰富|同上|out_channels完全等于卷积核的个数,和输入通道数无关|误以为输出通道数和输入通道数相关|
Padding 类型
|类型|说明|输出尺寸|
| ------| -------------------------------------------| -------------------------|
|Valid Padding|无填充(padding=0)|输出缩小,丢失边缘信息|
|Same Padding|填充使输出=输入(stride=1 时)|输出尺寸 = 输入尺寸|
|Full Padding|完全填充(padding=kernel_size-1)|输出放大|
多通道 卷积
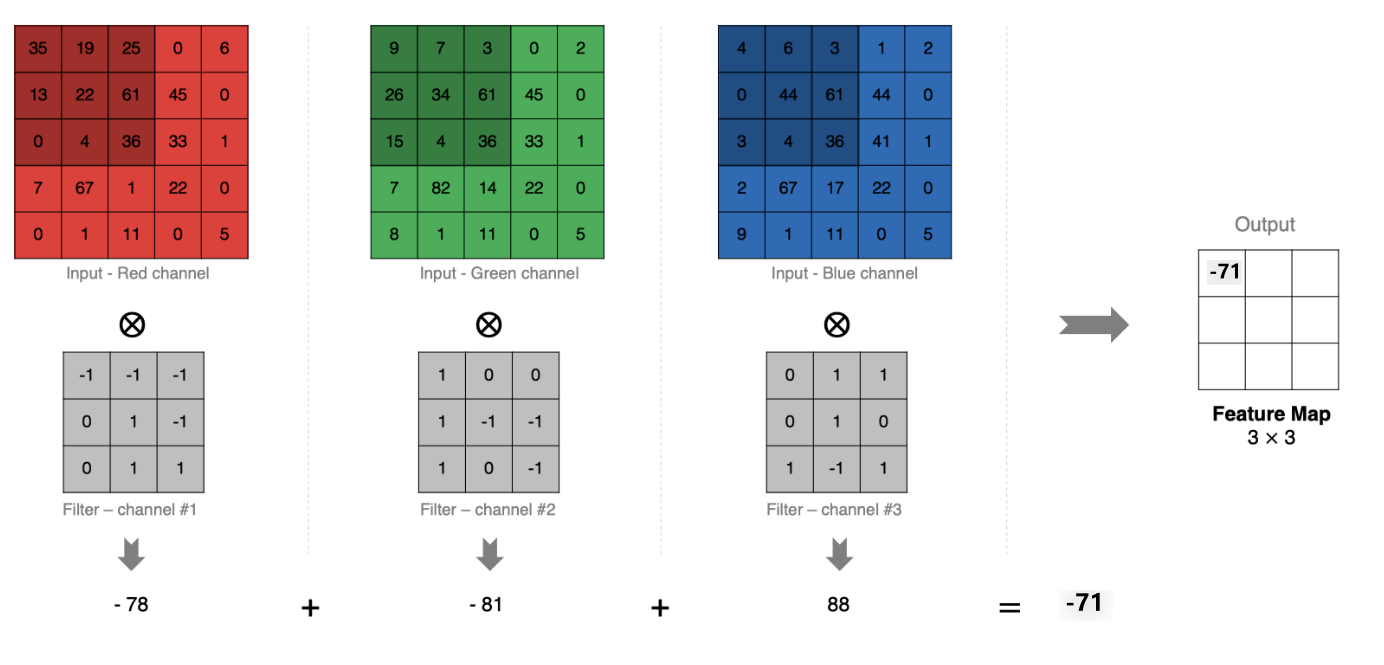
多通道单卷积核:输入多通道,输出单通道,通过“逐通道卷积+跨通道求和”实现。
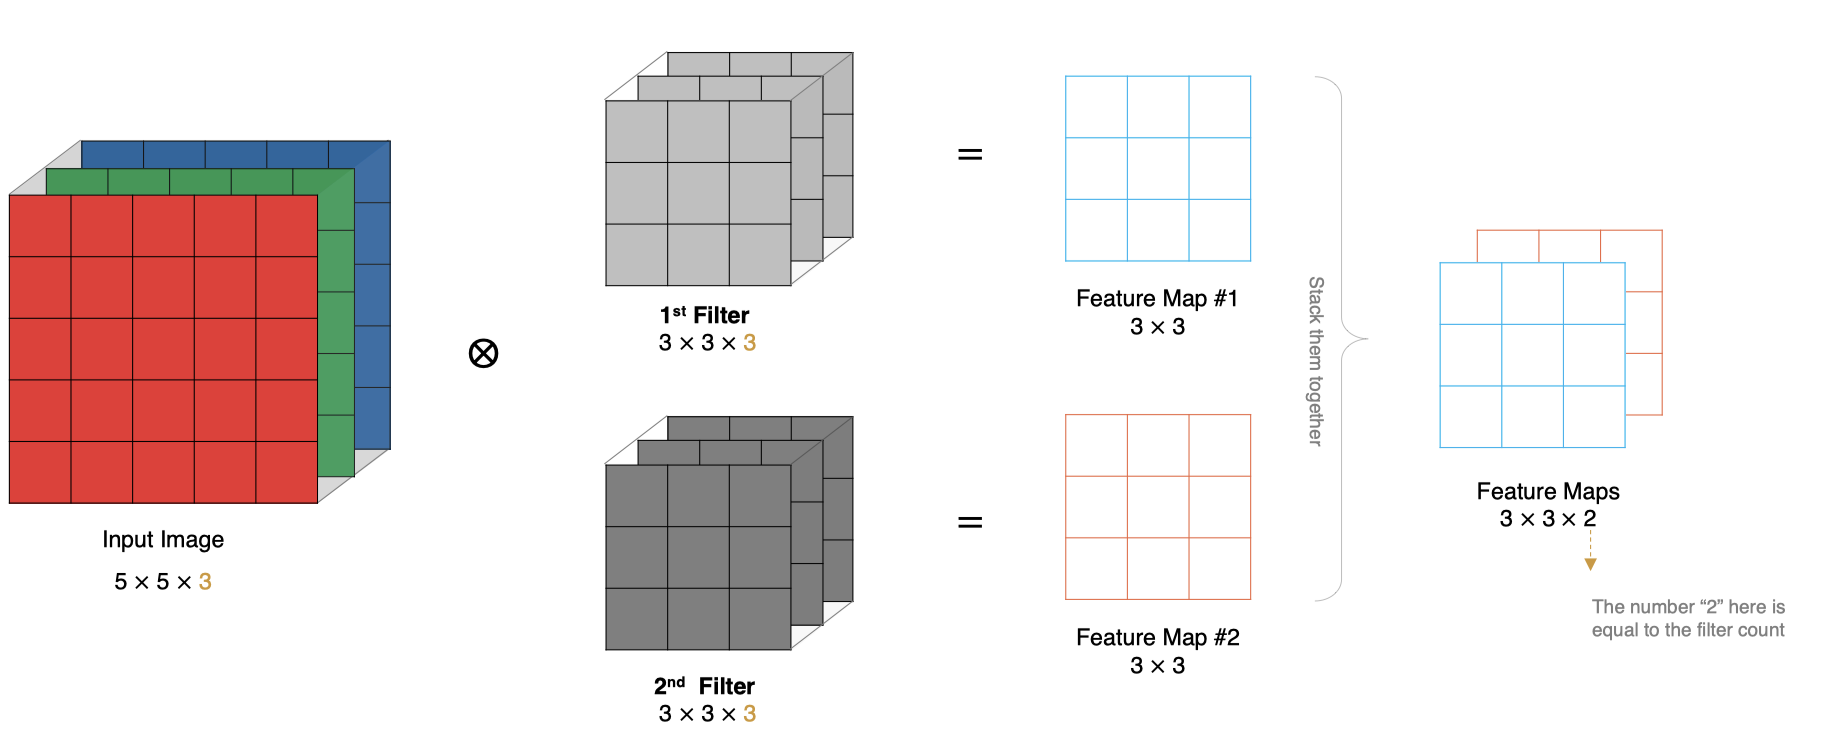
多通道多卷积核:输入多通道,输出多通道,每个卷积核独立生成一个输出通道,最后沿通道维度堆
⚠️ 关键规则:
- 卷积核通道数 必须 = 输入通道数
- 输出通道数 = 卷积核数量 ≠ 输入通道数
API
# 核心:in_channels, out_channels, kernel_size


nn.Conv2d(in_channels, out_channels, kernel_size, stride, padding)


'''


in_channels: 输入通道数,RGB图片一般是3


out_channels: 输出通道,也可以理解为卷积核kernel的数量


kernel_size:卷积核的高和宽设置,一般为3,5,7...


stride:卷积核移动的步长


	整数stride:表示在所有维度上使用相同的步长 stride=2 表示在水平和垂直方向上每次移动2个像素


	元组stride: 允许在不同维度上设置不同的步长 stride=(2, 1) 表示在水平方向上步长为2,在垂直方向上步长为1


padding:在四周加入padding的数量,默认补0


	padding=0:不进行填充。


	padding=1:在每个维度上填充 1 个像素(常用于保持输出尺寸与输入相同 padding=输入形状大小-输出形状大小)。


	padding='same'(从 PyTorch 1.9+ 开始支持):让输出特征图的尺寸与输入保持一致。PyTorch会自动计算需要的填充量。stride必须等于1,不支持跨行,因为计算padding时可能出现小数


	padding=kernel_size-1:Full Padding 完全填充


'''


# 注意:


# 1. padding='same' 时,stride必须为1。


# 2. 输出尺寸计算非整数时,向
池化层
基本概念
核心定义:CNN的“特征压缩器”,降维、减少计算量、防止过拟合。无学习参数。
主要作用:降维与计算量减少、提高特征鲁棒性、防止过拟合、层级化特征抽象、轻量化设计。
池化类型对比
|池化类型|操作描述|核心作用|典型位置|输出维度变化|
| --------------| -------------------------------------------| ----------------------------------------------------------------| -----------------------------------------------| --------------------------------------|
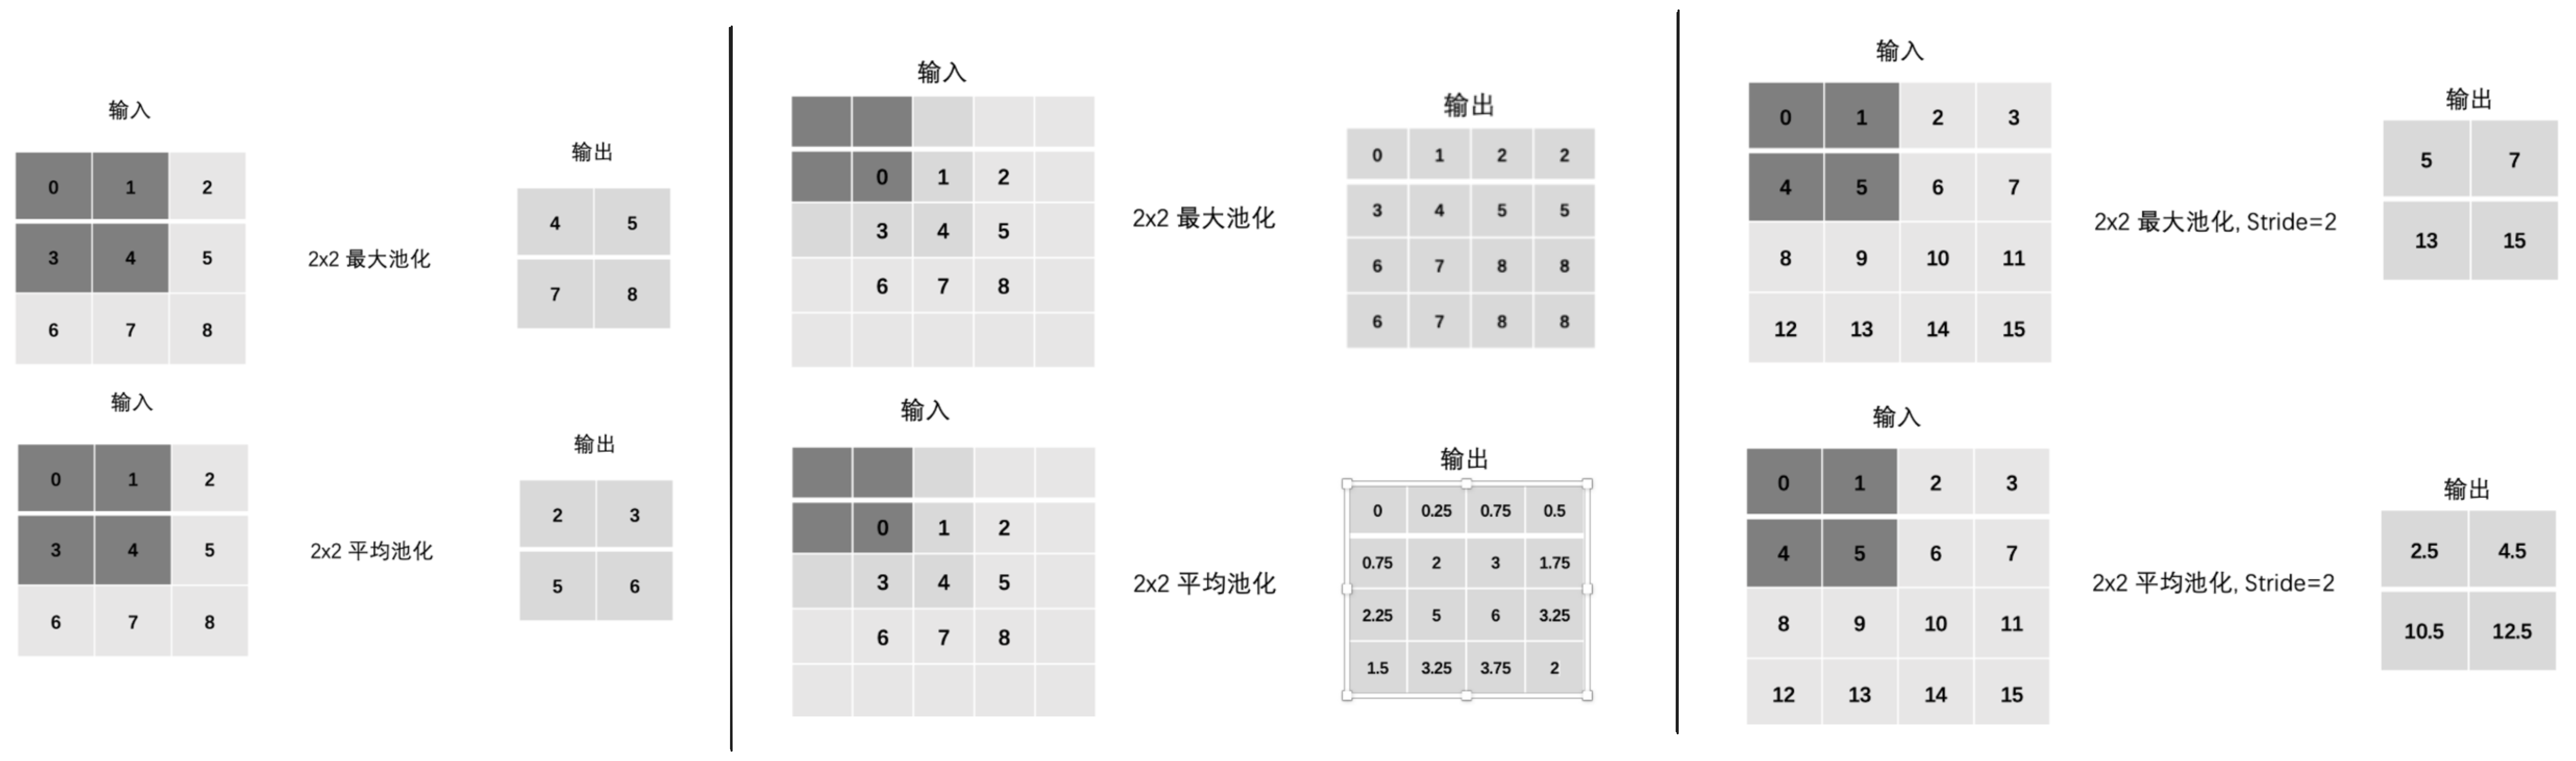
|最大池化|滑动窗口内取最大值|保留边缘、纹理等强响应特征,实现降维|CNN中间层(常与卷积搭配)|宽高缩小(如 k=2, s=2 时减半),通道数不变|
|平均池化|滑动窗口内取平均值|保留特征图整体分布,平滑特征、抑制噪声|CNN中间层(较少用于分类主干,偶见于部分网络)|宽高缩小,通道数不变|
|全局平均池化|对整个特征图取平均值(核大小 = 输入尺寸)|替代末端全连接层,参数量减少90%+,提升泛化能力与输入尺寸适应性|CNN末端,分类层之前|宽高压缩为 1×1,通道数不变|
共同点:三者均无可学习参数,仅对特征图进行固定规则的聚合操作。
核心计算规则
全局平均池化(Global Average Pooling, GAP)专属计算规则
全局平均池化是平均池化的特殊形式,属于池化层的核心分支,是现代CNN网络的必备设计,计算逻辑与常规滑动池化有本质区别:
核心定义:池化核大小 = 输入特征图的宽×高,即对每个输入通道的整张特征图,直接计算所有像素的平均值,输出1个标量值,无需滑动窗口。
计算逻辑:对每个通道独立执行「全图像素求和 ÷ 总像素数」,无任何可学习参数,无滑动过程。
输出尺寸:输入尺寸为
(N, C, H, W)(批次、通道、高、宽),输出尺寸固定为(N, C, 1, 1),宽高维度直接压缩为1×1。核心工程价值:替代CNN网络末端的全连接层,无需将特征图展平为一维向量,大幅减少参数量,同时避免全连接层容易出现的过拟合问题,是ResNet、MobileNet等经典网络的标准设计。
输出尺寸计算公式
1)常规滑动池化(与卷积层公式完全一致)
计算结果非整数时:向下取整,而非四舍五入。
(2)全局平均池化
输出宽高固定为 1×1,与输入宽高无关,仅通道数与输入保持一致。
核心参数
|参数|核心定义|核心作用|工程常用值|必背考点|高频易错点|
| ------------------------| ------------------------------------------| ------------------------------------------------------------------------------------| ---------------------------------------------------------| --------------------------------------------------------------------------------------------------| --------------------------------------------------------------------------------------|
|池化核大小 kernel_size|常规滑动池化窗口的宽 × 高,默认宽高相等|决定单次池化覆盖的输入区域,直接控制降维幅度与特征保留粒度|2×2(首选)、3×3|2×2 核 + stride=2 是最经典组合,可实现特征图尺寸精准减半,同时最大化保留核心信息|误以为池化核越大越好,过大的核会导致关键细节丢失,降维过于激进|
|步长 Stride|池化窗口滑动时,每次移动的像素数|1. 控制输出尺寸,步长越大,输出尺寸越小;
2. 实现高效下采样,平衡计算量与信息保留|2(与池化核大小一致)、1|步长与池化核大小一致时,可避免窗口重叠重复计算,是工程最优实践|步长设置过大导致特征图尺寸骤降,核心语义信息丢失;步长过小导致降维效果差,计算量冗余|
|填充 Padding|在输入特征图边缘填充像素(默认填0)|控制输出尺寸,避免边缘信息被过度压缩丢失|0(Valid,工程首选)、(kernel_size-1)/2(Same,极少用)|池化层通常不做填充(padding=0),以Valid方式为主,仅在需要精准控制输出尺寸时少量使用|误以为池化必须和卷积一样加Same填充,盲目填充会引入无效0值,干扰特征聚合结果|
|池化类型|滑动窗口内数据的聚合运算规则|决定特征保留的侧重点,直接影响后续特征提取的方向|Max Pooling(分类任务首选)、Avg Pooling|Max Pooling 强特征保留能力更适配图像分类、目标检测任务;Avg Pooling 更适配轻量网络、特征平滑场景|混淆两种池化的适用场景,盲目替换使用;在分类网络中全程使用Avg Pooling导致强特征丢失|
全局平均池化 专属参数说明
全局平均池化无需手动设置kernel_size、stride、padding,工程中通过自适应池化API实现,仅需指定输出尺寸为
1×1,API会自动匹配输入特征图的宽高作为池化核大小,适配任意输入尺寸,是工程开发的首选方案。
多通道 池化
输入通道数 = 输出通道数(仅压缩宽高,不改变通道数)
API
# 最大池化(最常用,网络中间层降维)


nn.MaxPool2d(kernel_size=2, stride=2, padding=0)


# 平均池化(常规滑动窗口版)


nn.AvgPool2d(kernel_size=2, stride=2, padding=0)


# 全局平均池化(网络末端轻量化,替代全连接层,工程首选)


nn.AdaptiveAvgPool2d(output_size=1)


'''


通用参数说明:


kernel_size:池化核的高和宽设置,常规池化首选2,支持整数/元组(分别设置高、宽)


stride:池化核移动的步长


	整数stride:所有维度使用相同步长,stride=2 表示水平、垂直方向均每次移动2个像素


	元组stride:不同维度设置不同步长,stride=(2, 1) 表示水平步长2,垂直步长1


padding:特征图边缘填充的像素数量,默认补0,常规池化首选0


output_size:自适应池化专属参数,指定输出特征图的宽高尺寸,全局平均池化固定为1


'''
经典网络架构
LeNet-5:作为最早的CNN架构之一,证明了CNN在图像识别任务上的有效性,为后续的CNN发展奠定了基础
卷积层: 提取图像的边缘、角点等基本特征
池化层 (子采样层): 降低特征图的维度,减少计算量,并提高模型对输入图像微小变化的鲁棒性
全连接层: 将卷积层和池化层提取的特征进行组合,用于最终的分类
AlexNet:显著提升了ImageNet图像分类的准确率,证明了深度学习在计算机视觉领域的潜力,并推动了深度学习的快速发展
卷积层: 使用更大的卷积核和更多的卷积核,提取更丰富的图像特征
ReLU激活函数: 加速训练过程,并提高模型的性能
最大池化层: 降低特征图的维度
Dropout层: 防止过拟合
全连接层: 用于最终的分类
VGGNet:探索了网络深度对性能的影响,证明了更深的网络可以提取更抽象和更具表达力的特征
卷积层: 使用更小的卷积核 (3x3),并堆叠多个卷积层,增加了网络的深度,提取更复杂的特征
最大池化层: 降低特征图的维度
全连接层: 用于最终的分类
GoogLeNet (Inception):提出了 Inception 模块,在提高性能的同时减少了计算量,为后续的网络架构设计提供了新的思路
- Inception 模块: 并行使用不同大小的卷积核和池化操作,然后将它们的输出连接起来,增加了网络的宽度,提高了网络的效率
ResNet:解决了深度网络训练困难的问题,使得可以训练更深的网络,从而显著提高了模型的性能
- 残差块 (Residual Block): 引入跳跃连接 (Shortcut Connection),允许梯度直接反向传播到浅层,解决了深度网络的梯度消失问题,使得训练非常深的网络成为可能
DenseNet:
密集块 (Dense Block): 将每一层都与之前的所有层连接,特征重用更加充分,进一步提高了网络的性能和参数效率
DenseNet通过密集连接(Dense Connectivity)在网络中各层之间建立了直接的连接,即每一层都接收前面所有层的输出作为输入。这种设计增强了特征传递和梯度流动,避免了梯度消失问题,并提高了信息的利用率
|网络|年份|核心贡献|特点|
| ------| ------| ----------------| -----------------------|
|LeNet-5|1998|首个成功 CNN|卷积 + 池化 + 全连接|
|AlexNet|2012|ImageNet 突破|ReLU/Dropout/大卷积核|
|VGGNet|2014|深度探索|3×3 小卷积核堆叠|
|GoogLeNet|2014|Inception 模块|并行多尺度卷积|
|ResNet|2015|残差连接|解决梯度消失|
|DenseNet|2017|密集连接|特征重用|
CNN 应用
图像分类:最常见的应用,例如识别图片中的物体类别
目标检测:检测图像中物体的位置和类别
图像分割:将图像分成多个区域,用于语义分割
人脸识别:识别图像中的人脸
医学图像分析:用于检测医学图像中的异常(如癌症检测、骨折检测等)
自动驾驶:用于识别交通标志、车辆、行人