特征工程
特征工程 概念
利用专业背景知识和技巧处理数据,让机器学习算法效果最好。这个过程就是特征工程(feature engineering)
数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限而已。
特征提取(feature extraction)
从原始数据中提取与任务相关的特征,构成特征向量
对于文本、图片这种非行列形式的数据行列形式转换,一旦转换成行列形式一列就是特征
特征预处理(feature preprocessing)
特征对模型产生影响;因量纲问题,有些特征对模型影响大、有些影响小
将不同的单位的特征数据转换成同一个范围内
使训练数据中不同特征对模型产生较为一致的影响
“量纲”(dimension)指物理量的种类(如长度、时间、质量)
“单位”(unit)是量纲的具体度量方式(如米、秒、千克)
- 不同特征的取值范围或尺度(scale)差异大(例如年龄∈[0,100],收入∈[0,1e6]),即使无物理单位,也会导致模型偏向大尺度特征。
特征预处理的方式:归一化、标准化
为什么进行归一化、标准化
防止因为量纲问题,导致特征列的反差值相差较大,影响模型的最终结果。
特征的单位或者大小相差较大,或者某特征的方差相比其他的特征要大出几个数量级,容易影响(支配)目标结果,使得一些模型(算法)无法学习到其它的特征。
归一化 (MinMaxScaler)
通过对原始数据进行变换,把数据映射到 (默认为 )之间
当 为 时, 所得即为归一化的结果
若 为 其他值,仍需计算 作为归一化的结果
弊端:归一化受到最大值与最小值的影响,容易受到异常数据的影响,鲁棒性较差。
适用场景:适用于数据分布较集中、无显著异常值、边界明确的场景;若存在异常值,max/min 会被扭曲,导致大部分数据被压缩到极小区间。
标准化 (StandardScaler)
通过对原始数据进行线性变换,使得结果均值为0、标准差为1,但不保证服从正态分布
$μ $:为特征的平均值
:为特征的标准差
适用场景:适用于存在异常值或未知数据分布的场景,对异常值鲁棒性较强,广泛用于大多数机器学习算法(如 SVM、逻辑回归、PCA 等)
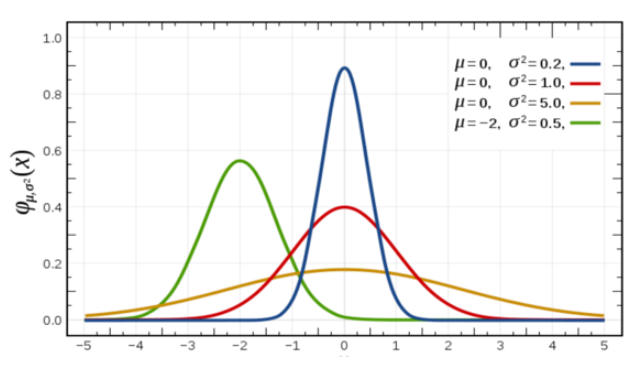
- 正态分布是一种概率分布,也叫高斯分布、钟形分布。
- 正态分布记作 ,其中 决定了其位置,其标准差 决定了分布的幅度。
- 当 时的正态分布是标准正态分布。
- 方差 是在概率论和统计学中衡量一组数据时离散程度的度量
,其中 为均值, 为数据总数。
【注】
sklearn 中的StandardScaler 使用总体标准差(分母为 nn),而非无偏样本标准差(分母 n−1n−1)
- 标准差 是方差开根号:
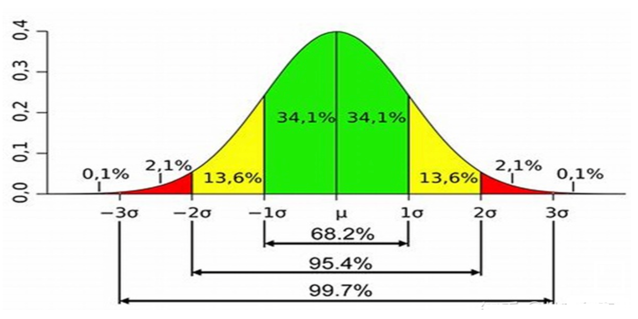
- 正态分布的 法则(68-95-99.7法则)
特征降维(feature decomposition)
将原始数据的维度降低
降维就需要保证数据的主要信息要保留下来
原始数据会发生变化,不需要了解数据本身是什么含义,它保留了最主要的信息
特征选择(feature selection)
选择任务需要的数据特征
原始数据特征很多,但是对任务相关是其中一个特征集合子集。
从特征中选择出一些重要特征(选择就需要根据一些指标来选择)
特征选择不会改变原来的数据
特征组合(feature crosses)
把多个的特征合并成一个特征
通过加法、乘法等方法将特征值合并
python[A × B]:将两个特征的值相乘 形成的特征组合。 [A × B × C × D × E]:将五个特征的值相乘 形成的特征组合。 [A × A]:对单个特征的值求平方 形成的特征组合。