模型评估
分类评估
混淆矩阵
一个 的方阵(C 为类别数),其中:
行(Rows) 表示真实标签(Actual / True Label)
列(Columns) 表示模型预测标签(Predicted Label)
对于最常见的二分类问题,混淆矩阵如下:
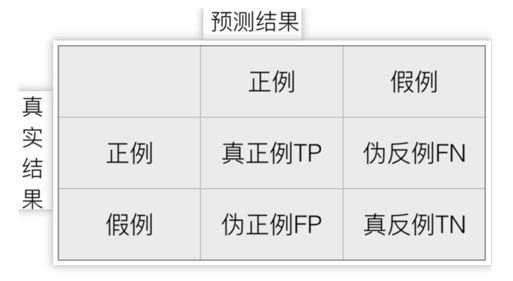
混淆矩阵四个指标:
|名称|含义|
| ------------------------------| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
|真正例(TP,True Positive)|真实值是正例的样本中,被分类为正例的样本数量有多少|
|伪反例(FN,False Negative)|真实值是正例的样本中,被分类为假例的样本数量有多少|
|伪正例(FP,False Positive)|真实值是假例的样本中,被分类为正例的样本数量有多少|
|真反例(TN,True Negative)|真实值是假例的样本中,被分类为假例的样本数量有多少|
准确率
准确率 (Accuracy):指的是预测正确的比重
精确率
精确率(Precision,也叫做查准率):指的是预测为真正例样本占所有预测为正例样本的比重。
召回率
召回率(Recall,也叫做查全率):指的是预测为真正例样本占所有真实正例样本的比重。
F1-score
如果我们对模型的精度、召回率都有要求,希望知道模型在这两个评估方向的综合预测能力如何?则可以使用 F1-score 指标。
AUC指标
我们发现:图像越靠近 (0,1) 点则模型对正负样本的辨别能力就越强
我们发现:图像越靠近 (0, 1) 点则 ROC 曲线下面的面积就会越大
AUC 是 ROC 曲线下面的面积,该值越大,则模型的辨别能力就越强
AUC 范围在 [0, 1] 之间
当 AUC= 1 时,该模型被认为是完美的分类器,但是几乎不存在完美分类器
AUC 值主要评估模型对正例样本、负例样本的辨别能力.
ROC曲线
ROC 曲线:我们分别考虑正负样本的情况:
正样本中被预测为正样本的概率,即:TPR (True Positive Rate)
负样本中被预测为正样本的概率,即:FPR (False Positive Rate)
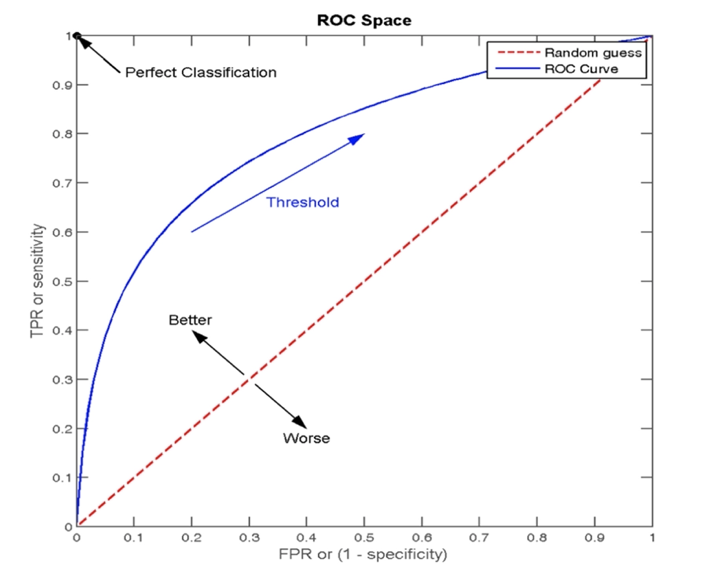
ROC 曲线图像中,4 个特殊点的含义:
(0, 0) 表示所有的正样本都预测为错误,所有的负样本都预测正确
(1, 0) 表示所有的正样本都预测错误,所有的负样本都预测错误
(1, 1) 表示所有的正样本都预测正确,所有的负样本都预测错误
(0, 1) 表示所有的正样本都预测正确,所有的负样本都预测正确
回归评估
目的:衡量预测值和真实值之间的差距
平均绝对误差(Mean Absolute Error,MAE)
其中: 为样本数量, 为实际值, 为预测值
MAE 越小模型预测越准确
均方误差(Mean Squared Error,MSE)
其中: 为样本数量, 为实际值, 为预测值
MSE 越小模型预测越准确
均方根误差(Root Mean Squared Error,RMSE)
其中: 为样本数量, 为实际值, 为预测值
RMSE 越小模型预测越准确
三种指标的比较
MAE反映的是“真实”的平均误差,RMSE会将误差大的数据点放大(放大预测误差较大的样本的影响)
MAE和RMSE 都能反映出预测值和真实值之间的误差
RMSE 公式中有平方项,大的误差将被平方,会增加 RMSE 的值。
RMSE 会放大预测误差较大的样本对结果的影响。大多数情况下 RMSE>MAE
RMSE 对预测误差较大的点比较敏感(对异常数据比较敏感)
假设数据中有少数异常点偏差很大,如果此时根据 RMSE 选择线性回归模型,可能会选出过拟合的模型来
这种情况下,由于数据中的异常点极少,选择具有最低 MAE 的回归模型可能更合适
聚类评估
SSE(Sum of Squared Errors,误差平方和)
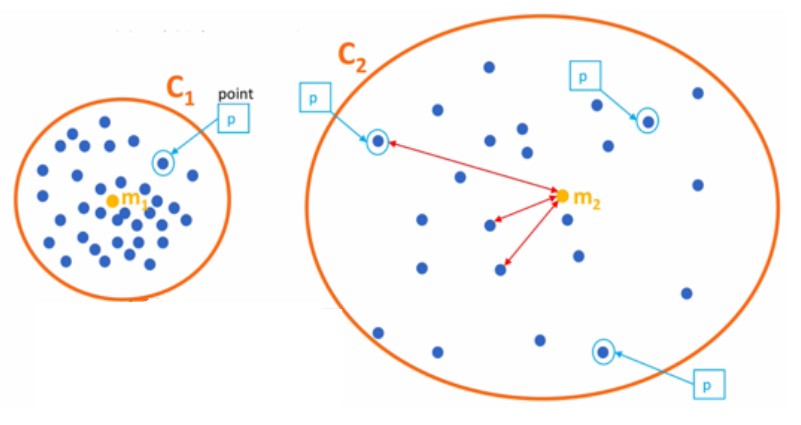
所有簇的所有样本到该簇执行的 误差平方和
表示聚类中心的个数
表示簇
表示样本
表示簇的质心
【注】
SSE越小,表示数据点越接近他们的中心,聚合效果越好
随着K值的增加,SSE值会逐渐减小
肘部法则
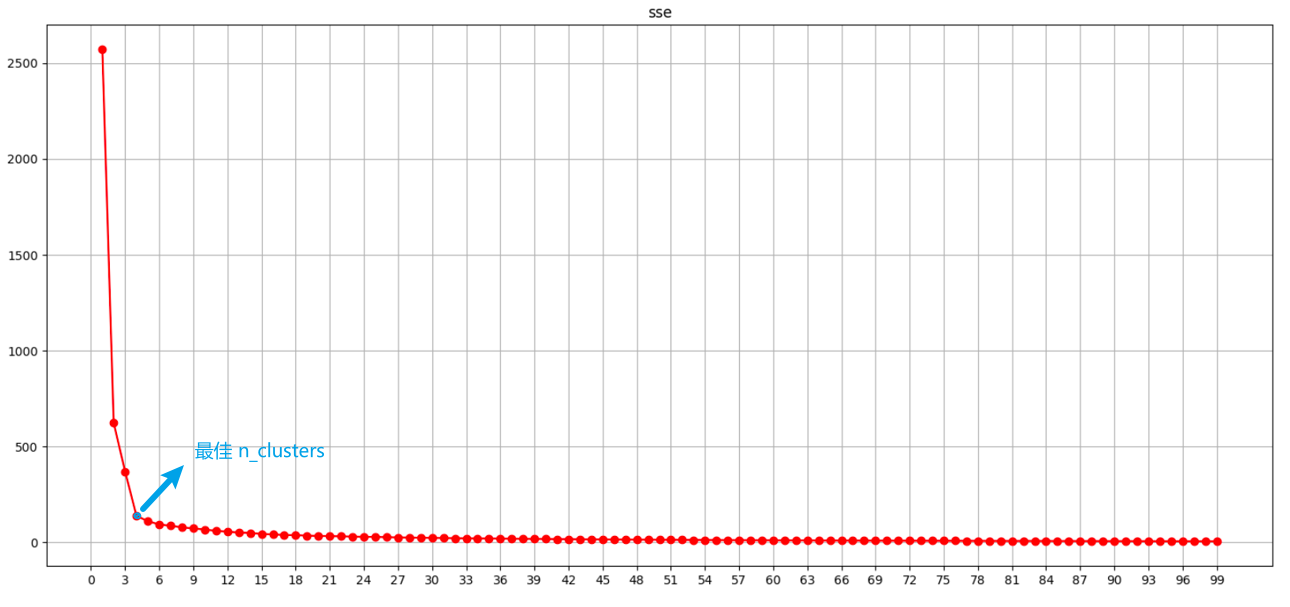
“肘”方法通过 SSE 确定 n_clusters 的值
对于 n 个点的数据集,尝试不同的 K 值(通常从 2 到 min(n, 10)),对每个 K 运行 KMeans 并记录其 SSE(即 inertia_)。
随着 K 增加,SSE 会单调递减,因为簇越多,每个簇越小,误差越低。
当 K 较小时,SSE 下降较快;当 K 增加到一定程度后,SSE 下降速度明显放缓,形成一个“肘部”拐点。
该拐点对应的 K 值被认为是合适的聚类数(最佳
n_clusters 值)——此时再增加簇数带来的性能提升有限。若无明显肘部,则说明数据结构复杂,建议结合轮廓系数或 CH 指数等其他评估指标综合判断。
⚠️ 注意事项:
数据必须先进行标准化处理;
每次运行 KMeans 应保持相同参数(如 n_init、random_state);
肘部法仅作为参考,不能绝对依赖。
SC 轮廓系数法(Silhoutte Coefficient)
轮廓系数综合考虑簇内的内聚程度(Cohesion)和簇外的分离程度(Separation),是评估聚类质量的重要无监督指标。
计算步骤如下:
对每个样本 :
计算其到同簇内其他样本的平均距离 :
越小越好,表示簇内相似度高。内聚越高
计算其到最近邻簇 的所有样本的平均距离 :
越大越好,表示该样本与其他簇区分明显。耦合越低
计算样本 的轮廓系数:
分母用 确保结果 在 [-1, 1] 范围内;
当 时, ,表示样本可能被误分。
计算所有样本的轮廓系数的 算术平均值,作为整体聚类效果评分。
轮廓系数范围:
:样本紧靠同类,远离异类 → 聚类效果好;
:样本位于两个簇边界 → 聚类效果一般;
:样本更接近其他簇 → 可能是误分。
使用场景:
选择最优 K 值(选择使平均轮廓系数最大的 K);
比较不同聚类算法的效果;
识别可能的异常点(S < 0 的样本)。
⚠️ 注意事项:
数据必须标准化;
适用于任意形状的簇(比 CH 指数更鲁棒);
计算复杂度较高,不适合超大数据集。
CH 指数(Calinski-Harabasz Index)
CH 指数衡量聚类质量,综合考虑:
簇内的内聚程度(越小越好)
簇间的离散程度(越大越好)
聚类数目(通过归一化因子控制),即质心的个数
公式:
其中:
:样本总数
:聚类数(K 值),质心个数
:簇内平方和(Within-cluster sum of squares)
:簇间平方和(Between-cluster sum of squares)
- SSW(簇内距离):越小表示簇内越紧凑
\text{SSW} = \sum_{i=1}^{m} ||x_i - C_{pi}||^2
- :第 j 个簇的质心
- :属于簇 的样本
- SSB(簇间距离):越大表示簇间分离度越高
\text{SSB} = \sum_{j=1}^{k} n_j ||C_j - \bar{X}||^2
- :第 j 个簇的样本数
- :所有样本的全局均值
归一化因子 :
- 用于平衡 K 的影响,避免因 K 增大而得分虚高
解读:
CH 指数越大越好
选择使 CH 指数最大的 K 值作为最优聚类数
⚠️ 注意事项:
数据必须标准化
适用于球形、大小相近的簇
对非球形或不均衡数据效果较差
小结
误差平方和 SSE
误差平方和的值越小越好
主要考量:簇内聚程度
肘部法
- 下降率突然变缓时,即认为是最佳的k值
SC 系数
取值为 [-1, 1],其值越大越好
主要考量:簇内聚程度,簇间分离程度
CH 系数
分数s 高,则聚类效果好
CH 达到的目的:用尽量少的类别聚类尽量多的样本,同时获得较好的聚类效果
主要考量:簇内聚程度、簇间分离程度、质心个数