机器学习 案例
拟合问题
【示例】欠拟合&过拟合
import numpy as np


import matplotlib.pyplot as plt


from sklearn.metrics import mean_squared_error


from sklearn.linear_model import LinearRegression


# 生成数据


# 设置随机数种子


np.random.seed(42)


# 生成x轴 100个数据


x = np.random.uniform(-3.0, 3.0, size=100)  # 随机生成100个[-3.0, 3.0]之间的数据


# 生成y轴 100个数据,通过线性公式:0.5 * x ** 2 + x + 2 + 噪声


y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, size=100)  # 随机生成100个“平均值为0标准差为1”的数据作为噪声


# 数据预处理


'''展示欠拟合'''


X = x.reshape(-1, 1)  # 改变x的形状为:多行1列


# 若要显示 拟合或欠拟合,添加对应一行的代码


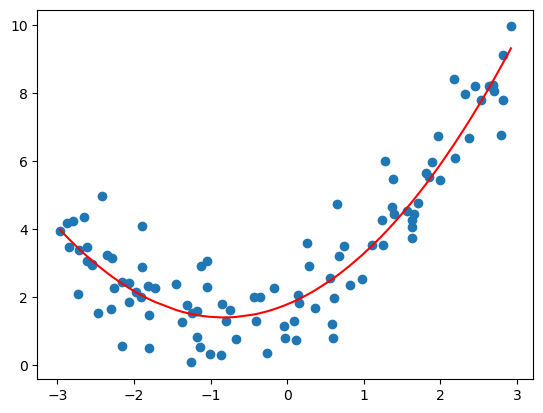
'''展示正好拟合'''


# 由于模型过于简单,会出现欠拟合的情况,因此增加模型复杂度:增加 1列特征列


X = np.hstack([X, X ** 2])  # 横向拼接


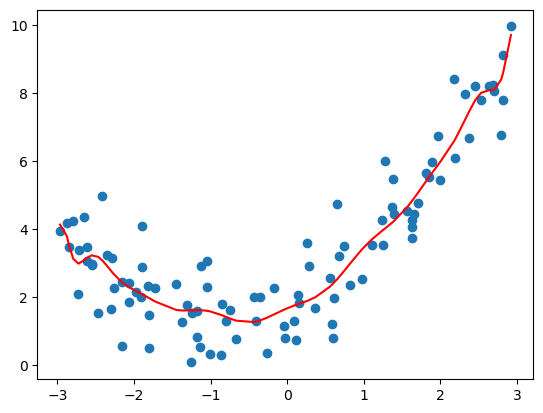
'''展示过拟合'''


# 添加 10列特征列,增加模型复杂度,模拟过拟合


X = np.hstack([X, X**2, X**4, X**6, X**8, X**10, X**12, X**14, X**16, X**18])


# 模型训练


model = LinearRegression()


model.fit(X, y)


# 模型预测


y_predict = model.predict(X)


# 模型评估


print('MSE: ', mean_squared_error(y, y_predict))


# 可视化


plt.scatter(x, y)  # 绘制散点图


plt.plot(x, y_predict, color='r')  # 绘制拟合曲线(折线图)


plt.show()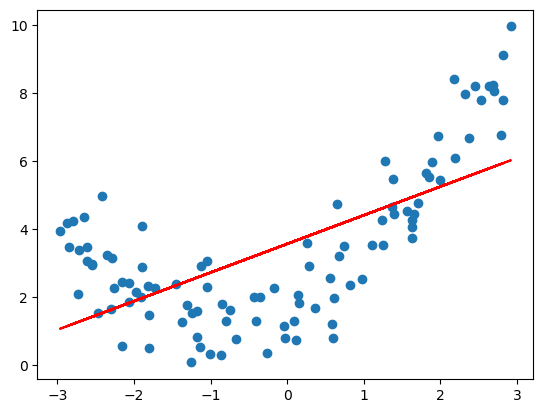
【示例】正则化
import numpy as np


import matplotlib.pyplot as plt


from sklearn.metrics import mean_squared_error


from sklearn.linear_model import Lasso, Ridge


# 生成数据


# 设置随机数种子


np.random.seed(42)


# 生成x轴 100个数据


x = np.random.uniform(-3.0, 3.0, size=100)  # 随机生成100个[-3.0, 3.0]之间的数据


# 生成y轴 100个数据,通过线性公式:0.5 * x ** 2 + x + 2 + 噪声


y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, size=100)  # 随机生成100个“平均值为0标准差为1”的数据作为噪声


# 数据预处理


X = x.reshape(-1, 1)  # 改变x的形状为:多行1列


# 添加 10列特征列,增加模型复杂度,模拟过拟合


X = np.hstack([X, X**2, X**3, X**4, X**5, X**6, X**7, X**8, X**9, X**10])


# 模型训练


'''过拟合-正则化-Lasso'''


model = Lasso(alpha=0.1)


'''过拟合-正则化-Ridge'''


model = Ridge(alpha=0.1)


model.fit(X, y)


# 模型预测


y_predict = model.predict(X)


# 模型评估


print('MSE: ', mean_squared_error(y, y_predict))


# 可视化


plt.scatter(x, y)  # 绘制散点图


# plt.plot(x, y_predict, color='r')  # 绘制拟合曲线(折线图)


plt.plot(np.sort(x), y_predict[np.argsort(x)], color='r')


#    sort() 对x排序,默认升序


# argsort() 对x排序,返回排序后的索引


plt.show()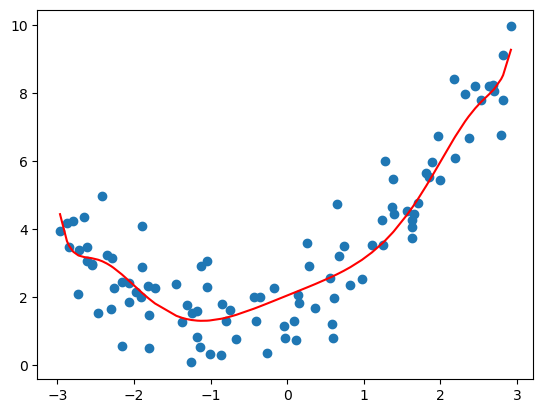
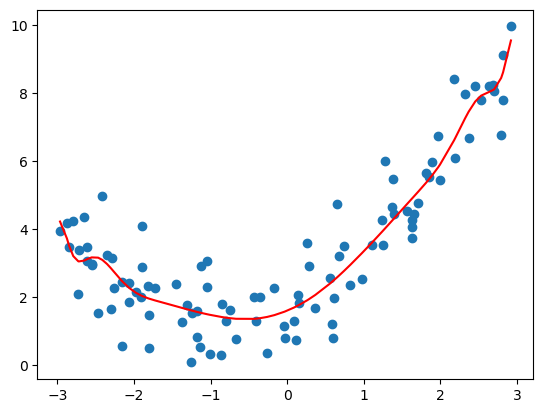
KNN算法
【案例】利用K近邻算法预测电影类型
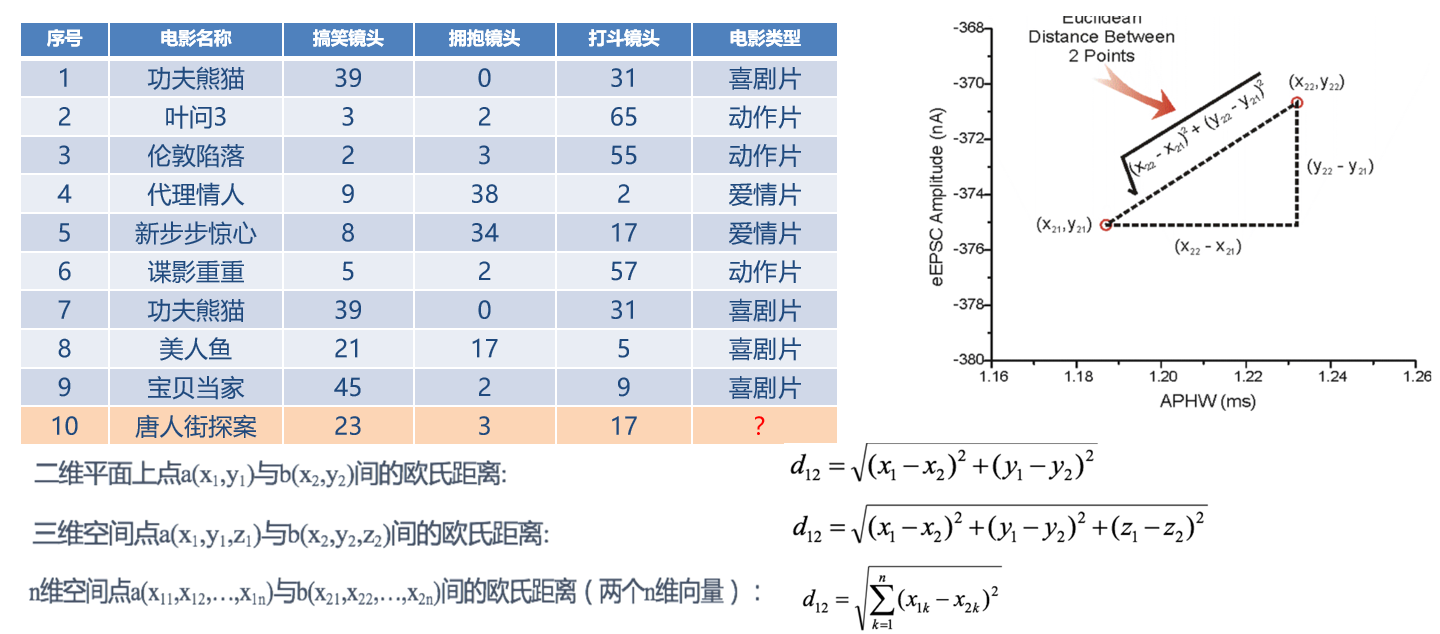
欧式距离 = 对应维度差值平方和,开平方根计算 功夫熊猫和唐人街探案的欧式距离:
分别计算 10号电影与前9个电影的距离
k=5,找出最近5个最相似的电影类别,来决定10号电影的类别
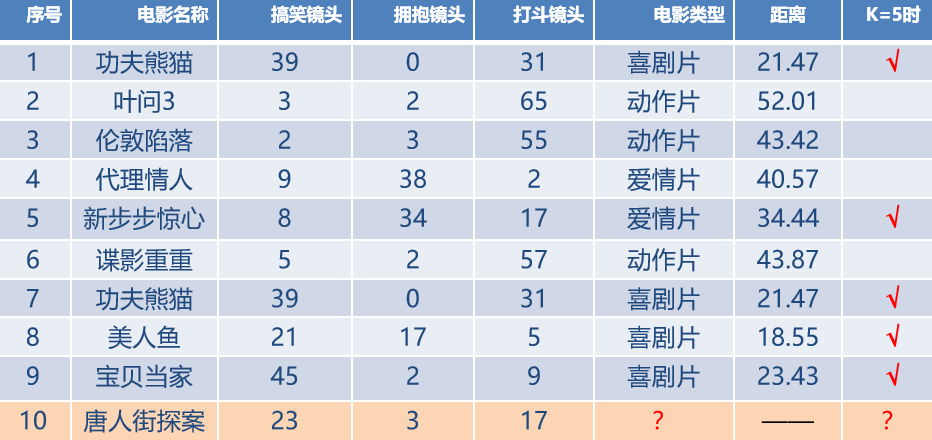
根据距离排序:
8(喜剧片)-> 1、7(喜剧片)-> 9(喜剧片)-> 5(爱情片)故而预测唐人街探案为:喜剧片
【案例】基于KNN对鸢尾花分类
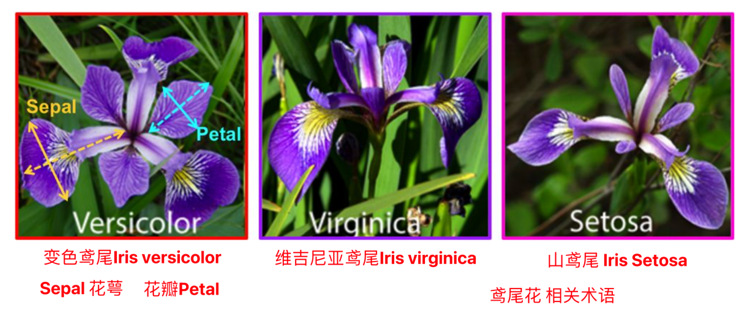
每个花的特征用如下属性描述:
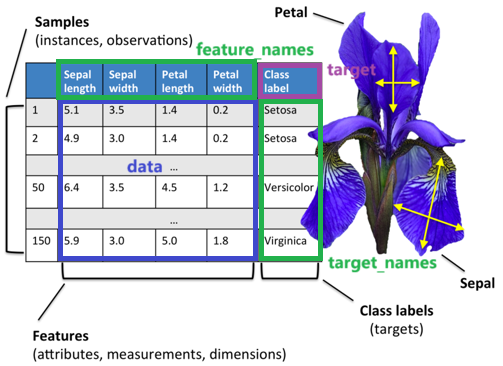
鸢尾花Iris Dataset数据集是机器学习领域经典数据集,鸢尾花数据集包含了150条鸢尾花信息,每50条取自三个鸢尾花中之一:Versicolour、Setosa和Virginica
import seaborn as sns


import pandas as pd


import matplotlib.pyplot as plt


from sklearn.model_selection import train_test_split    # 分割训练集和测试集的


from sklearn.preprocessing import StandardScaler        # 数据标准化的


from sklearn.neighbors import KNeighborsClassifier      # KNN算法 分类对象


from sklearn.metrics import accuracy_score              # 模型评估的, 计算模型预测的准确率
加载数据
pythonfrom sklearn.datasets import load_iris # 加载鸢尾花测试集 iris_data = load_iris() iris_datapythonprint('数据集的类型:', type(iris_data)) print('数据集所有的键:\n', iris_data.keys()) print('数据集data键对应的值:\n', iris_data.data[:5]) print('数据集target键对应的值:\n', iris_data.target[:5]) print('标签对应的名称:', iris_data.target_names) print('特征对应的名称:', iris_data.feature_names) # print('数据集的描述:\n', iris_data.DESCR) print('数据集的框架:', iris_data.frame) print('数据集的文件名:', iris_data.filename) print('数据集的模型:', iris_data.data_module)数据可视化
python# 把 鸢尾花数据集封装成 DataFrame对象. iris_df = pd.DataFrame(iris_data.data, columns=iris_data.feature_names) # 给df对象新增1列 -> 标签列. iris_df['class label'] = iris_data.target iris_dfpython# 通过 Seaborn绘制散点图 sns.lmplot(data=iris_df, x='sepal length (cm)', y='sepal width (cm)', hue='class label', fit_reg=True) # - data 数据集 # - x 轴 # - y 轴 # - hue 分类字段 # - fit_reg 是否显示拟合线 plt.title('iris data') # 设置标题 plt.show()切分训练集和测试集
pythonx_train, x_text, y_train, y_text = train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=22) # - 特征数据 # - 标签数据 # - 测试集的比例 # - 随机种子(种子一致, 每次生成的随机数据集都是固定的) # 返回值: 训练集的特征数据, 测试集的特征数据, 训练集的标签数据, 测试集的标签数据 x_train, x_text, y_train, y_text模型训练
pythontransfer = StandardScaler() # 创建标准化对象 # fit_transform: 兼具fit和transform的功能, 即: 训练, 转换. 该函数适用于: 第1次进行标准化的时候使用. 一般用于处理: 训练集. x_train = transfer.fit_transform(x_train) # 对特征列进行标准化 # transform: 只有转换. 该函数适用于: 重复进行标准化动作时使用, 一般用于对测试集进行标准化. x_text = transfer.transform(x_text) # 对测试集进行标准化pythonestimator = KNeighborsClassifier(n_neighbors=3) # 创建模型对象 estimator.fit(x_train, y_train) # 训练模型模型预测
pythony_pre = estimator.predict(x_text) # 模型预测 print('预测值为:', y_pre)python# 自定义测试数据集 my_data = [[7.8, 2.1, 3.9, 1.6]] my_data = transfer.transform(my_data) # 对自定义数据进行标准化 y_pre_new = estimator.predict(my_data) print('预测值为:', y_pre_new) print('(各分类)预测概率为:', estimator.predict_proba(my_data))模型评估
python# 方式1: 直接评分, 基于: 测试集的特征 和 测试集的标签. print('正确率(准确率):', estimator.score(x_text, y_text)) # 方式2: 基于 测试集的标签 和 预测结果 进行评分. print('正确率(准确率):', accuracy_score(y_text, y_pre))
【案例】基于KNN+交叉验证+网络搜索对鸢尾花分类
from sklearn.datasets import load_iris


from sklearn.model_selection import train_test_split    # 分割训练集和测试集的


from sklearn.model_selection import GridSearchCV        # 交叉验证 + 网格搜索


from sklearn.preprocessing import StandardScaler        # 数据标准化的


from sklearn.neighbors import KNeighborsClassifier      # KNN算法 分类对象


from sklearn.metrics import accuracy_score              # 模型评估的, 计算模型预测的准确率
'''加载数据'''


iris_data = load_iris()
'''数据预处理'''


# 切分训练集和测试集


x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=22)


# 数据标准化


scaler = StandardScaler()


x_train = scaler.fit_transform(x_train)


x_test = scaler.transform(x_test)
'''模型训练'''


# 创建KNN分类对象


estimator = KNeighborsClassifier()


# 参数准备


param_dict = {'n_neighbors': [i for i in range(1,11)]}


# 交叉验证 + 网格搜索,共计 4*10 = 40 次验证


estimator = GridSearchCV(estimator, param_grid=param_dict, cv=4)


# 模型训练


estimator.fit(x_train, y_train)
# 打印最优超参组合


print(f'最优评分: {estimator.best_score_}')


print(f'最优超参组合: {estimator.best_params_}')


print(f'最优估计器对象: {estimator.best_estimator_}')


print(f'具体的交叉验证结果: {estimator.cv_results_}')
'''模型评估'''


# 获取最优的模型对象


best_estimator = estimator.best_estimator_


y_pre = best_estimator.predict(x_test)


print(f'准确率: {accuracy_score(y_test, y_pre)}')
【案例】利用KNN算法实现手写数字识别
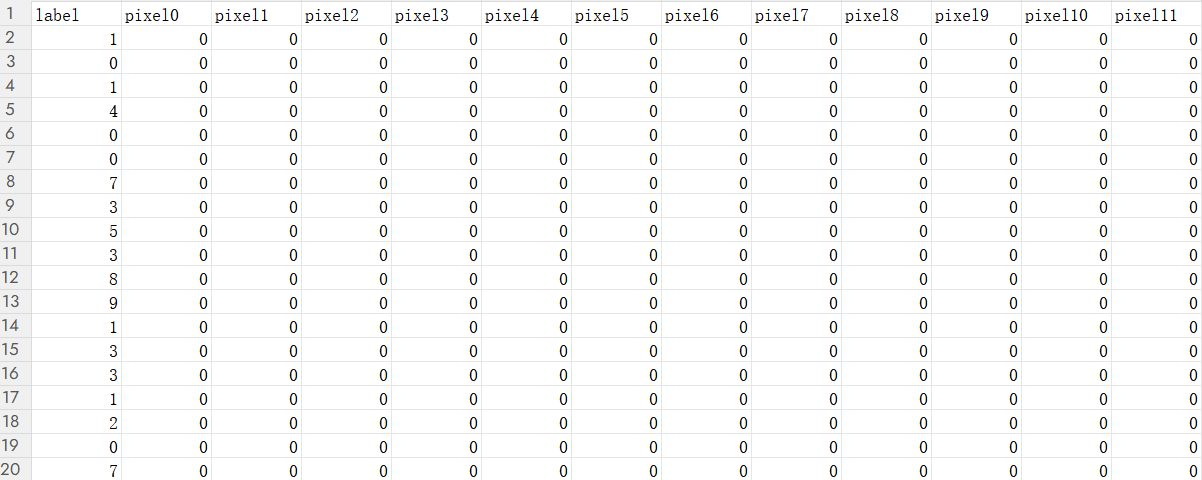
已知数据:
MNIST手写数字识别
1999年发布,成为分类算法基准测试的基础
MNIST仍然是研究人员和学习者的可靠资源
需求:从数万个手写图像的数据集中正确识别数字
数据介绍:
数据文件 包含从0到9的手绘数字的灰度图像。
每个图像高 28 像素,宽28 像素,共784个像素
每个像素取值范围 ,取值越大意味着该像素颜色越深
数据集共785列。
第一列为“索引列”
第二列为“标签”,为该图片对应的手写数字。
其余783列为该图像的像素值
数据集中的特征名称均有
pixel前缀,后面的数字( )代表了像素的序
import matplotlib.pyplot as plt


import pandas as pd


import joblib


from sklearn.model_selection import train_test_split


from sklearn.neighbors import KNeighborsClassifier


from sklearn.metrics import accuracy_score
'''读取数据'''


df = pd.read_csv('./data/手写数字识别.csv')


df
'''生成索引对应的手写数字图片'''


x = df.iloc[:, 1:]


y = df.iloc[:, 0]
# 索引为1的数字


xid = 1


print(f'该图片对应的数字是: {y.iloc[xid]}')


print(x.iloc[xid].shape)  # (784,)


x_1 = x.iloc[xid].values.reshape(28, 28)  # 转换成 28 * 28


x_1
# 绘制对应的灰度图


plt.imshow(x_1, cmap='gray')


plt.axis('off')


plt.show()
'''数据预处理'''


x = df.iloc[:, 1:] / 255  # 归一化


y = df.iloc[:, 0]


print(x.shape, y.shape)  # (42000, 784) (42000,)


# 拆分训练集和测试集


x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=21, stratify=y)
'''模型训练'''


estimator = KNeighborsClassifier(n_neighbors=3)


estimator.fit(x_train, y_train)
'''模型预测'''


y_pre = estimator.predict(x_test)


print(f'准确率: {estimator.score(x_test, y_test)}')


print(f'准确率: {accuracy_score(y_test, y_pre)}')
'''保存模型'''


joblib.dump(estimator, './model/手写数字识别.pkl')


print('模型保存成功!')
'''使用模型'''


# 读取图片数据


img = plt.imread('./data/demo.png')


print(img.shape)  # (28, 28)


plt.imshow(img, cmap='gray')  # 绘制灰度图


plt.axis('off')


plt.show()


# 加载模型


estimator = joblib.load('./model/手写数字识别.pkl')


# 转换数据


# img = img.reshape(1, 784)


# img = img.reshape(1, -1) / 255 # 归一化,可能预测失败,因为读图时,像素值可能不是特别精准


img = img.reshape(1, -1)


# 模型预测


y_pre = estimator.predict(img)


print(f'预测值为: {y_pre}')
线性回归
【案例】通过身高预测体重
'''线性回归-通过身高预测体重'''


from sklearn.linear_model import LinearRegression


x_train = [[160], [166], [172], [178], [180]]


y_train = [64, 68, 72, 77, 80]


x_test = [[160]]


model = LinearRegression()


model.fit(x_train, y_train)


print(f'权重:{model.coef_}, 偏置:{model.intercept_}')


print(f'预测值:{model.predict(x_test)}')
【案例】银行信贷
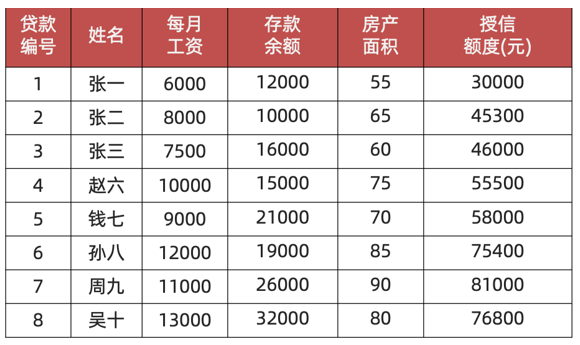
银行信贷只考虑每月薪资(元)、存款余额(元)、房产面积(平方米)。
已知:8位贷款人的数据。
目标:计算数据样本产生的梯度,求解线性回归模型。
假设
假设函数(预测函数)
,其中
置换成 ,模型为:
故模型为:
损失函数:均方误差
【注】引入 是为了求导后消去平方项的系数 2
损失函数求导,对任意
因为 ,所以顺势函数求导为:
梯度下降公式
带入标量,计算平均梯度
张一:在偏置分量上产生的梯度
张二:在偏置分量上产生的梯度
张三:在偏置分量上产生的梯度
……
吴十:在偏置分量上产生的梯度
由8个样本计算平均梯度得到: 梯度为
更新 的梯度,
分别计算:工资、存款余额、房产面积 这三个特征列的偏导,并更新对应的梯度
计算在每月工资上产生的梯度, 梯度为
计算在存款余额上产生的梯度, 梯度为
计算在房产面积上产生的梯度, 梯度为
利用梯度下降公式更新
经过第一轮迭代:初始化值 迭代成:
后续多次迭代,可计算出最终的向量
【案例】波士顿房价预测
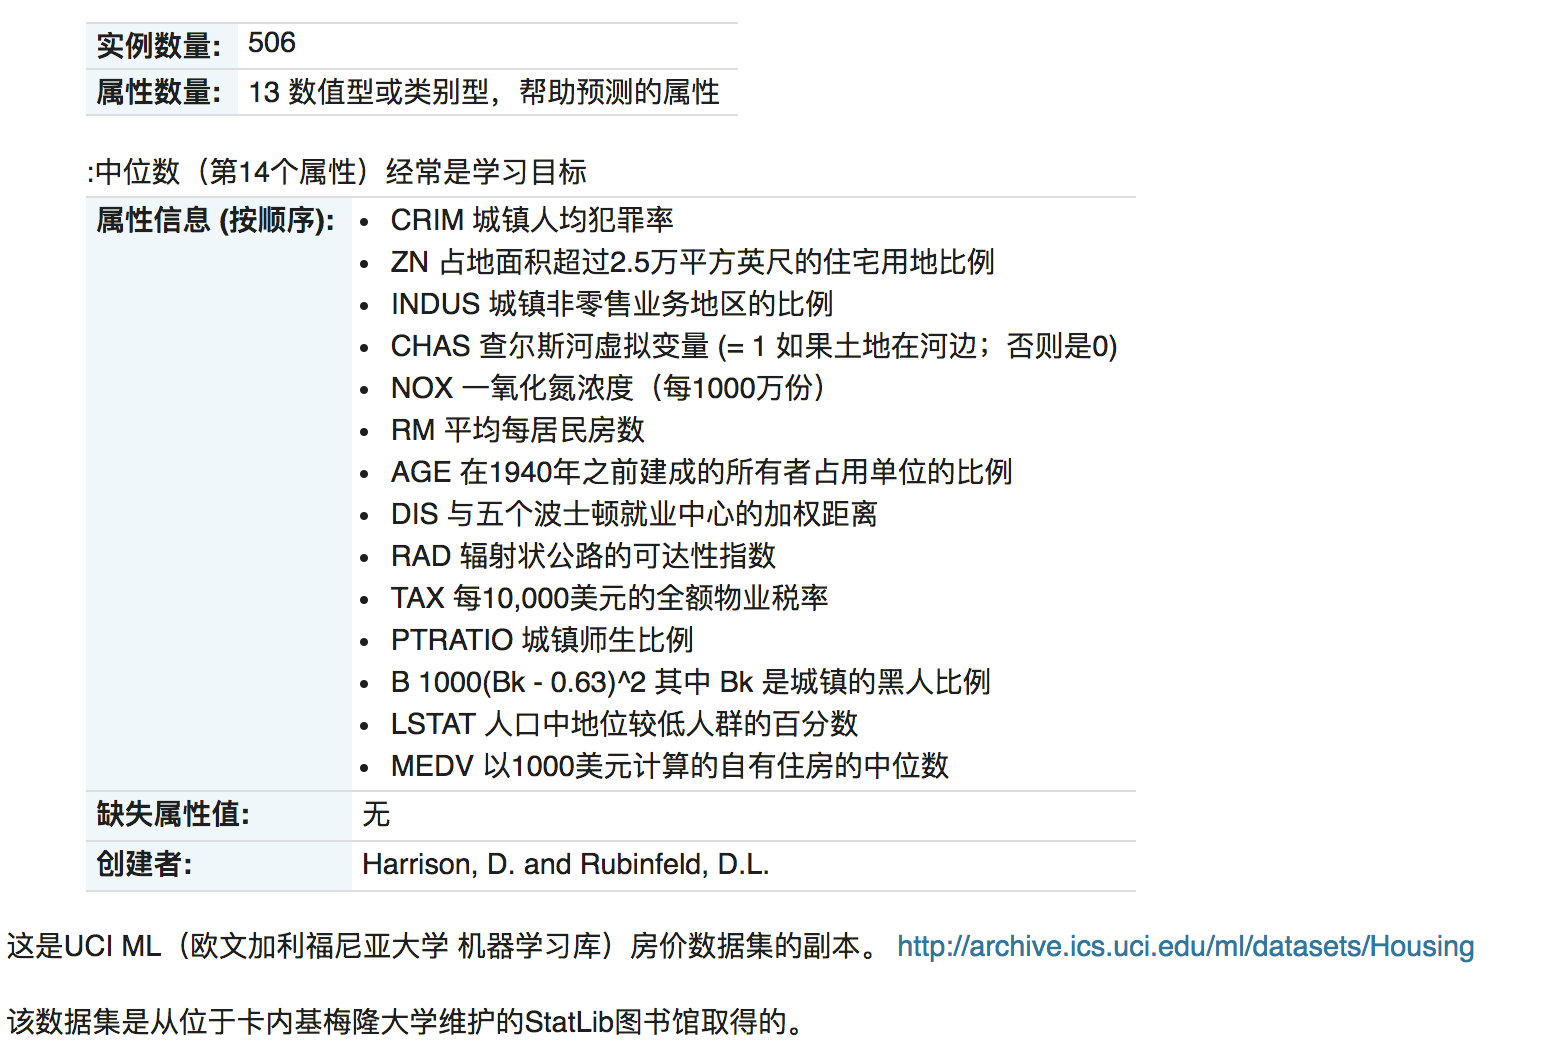
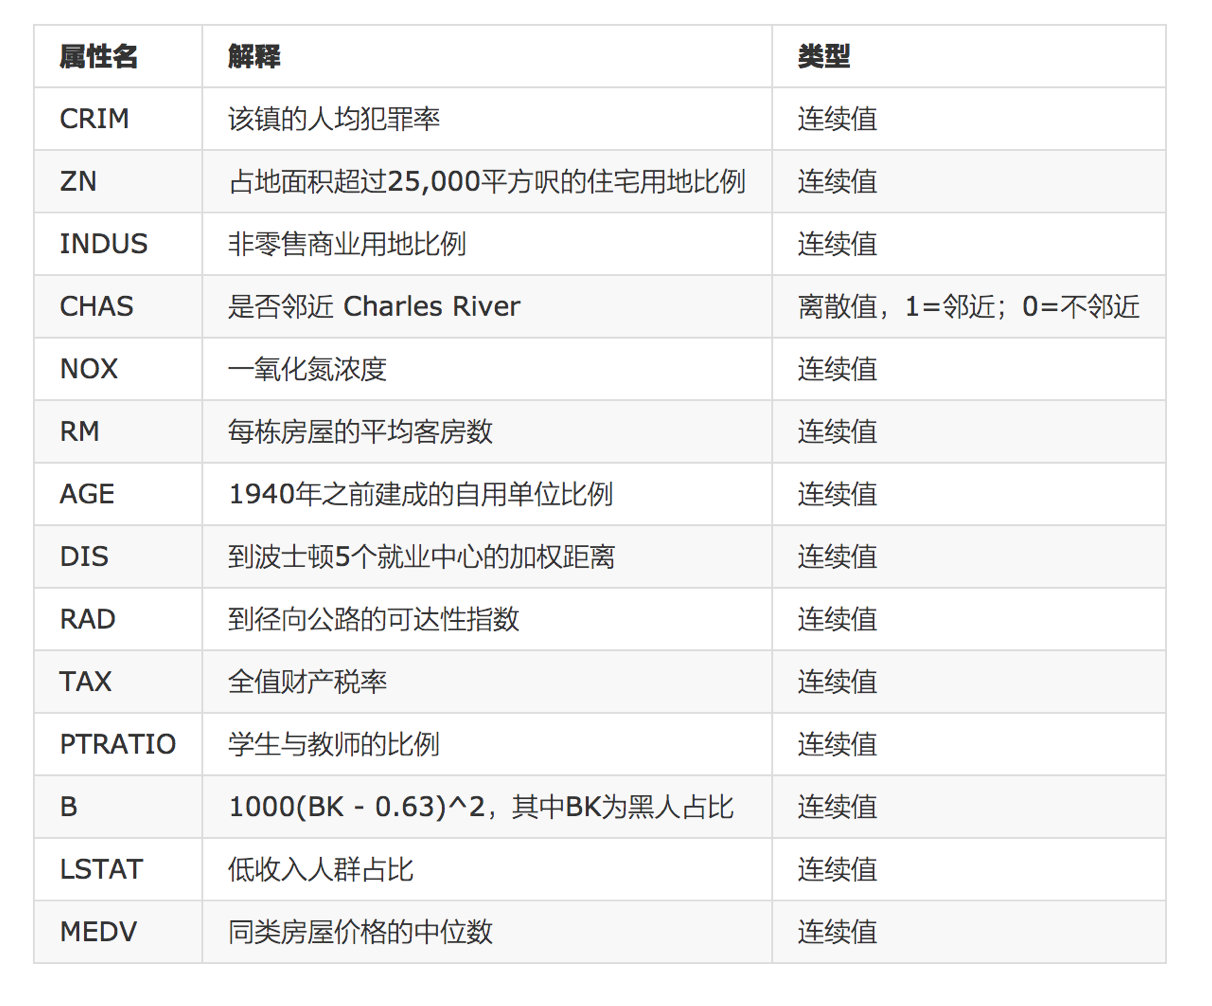
给定的这些特征,是专家们得出的影响房价的结果属性。我们此阶段不需要自己去探究特征是否有用,只需要使用这些特征。到后面量化很多特征需要我们自己去寻找
案例分析
回归当中的数据大小不一致,是否会导致结果影响较大。所以需要做标准化处理。
数据分割与标准化处理
回归预测
线性回归的算法效果评估
回归性能评估
“均方误差”回归损失
y_true:真实值
y_pred:预测值
return:浮点数结果
from sklearn.model_selection import train_test_split    # 数据集划分


from sklearn.preprocessing import StandardScaler        # 特征处理


from sklearn.linear_model import LinearRegression,SGDRegressor  # 回归模型(正规方程、梯度下降)


from sklearn.metrics import mean_squared_error          # 均方误差评估


from sklearn.metrics import root_mean_squared_error     # 均方根误差


from sklearn.metrics import mean_absolute_error         # 平均绝对误差


import pandas as pd


import numpy as np
'''数据获取'''


# from sklearn.datasets import load_boston  # 数据已不可用,改用以下方式


data_url = "http://lib.stat.cmu.edu/datasets/boston"


raw_df = pd.read_csv(data_url, sep="\\s+", skiprows=22, header=None)


data = np.hstack([raw_df.values[::2, :], raw_df.values[1::2, :2]])


target = raw_df.values[1::2, 2]


'''数据预处理'''


x_train, x_test, y_train, y_test = train_test_split(data, target, test_size=0.2, random_state=22)


transfer = StandardScaler()


x_train = transfer.fit_transform(x_train)


x_test = transfer.transform(x_test)


'''模型训练'''


# estimator = LinearRegression()


estimator = SGDRegressor(max_iter=1000)


estimator.fit(x_train, y_train)


print(f"权重:{estimator.coef_}")


print(f"偏置:{estimator.intercept_}")


'''模型预测'''


y_pre = estimator.predict(x_test)


print(f"预测结果为:{y_pre}")


'''模型评估'''


print(f"均方误差为:{mean_squared_error(y_test, y_pre)}")


print(f"均方根误差为:{root_mean_squared_error(y_test, y_pre)}")


print(f"平均绝对误差为:{mean_absolute_error(y_test, y_pre)}")


''' 正规方程


均方误差为:20.770684784270053


均方根误差为:4.557486674063902


平均绝对误差为:3.4251818718533658


'''


''' 梯度下降


均方误差为:21.09041649635677


均方根误差为:4.592430347469276


平均绝对误差为:3.4730243914359162


'''
逻辑回归
【案例】癌症分类预测
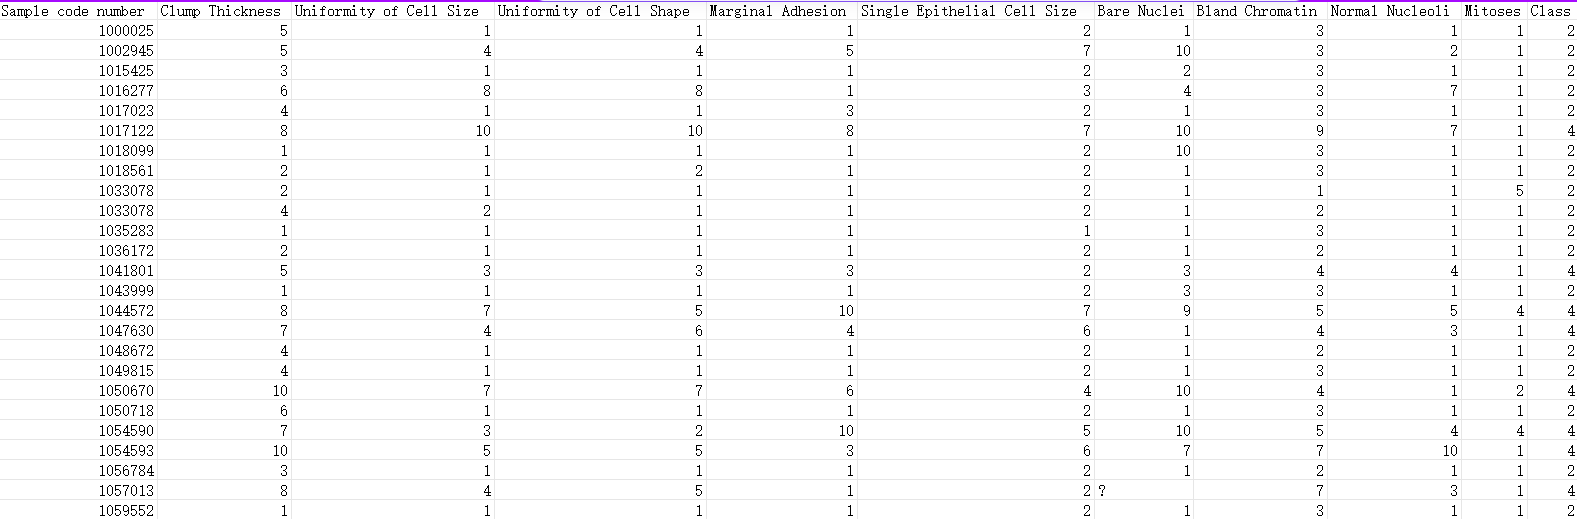
数据描述:
共有699条样本,11列数据。第一列是用于检索的ID,后9列是与肿瘤相关的医学特征,最后一列表示肿瘤类型的数值。
数据包含16个缺失值,用“?”标出。
Class:2表示良性,4表示恶性。
from sklearn.linear_model import LogisticRegression


from sklearn.model_selection import train_test_split


from sklearn.preprocessing import StandardScaler


from sklearn.metrics import accuracy_score


import pandas as pd


import numpy as np
# 读取数据


data= pd.read_csv('./data/breast-cancer-wisconsin.csv')


data.info()
# 数据预处理


# 缺失值处理


data = data.replace('?', np.nan)


data = data.dropna()


# 获取特征列和标签列


x = data.iloc[:, 1:-1]


y = data.iloc[:, -1]


# 训练集和测试集


x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=22)


# 标准化


transfer = StandardScaler()


x_train = transfer.fit_transform(x_train)


x_test = transfer.transform(x_test)
# 模型训练


model = LogisticRegression()


model.fit(x_train, y_train)


# 模型预测和评估


y_pre = model.predict(x_test)


print(f'预测结果: {y_pre}')


print(f'准确率: {accuracy_score(y_test, y_pre)}')


# 逻辑回归能用准确率进行评测,但不精确:逻辑回归主要进行二分类
【案例】电信用户流失预测
流失用户指的使用过产品因为某些原因不再使用该产品。随着产品的更新迭代,都会存在一定的流失情况,这时正常现象。流失用户的比例和变化趋势能够反映该产品当前是否存在问题以及未来的发展趋势。
当用户群体庞大时,有限的人力和精力不能为每个用户都投入大量的时间。如果公司可以预测哪些用户可能提前流失,这样就能将主要精力聚焦于这些用户,实施有效的用户挽留策略,提高用户粘性。
本项目旨在通过分析特征属性确定用户流失的原因,以及哪些因素可能导致用户流失。建立预测模型来判断用户是否流失,并提出用户流失预警策略。
具体数据说明如下:数据集中总计7043条数据,21个特征字段,最终分类特征为Churn:用户是否流失,具体内容如下所示:
textcustomerID: 用户ID gender: 性别 SeniorCitizen: 是否是老人 Partner: 是否有伴侣 Dependents: 是否有需要抚养的孩子 tenure: 任职 PhoneService: 是否办理电话服务 MultipleLines: 是否开通了多条线路 InternetService:是否开通网络服务和开通的服务类型(光纤、电话拨号) TechSupport: 是否办理技术支持服务 OnlineBackup: 是否办理在线备份服务 OnlineSecurity:是否办理在线安全服务 DeviceProtection:是否办理设备保护服务 StreamingTV: 是否办理电视服务 StreamingMovies:是否办理电影服务 Contract: 签订合约的时长 PaperlessBilling:是否申请了无纸化账单 PaymentMethod: 付款方式(电子支票、邮寄支票、银行自动转账、信用卡自动转账) MonthlyCharges:月消费 TotalCharges: 总消费 Churn: 用户是否流失
import numpy as np


import pandas as pd


import seaborn as sns


import matplotlib.pyplot as plt


from sklearn.model_selection import train_test_split


from sklearn.linear_model import LogisticRegression


from sklearn.metrics import accuracy_score


from sklearn.metrics import precision_score, recall_score, f1_score


from sklearn.metrics import classification_report  # 分类评估报告
# 读取数据


df = pd.read_csv('./data/churn.csv')


print(df.head())


print(df.info())
# 数据预处理


# one-hot 对字符列进行热编码处理


df = pd.get_dummies(df, columns=['Churn', 'gender'])


# 删除冗余列


df = df.drop(columns=['Churn_No', 'gender_Male'])


# 修改列名


df = df.rename(columns={'Churn_Yes': 'flag'})


# 提取特征列 和 标签列


# 月度会员、是否有互联网服务、是否是电子支付


X = df[['Contract_Month', 'internet_att', 'PaymentElectronic']]


y = df['flag']  # False -> 流失;True -> 不流失


# 划分训练集和测试集


X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# 数据可视化


# 根据月份进行分类, 流失用户和非流失用户的数量对比


sns.countplot(data=df, x='Contract_Month', hue='flag')


plt.show()
# 模型训练


model = LogisticRegression()


model.fit(X_train, y_train)


# 模型预测


y_pred = model.predict(X_test)


print(f'模型预测结果: {y_pred}')


# 模型评估


print(f'准确率: {model.score(X_test, y_test)}')     # 预测前


print(f'准确率: {accuracy_score(y_test, y_pred)}')  # 预测后


print(f'精确率: {precision_score(y_test, y_pred)}')


print(f'召回率: {recall_score(y_test, y_pred)}')


print(f'F1值: {f1_score(y_test, y_pred)}')


print(f'分类评估报告:\n{classification_report(y_test, y_pred)}')
决策树
【案例】泰坦尼克号乘客生存预测
案例背景
泰坦尼克号沉没是历史上最著名的沉船事件。1912年4月15日,在她的处女航中,泰坦尼克号在与冰山相撞后沉没,在2224名乘客和船员中造成1502人死亡。这场耸人听闻的悲剧震惊了国际社会,并为船舶制定了更好的安全规定。 造成海难失事的原因之一是乘客和船员没有足够的救生艇。尽管幸存下来有一些运气因素,但有些人比其他人更容易生存,例如妇女,儿童和社会地位较高的人群。
在这个案例中,我们要求您完成对哪些人可能存活的分析。
数据情况:
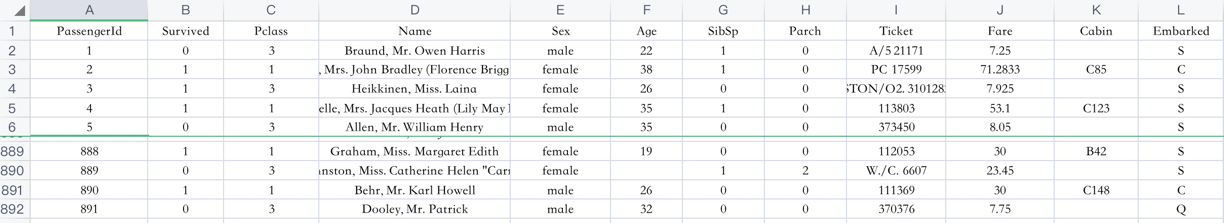
数据集中的特征包括票的类别,是否存活,舱位等级,姓名,年龄,上船港口,房间,性别等。
Survived:生存状态(0-为存活,1-存活)
Pclass(1,2,3),舱位等级,是社会经济阶层的代表
Sex:性别
Age:年龄,存在缺失
import pandas as pd


import matplotlib.pyplot as plt


from sklearn.model_selection import train_test_split


from sklearn.tree import DecisionTreeClassifier


from sklearn.tree import plot_tree


from sklearn.metrics import classification_report
'''加载数据'''


data = pd.read_csv('./data/titanic.csv')


print(data.head())


print(data.info())
'''数据预处理'''


# 选择特征和标签


x = data[['Pclass', 'Sex', 'Age']]


y = data['Survived']


# print(x.head(), y.head())


# 处理缺失值


# x['Age'].fillna(x['Age'].mean(), inplace=True)  # 出现警告,建议使用下面的写法


# x['Age'] = x['Age'].fillna(x['Age'].mean())     # 出现警告,因为直接修改原数据


x = x.copy()  # 先创建副本,再修改


x['Age'] = x['Age'].fillna(x['Age'].mean())


# print(x.info())


# 处理类别特征,Sex使用独热编码


x = pd.get_dummies(x, columns=['Sex'])


print(x.info())


# 数据集划分


x_train, x_test, y_train, y_test = train_test_split(


    x, y, test_size=0.2, random_state=22)
'''模型训练'''


estimator = DecisionTreeClassifier(max_depth=10)  # 最大深度为10


estimator.fit(x_train, y_train)
'''模型预测'''


y_pred = estimator.predict(x_test)


print(f'预测值为:\n{y_pred}')
'''模型评估'''


print(f'分类评估报告:\n{classification_report(y_test, y_pred)}')
'''绘制决策树'''


plt.figure(figsize=(60,40))


plot_tree(estimator,filled=True,max_depth=10)


plt.savefig('./output/titanic_decision_tree.png')


plt.show()
【案例】线性回归与回归决策树对比
已知数据:

需求:分别训练线性回归、回归决策树模型,并预测对比
分析:训练模型,并使用1000个[0.0, 10]之间的数据,让模型预测,画出预测值图线
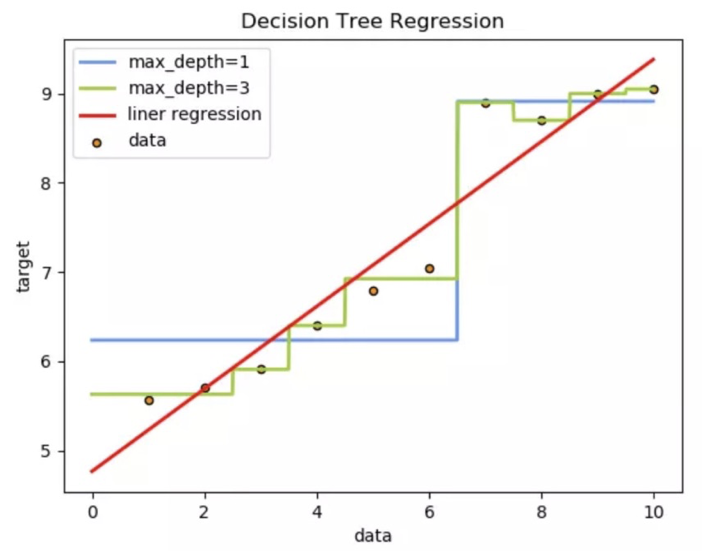
从预测效果来看:
1、线性回归是一条直线
2、决策树是曲线
3、树的拟合能力是很强的,易过拟合
import numpy as np


import pandas as pd


import matplotlib.pyplot as plt


from sklearn.tree import DecisionTreeRegressor     # 回归决策树


from sklearn.linear_model import LinearRegression  # 线性回归
'''数据准备'''


x_train = np.array(list(range(1, 11))).reshape(-1, 1)


y_train = np.array([5.56, 5.7, 5.91, 6.4, 6.8, 7.05, 8.9, 8.7, 9, 9.05])


x_test = np.arange(0, 10, 0.1).reshape(-1, 1)
'''模型训练'''


dtc1 = DecisionTreeRegressor(max_depth=1)


dtc3 = DecisionTreeRegressor(max_depth=3)


lr = LinearRegression()


dtc1.fit(x_train,y_train)


dtc3.fit(x_train,y_train)


lr.fit(x_train,y_train)
'''模型预测'''


y_pred1 = dtc1.predict(x_test)


y_pred3 = dtc3.predict(x_test)


y_pred_lr = lr.predict(x_test)


print(f'回归决策树(深度为1)预测值为:\n{y_pred1}')


print(f'回归决策树(深度为3)预测值为:\n{y_pred3}')


print(f'线性回归预测值为:\n{y_pred_lr}')
'''绘制结果对比图'''


plt.figure(figsize=(10,6))


plt.scatter(x_train, y_train, color='gray', label='data')


plt.plot(x_test, y_pred1, color='blue', label='max_depth=1')


plt.plot(x_test, y_pred3, color='green', label='max_depth=3')


plt.plot(x_test, y_pred_lr, color='red', label='liner regression')


plt.xlabel('data')


plt.ylabel('target')


plt.title('Decision Tree Regression')


plt.legend() # 显示图例


plt.show()
【例子】预剪枝和后剪枝
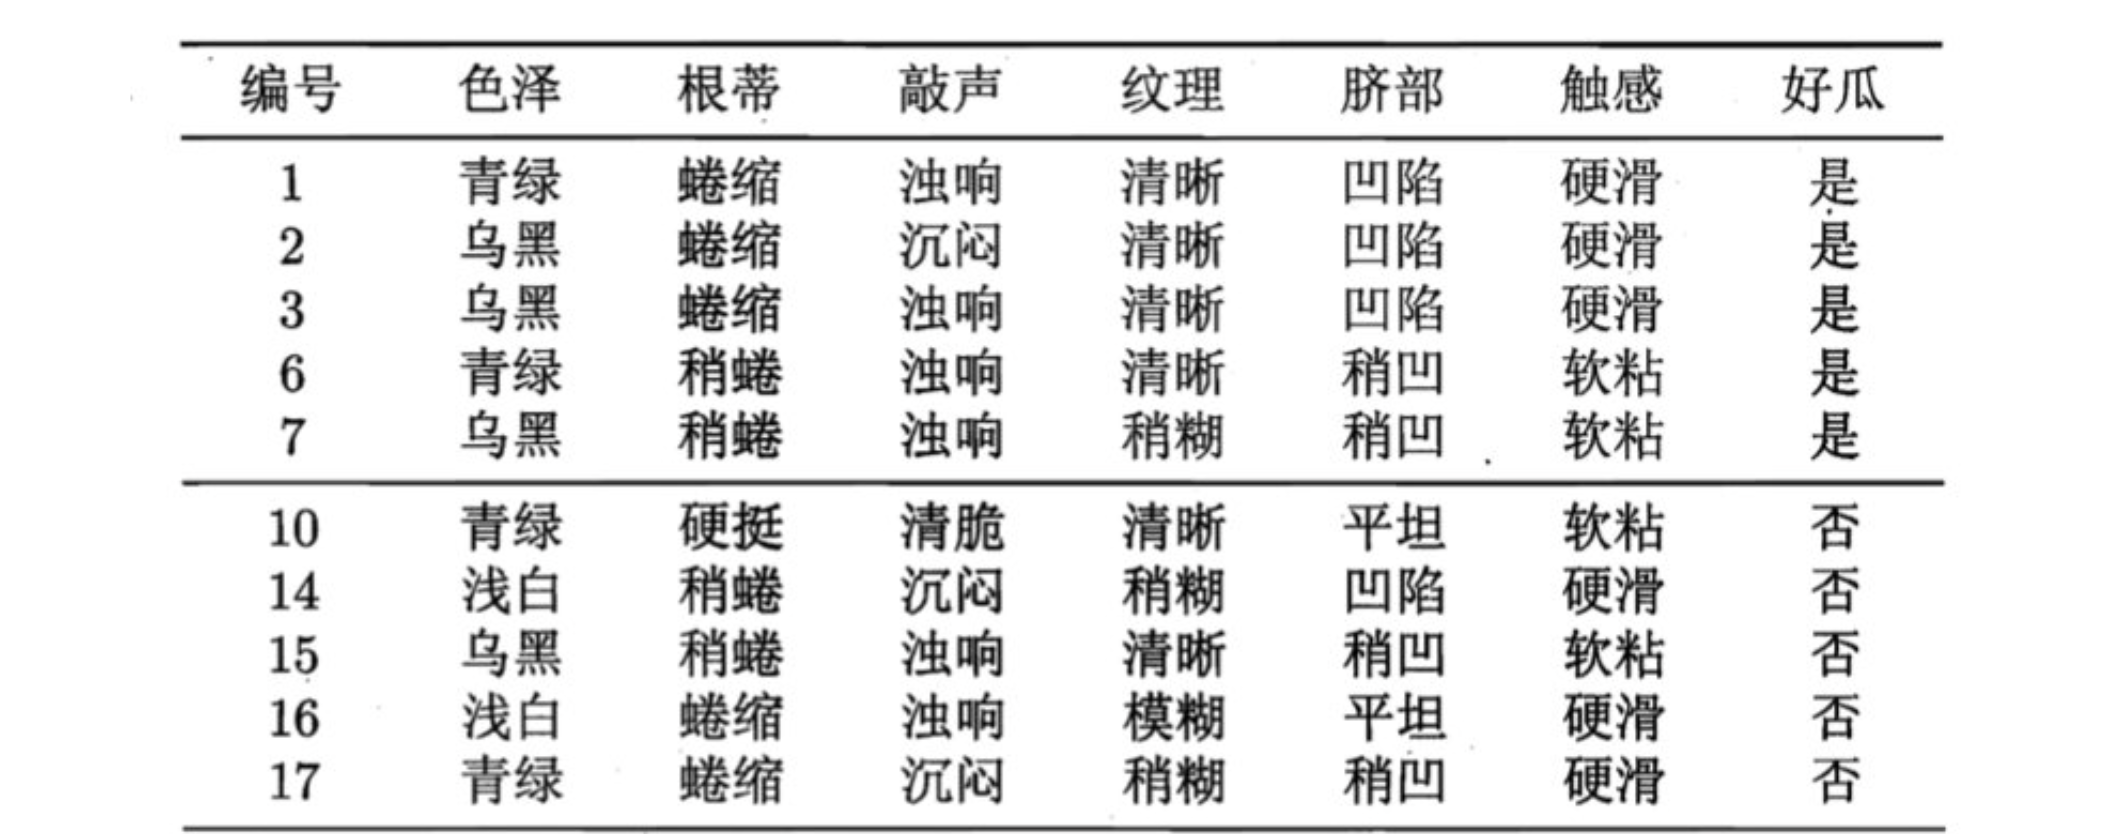
在构建树时, 为了能够实现剪枝, 可预留一部分数据用作 "验证集" 以进行性能评估。我们的训练集如下:
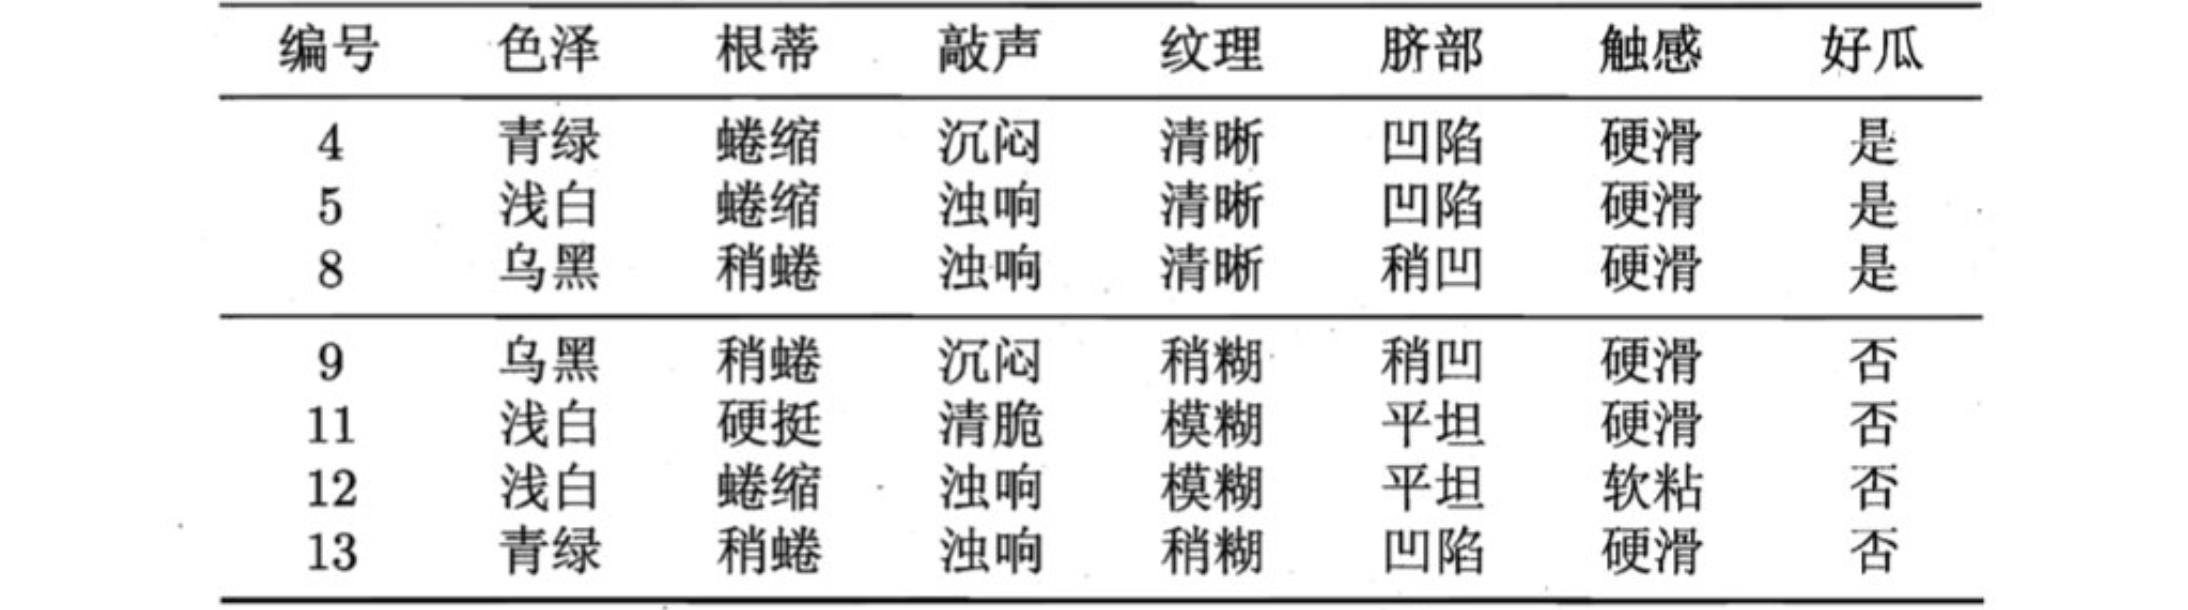
验证集如下:
后剪枝
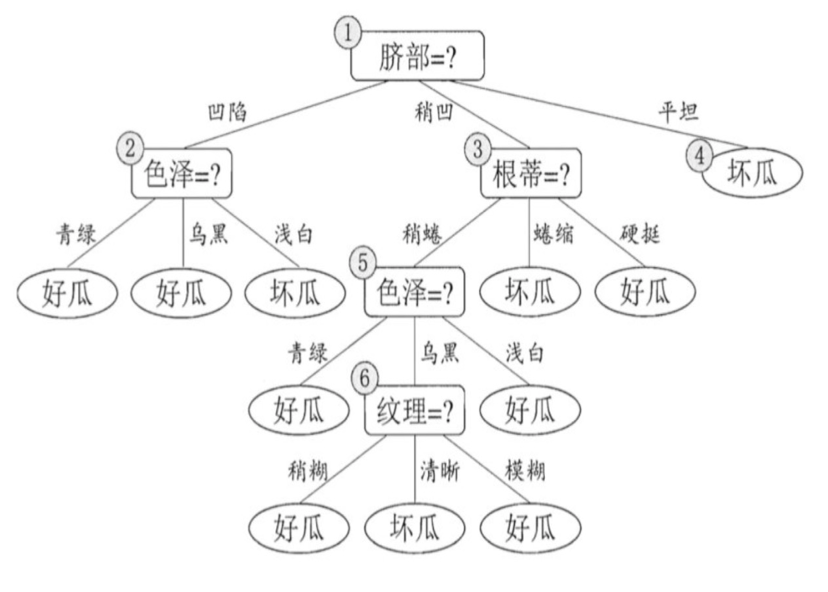
后剪枝先从训练集生成一棵完整的树,分别考察内部6个节点作为叶子节点的准确率,若为叶子节点的准确率上升,则进行剪枝。最终得到以下决策树
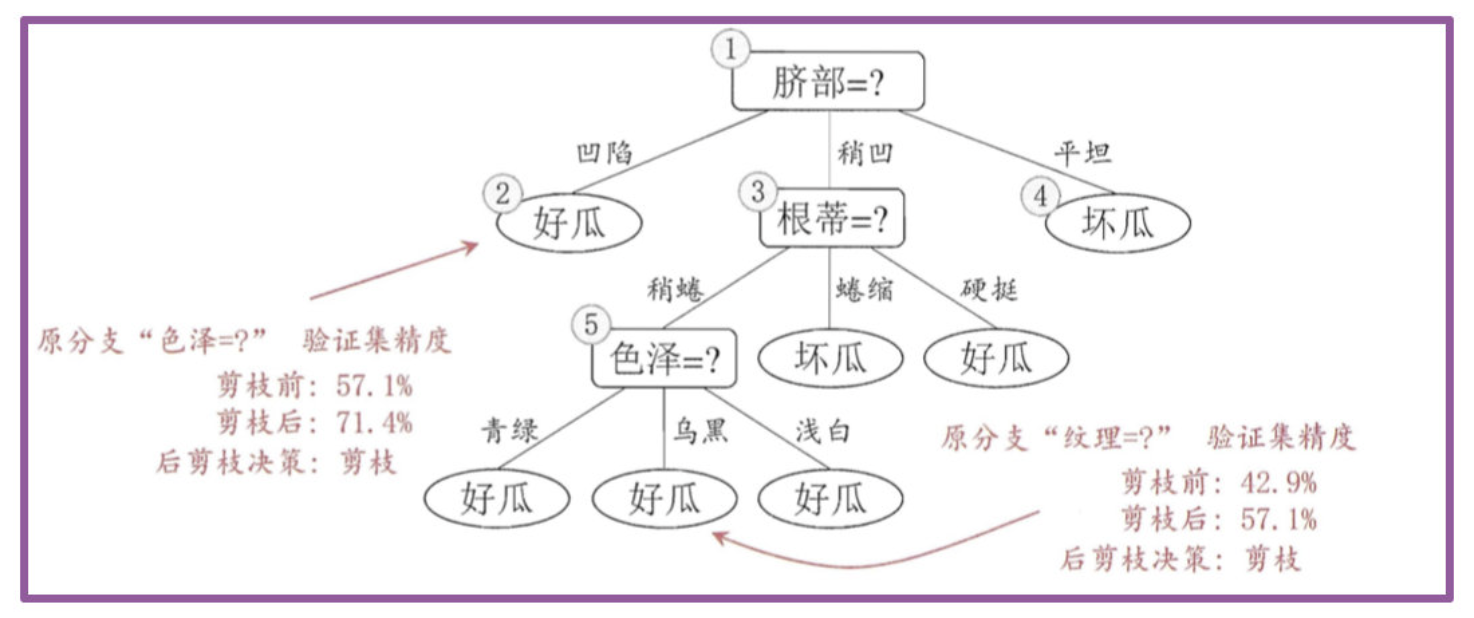
预剪枝
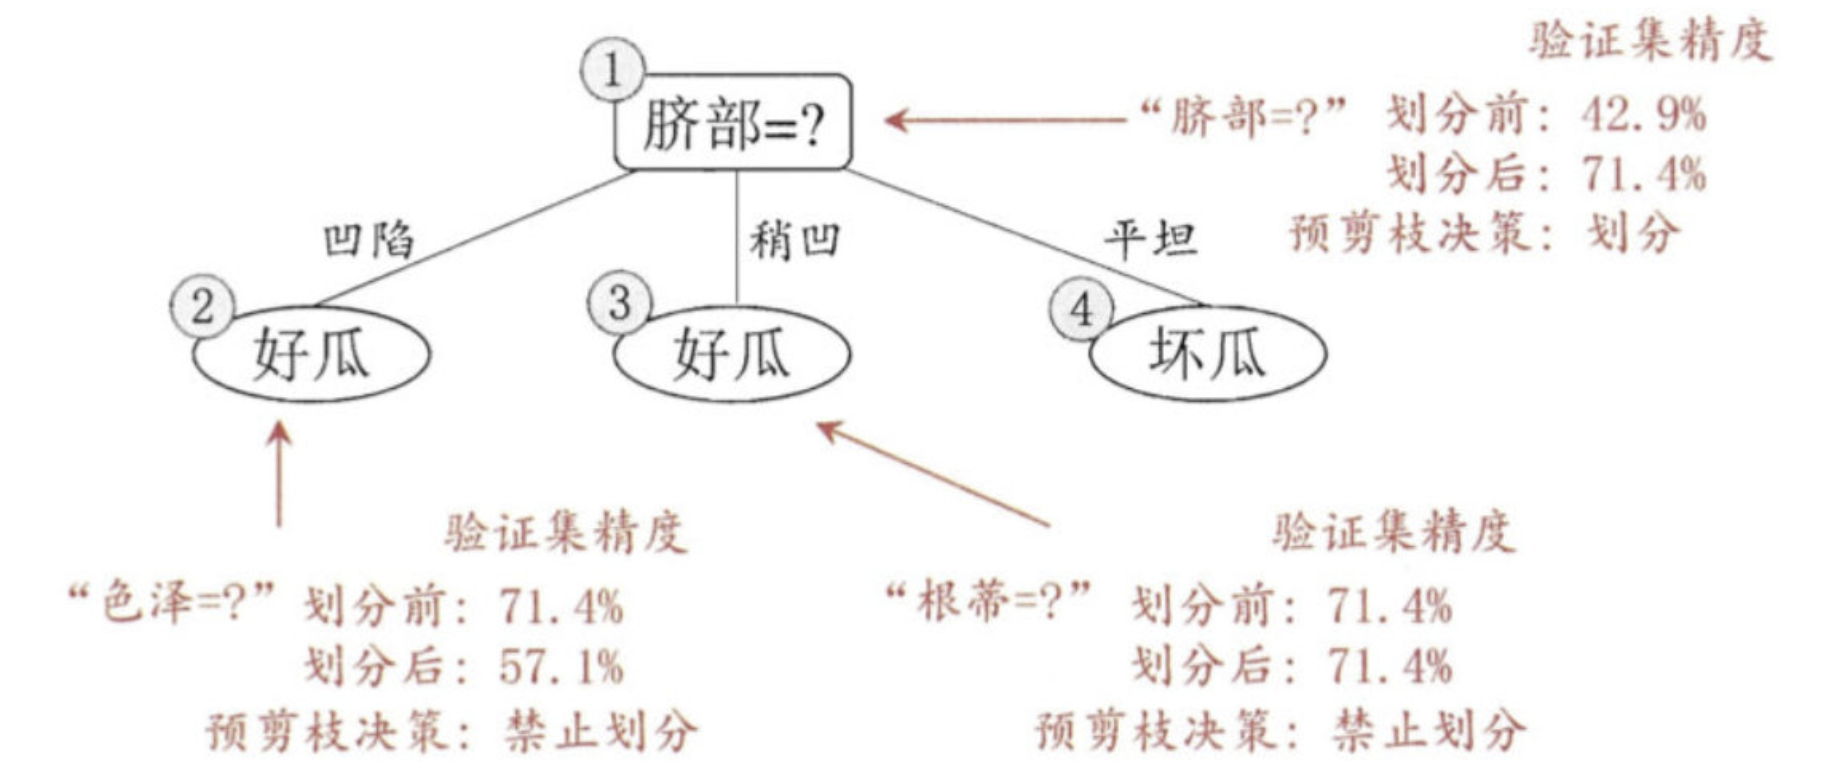
最终得到以上决策树,其最终验证集的精度为 71.4%
集成学习
【案例】随机森林-泰坦尼克号乘客生存预测
案例背景
泰坦尼克号沉没是历史上最著名的沉船事件。1912年4月15日,在她的处女航中,泰坦尼克号在与冰山相撞后沉没,在2224名乘客和船员中造成1502人死亡。这场耸人听闻的悲剧震惊了国际社会,并为船舶制定了更好的安全规定。 造成海难失事的原因之一是乘客和船员没有足够的救生艇。尽管幸存下来有一些运气因素,但有些人比其他人更容易生存,例如妇女,儿童和社会地位较高的人群。
在这个案例中,我们要求您完成对哪些人可能存活的分析。
数据情况:
数据集中的特征包括票的类别,是否存活,舱位等级,姓名,年龄,上船港口,房间,性别等。
Survived:生存状态(0-为存活,1-存活)
Pclass(1,2,3),舱位等级,是社会经济阶层的代表
Sex:性别
Age:年龄,存在缺失
import pandas as pd


from sklearn.model_selection import train_test_split


from sklearn.tree import DecisionTreeClassifier


from sklearn.ensemble import RandomForestClassifier


from sklearn.model_selection import GridSearchCV
# 加载数据


df = pd.read_csv('./data/titanic.csv')


df.info()


# 数据预处理


# 特征和标签选择


x = df[['Pclass', 'Age', 'Sex']].copy()


y = df['Survived']


# 处理缺失值


x['Age']= x['Age'].fillna(x['Age'].mean())


# 热编码处理


x = pd.get_dummies(x)


# 划分训练集和测试集


x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=42)


# 模型训练


estimator1 = DecisionTreeClassifier()  # CART 分类器


estimator1.fit(x_train, y_train)


estimator2 = RandomForestClassifier()  # 随机森林 分类器


estimator2.fit(x_train, y_train)


estimator3 = RandomForestClassifier()


# 网格搜索交叉验证


param_grid = {


    'n_estimators': [50, 100, 200],


    'max_depth': [None, 5, 10],


    'min_samples_split': [2, 5, 10]


}


grid_search = GridSearchCV(estimator3, param_grid, cv=5, n_jobs=-1)


grid_search.fit(x_train, y_train)


# 模型预测


y_pred1 = estimator1.predict(x_test)


print("决策树模型预测结果:", y_pred1)


y_pred2 = estimator2.predict(x_test)


print("随机森林模型预测结果:", y_pred2)


y_pred3 = grid_search.predict(x_test)


print("网格搜索随机森林模型预测结果:", y_pred3)


# 模型评估


accuracy1 = estimator1.score(x_test, y_test)


print("决策树模型准确率:", accuracy1)  # 0.776536312849162


accuracy2 = estimator2.score(x_test, y_test)


print("随机森林模型准确率:", accuracy2)  # 0.7877094972067039


accuracy3 = grid_search.score(x_test, y_test)


print("调参后的随机森林模型准确率:", accuracy3)  # 0.7988826815642458
【案例】AdaBoost-葡萄酒的分类
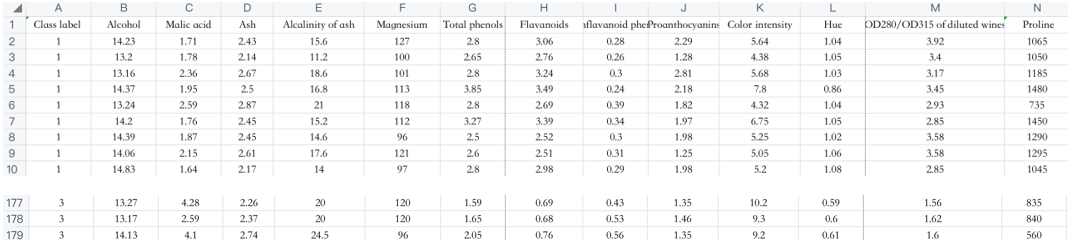
葡萄酒分为白葡萄酒和红葡萄酒两类。
该分析涉及白葡萄酒,并基于数据集中显示的13个变量/特征:
固定酸度,挥发性酸度,柠檬酸,残留糖,氯化物,游离二氧化硫,总二氧化硫,密度,pH值,硫酸盐,酒精,质量等。为了评估葡萄酒的质量,我们提出的方法就是根据酒的物理化学性质与质量的关系,找出高品质的葡萄酒具体与什么性质密切相关,这些性质又是如何影响葡萄酒的质量。
import pandas as pd


from sklearn.preprocessing import LabelEncoder


from sklearn.model_selection import train_test_split


from sklearn.tree import DecisionTreeClassifier


from sklearn.ensemble import AdaBoostClassifier   # AdaBoost 分类器
# 加载数据


wine = pd.read_csv('./data/wine.csv')


wine.info()
# 数据预处理


# 过滤数据,葡萄酒有3种,但是决策树只能处理二分类问题,因此过滤掉类别1的数据


wine = wine[wine['Class label'] != 1]


print(wine['Class label'].value_counts())


# 特征和标签划分


x = wine[['Alcohol', 'Hue']]


y = wine['Class label']


# 将标签列 转换为 数值列


le = LabelEncoder()


y = le.fit_transform(y)


# 划分训练集和测试集


x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.3, random_state=1, stratify=y)
# 模型训练


estimator1 = DecisionTreeClassifier(max_depth=3)  # 基学习器(CART 决策树)


estimator2 = AdaBoostClassifier(estimator=estimator1, n_estimators=200, learning_rate=0.1)


estimator1.fit(x_train, y_train)


estimator2.fit(x_train, y_train)
# 模型预测和评估


y_pred1 = estimator1.predict(x_test)


print(f'决策树模型预测结果:{y_pred1}')


print(f'决策树模型准确率:{estimator1.score(x_test, y_test)}')


y_pred2 = estimator2.predict(x_test)


print(f'AdaBoost模型预测结果:{y_pred2}')


print(f'AdaBoost模型准确率:{estimator2.score(x_test, y_test)}')
【案例】GBDT-泰坦尼克号乘客生存预测
案例背景
泰坦尼克号沉没是历史上最著名的沉船事件。1912年4月15日,在她的处女航中,泰坦尼克号在与冰山相撞后沉没,在2224名乘客和船员中造成1502人死亡。这场耸人听闻的悲剧震惊了国际社会,并为船舶制定了更好的安全规定。 造成海难失事的原因之一是乘客和船员没有足够的救生艇。尽管幸存下来有一些运气因素,但有些人比其他人更容易生存,例如妇女,儿童和社会地位较高的人群。
在这个案例中,我们要求您完成对哪些人可能存活的分析。
数据情况:
数据集中的特征包括票的类别,是否存活,舱位等级,姓名,年龄,上船港口,房间,性别等。
Survived:生存状态(0-为存活,1-存活)
Pclass(1,2,3),舱位等级,是社会经济阶层的代表
Sex:性别
Age:年龄,存在缺失
import pandas as pd


from sklearn.model_selection import train_test_split


from sklearn.tree import DecisionTreeClassifier         # CART 决策树


from sklearn.ensemble import GradientBoostingClassifier # GBDT 树(梯度提升树)


from sklearn.model_selection import GridSearchCV        # 网格搜索交叉验证
# 加载数据


df = pd.read_csv('./data/titanic.csv')


df.info()
# 数据预处理


# 特征和标签选择


x = df[['Pclass', 'Age', 'Sex']].copy()


y = df['Survived']


# 处理缺失值


x['Age']= x['Age'].fillna(x['Age'].mean())


# 热编码处理


x = pd.get_dummies(x)


# 划分训练集和测试集


x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=42)
# 模型训练


estimator1 = DecisionTreeClassifier()  # CART 分类器


estimator1.fit(x_train, y_train)


estimator2 = GradientBoostingClassifier()  # GBDT 分类器


estimator2.fit(x_train, y_train)


estimator3 = GradientBoostingClassifier()


# 网格搜索交叉验证


param_grid = {


    'n_estimators': [50, 100, 200],


    'max_depth': [None, 5, 10],


    'min_samples_split': [2, 5, 10]


}


grid_search = GridSearchCV(estimator3, param_grid, cv=5, n_jobs=-1)


grid_search.fit(x_train, y_train)
# 模型预测


y_pred1 = estimator1.predict(x_test)


print("决策树模型预测结果:", y_pred1)


y_pred2 = estimator2.predict(x_test)


print("随机森林模型预测结果:", y_pred2)


y_pred3 = grid_search.predict(x_test)


print("网格搜索随机森林模型预测结果:", y_pred3)
# 模型评估


accuracy1 = estimator1.score(x_test, y_test)


print("决策树模型准确率:", accuracy1)  # 0.776536312849162


accuracy2 = estimator2.score(x_test, y_test)


print("GBDT模型准确率:", accuracy2)  # 0.7988826815642458


accuracy3 = grid_search.score(x_test, y_test)


print("调参后的GBDT模型准确率:", accuracy3)  # 0.8044692737430168
【案例】XGBoost-红酒品质的分类
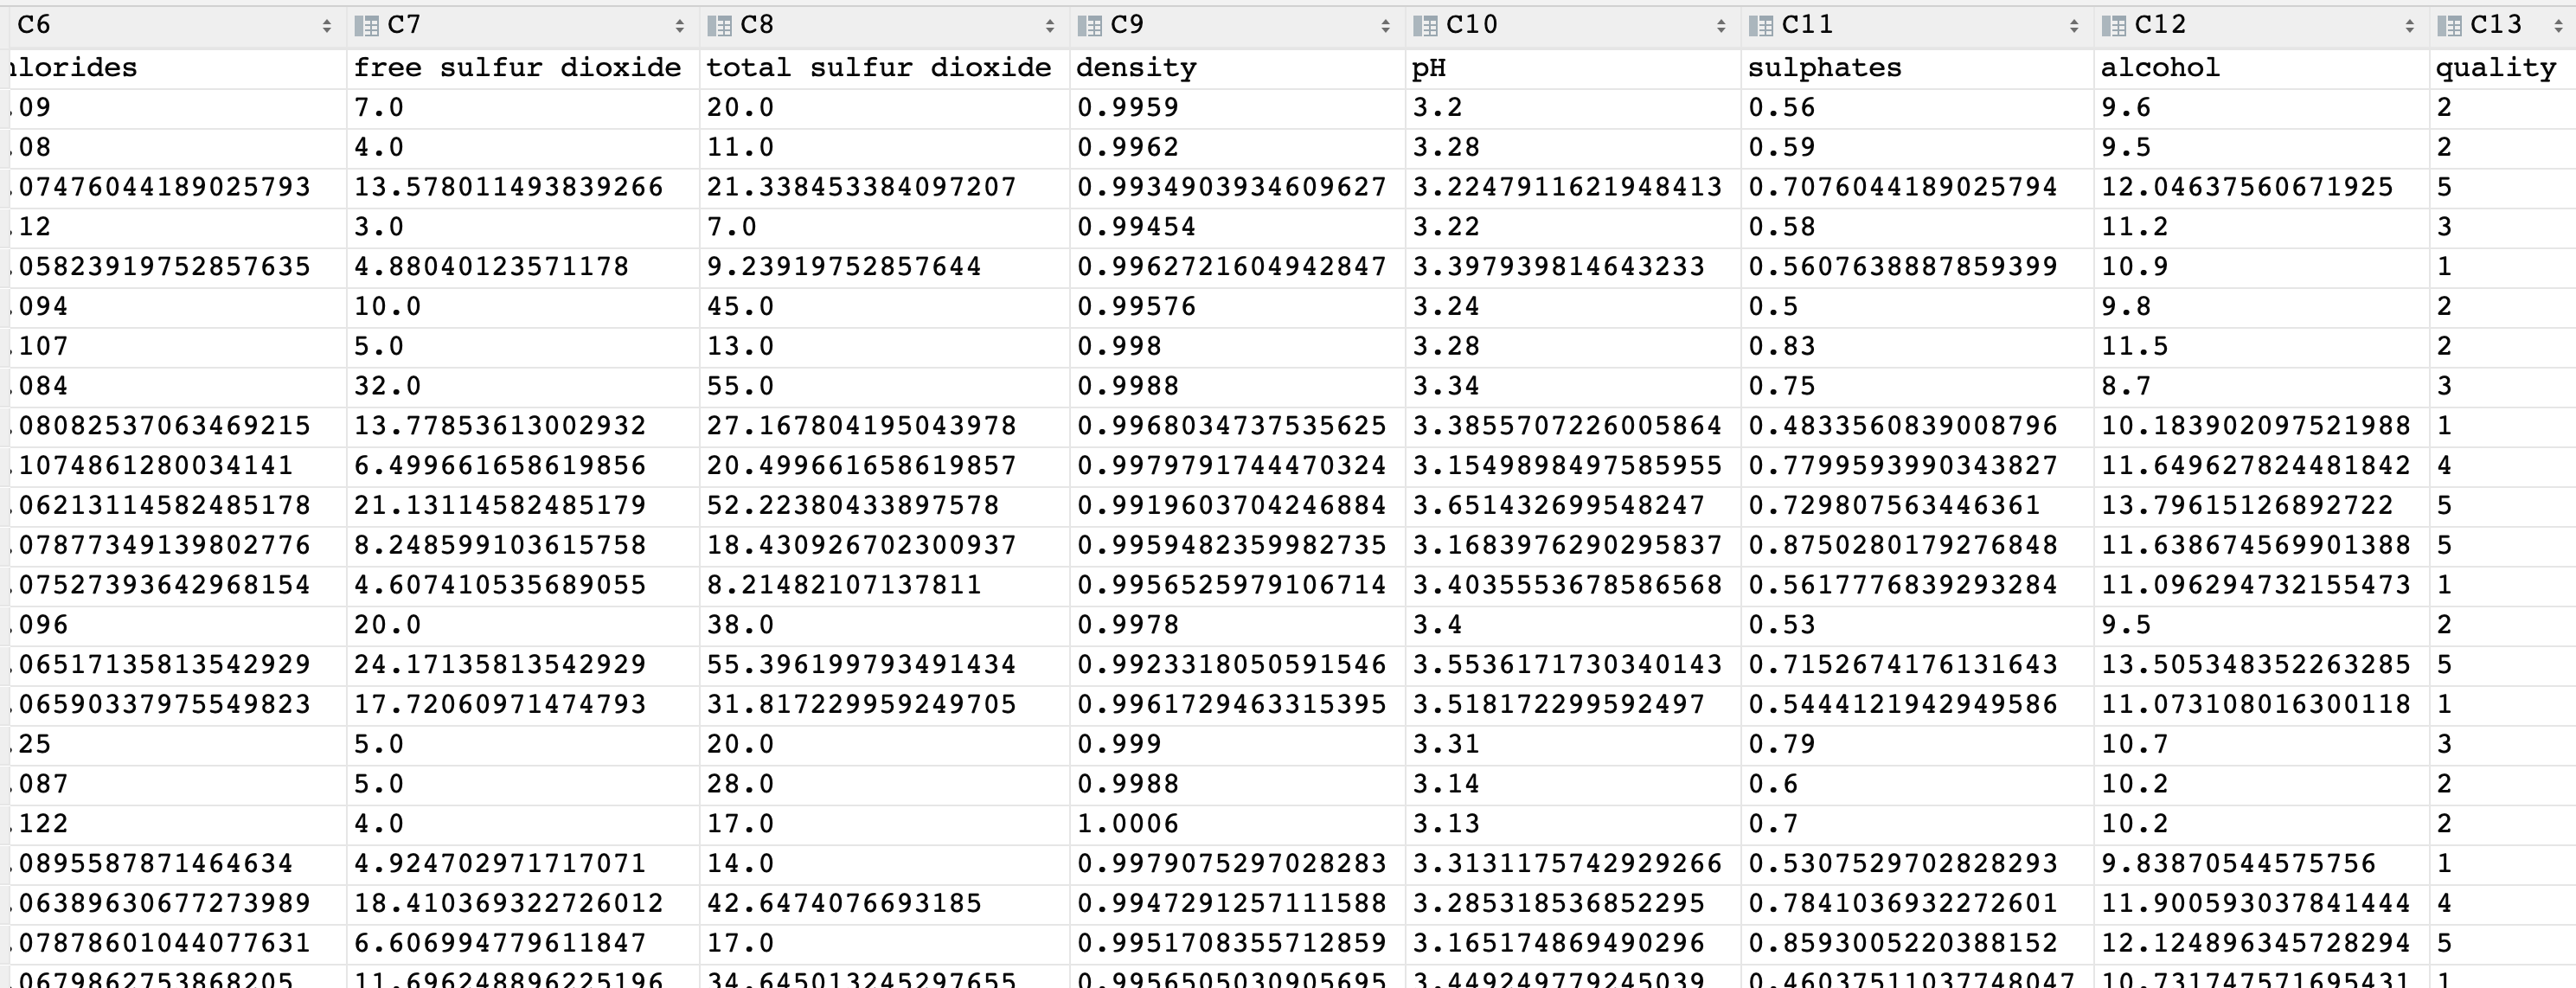
数据集:数据集共包含 11 个特征,共计 3269 条数据. 我们通过训练模型来预测红酒的品质, 品质共有 6 个各类别,分别使用数字: 1、2、3、4、5 来表示。
需求:对红酒品质进行多分类
分析:从数据可知,目标是多分类,数据存在样本不均衡问题
聚类
【案例】k-means-将随机创建的数据进行聚类
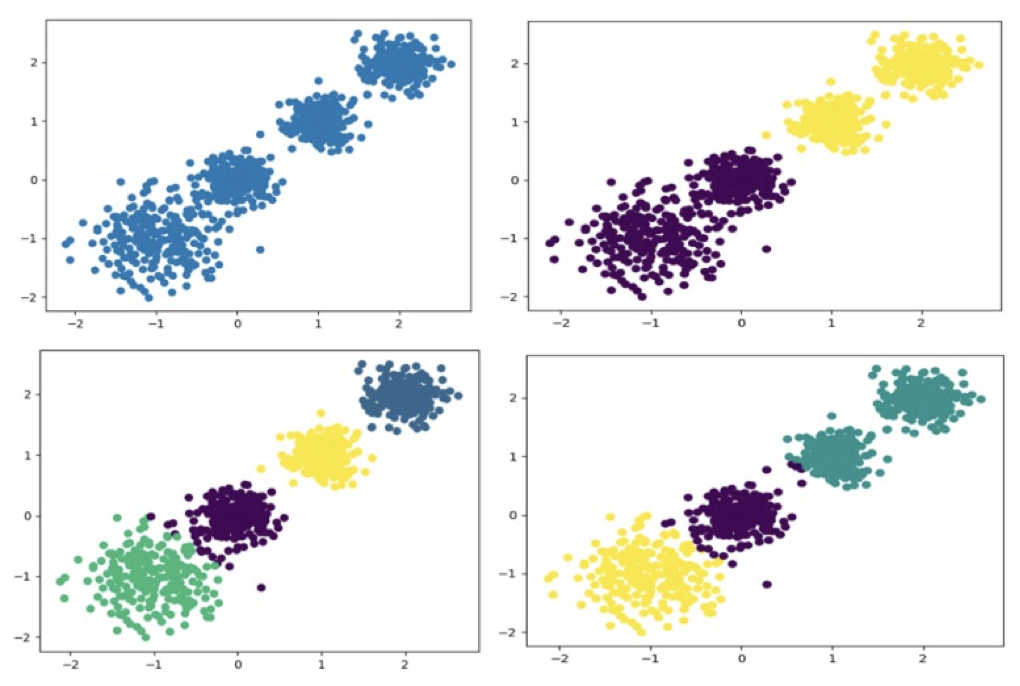
随机创建不同二维数据集作为训练集,并结合k-means算法将其聚类,你可以尝试分别聚类不同数量的簇,并观察聚类效果:
import matplotlib.pyplot as plt


from sklearn.datasets import make_blobs  # 默认按照高斯分布生成数据


from sklearn.cluster import KMeans


from sklearn.metrics import calinski_harabasz_score  # CH方法评估,值越大聚类效果越好
# 生成随机数据


x, y = make_blobs(


    n_samples=1000,   # n_samples:生成样本数


    n_features=2,     # n_features:每个样本的特征数


    centers=[[-1, -1], [0, 0], [1, 1], [2, 2]], # centers:中心数(即类别数)


    cluster_std=[0.4, 0.2, 0.2, 0.2], # cluster_std:中心点离中心点的距离(标准差),值越大,数据越分散


    random_state=9)


print(x, y)
# 绘制散点图


plt.scatter(x[:, 0], x[:, 1])


plt.show()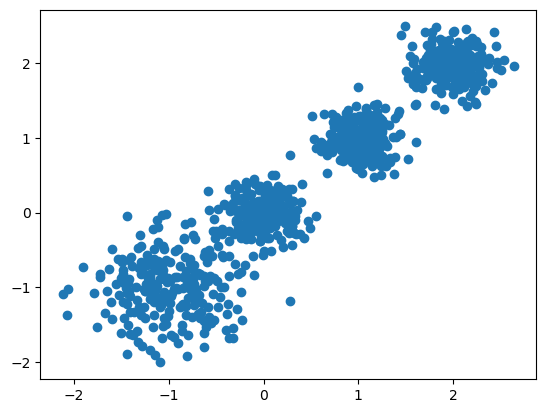
# 训练模型


kmeans = KMeans(n_clusters=4, random_state=10)  # n_clusters:聚类的类别数


y_pred = kmeans.fit_predict(x)


print(y_pred)
# 绘制结果


plt.scatter(x[:, 0], x[:, 1], c=y_pred)


plt.show()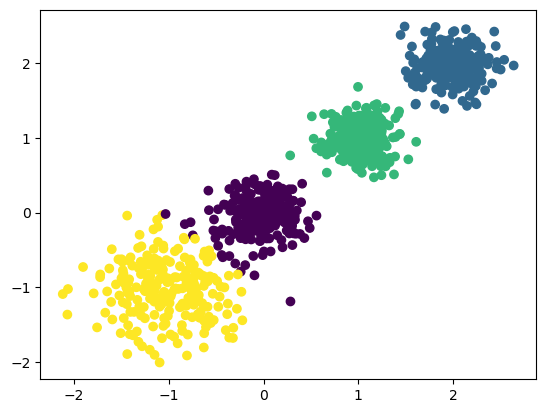
# 评价指标


ch_score = calinski_harabasz_score(x, y_pred)


print("CH score:", ch_score)  # 越大越好
【案例】聚类算法的评估指标
import matplotlib.pyplot as plt


from sklearn.cluster import KMeans


from sklearn.datasets import make_blobs


from sklearn.metrics import silhouette_score  # SC 轮廓系数


from sklearn.metrics import calinski_harabasz_score  # CH 轮廓评分
# 生成数据


x, y = make_blobs(


    n_samples=1000,     # 样本数量


    n_features=2,       # 特征数量


    centers=[[-1, -1], [0, 0], [1, 1], [2, 2]], # 聚类中心


    cluster_std=[0.4, 0.2, 0.2, 0.2],           # 每个簇的标准差


    random_state=0      # 随机种子


    )
'''SSE'''


sse_list = []  # 存储不同聚类个数k 对应的SSE值


# 循环尝试不同聚类个数k, 计算对应的SSE值


for k in range(1, 101):


    kmeans = KMeans(n_clusters=k, max_iter=100, random_state=42)


    kmeans.fit(x)


    sse_list.append(kmeans.inertia_)  # inertia_属性表示SSE值


# 绘制肘部曲线


plt.figure(figsize=(30, 10), dpi=100)


plt.plot(range(1, 101), sse_list, 'or-')


plt.title("SSE curve")


plt.xlabel("k")


plt.ylabel("SSE")


plt.xticks(range(0, 101, 5))


plt.grid()


plt.show()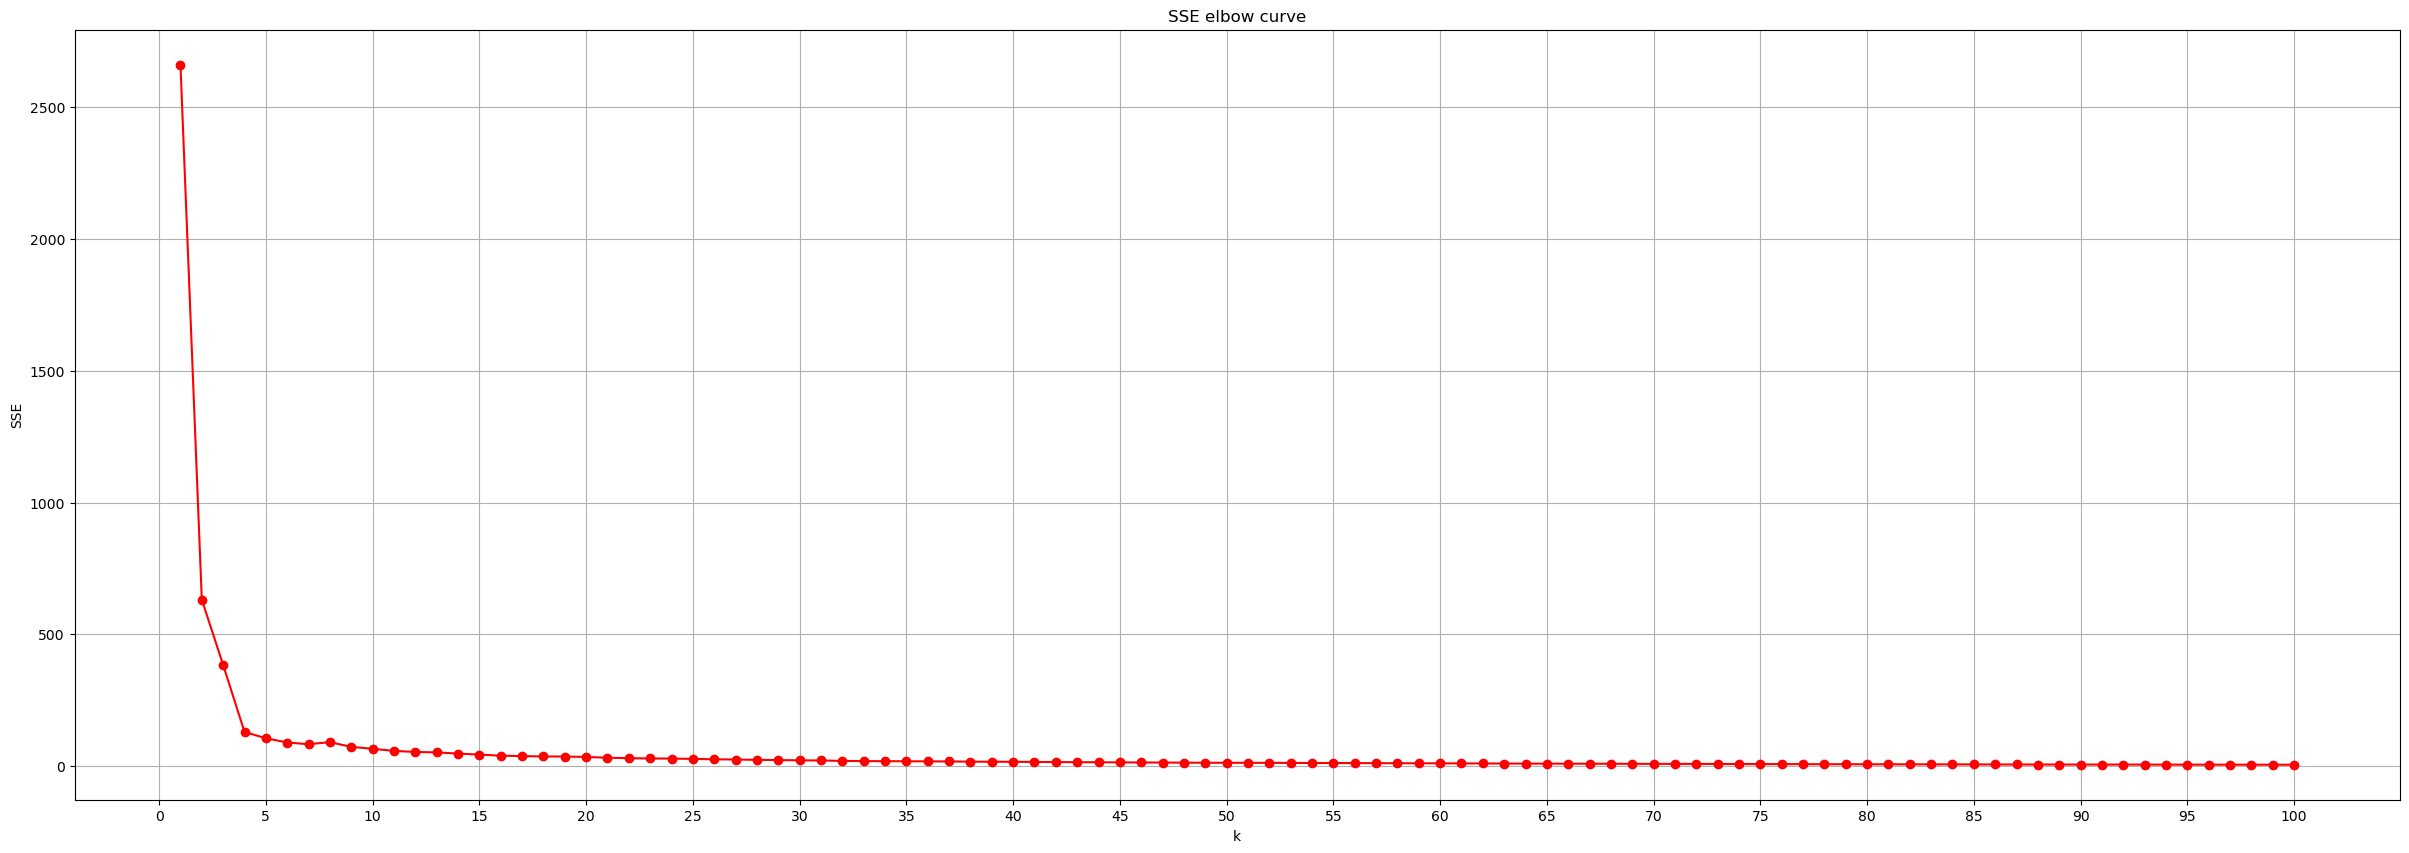
'''SC'''


sc_list = []  # 存储不同聚类个数k 对应的SC值


# 循环尝试不同聚类个数k, 计算对应的SC值


for k in range(2, 101):  # 从2开始,考虑簇外至少2个样本


    kmeans = KMeans(n_clusters=k, max_iter=100, random_state=42)


    kmeans.fit(x)


    y_pred = kmeans.predict(x)


    sc_value = silhouette_score(x, y_pred)


    sc_list.append(sc_value)


# 绘制肘部曲线


plt.figure(figsize=(30, 10), dpi=100)


plt.plot(range(2, 101), sc_list, 'or-')


plt.title("SC curve")


plt.xlabel("k")


plt.ylabel("SC")


plt.xticks(range(0, 101, 5))


plt.grid()


plt.show()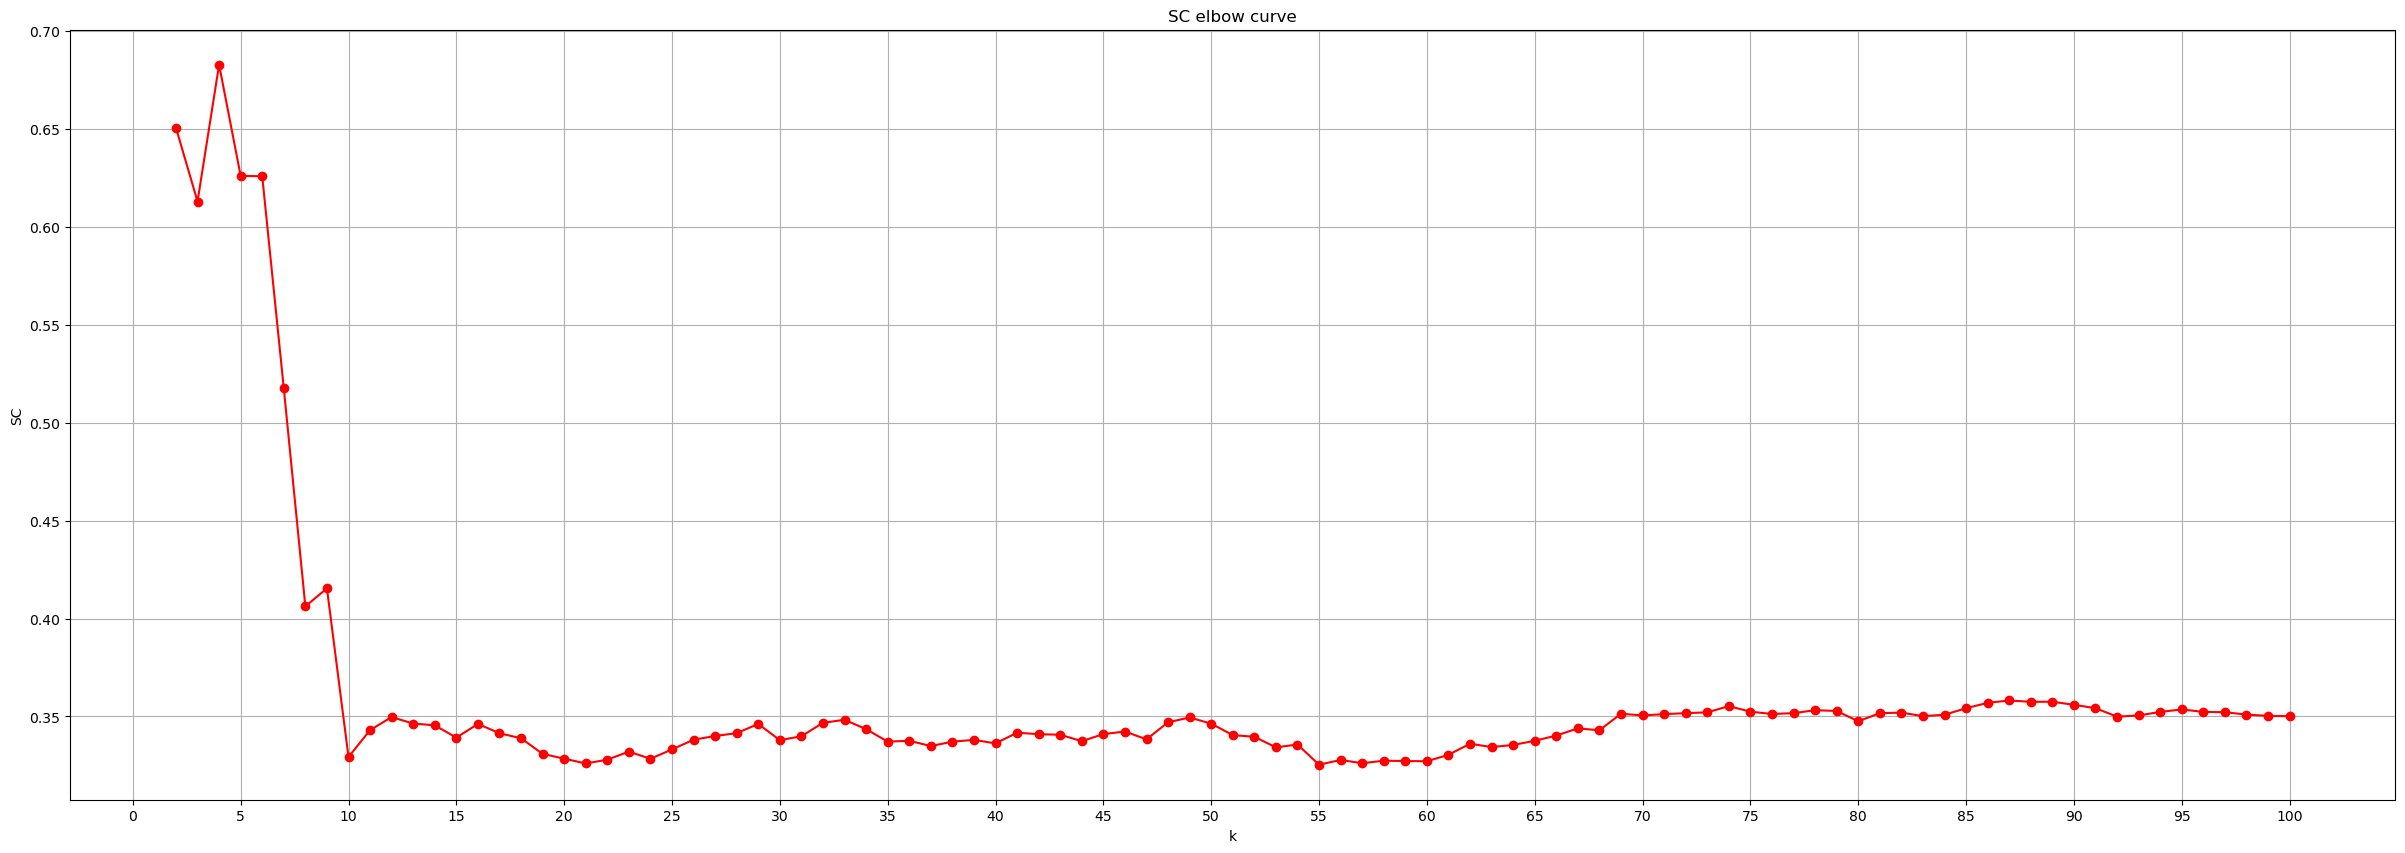
'''CH'''


ch_list = []  # 存储不同聚类个数k 对应的SC值


# 循环尝试不同聚类个数k, 计算对应的SC值


for k in range(2, 101):  # 从2开始,考虑簇外至少2个样本


    kmeans = KMeans(n_clusters=k, max_iter=100, random_state=42)


    kmeans.fit(x)


    y_pred = kmeans.predict(x)


    ch_value = calinski_harabasz_score(x, y_pred)


    ch_list.append(ch_value)


# 绘制肘部曲线


plt.figure(figsize=(30, 10), dpi=100)


plt.plot(range(2, 101), ch_list, 'or-')


plt.title("CH curve")


plt.xlabel("k")


plt.ylabel("CH")


plt.xticks(range(0, 101, 5))


plt.grid()


plt.show()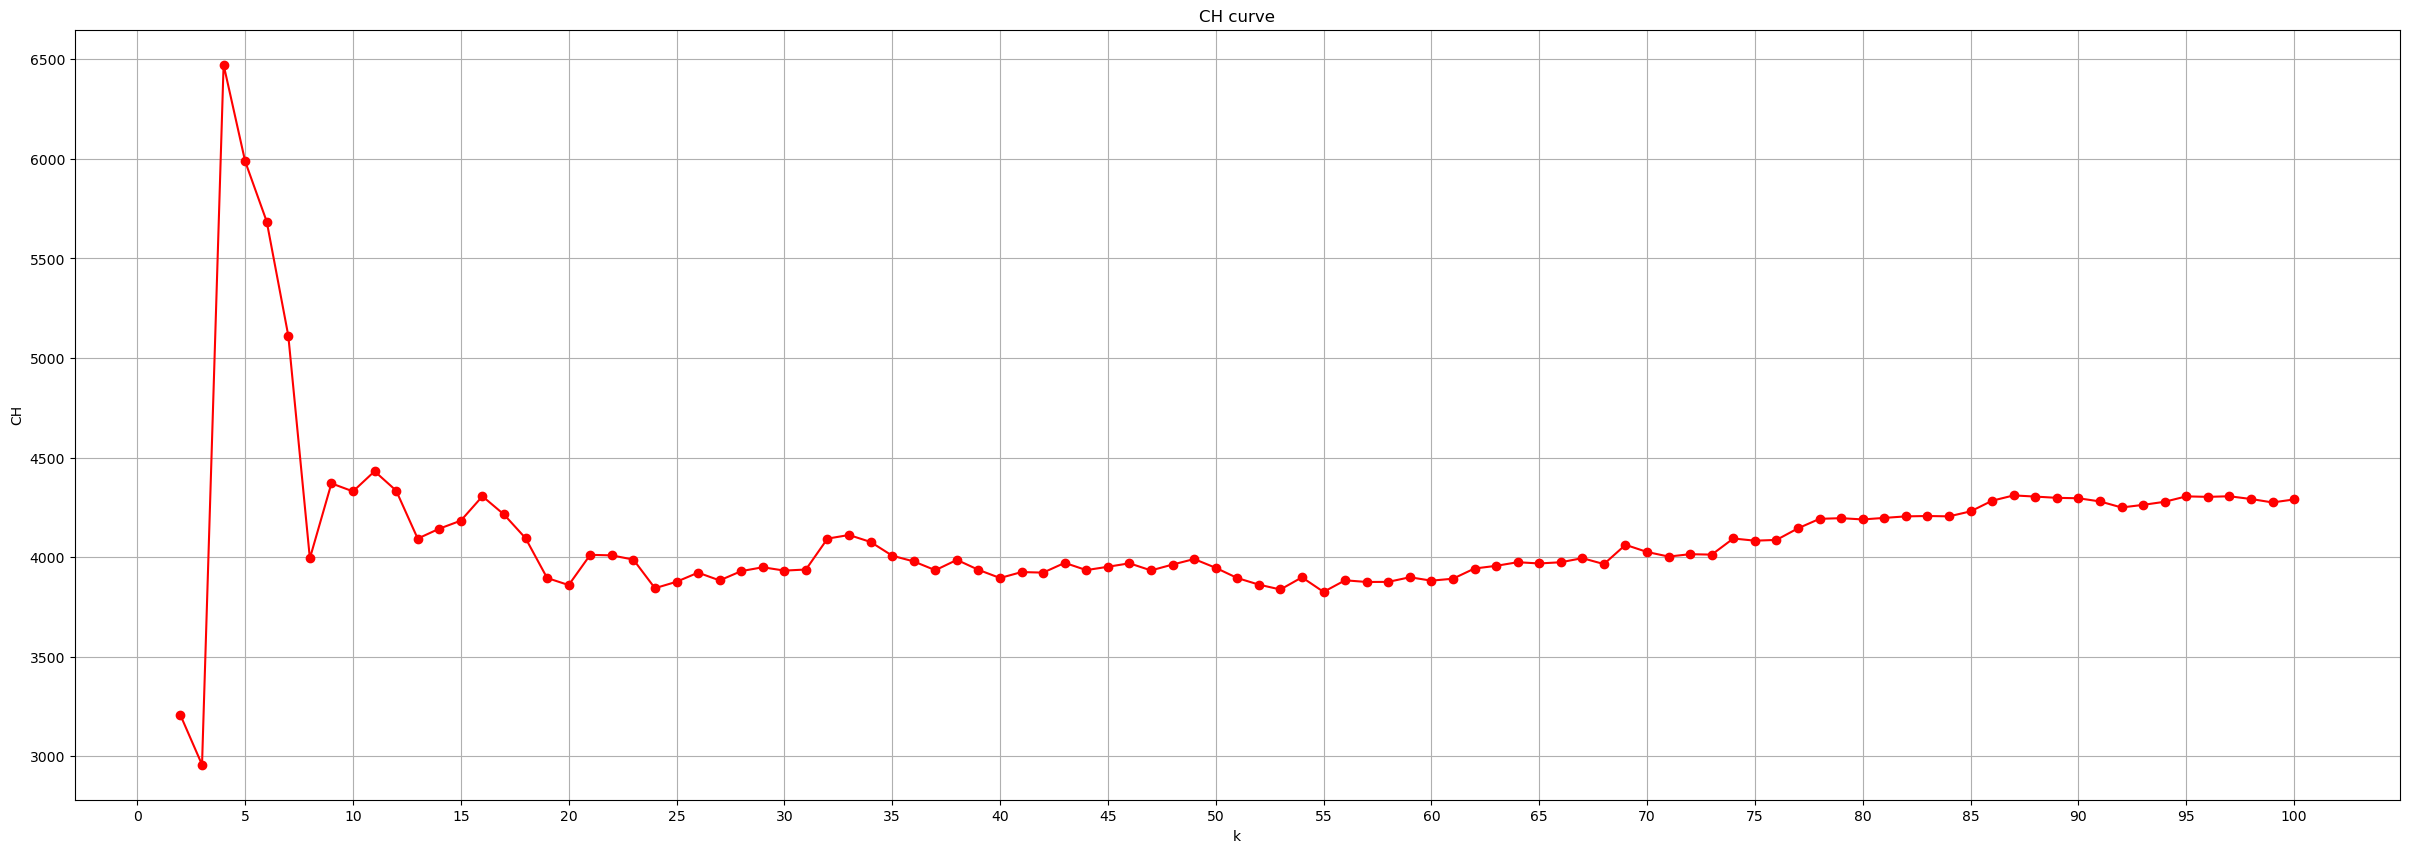
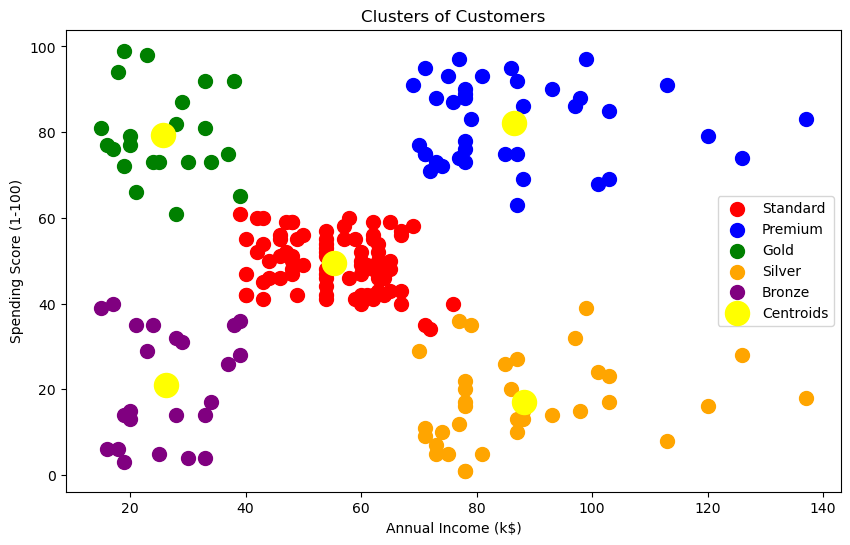
【案例】顾客数据聚类分析
已知:客户性别、年龄、年收入、消费指数
需求:对客户进行分析,找到业务突破口,寻找黄金客户
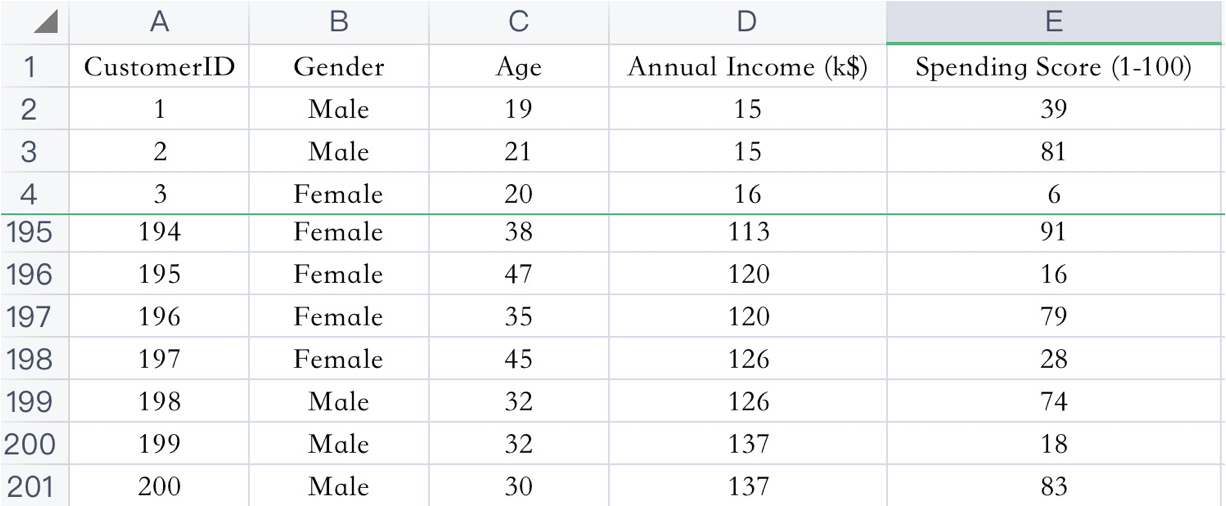
数据集共包含顾客的数据, 数据共有 4 个特征, 数据共有 200 条。接下来,使用聚类算法对具有相似特征的的顾客进行聚类,并可视化聚类结果。
import pandas as pd


import matplotlib.pyplot as plt


from sklearn.cluster import KMeans


from sklearn.metrics import silhouette_score
data = pd.read_csv('./data/customers.csv')


print(data.info())


data.head()
# 训练模型和评估指标计算


x = data.iloc[:, 3:4]


sse_list = []


sc_list = []


ch_list = []


for k in range(2, 80):  # 尝试k=1到100个聚类


    kmeans = KMeans(n_clusters=k, max_iter=100, random_state=42)


    kmeans.fit(x)


    sse_list.append(kmeans.inertia_)  # 存储SSE值


    y_pred = kmeans.predict(x)


    sc_list.append(silhouette_score(x, y_pred))
# 绘制评估指标图形


# SSE


plt.figure(figsize=(30, 5))


plt.subplot(1, 2, 1)


plt.plot(range(2, 80), sse_list, 'or-')


plt.title("SSE curve")


plt.xlabel("k")


plt.ylabel("SSE")


plt.xticks(range(2, 80, 5))


plt.grid()


plt.show()


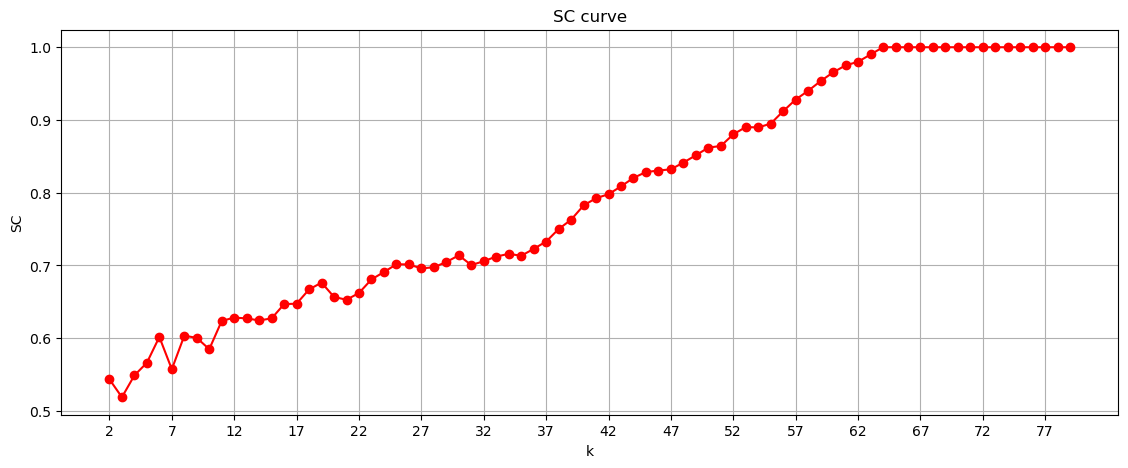
# SC


plt.figure(figsize=(30, 5))


plt.subplot(1, 2, 2)


plt.plot(range(2, 80), sc_list, 'or-')


plt.title("SC curve")


plt.xlabel("k")


plt.ylabel("SC")


plt.xticks(range(2, 80, 5))


plt.grid()


plt.show()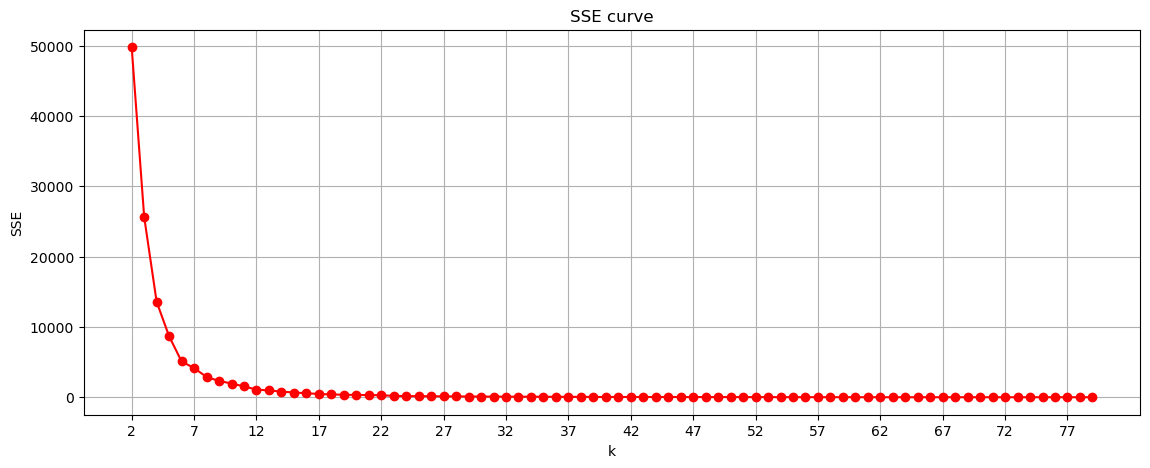
# 聚类分析


x = data.iloc[:, 3:5]


km = KMeans(n_clusters=5, max_iter=100, random_state=42)


km.fit(x)


y_pred = km.predict(x)


# 可视化


plt.figure(figsize=(10, 6))


# 把类别是 0的数据点画出来,颜色是红色,标签是Standard


plt.scatter(x.values[y_pred == 0, 0], x.values[y_pred == 0, 1], s=100, c='red', label='Standard')


# 把类别是 1的数据点画出来,颜色是蓝色,标签是Premium


plt.scatter(x.values[y_pred == 1, 0], x.values[y_pred == 1, 1], s=100, c='blue', label='Premium')


# 把类别是 2的数据点画出来,颜色是绿色,标签是Gold


plt.scatter(x.values[y_pred == 2, 0], x.values[y_pred == 2, 1], s=100, c='green', label='Gold')


# 把类别是 3的数据点画出来,颜色是橙色,标签是Silver


plt.scatter(x.values[y_pred == 3, 0], x.values[y_pred == 3, 1], s=100, c='orange', label='Silver')


# 把类别是 4的数据点画出来,颜色是紫色,标签是Bronze


plt.scatter(x.values[y_pred == 4, 0], x.values[y_pred == 4, 1], s=100, c='purple', label='Bronze')


# 画出质心


plt.scatter(km.cluster_centers_[:, 0], km.cluster_centers_[:, 1], s=300, c='yellow', label='Centroids')


plt.title('Clusters of Customers')


plt.xlabel('Annual Income (k$)')


plt.ylabel('Spending Score (1-100)')


plt.legend()


plt.show()