决策树
基本概念
决策树(Decision Tree)是一种基于树形结构的监督学习算法,用于解决分类(Classification)或回归(Regression)问题。
核心定义:决策树通过递归地将样本集按照特征取值进行划分,构建一棵树,其中每个内部节点表示一个特征上的判断条件,每个分支代表该判断的一个可能结果,每个叶节点代表一个预测输出(类别标签或连续数值)。
直观理解:决策树模拟人类做决策的过程,一系列“if-else”规则的组合。
核心组成:
根节点(Root Node):包含全部训练样本,是分裂的起点。
内部节点(Internal/Decision Node):对某个特征进行判断(如“年龄 > 30?”),并根据结果导向不同子节点。
分支(Branch):代表一个分类结果(或判断结果,如“是”或“否”)。
叶节点(Leaf/Terminal Node):不再分裂,直接给出预测结果(如“见”或“不见”,或“房价 = 250 万元”)。
适用任务:分类树(Classification Tree) vs 回归树(Regression Tree)
分类树:输出离散类别(如垃圾邮件识别、客户流失预测)。
回归树:输出连续数值(如房价预测、销量估计)。
优点与缺点:
优点:可解释性强、无需特征缩放、能处理数值/类别特征等
缺点:易过拟合、对数据扰动敏感、不稳定等
决策树构建流程(通用步骤)
特征选择:选择最优划分特征(依据不同准则,如有较强分类能力的特征)
决策树生成:根据选择的特征生成决策树。
节点分裂:按选定特征将数据划分为子集
递归建树:对每个子集重复上述过程
停止条件:
所有样本属于同一类
没有更多特征可用
样本数低于阈值
树深度达到上限
剪枝(Pruning) :防止过拟合(预剪枝 / 后剪枝)
特征选择准则(核心指标)
信息熵
对象:整个样本集合
作用:度量 的“混乱度”,熵(Entropy)在信息论中代表随机变量不确定度的度量
熵越大,数据的不确定性越高,信息就越多,整个系统不确定性越大
熵越小,数据的不确定性越低,整个系统确定性越大
分类越均匀,熵越大;如果只有一个类,熵为 0。
公式:
:信息的信息熵值
:某一类样本占总样本的比例(标签列)
条件熵
对象:在某个特征 的条件下,样本集合 的熵
公式:
其中,
条件熵 = 分类占比*信息熵 + 分类占比*信息熵 ...对任意特征 ,设其有 个可能取值。
对第 个取值,记 为 取该值的样本子集
表示 中属于第 类的样本子集。
信息增益
概念:特征 对训练数据集 的信息增益 ,定义为集合 的熵 与 特征 给定条件下 的熵之差。
公式:
-
信息增益 = 信息熵 - 条件熵
-
【示例】
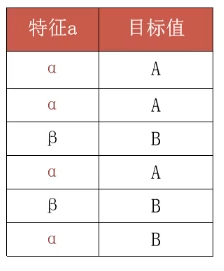
计算熵:
计算条件熵:
计算信息增益:
信息增益率
动机:
信息增益倾向于选择取值较多的特征(例如用户 ID),因为这类特征容易将数据划分为纯度很高的子集(条件熵接近 0),从而获得较大的信息增益。但这种划分通常缺乏泛化能力,对新样本无效。为克服这一偏差,引入信息增益率。
公式:
其中,
:特征 的信息增益率
:信息增益
:特征熵,表示分裂信息(Split Information,内在信息)或固有值(Intrinsic Value),即:惩罚参数,作为归一化惩罚项
:特征 的不同取值个数
:在特征 上取第 个值的样本子集
核心机制:
信息增益率通过除以 对信息增益进行归一化。
** ** 衡量的是特征 对数据集 的划分“均匀程度” :
当各子集 的样本数量越接近(划分越均匀), 越大;
当某个子集占据绝大多数样本(划分极不均匀), 趋近于 0。
因此:
对于取值多且划分均匀的特征(如 ID), 很大,导致 Gain_Ratio 被显著压低,有效抑制了对高基数无意义特征的偏好。
对于真正有判别力且划分合理的特征,即使取值不多,也能获得较高的增益率。
本质理解:
信息增益率 = 信息增益 / 分裂代价
→ 它衡量的是每单位划分复杂度所带来的信息收益,使特征选择更加鲁棒。
基尼值
从数据集中随机抽取两个样本,其类别标记不一致的概率。故, 值越小,数据集 的纯度越高
公式:
基尼值 = 两个样本(所有组合)的概率乘积和 = 1 - 每个类别概率的平方和
基尼指数
特征筛选,选择使划分后基尼系数最小的属性作为最优化属性
公式:
小结
信息熵:
条件熵:
特征熵:
信息增益:
信息增益率:
惩罚项:
💡:
信息增益(ID3)越小、信息增益率(C4.5)越大,则说明优先选择该特征
基尼指数越小(CRAT),则说明优先选择该特征
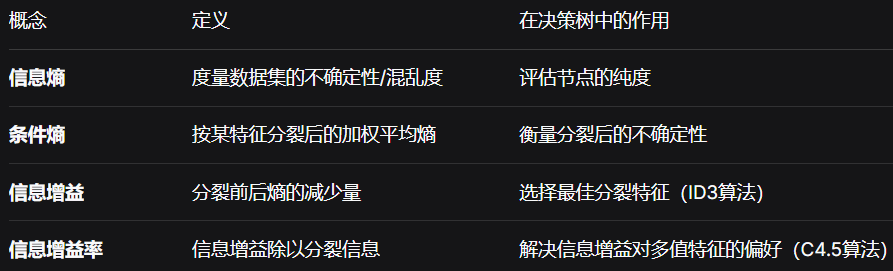
决策树算法
ID3 决策树
定义:ID3 树是基于信息增益构建的决策树
核心思想:优先参考信息增益大的特征列,充当节点
ID3 决策树构建流程
计算每个特征的信息增益
使用信息增益最大的特征将数据集 S 拆分为子集
使用该特征(信息增益最大的特征)作为决策树的一个节点
使用剩余特征对子集重复上述(1,2,3)过程
不足:偏向于选择种类多的特征作为分裂依据
【案例】
已知:某一个论坛客户流失率数据
需求:考察性别、活跃度特征哪一个特征对流失率的影响更大
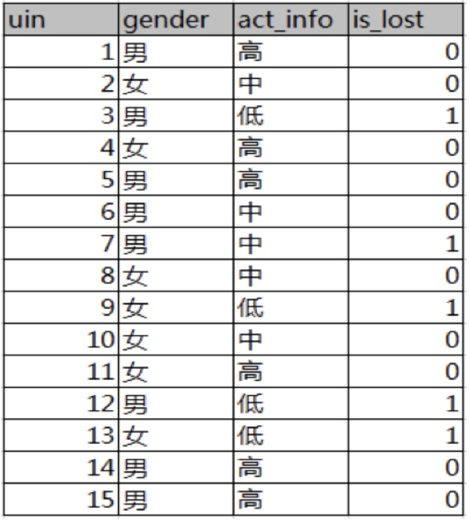
分析:
15条样本:5正样本、10个负样本
计算熵
计算性别信息增益
计算活跃度信息增益
比较两个特征的信息增益
计算信息熵,最大谁就充当根节点
计算熵:
gender 的信息增益
act_info 的信息增益
,故 采用 act_info(活跃度) 充当根节点
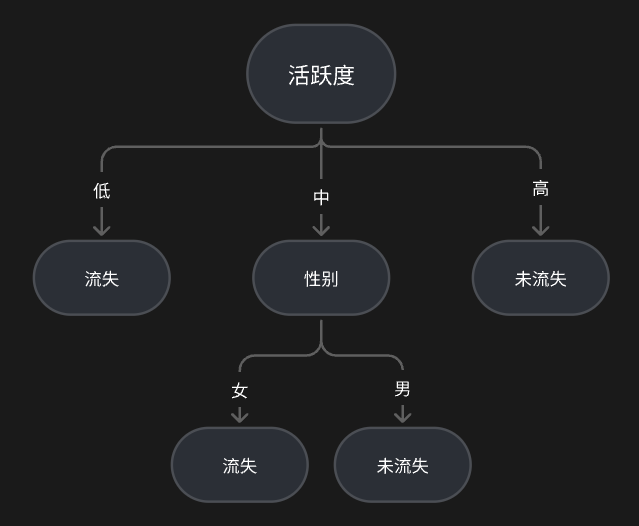
C4.5 决策树
在 C4.5 决策树算法中,为避免信息增益率偏向取值过少的特征,通常先筛选出信息增益高于平均水平的候选特征,再从中选择信息增益率最高的特征进行分裂。
信息增益率越大越好
【案例】计算 C4.5树 的信息增益率
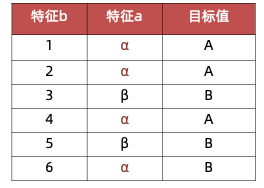
计算 特征a 的信息增益(信息增益 = 熵 - 条件熵)
计算 特征a 的特征熵
计算 特征a 的信息增益率(信息增益率 = 信息增益 / 特征熵)
计算 特征b 的 信息增益
计算 特征b 的特征熵
计算 特征b 的信息增益率
CART 决策树(Classification and Regression Tree)
Cart模型是一种决策树模型,它即可以用于分类,也可以用于回归。
分类和回归树模型采用不同的最优化策略
Cart回归树 使用平方误差最小化策略
Cart分类树 采用基尼指数最小化策略
CART 回归树和 CART 分类树的不同之处在于:
CART 分类树预测输出的是一个离散值,CART 回归树预测输出的是一个连续值。
CART 分类树使用基尼指数作为划分、构建树的依据,CART 回归树使用平方损失。
分类树使用叶子节点里出现更多次数的类别作为预测类别,回归树则采用叶子节点里均值作为预测输出
CART 回归树的平方损失(总误差):
:切分后形成的两个子区域(左子树和右子树对应的样本集合)
:第 个样本的真实目标值
:分别是在区域 和 中对输出的最优常数预测值
最优常数预测值: 该区域内所有目标值的均值(子区域中 y的均值)
平方损失 = (预测值 - 真实值)^2【案例】根据基尼值,构建 CART 分类树
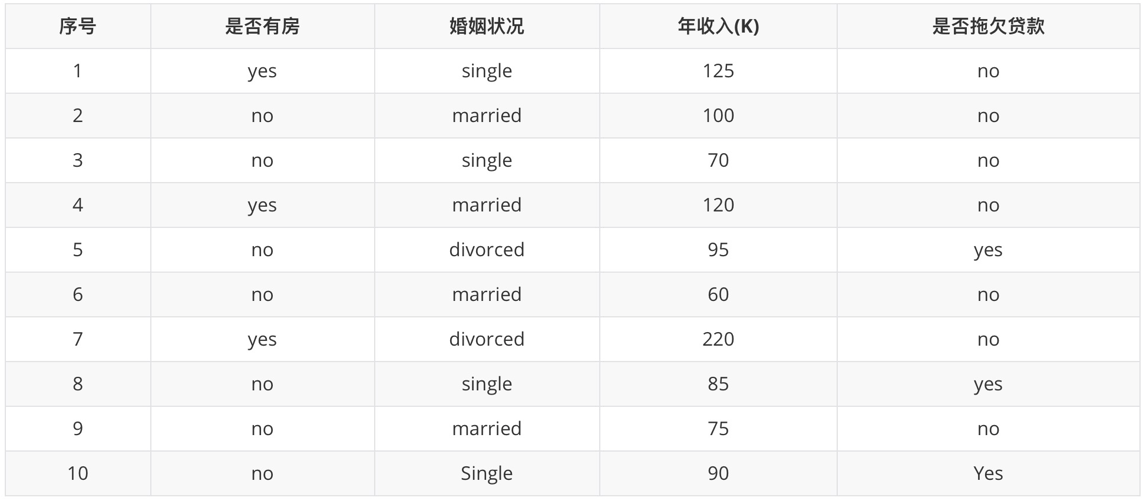
已知:是否拖欠货代数据
需求:计算各种特征的基尼指数,选择最优分裂点
计算是否有房的基尼指数
3-有房:3-no,0-yes;7-无房:3-yes,4-no
有房的基尼值
无房的基尼值
计算婚姻状况的基尼指数
计算 {married} 和 {single, divorced} 情况下的基尼指数
4-married:4-no,0-yes;6-{single, divorced}:3-no,3-yes
已婚的基尼值
未婚的基尼值
计算 {single} 和 {married, divorced} 情况下的基尼指数
计算 {divorced} 和 {single,married} 情况下的基尼指数
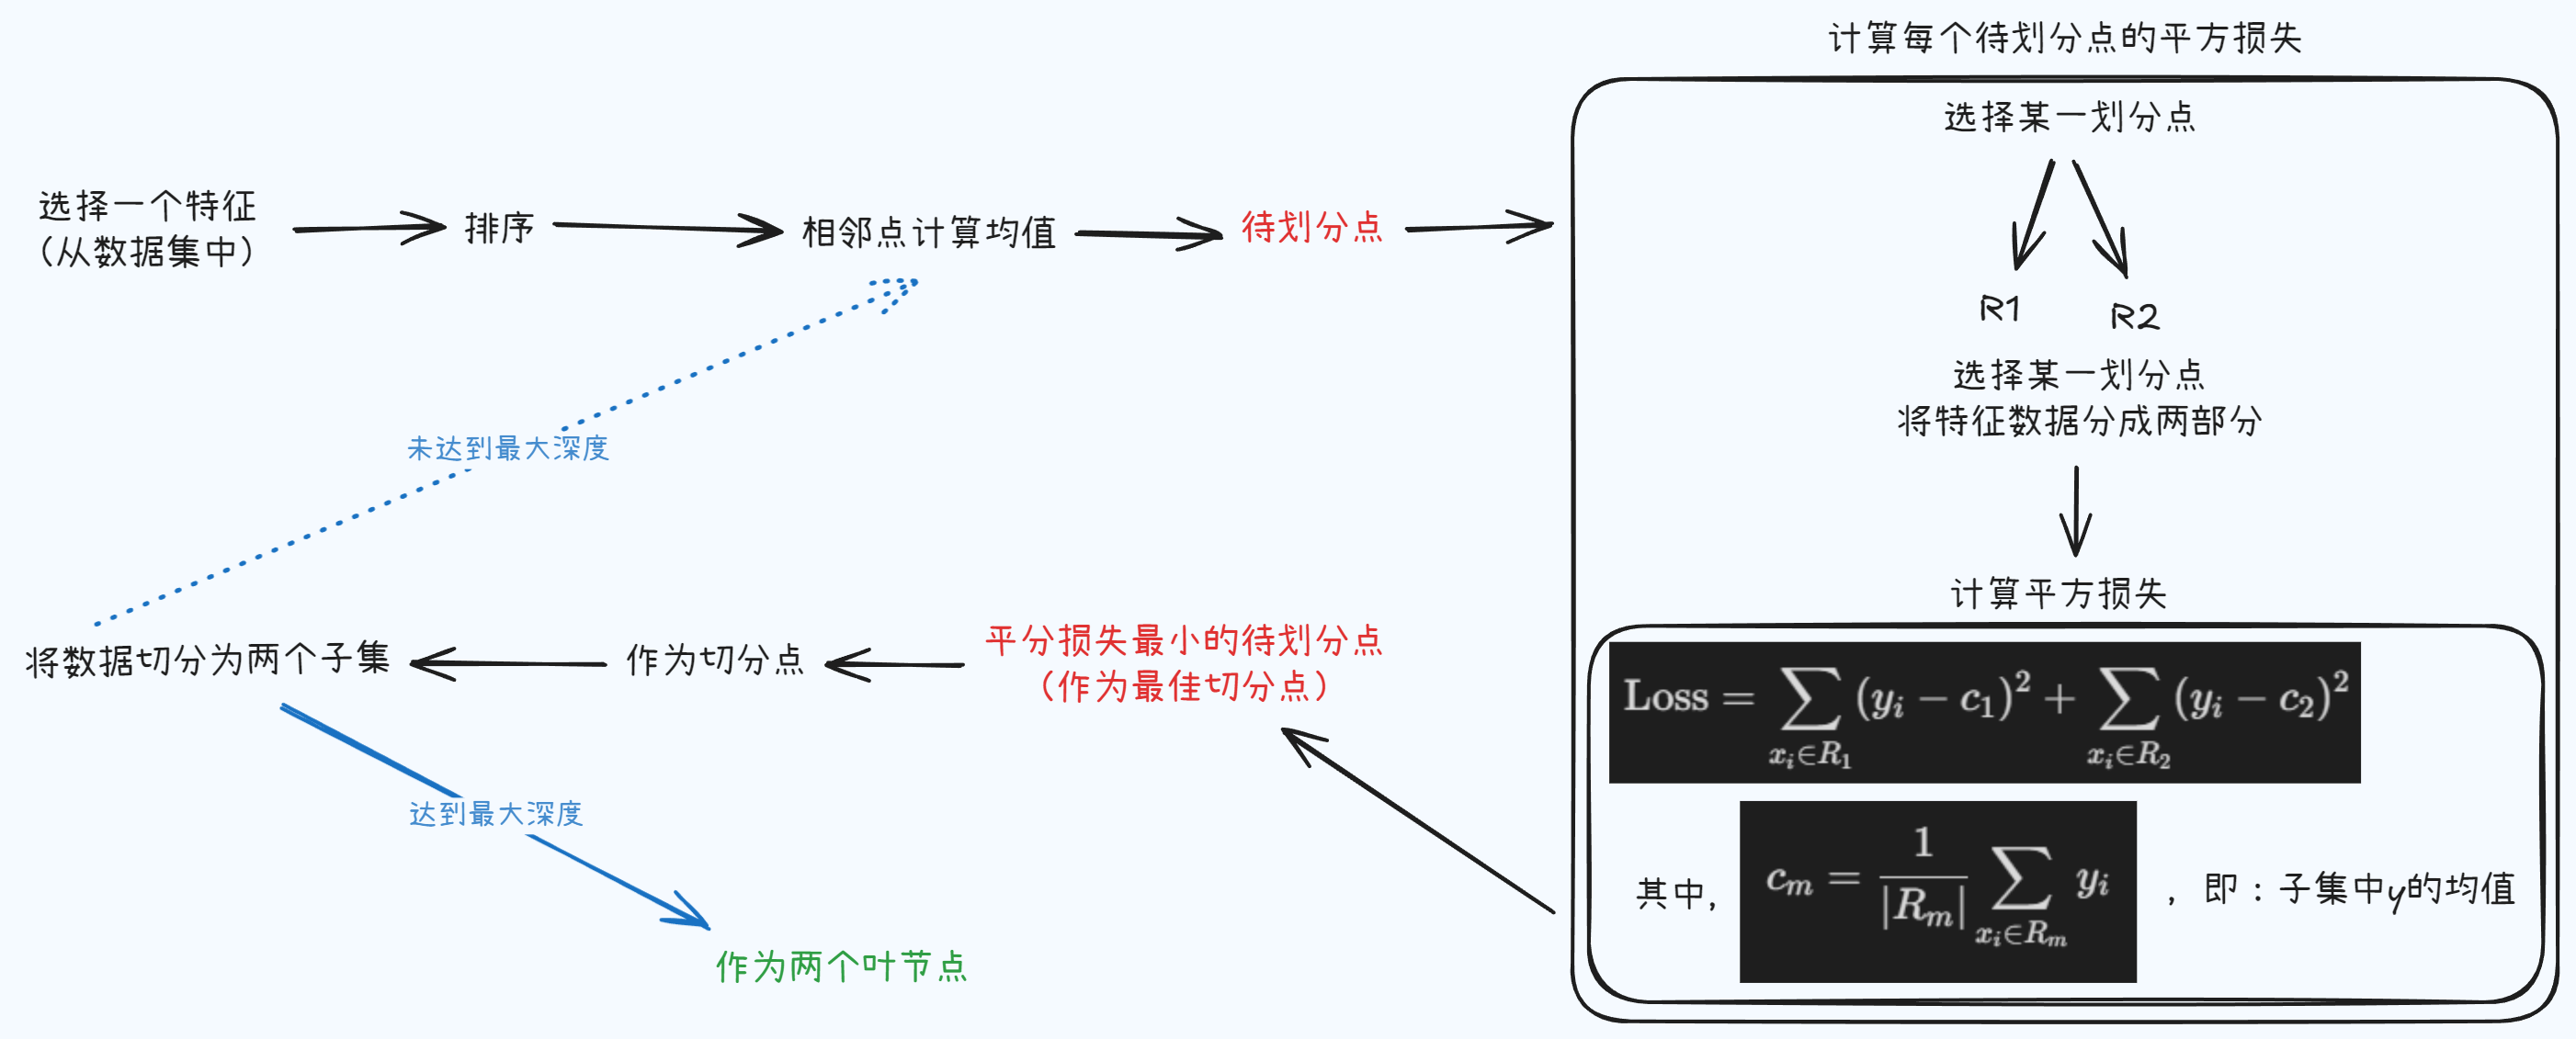
故,婚姻状况的基尼指数为 0.3,且 预选分裂点为:{married} 和
计算年收入的基尼指数
先将数值型属性升序排列,以相邻中间值作为待确定分裂点:
|是否拖欠贷款|年收入|相邻值中点|Gini_index|
| --------------| --------| ------------| ------------|
|no|60|65|0.4|
|no|70|72.5|0.375|
|no|75|80|0.343|
|yes|85|87.7|0.417|
|yes|90|92.5|0.4|
|yes|95|97.5|0.3|
|no|100|110|0.343|
|no|120|122.5|0.375|
|no|125|172.5|0.4|
|no|220|—|—|
以年收入 65 将样本分为两部分,计算基尼值
节点为 65 时:
同理,计算多有分割点的基尼指数,最小的基尼指数为 0.3
最小基尼指数有两个分裂点,我们随机选择一个即可
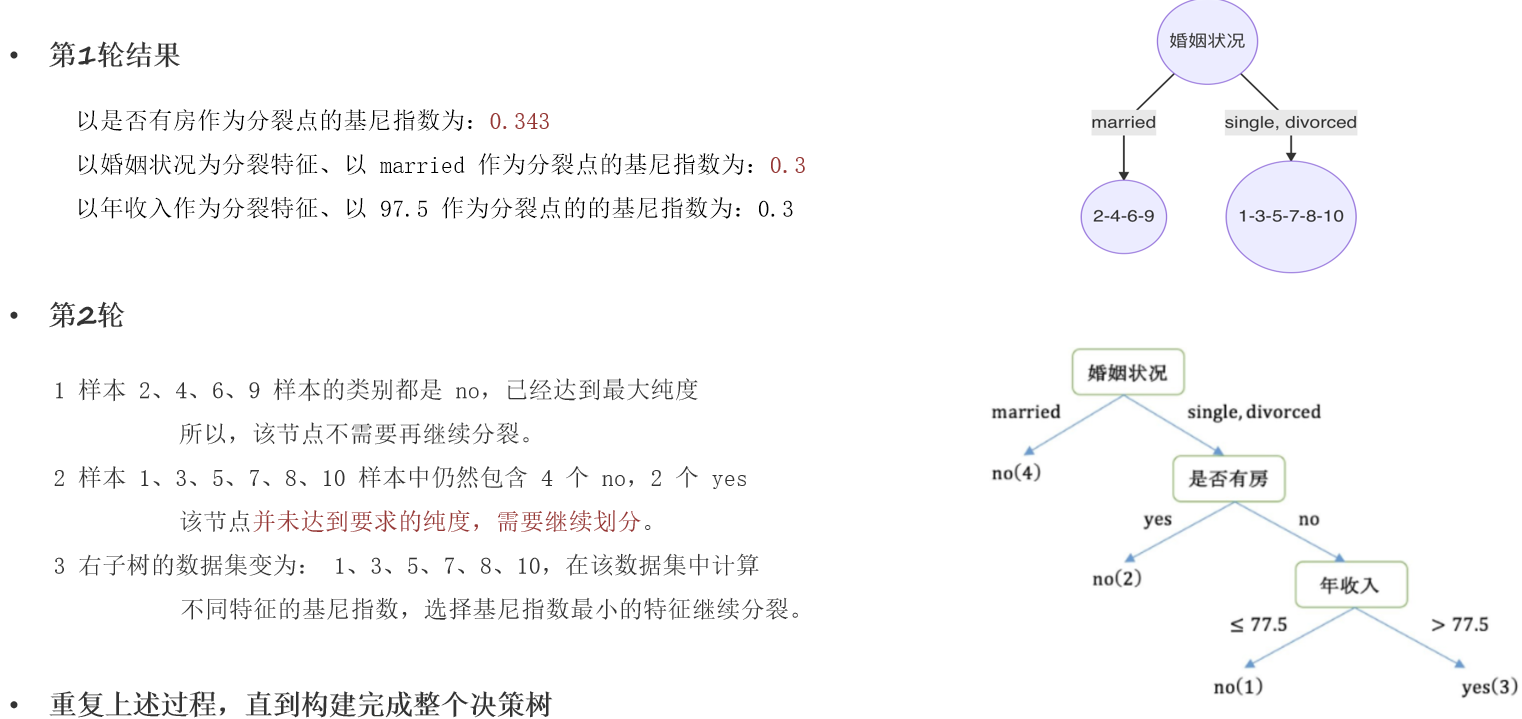
CART 回归树构建过程
选择第一个特征,将该特征的值进行排序,取相邻点计算均值作为待划分点
根据所有划分点,将数据集分成两部分:R1、R2
R1 和 R2 两部分的平方损失相加作为该切分点平方损失
取最小的平方损失的划分点,作为当前特征的划分点
以此计算其他特征的最优划分点、以及该划分点对应的损失值
在所有的特征的划分点中,选择出最小平方损失的划分点,作为当前树的分裂点
【案例】根据平方损失,构建 CART 回归树
已知:数据集只有1个特征x,目标值为y
|x|1|2|3|4|5|6|7|8|9|10|
| ---| ------| -----| ------| -----| -----| ------| -----| -----| ---| ------|
|y|5.56|5.7|5.91|6.4|6.8|7.05|8.9|8.7|9|9.05|
分析:因只有1个特征,所以只需选择该特征的最优划分点,并不需要计算其他特征。
先将特征 的值排序,并取相邻元素均值作为待划分点,如下所示:
|s|1.5|2.5|3.5|4.5|5.5|6.5|7.5|8.5|9.5|
| ---| -----| -----| -----| -----| -----| -----| -----| -----| -----|
计算每一个划分点的平方损失
例如:1.5 的平方损失计算过程为
R1 为 小于 1.5 的样本个数,样本数量为:1,其输出值为:
R2 为 大于 1.5 的样本个数,样本数量为:9 ,其输出值为:
该划分点的平方损失:
误差 = 预测值 - 真实值
以此方式计算 2.5、3.5... 等划分点的平方损失,结果如下所示:
|s|1.5|2.5|3.5|4.5|5.5|6.5|7.5|8.5|9.5|
| ------| -------| -------| ------| ------| ------| -------------------------------------------------------------------------------------------------| ------| -------| -------|
|m(s)|15.72|12.07|8.36|5.78|3.91|1.93|8.01|11.73|15.74|
当划分点 时, 最小。
因此,第一个划分变量:特征为 , 切分点为 ,即:
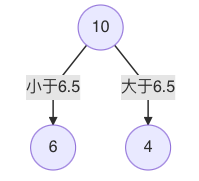
对左子树的 6 个结点计算每个划分点的平方式损失,找出最优划分点:
|x|1|2|3|4|5|6|
| ---| ------| -----| ------| -----| -----| ------|
|y|5.56|5.7|5.91|6.4|6.8|7.05|
|s|1.5|2.5|3.5|4.5|5.5|
| ----| ------| ------| ------| ------| ------|
|c1|5.56|5.63|5.72|5.89|6.07|
|c2|6.37|6.54|6.75|6.93|7.05|
以 作为切分点,左子树c1 输出为5.56,右子树c2输出
|s|1.5|2.5|3.5|4.5|5.5|
| ------| --------| -------| -------------------------------------------------------------------------------------------------| --------| --------|
|m(s)|1.3087|0.754|0.2771|0.4368|1.0644|
时 最小,所以左子树继续以 进行分裂:
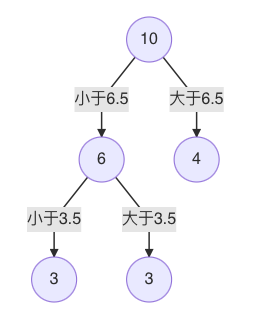
假设在生成3个区域 之后停止划分(最大深度为3),以上就是回归树。
每一个叶子结点的输出为:挂在该结点上的所有样本均值。
|x|1|2|3|4|5|6|7|8|9|10|
| ---| ------| -----| ------| -----| -----| ------| -----| -----| ---| ------|
|y|5.56|5.7|5.91|6.4|6.8|7.05|8.9|8.7|9|9.05|
1/2/3 号样本预测结果都为:5.72
4/5/6 号样本预测结果都为:6.75
7/8/9/10 号样本预测结果都为:8.9125
【案例】泰坦尼克号乘客生存预测
小结
|名称|提出时间|分支方式|特点|
| ------| ----------| ------------| --------------------------------------------------------------------------------------------------------------------------------------------------------------|
|ID3|1975|信息增益|1.ID3只能对离散属性的数据集构成决策树
2.倾向于选择取值较多的属性
|
|C4.5|1993|信息增益率|1.缓解了ID3分支过程中总喜欢偏向选择值较多的属性
2.可处理连续数值型属性,也增加了对缺失值的处理方法
3.只适合于能够驻留于内存的数据集,大数据集无能为力
|
|CART|1984|基尼指数|1.可以进行分类和回归,可处理离散属性,也可以处理连续属性
2.采用基尼指数,计算量减小
3.一定是二叉树
|
决策树剪枝
为什么要剪枝?
防止决策树过拟合的一种正则化方法,可提高其泛化能力
如何剪枝?
将一颗子树的子节点全部删掉,利用叶子节点替换子树(实质上是后剪枝技术),也可以(假定当前对以root为根的子树进行剪枝)只保留根节点本身而删除所有的叶子
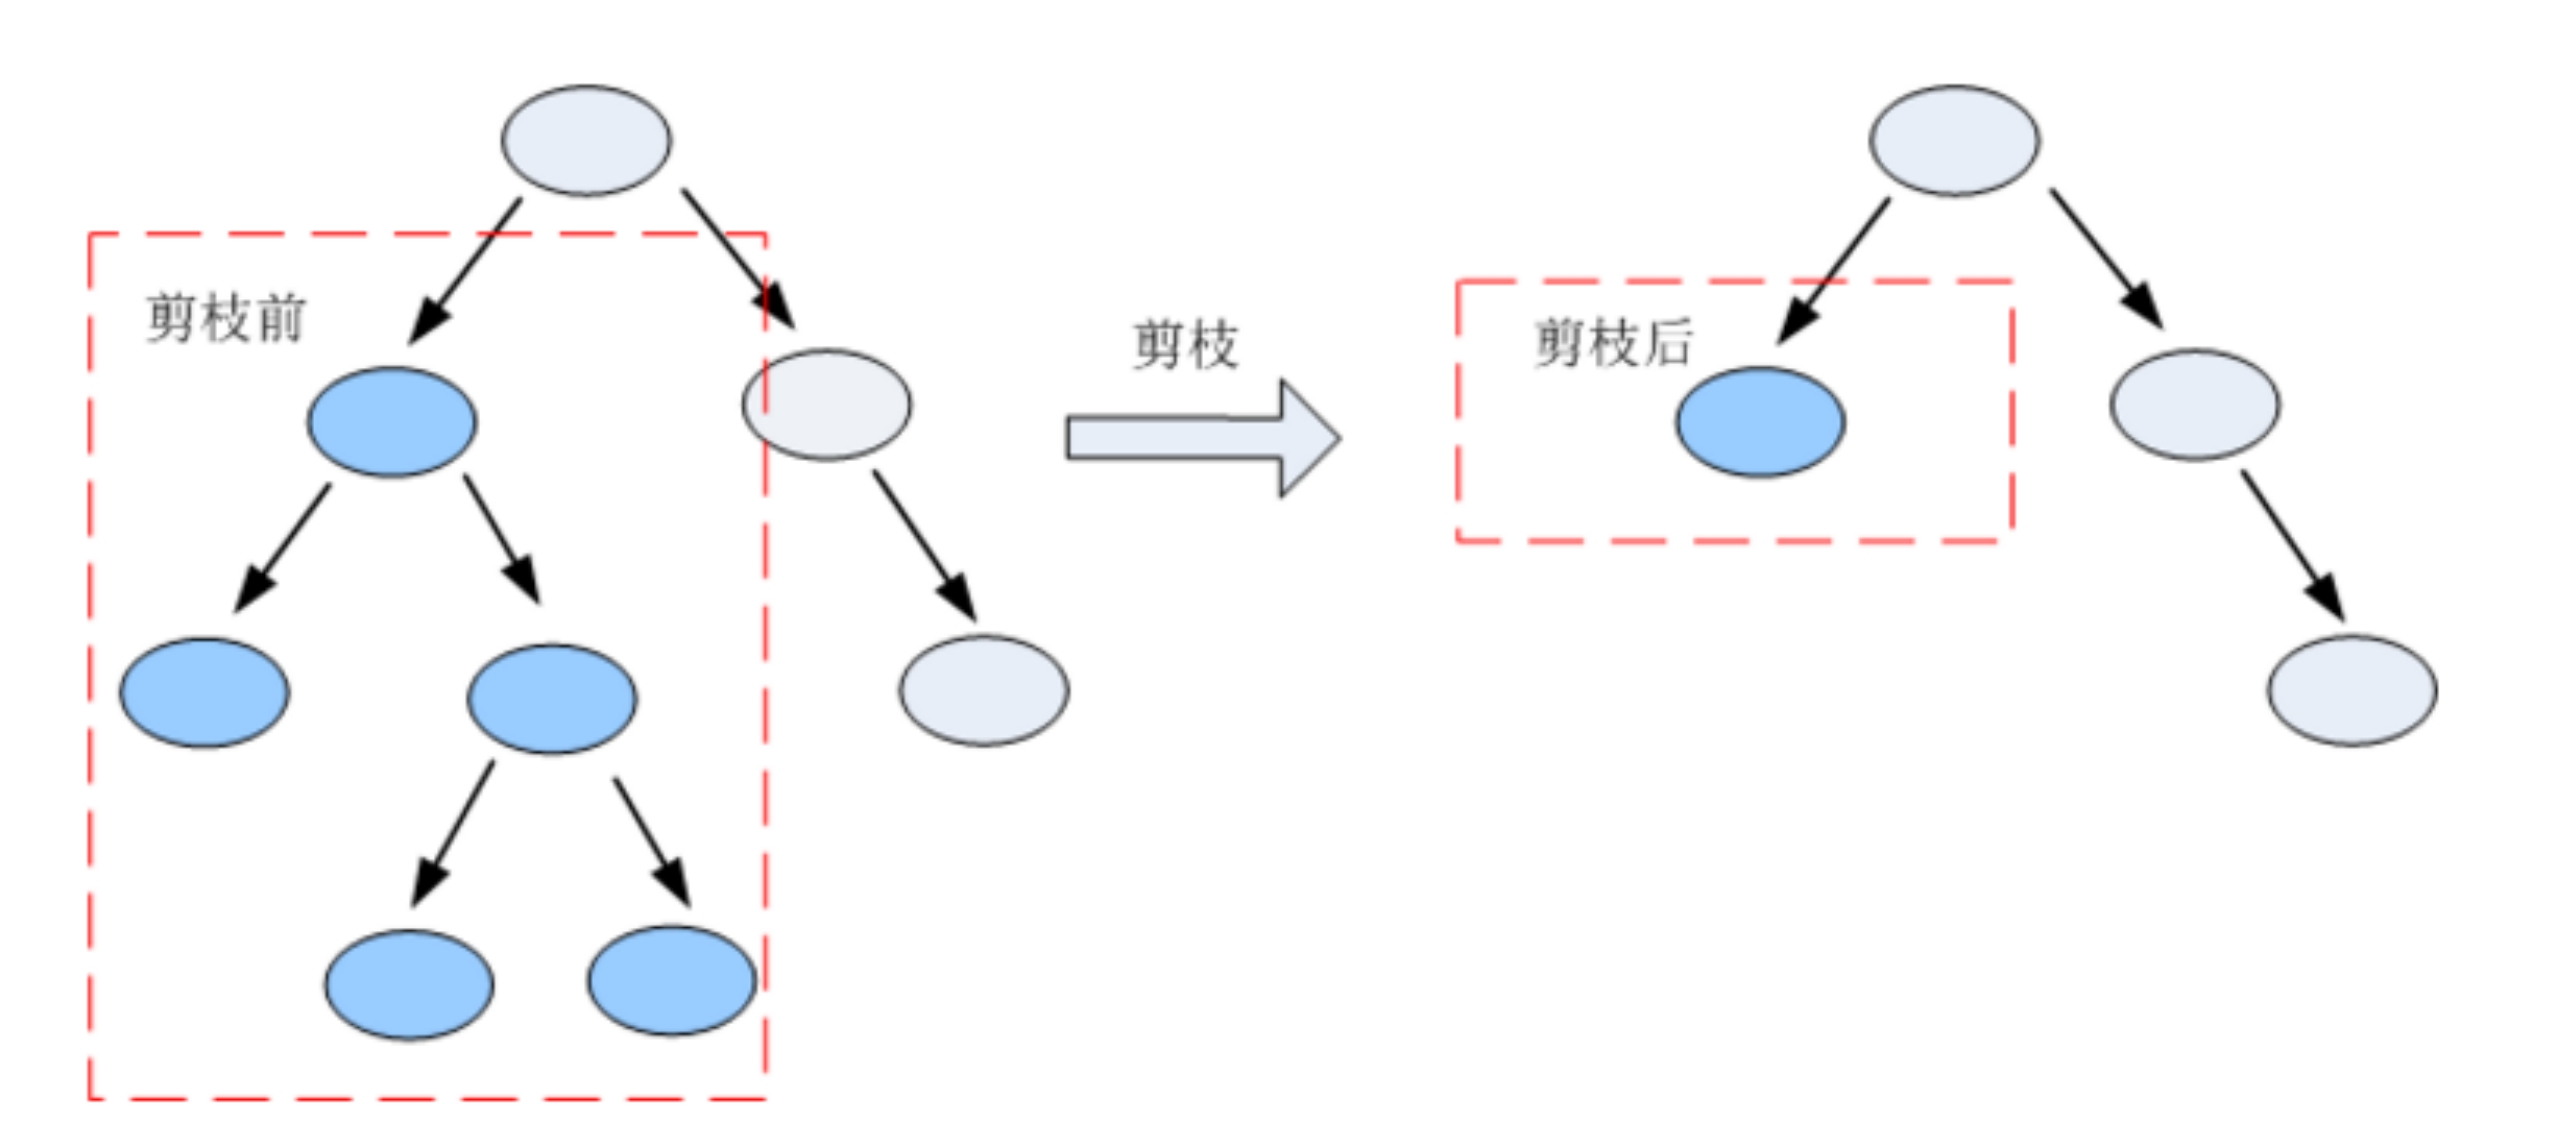
剪枝的方式:
预剪枝:指在决策树生成过程中,对每个结点在划分前先进行估计,若当前结点的划分不能带来决策树泛化性能提升,则停止划分并将当前结点标记为叶结点;
后剪枝:先从训练集生成一棵完整的决策树,然后自底向上地对非叶结点进行考察,若将该结点对应的子树替换为叶结点能带来决策树泛化性能提升,则将该子树替换为叶结点。
【区别】预剪枝,在节点划分前就先判断是否要剪枝;后剪枝,对一颗完整的树进行剪枝。
预剪枝 VS 后剪枝
||预剪枝|后剪枝|
| ------| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------| -----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
|优点|预剪枝使决策树的很多分支没有展开,不单降低了过拟合风险,还显著减少了决策树的训练、测试时间开销|比预剪枝保留了更多的分支。一般情况下,后剪枝决策树的欠拟合风险很小,泛化性能往往优于预剪枝|
|缺点|有些分支的当前划分虽不能提升泛化性能,但在其基础上进行的后续划分却有可能导致性能的显著提高
预剪枝决策树也带来了欠拟合的风险
|但后剪枝过程是在生成完全决策树之后进行的,并且要自底向上地对树中所有非叶子节点进行逐一考察,因此在训练时间开销比未剪枝的决策树和预剪枝的决策树都要大得多。(资源开销大)|
【例子】预剪枝和后剪枝