GBDT介绍
集成学习
集成学习归属于机器学习,他是一种「训练思路」,并不是某种具体的方法或者算法。
现实生活中,大家都知道「人多力量大」,「3 个臭皮匠顶个诸葛亮」。而集成学习的核心思路就是「人多力量大」,它并没有创造出新的算法,而是把已有的算法进行结合,从而得到更好的效果。
集成学习会挑选一些简单的基础模型进行组装,组装这些基础模型的思路主要有 2 种方法:
bagging(bootstrap aggregating的缩写,也称作“套袋法”)
boosting
Bagging
强强遏制变"弱",防止过拟合;
Bagging 的思路是所有基础模型都一致对待,每个基础模型手里都只有一票。然后使用民主投票的方式得到最终的结果
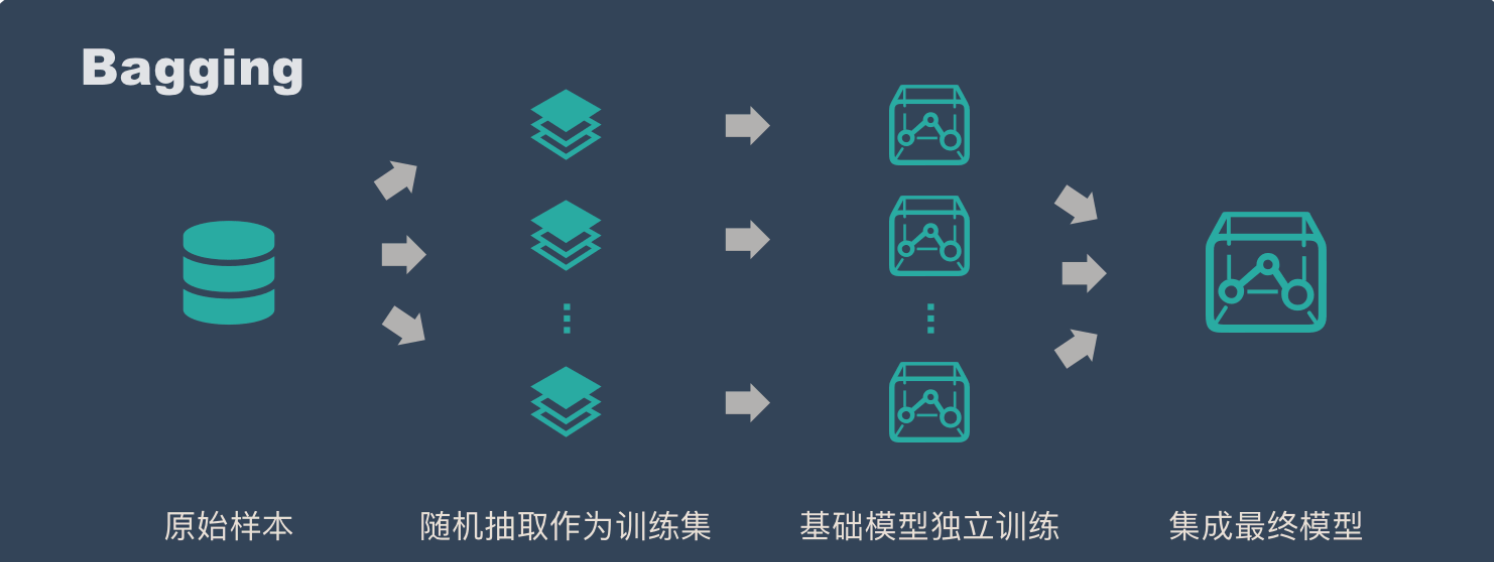
具体过程:
从原始样本集中抽取训练集。每轮从原始样本集中使用Bootstraping(有放回抽取)的方法抽取n个训练样本(在训练集中,有些样本可能被多次抽取到,而有些样本可能一次都没有被抽中)。共进行k轮抽取,得到k个训练集。(k个训练集之间是相互独立的)
每次使用一个训练集得到一个模型,k个训练集共得到k个模型。(注:这里并没有具体的分类算法或回归方法,我们可以根据具体问题采用不同的分类或回归方法,如决策树、感知器等)
对分类问题:将上步得到的k个模型采用投票的方式得到分类结果;对回归问题,计算上述模型的均值作为最后的结果。(所有模型的重要性相同)
- 在 bagging 的方法中,最广为熟知的就是随机森林了:bagging + 决策树 = 随机森林
Boosting
弱弱组合变强,防止欠拟合
Boosting 和 bagging 最本质的差别在于他对基础模型不是一致对待的,而是经过不停的考验和筛选来挑选出「精英」,然后给精英更多的投票权,表现不好的基础模型则给较少的投票权,然后综合所有人的投票得到最终结果。
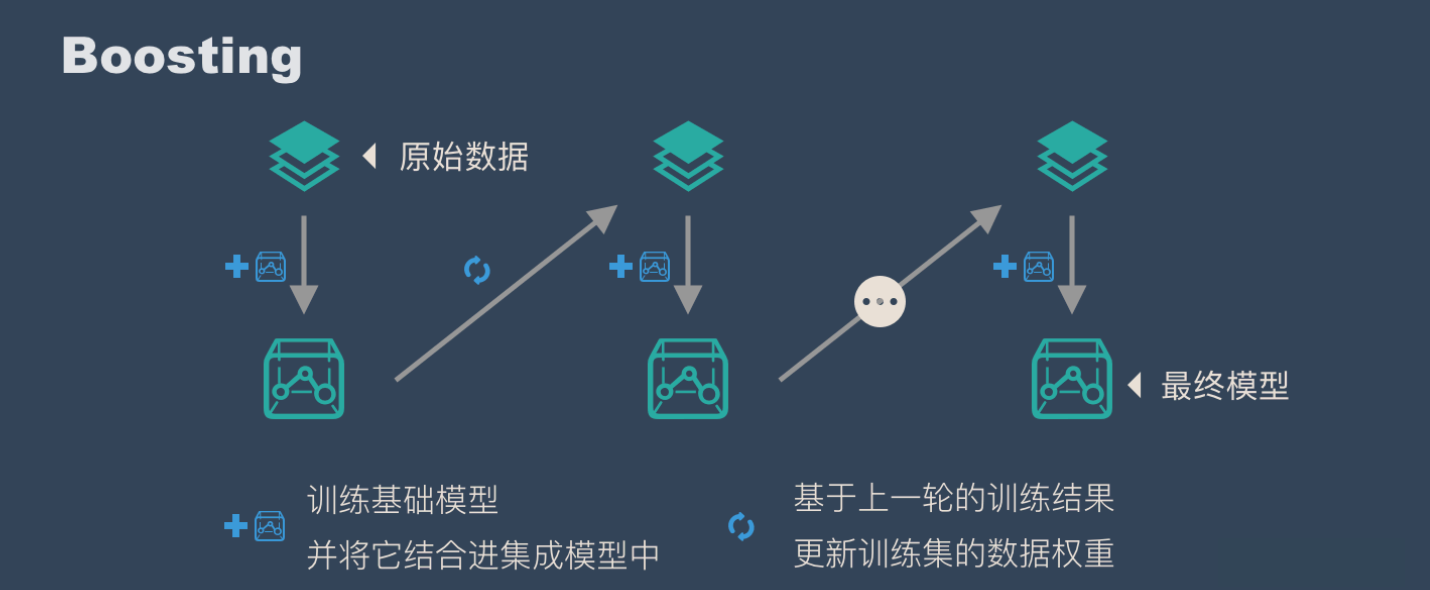
具体过程:
通过加法模型将基础模型进行线性的组合。
每一轮训练都提升那些错误率小的基础模型权重,同时减小错误率高的模型权重。
在每一轮改变训练数据的权值或概率分布,通过提高那些在前一轮被弱分类器分错样例的权值,减小前一轮分对样例的权值,来使得分类器对误分的数据有较好的效果。
- 在 boosting 的方法中,比较主流的有GBDT 。
GBDT算法
GBDT的原理:
所有弱分类器的结果相加等于预测值。
每次都以当前预测为基准,下一个弱分类器去拟合误差函数对预测值的残差(预测值与真实值之间的误差)。
GBDT的弱分类器使用的是树模型。
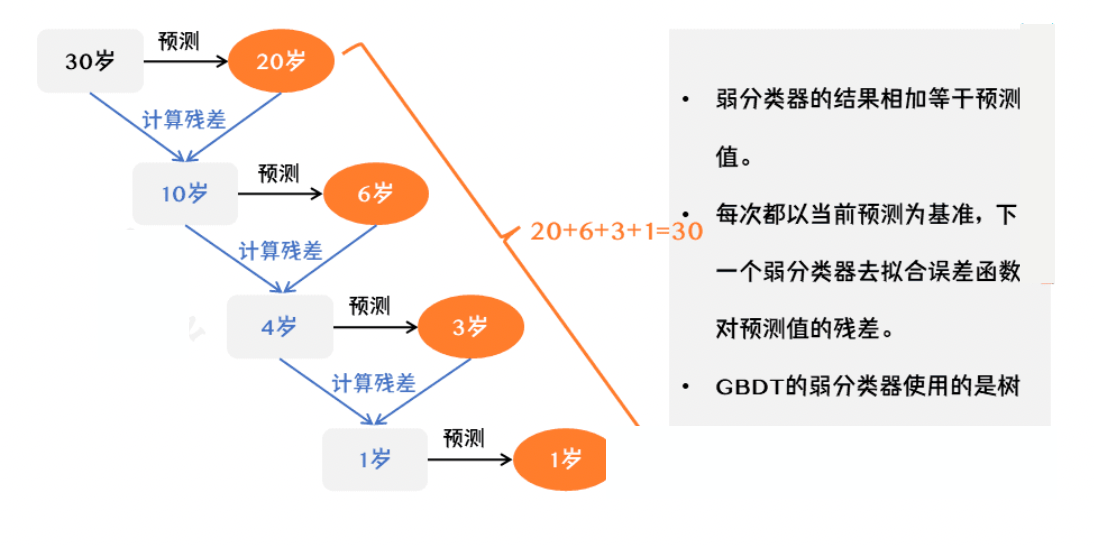
如图是一个非常简单的帮助理解的示例,我们用 GBDT 去预测年龄:
第一个弱分类器(第一棵树)预测一个年龄(如20岁;
第二棵树预测拟合残差,预测值 6,计算发现差距还有 4 岁;
第三棵树继续预测拟合残差,预测值 3,发现差距只有1 岁了;
第四棵树用 1 岁拟合剩下的残差,完成。
最终,四棵树的结论加起来,得到 30岁 这个标注答案(实际工程实现里,GBDT 是计算负梯度,用负梯度近似残差)。