大模型的强化学习思想
https://zhuanlan.zhihu.com/p/721073733
一、强化学习概述
1.1 强化学习整体流程
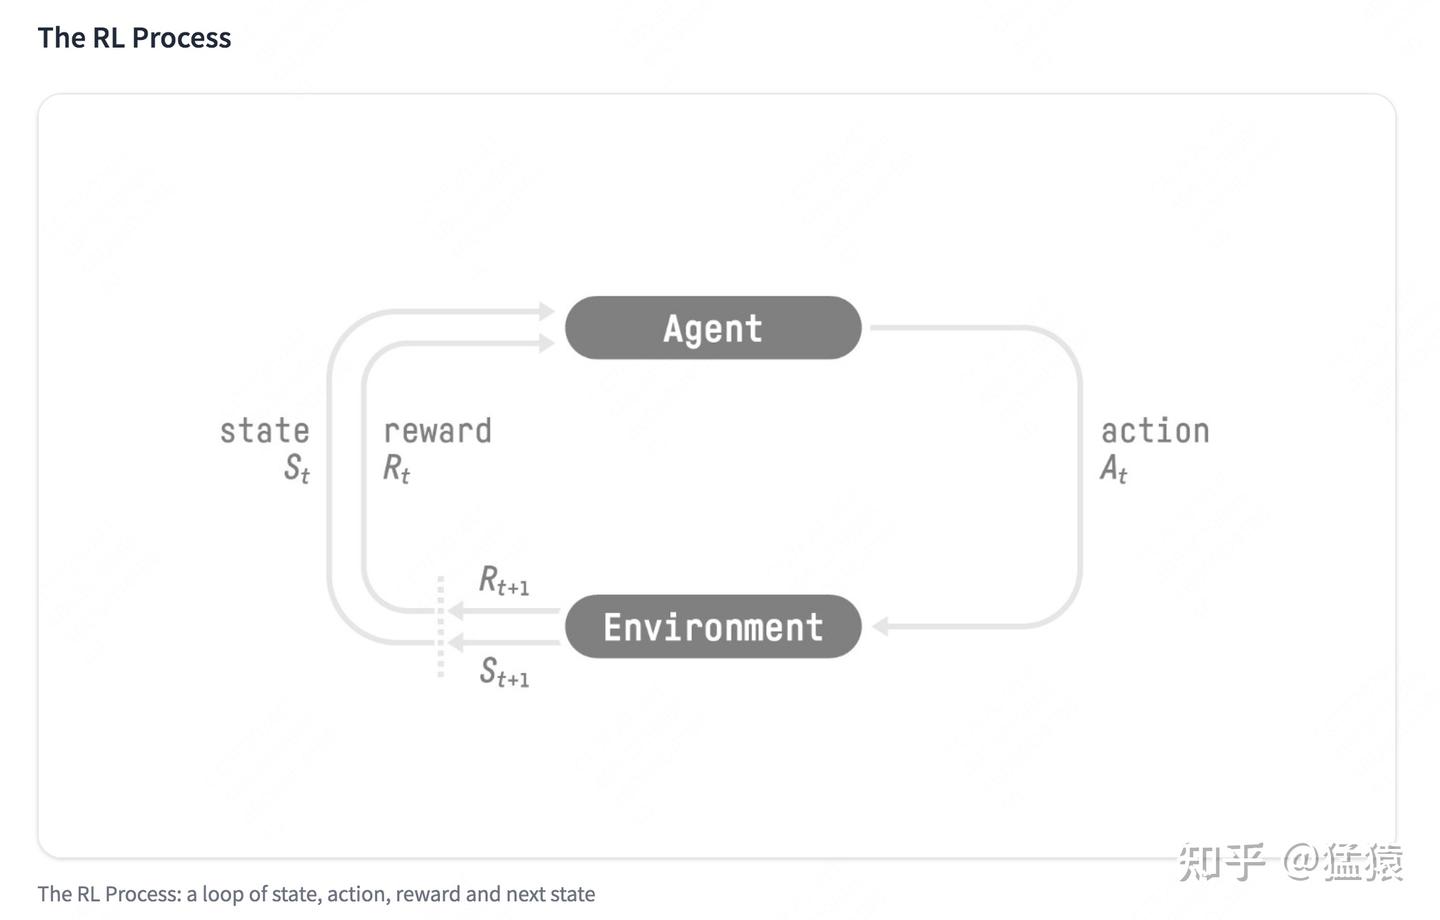
强化学习的两个实体:智能体(Agent)与环境(Environment)
强化学习中两个实体的交互:
- 状态空间S:S即为State,指环境中所有可能状态的集合
- 动作空间A:A即为Action,指智能体所有可能动作的集合
- 奖励R:R即为Reward,指智能体在环境的某一状态下所获得的奖励。
以上图为例,智能体与环境的交互过程如下:
- 在 t 时刻,环境的状态为 St ,达到这一状态所获得的奖励为 Rt
- 智能体观测到 St 与 Rt ,采取相应动作 At
- 智能体采取 At 后,环境状态变为 St+1 ,得到相应的奖励 Rt+1
智能体在这个过程中学习,它的最终目标是:找到一个策略,这个策略根据当前观测到的环境状态和奖励反馈,来选择最佳的动作。
1.2 价值函数
在1.1中,我们谈到了奖励值 Rt ,它表示环境进入状态 St 下的即时奖励。 但如果只考虑即时奖励,目光似乎太短浅了:当下的状态和动作会影响到未来的状态和动作,进而影响到未来的整体收益。 所以,一种更好的设计方式是:t时刻状态s的总收益 = 身处状态s能带来的即时收益 + 从状态s出发后能带来的未来收益。写成表达式就是:
Vt=Rt+γVt+1
其中:
- Vt : t 时刻的总收益,注意这个收益蕴涵了“即时”和“未来”的概念
- Rt : t 时刻的即时收益
- Vt+1 : t+1 时刻的总收益,注意这个收益蕴涵了“即时”和“未来”的概念。而 Vt+1 对 Vt 来说就是“未来”。
- γ :折扣因子。它决定了我们在多大程度上考虑将“未来收益”纳入“当下收益”。
注:在这里,我们不展开讨论RL中关于价值函数的一系列假设与推导,而是直接给出一个便于理解的简化结果,方便没有RL背景的朋友能倾注更多在“PPO策略具体怎么做”及“对PPO的直觉理解”上。
二、NLP中的强化学习
我们在第一部分介绍了通用强化学习的流程,那么我们要怎么把这个流程对应到NLP任务中呢?换句话说,NLP任务中的智能体、环境、状态、动作等等,都是指什么呢?
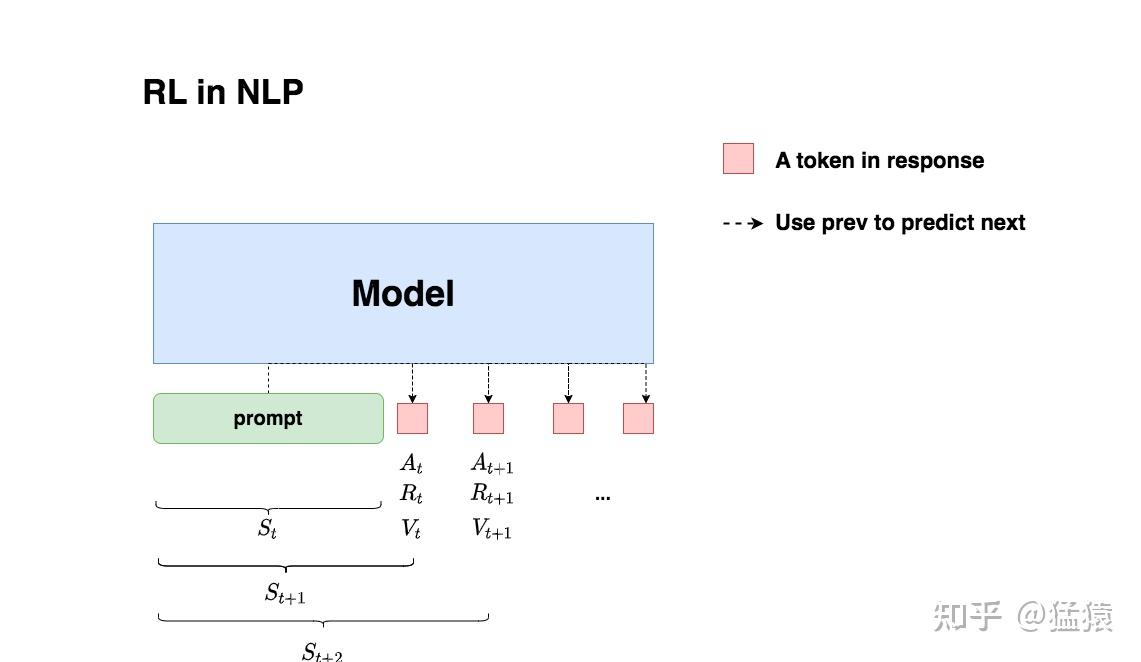
回想一下我们对NLP任务做强化学习(RLHF)的目的:我们希望给模型一个prompt,让模型能生成符合人类喜好的response。再回想一下gpt模型做推理的过程:每个时刻 t 只产生一个token,即token是一个一个蹦出来的,先有上一个token,再有下一个token。
复习了这两点,现在我们可以更好解读上面这张图了:
- 我们先喂给模型一个prompt,期望它能产出符合人类喜好的response
- 在 t 时刻,模型根据上文,产出一个token,这个token即对应着强化学习中的动作,我们记为At 。因此不难理解,在NLP语境下,强化学习任务的动作空间就对应着词表。
- 在 t 时刻,模型产出token At对应着的即时收益为Rt,总收益为Vt(复习一下, Vt 蕴含着“即时收益”与“未来收益”两个内容)。这个收益即可以理解为“对人类喜好的衡量”。此刻,模型的状态从St变为St+1,也就是从“上文”变成“上文 + 新产出的token”
- 在NLP语境下,智能体是语言模型本身,环境则对应着它产出的语料
这样,我们就大致解释了NLP语境下的强化学习框架,不过针对上面这张图,你可能还有以下问题:
(1)问题1:图中的下标是不是写得不太对?例如根据第一部分的介绍, At 应该对应着 Rt+1 , At+1 应该对应着 Rt+2 ,以此类推? 答:你说的对。但这里我们不用太纠结下标的问题,只需要记住在对应的response token位置,会产生相应的即时奖励和总收益即可。之所以用图中这样的下标,是更方便我们后续理解代码。
(2)问题2:我知道 At 肯定是由语言模型产生的,那么 ,Rt,Vt 是怎么来的呢,也是语言模型产生的吗? 答:先直接说结论, At 是由我们的语言模型产生的, ,Rt,Vt 则分别由另外两个模型来产生,在后文中我们会细说。
(3)问题3:语言模型的参数在什么时候更新?是观测到一个 Rt,Vt ,就更新一次参数,然后再去产生 At+1 吗? 答:当然不是。你只看到某个时刻的收益,就急着用它更新模型,这也太莽撞了。我们肯定是要等有足够的观测数据了(例如等模型把完整的response生成完),再去更新它的参数。这一点我们也放在后文细说。
(4)问题4:再谈谈 Rt,Vt 吧,在NLP的语境下我还是不太理解它们 答:
- 首先,“收益”的含义是“对人类喜好的衡量”
- Rt :即时收益,指语言模型当下产生token At 带来的收益
- Vt : 实际期望总收益(即时+未来),指对语言模型“当下产生token At ,一直到整个response生产结束”后的期收益预估。因为当下语言模型还没产出 At 后的token,所以我们只是对它之后一系列动作的收益做了估计,因而称为“期望总收益”。
三、RLHF中的四个重要角色
本节中,我们在第二部分的基础上更进一步:更详细理清NLP语境下RLHF的运作流程。
我们从第二部分中已经知道:生成token At 和对应收益 Rt,Vt 的并不是一个模型。那么在RLHF中到底有几个模型?他们是怎么配合做训练的?而我们最终要的是哪个模型?
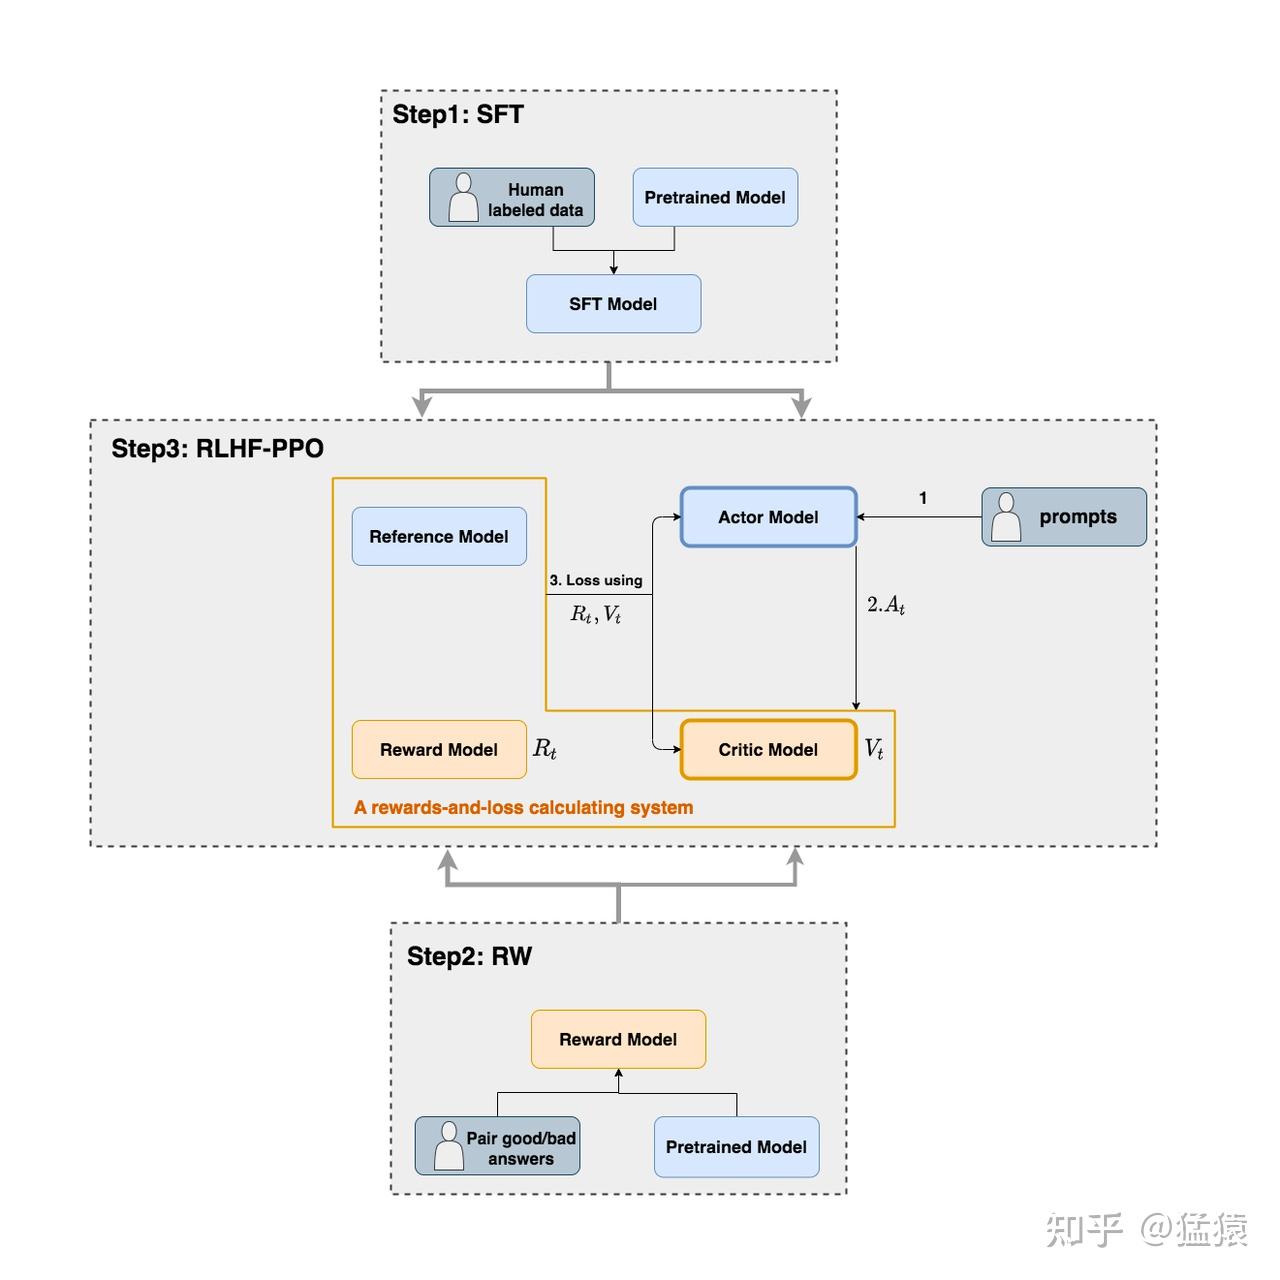
如上图,在RLHF-PPO阶段,一共有四个主要模型,分别是:
- Actor Model:演员模型,这就是我们想要训练的目标语言模型
- Critic Model:评论家模型,它的作用是预估总收益 Vt
- Reward Model:奖励模型,它的作用是计算即时收益 Rt
- Reference Model:参考模型,它的作用是在RLHF阶段给语言模型增加一些“约束”,防止语言模型训歪(朝不受控制的方向更新,效果可能越来越差)
其中:
- Actor/Critic Model在RLHF阶段是需要训练的(图中给这两个模型加了粗边,就是表示这个含义);而Reward/Reference Model是参数冻结的。
- Critic/Reward/Reference Model共同组成了一个“奖励-loss”计算体系(我自己命名的,为了方便理解),我们综合它们的结果计算loss,用于更新Actor和Critic Model
我们把这四个部分展开说说。
3.1 Actor Model (演员模型)
正如前文所说,Actor就是我们想要训练的目标语言模型。我们一般用SFT阶段产出的SFT模型来对它做初始化。
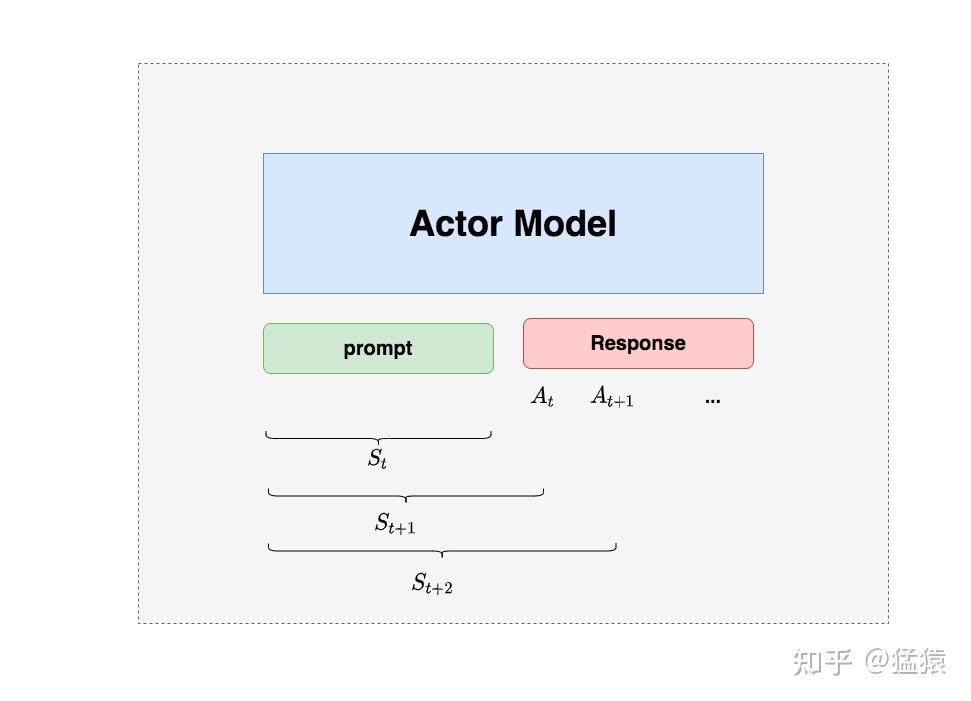
我们的最终目的是让Actor模型能产生符合人类喜好的response。所以我们的策略是,先喂给Actor一条prompt (这里假设batch_size = 1,所以是1条prompt),让它生成对应的response。然后,我们再将“prompt + response"送入我们的“奖励-loss”计算体系中去算得最后的loss,用于更新actor。
3.2 Reference Model(参考模型)
Reference Model(以下简称Ref模型)一般也用SFT阶段得到的SFT模型做初始化,在训练过程中,它的参数是冻结的。Ref模型的主要作用是防止Actor”训歪”,那么它具体是怎么做到这一点的呢?
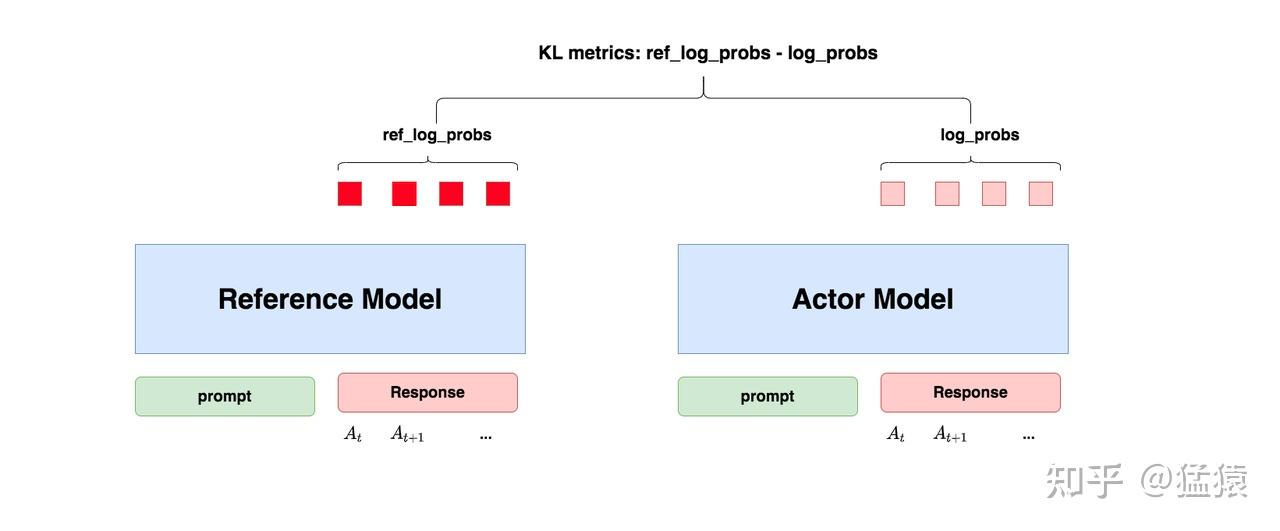
“防止模型训歪”换一个更详细的解释是:我们希望训练出来的Actor模型既能达到符合人类喜好的目的,又尽量让它和SFT模型不要差异太大。简言之,我们希望两个模型的输出分布尽量相似。那什么指标能用来衡量输出分布的相似度呢?我们自然而然想到了KL散度。
如图所示:
对Actor模型,我们喂给它一个prompt,它正常输出对应的response。那么response中每一个token肯定有它对应的log_prob结果呀,我们把这样的结果记为log_probs
对Ref模型,我们把Actor生成的"prompt + response"喂给它,那么它同样能给出每个token的log_prob结果,我们记其为ref_log_probs
那么这两个模型的输出分布相似度就可以用ref_log_probs - log_probs来衡量,我们可以从两个方面来理解这个公式:
- 从直觉上理解,ref_log_probs越高,说明Ref模型对Actor模型输出的肯定性越大。即Ref模型也认为,对于某个 St ,输出某个 At 的概率也很高( P(At|St) )。这时可以认为Actor模型较Ref模型没有训歪
- 从KL散度上理解, KL[Actor(X)||Ref(X)]=Ex∼Actor(x)[logActor(x)Ref(x)]=log_probs−ref_log_probs (当然这里不是严格的等于,只是KL散度的近似),这个值越小意味着两个分布的相似性越高。
注:你可能已经注意到,按照KL散度的定义,这里写成log_probs - ref_log_probs更合适一些。但是如果你看过一些rlhf相关的论文的话,你可能记得在计算损失函数时,有一项 散度Rt−KL散度 (对这个有疑惑不要紧,我们马上在后文细说),即KL散度前带了负号,所以这里我写成ref_log_probs - log_probs这样的形式,更方便大家从直觉上理解这个公式。
现在,我们已经知道怎么利用Ref模型和KL散度来防止Actor训歪了。KL散度将在后续被用于loss的计算,我们在后文中会详细解释。
3.3 Critic Model(评论家模型)
Critic Model用于预测期望总收益 Vt ,和Actor模型一样,它需要做参数更新。实践中,Critic Model的设计和初始化方式也有很多种,例如和Actor共享部分参数、从RW阶段的Reward Model初始化而来等等。我们讲解时,和deepspeed-chat的实现保持一致:从RW阶段的Reward Model初始化而来。
你可能想问:训练Actor模型我能理解,但我还是不明白,为什么要单独训练一个Critic模型用于预测收益呢? 这是因为,当我们在前文讨论总收益 Vt (即时 + 未来)时,我们是站在上帝视角的,也就是这个 Vt 就是客观存在的、真正的总收益。但是我们在训练模型时,就没有这个上帝视角加成了,也就是在 t 时刻,我们给不出客观存在的总收益 Vt ,我们只能训练一个模型去预测它。
所以总结来说,在RLHF中,我们不仅要训练模型生成符合人类喜好的内容的能力(Actor),也要提升模型对人类喜好量化判断的能力(Critic)。这就是Critic模型存在的意义。我们来看看它的大致架构:
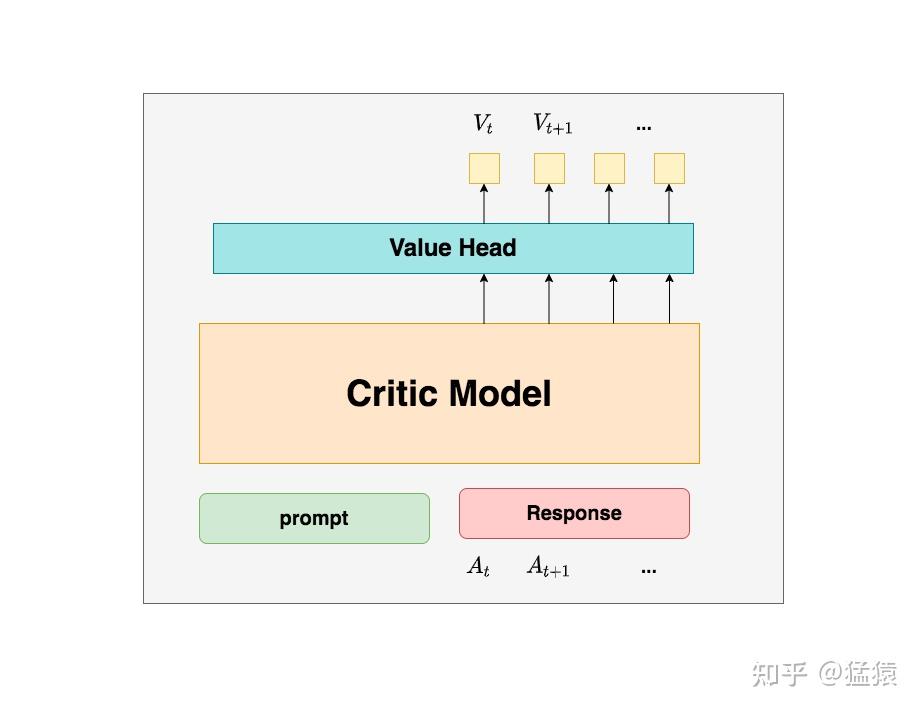
deepspeed-chat采用了Reward模型作为它的初始化,所以这里我们也按Reward模型的架构来简单画画它。你可以简单理解成,Reward/Critic模型和Actor模型的架构是很相似的(毕竟输入都一样),同时,它在最后一层增加了一个Value Head层,该层是个简单的线形层,用于将原始输出结果映射成单一的 Vt 值。
在图中, Vt 表示Critic模型对 t 时刻及未来(response完成)的收益预估。
3.4 Reward Model(奖励模型)
Reward Model用于计算生成token At 的即时收益,它就是RW阶段所训练的奖励模型,在RLHF过程中,它的参数是冻结的。
你可能想问:为什么Critic模型要参与训练,而同样是和收益相关的Reward模型的参数就可以冻结呢? 这是因为,Reward模型是站在上帝视角的。这个上帝视角有两层含义:
- 第一点,Reward模型是经过和“估算收益”相关的训练的,因此在RLHF阶段它可以直接被当作一个能产生客观值的模型。
- 第二点,Reward模型代表的含义就是“即时收益”,你的token At 已经产生,因此即时收益自然可以立刻算出。
你还可能想问:我已经用Critic预测出 Vt 了,而这个 Vt 包含了“即时”和“未来”的概念,那我还需要代表“即时”的 Rt 做什么呢?直接用 Vt 不就好了吗?
为了解答这个问题,我们先回顾下1.2部分中给出的价值函数: Vt=Rt+γVt+1 这个函数告诉我们,我们当前可以用两个结果来表示 t 时刻的总收益:
- 结果1:Critic模型预测的 Vt
- 结果2:Reward模型预测的 Rt 和critic模型预测的 Vt+1
那么哪一个结果更靠近上帝视角给出的客观值呢?当然是结果2,因为结果1全靠预测,而结果2中的 Rt 是事实数据。 我们知道Critic模型也是参与参数更新的,我们可以用MSE(上帝视角的客观收益-Critic模型预测的收益)来衡量它的loss。但是上帝视角的客观收益我们是不知道的,只能用已知事实数据去逼近它,所以我们就用 Rt+γ∗Vt+1 来做近似。这就是 Rt,Vt 同时存在的意义
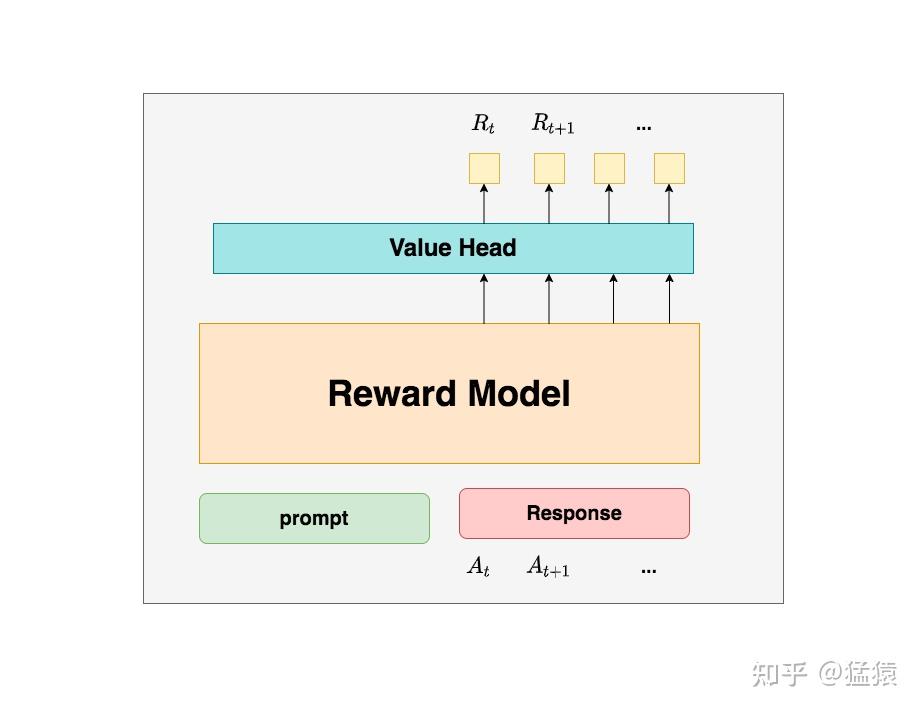
Reward模型和critic模型非常相似,这里我们就只给出架构图,不再做过多的说明。关于Reward模型的训练过程,后续有时间也会出个原理和代码解析。
四、RLHF中的loss计算
到目前为止,我们已经基本了解了RLHF的训练框架,以及其中的四个重要角色(训练一个RLHF,有4个模型在硬件上跑,可想而知对存储的压力)。在本节中,我们一起来解读RLHF的loss计算方式。在解读中,我们会再一次理一遍RLHF的整体训练过程,填补相关细节。在这之后,我们就可以来看代码解析了。
在第三部分的讲解中,我们知道Actor和Critic模型都会做参数更新,所以我们的loss也分成2个:
- Actor loss:用于评估Actor是否产生了符合人类喜好的结果,将作用于Actor的BWD上。
- Critic loss:用于评估Critic是否正确预测了人类的喜好,将作用于Critic的BWD上。
我们详细来看这两者。
4.1 Actor loss
(1)直观设计
我们先来看一个直观的loss设计方式:
- Actor接收到当前上文 St ,产出token At ( P(At|St) )
- Critic根据 St,At ,产出对总收益的预测 Vt
- 那么Actor loss可以设计为: actor_loss=−∑t∈response_timestepVtlogP(At|St)
求和符号表示我们只考虑response部分所有token的loss,为了表达简便,我们先把这个求和符号略去(下文也是同理),也就是说:
actor_loss=−VtlogP(At|St)
我们希望minimize这个actor_loss。
这个设计的直观解释是:
- 当 Vt>0 时,意味着Critic对Actor当前采取的动作给了正向反馈,因此我们就需要在训练迭代中提高 P(At|St) ,这样就能达到减小loss的作用。
- 当 Vt<0 时,意味着Critic对Actor当前采取的动作给了负向反馈,因此我们就需要在训练迭代中降低 P(At|St) ,这样就能到达到减小loss的作用。
一句话总结:这个loss设计的含义是,对上文 St 而言,如果token At 产生的收益较高,那就增大它出现的概率,否则降低它出现的概率。
(2)引入优势(Advantage)
在开始讲解之前,我们举个小例子: 假设在王者中,中路想支援发育路,这时中路有两种选择:1. 走自家野区。2. 走大龙路。 中路选择走大龙路,当她做出这个决定后,Critic告诉她可以收1个人头。结果,此刻对面打野正在自家采灵芝,对面也没有什么苟草英雄,中路一路直上,最终收割2个人头。 因为实际收割的人头比预期要多1个,中路尝到了甜头,所以她增大了“支援发育路走大龙路”的概率。 这个多出来的“甜头”,就叫做“优势”(Advantage)。
对NLP任务来说,如果Critic对 At 的总收益预测为 Vt ,但实际执行 At 后的总收益是 Rt+γ∗Vt+1 ,我们就定义优势为:
Advt=Rt+γ∗Vt+1−Vt
我们用 Advt 替换掉 Vt ,则此刻actor_loss变为: actor_loss=−AdvtlogP(At|St)
(3)重新设计 Rt
总结一下,到目前为止,我们的actor_loss形式为:
actor_loss=−AdvtlogP(At|St)
其中, Advt=Rt+γ∗Vt+1−Vt 同时注意,这个actor_loss应该是response的所有token loss的sum或者avg。这里为了表达方便,我们的公式略去了求和或求平均的符号。
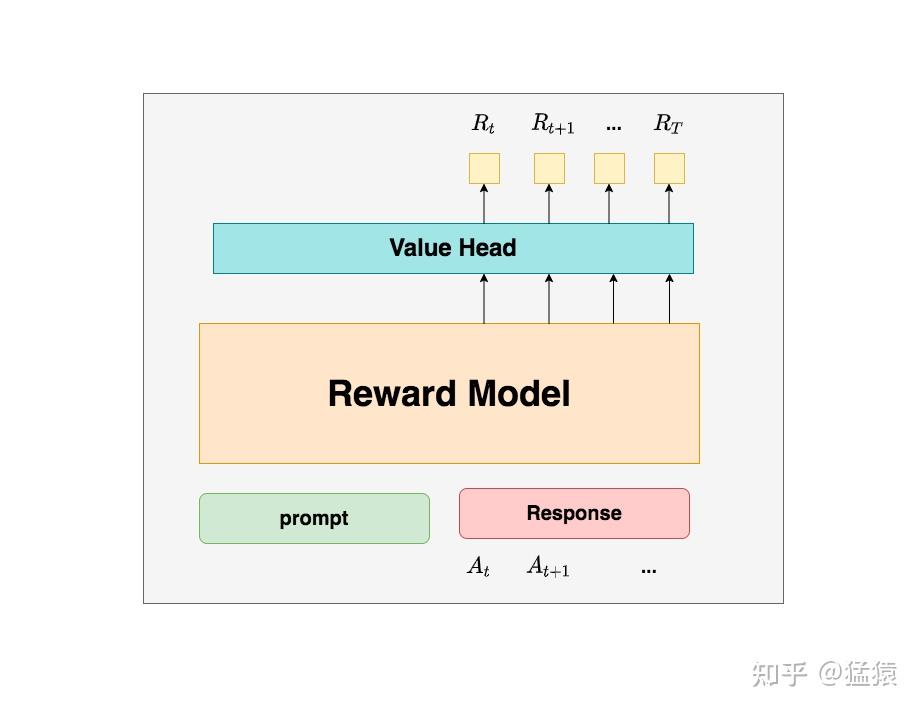
按照这个理解, Rt 应该表示每个Actor产出token At 带来的即时收益,正如下图所示(其中 T 表示最后一个时刻):
但在deepspeed-chat的RLHF实践中,对 Rt 做了另一种设计:
{Rt=−kl_ctl∗(logP(At|St)Pref(At|St)),t≠TRt=−kl_ctl∗(logP(At|St)Pref(At|St))+Rt,t=T
- kl_ctl :常量,可以理解成是一个控制比例的缩放因子,在deepspeed-chat中默认设为0.1
- −logP(At|St)Pref(At|St) :这一项你是不是非常眼熟,这就是我们在3.2部分介绍的Actor和Ref模型间的KL散度呀,写成更容易理解的形式,就是
ref_log_probs - log_probs。在3.2中我们说过,为了防止模型训歪,我们需要把这个KL散度加入loss计算中,所以这里我们就在做这件事
基于这些,上面这个对 Rt 的设计可理解成:
- 当t≠T时,我们更加关心Actor是否有在Ref的约束下生产token At
- 当$ t=T时,我们不仅关心Actor是否遵从了Ref的约束,也关心真正的即时收益Rt
为什么只有最后一个时刻的 Rt 被纳入了考量呢?这是因为在Reward模型训练阶段,就是用这个位置的 Rt 来表示对完整的prompt + response的奖励预测(但不妨碍你理解成是执行完 AT 的即时奖励),然后用这个指标来做模型eval的(但是Reward训练阶段算loss时,还是考虑了response部分所有token输出的reward值)。所以到了RLHF的场景下,其余时刻的即时奖励,我们就用“Actor是否遵循了Ref的约束”来进行评价。
需要注意的是, Rt 的设计并不只有这一种。deepspeed在自己的代码注释中也有提过,可以尝试把最后一个时刻的 RT 替换成所有token的即时奖励的平均值。如果站在这个角度理解的话,我们同样也可以尝试在每一个位置的奖励衡量上引入 Rt 。
代码实践如下:
def compute_rewards(self, prompts, log_probs, ref_log_probs, reward_score,
                        action_mask):
        """
        reward_function:计算最终的reward分数
        复习一下几个相关参数的默认值:
        self.kl_ctl = 0.1
        self.clip_reward_value = 5

        对于batch中的某个prompt来说,它最终的reward分数为:
        (1) 先计算actor和ref_model的logit相似度: -self.kl_ctl * (log_probs - ref_log_probs)
            其实写成self.kl_ctl * (ref_log_probs - log_probs)更好理解些
            这个值越大,说明ref_model对actor生成的结果的认可度越高(即表明rlhf没有训歪),
            没有训歪的情况下我们也应该给模型一些奖励,这个奖励就是self.kl_ctl * (ref_log_probs - log_probs)

        (2)由于我们只取最后一个token对应位置的分数作为reward_score,因此我们只需要:
            self.kl_ctl * (ref_log_probs - log_probs)的最后一位 + reward_score

         (3) 同时我们对reward_score也做了大小限制,最大不超过self.clip_reward_value(超过统一给成self.clip_reward_value),
             最小不低于-self.clip_reward_value(低于统一给成-self.clip_reward_value)

         (4) 最后返回的rewards大小为:(batch_size, 各条数据的长度),对batch中的每条数据来说:
             - response的最后一位:self.kl_ctl * (ref_log_probs - log_probs)的最后一位 + reward_score
             - response的其余位置:self.kl_ctl * (ref_log_probs - log_probs)

        """

        kl_divergence_estimate = -self.kl_ctl * (log_probs - ref_log_probs)
        rewards = kl_divergence_estimate
        # ---------------------------------------------------------------------------------------------------
        # response开始的位置
        # (因为我们对prompt做过padding处理,因此batch中每个prompt长度一致,也就意味着每个response开始的位置一致)
        # (所以这里start是不加s的,只是一个int)
        # ---------------------------------------------------------------------------------------------------
        start = prompts.shape[1] - 1
        # ---------------------------------------------------------------------------------------------------
        # response结束的位置
        # (因为一个batch中,每个response的长度不一样,所以response的结束位置也不一样)
        # (所以这里end是加s的,ends的尺寸是(batch_size,)
        # ---------------------------------------------------------------------------------------------------
        ends = start + action_mask[:, start:].sum(1) + 1
        # ---------------------------------------------------------------------------------------------------
        # 对rewards_score做限制
        # ---------------------------------------------------------------------------------------------------
        reward_clip = torch.clamp(reward_score, -self.clip_reward_value,
                                  self.clip_reward_value)
        batch_size = log_probs.shape[0]
        for j in range(batch_size):
            rewards[j, start:ends[j]][-1] += reward_clip[j] #

        return rewards
(4)重新设计优势
好,再总结一下,目前为止我们的actor_loss为:
actor_loss=−AdvtlogP(At|St)
其中, Advt=Rt+γ∗Vt+1−Vt 同时,我们对 Rt 进行来改造,使其能够衡量Actor模型是否遵从了Ref模型的约束。
现在我们把改造焦点放在 Advt 上,回想一下,既然对于收益而言,分为即时和未来,那么对于优势而言,是不是也能引入对未来优势的考量呢?这样,我们就可以把 Advt 改写成如下形式:
Advt=(Rt+γ∗Vt+1−Vt)+γ∗λ∗Advt+1
(熟悉强化学习的朋友应该能一眼看出这是GAE,这里我们不打算做复杂的介绍,一切都站在直觉的角度理解) 其中,新引入的 λ 也是一个常量,可将其理解为权衡因子,直觉上看它控制了在计算当前优势时对未来优势的考量。(从强化学习的角度上,它控制了优势估计的方差和偏差)
看到这里,你可能想问:这个代表未来优势的 Advt+1 ,我要怎么算呢? 注意到,对于最后一个时刻 t ,它的未来收益( VT+1 )和未来优势( AdvT+1 )都是0,也就是 AdvT=RT−VT ,这是可以直接算出来的。而有了 AdvT ,我们不就能从后往前,通过动态规划的方法,把所有时刻的优势都依次算出来了吗?
代码实践如下(其中返回值中的returns表示实际收益,将被用于计算Critic模型的loss,可以参见4.2,其余细节都在代码注释中):
 def get_advantages_and_returns(self, values, rewards, start):
        """
        Adopted from https://github.com/CarperAI/trlx/blob/main/trlx/models/modeling_ppo.py#L134

        没有引入GAE前的t时刻的优势值:
        detal_t = r_t + gamma * V_t+1 - V_t
        其中:
            - r_t表示t时刻的即时收益
            - V_t+1表示未来时刻的预期收益
            - r_t + gamma * V_t+1可理解成t时刻的实际预期收益
            - V_t可理解成t时刻的预估预期收益(是模型,例如critic model自己估算出来的)

        引入GAE后的t时刻的优势值:
        A_t = delta_t + gamma * lambda * A_t+1
        粗暴理解为在t时刻时,不仅考虑当下优势,还考虑了未来的优势
        为了知道A_t, 我们得知道A_t+1,所以在本算法中采取了从后往前做动态规划求解的方法,也即:
        假设T是最后一个时刻,则有A_T+1 = 0, 所以有: A_T = delta_T
        知道了A_T, 就可以依次往前倒推,把A_t-1, A_t-2之类都算出来了

        引入GAE后t时刻的实际预期收益
        returns_t = A_t + V_t
                  = delta_t + gamma * lambda * A_t+1 + V_t
                  = r_t + gamma * V_t+1 - V_t + gamma * lambda * A_t+1 + V_t
                  = r_t + gamma * (V_t+1 + lambda * A_t+1)

        注意,这里不管是advantages还是returns,都只算response的部分
        """

        # Adopted from https://github.com/CarperAI/trlx/blob/main/trlx/models/modeling_ppo.py#L134
        lastgaelam = 0
        advantages_reversed = []
        length = rewards.size()[-1]
        # 注意这里用了reversed,是采取从后往前倒推计算的方式
        for t in reversed(range(start, length)):
            nextvalues = values[:, t + 1] if t < length - 1 else 0.0
            delta = rewards[:, t] + self.gamma * nextvalues - values[:, t]
            lastgaelam = delta + self.gamma * self.lam * lastgaelam
            advantages_reversed.append(lastgaelam)
        advantages = torch.stack(advantages_reversed[::-1], dim=1) # 优势
        returns = advantages + values[:, start:] # 实际收益
        # values: 预期收益
        return advantages.detach(), returns
(5)PPO-epoch: 引入新约束
总结一下,目前为止我们的actor_loss为:
actor_loss=−AdvtlogP(At|St)
其中, Advt=(Rt+γ∗Vt+1−Vt)+γ∗λ∗Advt+1
同时
- 我们已经对Rt进行来改造,使其能够衡量Actor模型是否遵从了Ref模型的约束。
- 我们已经对Advt进行改造,使其不仅考虑了当前时刻的优势,还考虑了未来的优势
基于这些改造,我们重新理一遍RLHF-PPO的训练过程。
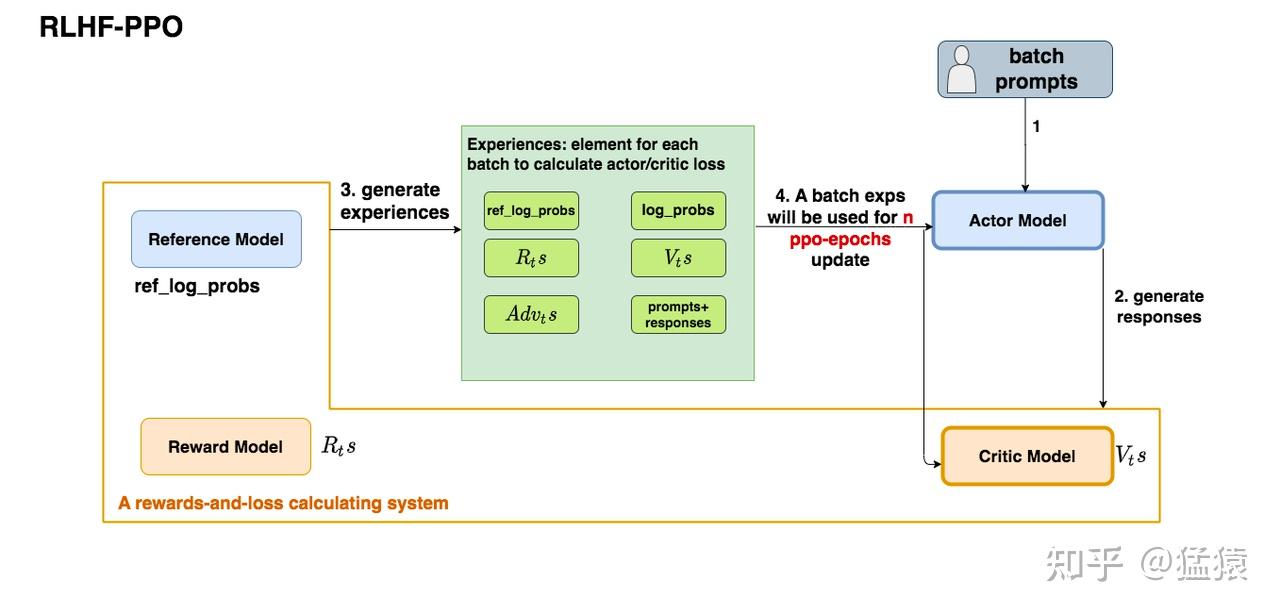
- 第一步,我们准备一个batch的prompts
- 第二步,我们将这个batch的prompts喂给Actor模型,让它生成对应的responses
- 第三步,我们把prompt+responses喂给我们的Critic/Reward/Reference模型,让它生成用于计算actor/critic loss的数据,按照强化学习的术语,我们称这些数据为经验(experiences)。critic loss我们将在后文做详细讲解,目前我们只把目光聚焦到actor loss上
- 第四步,我们根据这些经验,实际计算出actor/critic loss,然后更新Actor和Critic模型
这些步骤都很符合直觉,但是细心的你肯定发现了,文字描述中的第四步和图例中的第四步有差异:图中说,这一个batch的经验值将被用于n次模型更新,这是什么意思呢?
我们知道,在强化学习中,收集一个batch的经验是非常耗时的。对应到我们RLHF的例子中,收集一次经验,它要等四个模型做完推理才可以,正是因此,一个batch的经验,只用于计算1次loss,更新1次Actor和Critic模型,好像有点太浪费了。
所以,我们自然而然想到,1个batch的经验,能不能用来计算ppo-epochs次loss,更新ppo-epochs次Actor和Critic模型?简单写一下伪代码,我们想要:
# --------------------------------------------------------------
# 初始化RLHF中的四个模型
# --------------------------------------------------------------
actor, critic, reward, ref = initialize_models()

# --------------------------------------------------------------
# 训练
# --------------------------------------------------------------
# 对于每一个batch的数据
for i in steps:
    # 先收集经验值
    exps = generate_experience(prompts, actor, critic, reward, ref)
    # 一个batch的经验值将被用于计算ppo_epochs次loss,更新ppo_epochs次模型
    # 这也意味着,当你计算一次新loss时,你用的是更新后的模型
    for j in ppo_epochs:
        actor_loss = cal_actor_loss(exps, actor)
        critic_loss = cal_critic_loss(exps, critic)

        actor.backward(actor_loss)
        actor.step()

        critc.backward(critic_loss)
critic.step()而如果我们想让一个batch的经验值被重复使用ppo_epochs次,等价于我们想要Actor在这个过程中,模拟和环境交互ppo_epochs次。举个例子:
- 如果1个batch的经验值只使用1次,那么在本次更新完后,Actor就吃新的batch,正常和环境交互,产出新的经验值
- 但如果1个batch的经验值被使用ppo_epochs次,在这ppo_epochs中,Actor是不吃任何新数据,不做任何交互的,所以我们只能让Actor“模拟”一下和环境交互的过程,吐出一些新数据出来。
那怎么让Actor模拟呢?很简单,让它观察一下之前的数据长什么样,让它依葫芦画瓢,不就行了吗?我们假设最开始吃batch,吐出经验的actor叫 Actorold ,而在伪代码中,每次做完ppo_epochs而更新的actor叫 Actornew ,那么我们只要尽量保证每次更新后的 Actornew 能模仿最开始的那个 Actorold ,不就行了吗?
诶!是不是很眼熟!两个分布,通过什么方法让它们相近!那当然是KL散度!所以,再回到我们的actor_loss上来,它现在就可被改进成: actor_loss=−AdvtlogP(At|St)Pold(At|St)
我们再稍作一些改动将log去掉(这个其实不是“稍作改动去掉log”的事,是涉及到PPO中重要性采样的相关内容,大家有兴趣可以参考这篇): actor_loss=−Advt∗P(At|St)Pold(At|St)
其中, Pold 表示真正吃了batch,产出经验值的Actor;P表示ppo_epochs中实时迭代更新的Actor,它在模仿 Pold 的行为。所以这个公式从直觉上也可以理解成:在Actor想通过模拟交互的方式,使用一个batch的经验值更新自己时,它需要收到真正吃到batch的那个时刻的Actor的约束,这样才能在有效利用batch,提升训练速度的基础上,保持训练的稳定。
但是,谨慎的你可能此时又有新的担心了:虽然我们在更新Actor的过程中用 Actorold 做了约束,但如果 Actorold 的约束能力不够,比如说 P(At|St)Pold(At|St) 还是超出了可接受的范围,那怎么办?
很简单,那就剪裁(clip)它吧!
我们给 P(At|St)Pold(At|St) 设置一个范围,例如(0.8 ,1.2),也就是如果这个值一旦超过1.2,那就统一变成1.2;一旦小于0.8,那就统一变成0.8。这样就能保证 Actor 和 Actorold 的分布相似性在我们的掌控之内了。此时actor_loss变为:
actor_loss=−min(Advt∗P(At|St)Pold(At|St),Advt∗clip(P(At|St)Pold(At|St),0.8,1.2))
这时要注意,如果超过变化范围,将 P(At|St)Pold(At|St) 强制设定为一个常数后,就说明这一部分的loss和Actor模型无关了,而 Advt 这项本身也与Actor无关。所以相当于,在超过约束范围时,我们停止对Actor模型进行更新。
整体代码如下:
    def actor_loss_fn(self, logprobs, old_logprobs, advantages, mask):
        """
        logprobs: 实时计算的,response部分的prob(只有这个是随着actor实时更新而改变的)
        old_logprobs:老策略中,response部分的prob (这个是固定的,不随actor实时更新而改变)
        advantages: 老策略中,response部分每个token对应的优势(这个是固定的,不随actor实时更新而改变)
        mask:老策略中,response部分对应的mask情况这个是固定的,不随actor实时更新而改变)

        之所以要引入logprobs计算actor_loss,是因为我们不希望策略每次更新的幅度太大,防止模型训歪

        self.cliprange: 默认值是0.2
        """
        ## policy gradient loss
        # -------------------------------------------------------------------------------------
        # 计算新旧策略间的KL散度
        # -------------------------------------------------------------------------------------
        log_ratio = (logprobs - old_logprobs) * mask
        ratio = torch.exp(log_ratio)
        # -------------------------------------------------------------------------------------
        # 计算原始loss和截断loss
        # -------------------------------------------------------------------------------------
        pg_loss1 = -advantages * ratio
        pg_loss2 = -advantages * torch.clamp(ratio, 1.0 - self.cliprange, 1.0 + self.cliprange)
        pg_loss = torch.sum(torch.max(pg_loss1, pg_loss2) * mask) / mask.sum() # 最后是取每个非mask的response token的平均loss作为最终loss
        return pg_loss
(6)Actor loss小结
(1)~(5)中我们一步步树立了actor_loss的改进过程,这里我们就做一个总结吧:
actor_loss=−min(Advt∗P(At|St)Pold(At|St),Advt∗clip(P(At|St)Pold(At|St),0.8,1.2)
其中:
- Advt=(Rt+γ∗Vt+1−Vt)+γ∗λ∗Advt+1
- 我们已经对Rt进行来改造,使其能够衡量Actor模型是否遵从了Ref模型的约束
- 我们已经对Advt进行改造,使其不仅考虑了当前时刻的优势,还考虑了未来的优势
- 我们重复利用了1个batch的数据,使本来只能被用来做1次模型更新的它现在能被用来做ppo_epochs次模型更新。我们使用真正吃了batch,产出经验值的那个时刻的Actor分布来约束ppo_epochs中更新的Actor分布
- 我们考虑了剪裁机制(clip),在ppo_epochs次更新中,一旦Actor的更新幅度超过我们的控制范围,则不对它进行参数更新。
4.2 Critic loss
我们知道,1个batch产出的经验值,不仅被用来更新Actor,还被用来更新Critic。对于Critic loss,我们不再像Actor loss一样给出一个“演变过程”的解读,我们直接来看它最后的设计。
首先,在之前的解说中,你可能有这样一个印象:
- Vt :Critic对t时刻的总收益的预估,这个总收益包含即时和未来的概念(预估收益)
- Rt+γ∗Vt+1 :Reward计算出的即时收益 Rt ,Critic预测出的 t+1 及之后时候的收益的折现,这是比 Vt 更接近t时刻真值总收益的一个值(实际收益)
所以,我们的第一想法是: Critic_loss=(Rt+γ∗Vt+1−Vt)2
现在,我们对“实际收益”和“预估收益”都做一些优化。
(1)实际收益优化
我们原始的实际收益为 Rt+γ∗Vt+1 ,但是当我们在actor_loss中引入“优势”的概念时,“优势”中刻画了更为丰富的实时收益信息,所以,我们将实际收益优化为: Advt+Vt
(2)预估收益优化
我们原始的预估收益为 Vt 。 类比于Actor,Critic模型在ppo_epochs的过程中也是不断更新的。所以这个 Vt 可以理解成是 Criticold ,也就是真正吃了batch,参与产出经验的那个时候的Critic产出的收益预测结果。
我们同样想用旧模型去约束新模型,但对于Critic我们采用的约束策略就比较简单了,我们直接看代码,从中可以看出,我们用老 Vt 设计了了一个变动范围,然后用这个变动范围去约束新 Vt
# self.cliprange_value是一个常量
# old_values: 老critic的预测结果
# values:新critic的预测结果
values_clipped = torch.clamp(
            values,
            old_values - self.cliprange_value,
            old_values + self.cliprange_value,
        )
那么最终我们就取实际收益和预估收益的MSE做为loss就好,这里注意,计算实际收益时 Advt,Vt 都是老Critic(真正吃了batch的那个)产出的结果,而预估收益是随着ppo_epochs而变动的。
代码如下:
def critic_loss_fn(self, values, old_values, returns, mask):
        """
        values: 实时critic跑出来的预估预期收益(是变动的,随着ppo epoch迭代而改变)
        old_values:老critic跑出来的预估预期收益(是固定值)
        returns:实际预期收益
        mask:response部分的mask

        self.cliprange_value = 0.2
        """
        ## value loss
        # 用旧的value去约束新的value
        values_clipped = torch.clamp(
            values,
            old_values - self.cliprange_value,
            old_values + self.cliprange_value,
        )
        if self.compute_fp32_loss:
            values = values.float()
            values_clipped = values_clipped.float()

        # critic模型的loss定义为(预估预期收益-实际预期收益)**2
        vf_loss1 = (values - returns)**2
        vf_loss2 = (values_clipped - returns)**2
        vf_loss = 0.5 * torch.sum(
            torch.max(vf_loss1, vf_loss2) * mask) / mask.sum() # 同样,最后也是把critic loss平均到每个token上
        return vf_loss
LLM 中主流 RLHF 方向分为两大路线:
- 以 PPO 为代表的 On Policy 路线
- 以 DPO 为代表的 Off Policy 路线
那究竟什么是 On Policy,什么是 Off Policy 呢?
我们可以简单理解为:凡是需要 LLM 在训练过程中做 generation 的方法就是 On Policy,反之为 Off Policy。
我们通常会说 On Policy 的方法会更耗卡、训练更耗时,这里的「耗时」主要就体现在模型做「生成」上。
想想看,我们做 SFT 的时候只用给定训练训练数据,模型做一遍 forward 就能算出 loss,然后更新。
但如果训练过程中加入了「模型生成答案」这个环节,那耗时可就长多了,
毕竟对于生成任务而言,模型需要一个 token 一个 token 依次生成,可不慢吗。
不过,虽然慢了些,On Policy 的方法相较于 Off Policy 方法理论有着更高的效果上限,这点我们将在后面分析。
1. On Policy 路线
前面我们提到了,On Policy 的核心思路就是:让模型自己做生成,我们根据模型生成结果的好坏来打分,用于指导模型进行更新。
这里最关键的点是:让模型尝试「自己生成答案」,为什么说这一点很关键呢?
想象一下,如果今天你是一个被训练的模型,你的任务是学会玩王者荣耀。
那么现在有两种训练你的方法:
- 第一种:有一个教练在你旁边,你操作的时候他就在旁边对你的每一个操作给予评价。当你推掉一座塔时,教练夸你很有天赋,当你因为上头结果被对面反杀时,他提醒你下次吸取教训。
- 第二种:不直接让你玩游戏,而是给你一堆职业选手比赛的录像,还有一堆青铜玩家的对局,告诉你职业选手的操作是好的,青铜玩家的操作是不好的,你应该多学习职业玩家的操作,避免青铜玩家的操作。
宇宙免责声明:上述内容仅为例子,不歧视任何青铜玩家,我也青铜水平。
看出来了吗,这两种方法最大的区别就在于:你有没有亲自下场去「玩游戏」。
对于第二种而言,尽管你能看到什么是「好操作」,什么是「坏操作」,但并不是真的每一个操作对你都有帮助。
比如,就算你知道职业选手的操作是好操作,你也打不出来(对你来说太难了);
而青铜玩家的操作,就算不看它你也不会打出那么生疏的操作。
上述两种方法中的「第一种」就是 On Policy 的方法,即需要模型亲自输出答案,然后根据反馈学习;
「第二种」即为 Off Policy 的方法,模型不需要亲自输出答案,根据给定的「好坏样本」来进行模拟学习。
由此我们可以看出,Off Policy 的训练速度能够更快(只用看大量的样本来学习,不用亲自去玩),但非常依赖给定的数据是否和「模型自身能力」足够相近。最理想的效果就是,找到大量和你自身水平差不多的玩家的对局资料给你学习,这些训练样本的利用率才是最高的。
反之,对于 On Policy 而言就不用担心「训练样本是否匹配」的问题,
毕竟所有的训练样本都是当前模型自己吭哧吭哧生成的,百分之百的匹配!
下面,我们就来看看一个完整的 On Policy 的算法都需要哪些组成部分:
rl-01.pngPPO 训练所需要的 4 个模型,通常情况下 4 个模型是一样规模大小的 LLM
上图是一个标准 PPO 所需要的 4 个模型,其中:
- Actor:用于生成句子的模型,也就是正在被训练玩游戏的你。
- Critic:指导你进步的教练模型,注意,这个教练模型也会随着你的进步来调整自己的指导策略。比如,当你很菜的时候,突然打出了一个很强的操作时,会给你一个较高的分数(Vs 较低,因此 r - Vs 就较大,看不懂这句话没关系,我只是尝试证明这个例子的存在一定合理性),当你本身比较强了,再打出同样操作的时候给的奖励就没有之前那么高。因此,训练过程中 Critic 是和 Actor 一起训练的。
- Reward Model:用于给出最终分数的模型。虽然教练能够给你一定的指导,但最终游戏获胜与否还是要靠裁判说了算,可以说教练在教你的同时也在尝试学习裁判的偏好。裁判一般是固定的,因此 Reward Model 在整个训练过程中参数是被冻结的。
- Reference Model:这是 PPO 在 LLM 中独有的概念,目的是为了让 actor 不要训练偏离太远,主要是缓解 reward hacking + 稳定训练使用的。
通常来讲,这 4 个模型都是同样规模参数的模型,
也就是说,如果我们选用 llama3-70B 作为训练模型的话,整个训练过程中我们需要同时载入 70 x 4 = 280B 的参数,这当中有 70 x 2 = 140B 的参数需要进行训练,这就是为什么 PPO 非常耗卡的原因。
于是,针对 PPO 耗卡且训练慢的特点,就涌现出一系列的工作尝试解决该问题。
1.1 ReMax
ReMax 认为,我们可以丢掉 Critic(教练),Actor 不再需要受到 Critic 的指导,而是直接去对齐 RM(裁判),
这样一来,我们就只用载入 3 个模型,3 x 70 = 210B,并且只有 70B 的参数在学习(省了一半)。
其实,在 PPO 之前,最早是没有 Critic 的(Policy Gradient,我在上一篇文章有讲到),
我们只让 actor 去生成行为,然后利用所有行为共同获得分数来训练模型,
但是,因为每一个行为(对应生成句子中的每一个 token)都是一个随机变量,
N 个随机变量加在一起,方差就会非常巨大,这通常会导致整个 RL 训练崩掉。
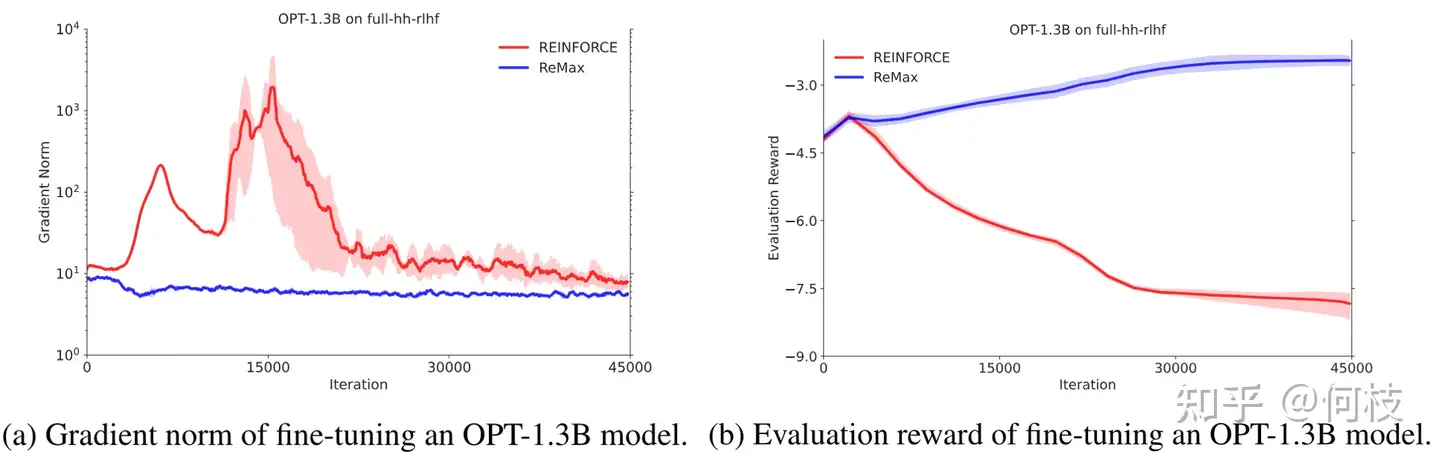
Remax 中给的例子,图中的 REINFROCE 即为 N 个随机变量直接相加的方法
从上述图中可以看到:
图左红线是随机变量直接叠加的方法,训练时梯度方差特别大,
对应到图右,训练没几步 reward 就开始崩溃,预示着训练失败。
为了解决这个问题,我们可以让每一个随机变量都减掉一个 baseline,这样就可以降低方差,稳定训练。
那么这个 baseline 如何得到呢?
一种很直觉的想法是:我们随机采样 N 次,将这 N 次采样结果的得分「求均值」并作为 baseline,
但这个方法的缺陷也很明显,只有当 N 足够大时,方差才能足够小。
对此,PPO 的处理方式是:使用一个神经网络 Critic 去拟合这个均值(而不是直接叠加),从而减小方差。
而 ReMax 的思路就比较有趣:使用「当前策略」认为最好的行为来当作 baseline 值。
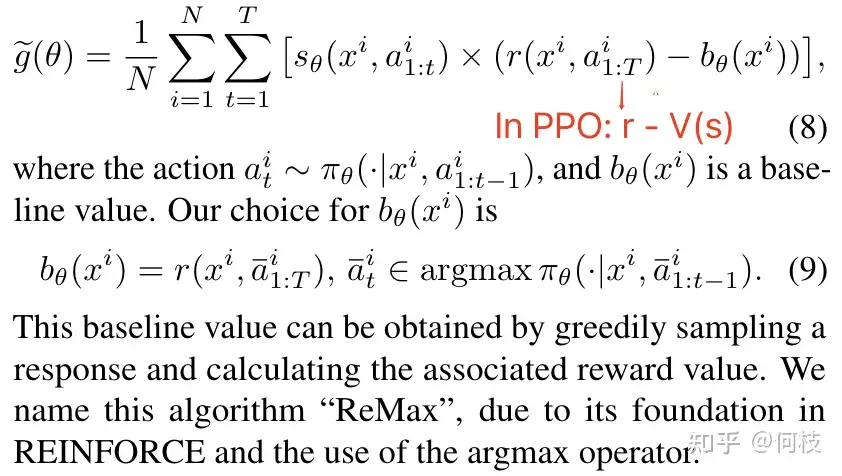
ReMax 计算 gradient 的函数
可以看到,在 PPO 中我们计算 actor 分数时是: r−V(s)r - V(s) ,而在 ReMax 中变成了: r−rgreedyr - r_{greedy} 。
其中,r(greedy) 是指对于一个 prompt,LLM 在 greedy sample 的情况下生成一个句子,该句子的得分。
PS:通常情况下我们在 On Policy 训练过程中,LLM 在做 generate 的时会采用 top_p = 1.0, top_k = -1 的采样方式,以增强模型的探索。
使用 greedy 策略生成句子的得分做为 basline,这之所以能够降低方差,
是默认认为通常 SFT 模型已经经过一部分对齐,对于同一个 prompt 模型不太会输出差异性过大的答案。
这样看来,ReMax 优化思路也很直觉:模型每次只需要和当前 greedy 策略下进行比较,当这次「探索」的句子的得分大于 greedy 策略生成的句子,那么就鼓励模型朝着这次探索的句子分布进化。于是,很有可能在下一次 greedy 采样时,当前被探索出来的优秀答案就能被采出。
除此之外,ReMax 最大的优势是在于:它丢掉了一个巨大的 Critic 网络。
因此,在只有 4 张 A800-80G 的情况下,ReMax 也能在不使用 offload 的情况下训练 [Llama-7B]。
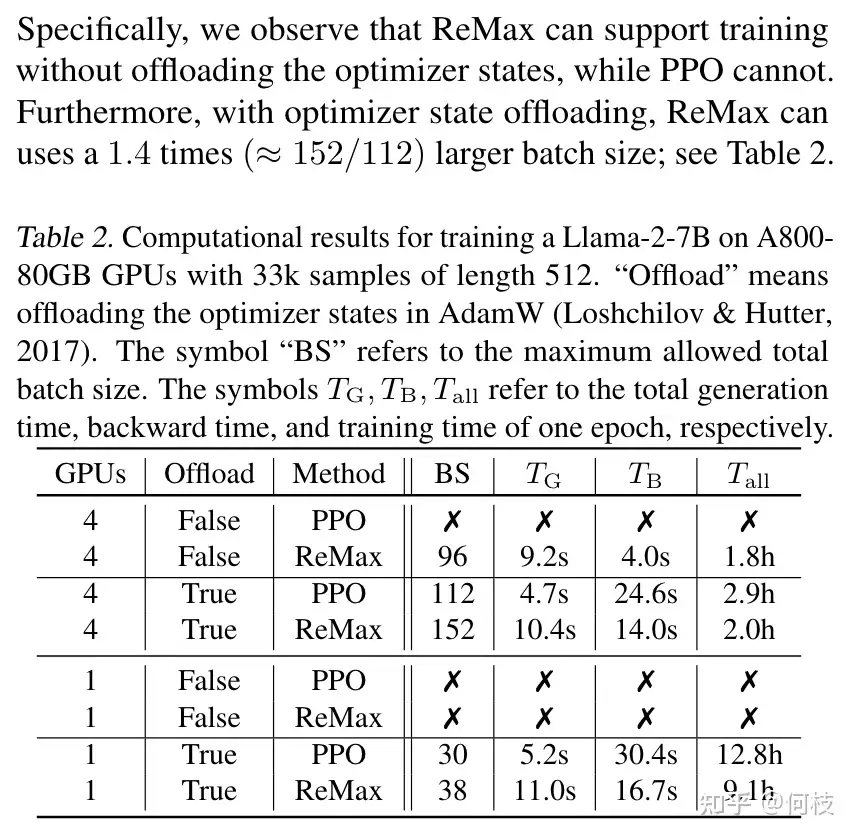
PPO v.s. ReMax,在 4 卡不使用 offload 时,PPO 跑不起来,ReMax 可以,并且 ReMax 不用更新 Critic,backward 也能更快一些
训练一步的时间对比如下:
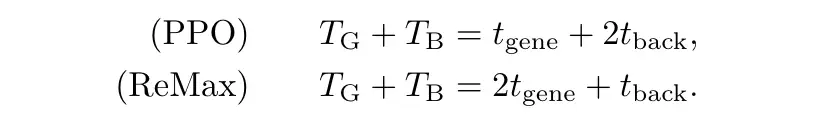
PPO v.s. ReMax 单步训练时间
PPO 只用做一次 generation,需要更新 2 次参数(actor + critic);
ReMax 需要做两次 generation(训练 sample 1 次 + greedy sample 1 次),需要更新 1 次参数(actor)。
PS:论文中讨论的 PPO 是 actor 和 critic 串行 backward 的情况,事实上由于 actor 和 critic 的 loss 是没有相互依赖的,通常我们可以做成异步更新,其实也就只有 1 个 t_back。
源码 中计算 loss 的部分如下:
def compute_loss(self, inputs):
    prompts = inputs["prompts"]
    log_probs = inputs["logprobs"]
    ref_log_probs = inputs["ref_logprobs"]
    reward_score = inputs["rewards"]
    baseline_reward_score = inputs["baseline_rewards"]
    attention_mask = inputs["attention_mask"]
    seq = inputs["input_ids"]

    start = prompts.size()[-1] - 1
    action_mask = attention_mask[:, 1:]

    with torch.no_grad():
        kl_divergence = -(log_probs - ref_log_probs)
        kl_divergence = self.kl_ctl * kl_divergence

        reward_score = reward_score - baseline_reward_score         # 真实 reward
        returns, kl_ratio = self.compute_returns(
            prompts, kl_divergence, reward_score, action_mask
        )

    # process the new outputs
    batch = {"input_ids": seq, "attention_mask": attention_mask}
    logits = self.actor_model(**batch, use_cache=False).logits
    log_probs = gather_log_probs(logits[:, :-1, :], seq[:, 1:])

    actor_loss = self.actor_loss_fn(
        log_probs[:, start:], returns[:, start:], action_mask[:, start:]
    )
    return actor_loss, returns[:, start:], kl_ratio


# reward & basline_reward_score 计算如下:
seq = self._generate_sequence(
    self.actor_model,
    prompts,
    ...
)
baseline_seq = self._generate_sequence(
    self.actor_model,
    prompts,
    ...
    do_sample=False,
)
reward_score = self.reward_model.forward_value(
    seq, action_mask, prompt_length=self.prompt_length
)
baseline_reward_score = self.reward_model.forward_value(
    baseline_seq, baseline_action_mask, prompt_length=self.prompt_length
)
1.2 Group Relative Policy Optimization(GRPO)
在 ReMax 中我们提到:使用一种好的方法来计算 baseline 是丢掉 Critic 网络的关键。
在 DeepSpeek-v2 的 RLHF 过程中,这个思路也有被使用,
不过计算 baseline 的方式稍有不同,文章中将其称为 GRPO。
GRPO 认为,直接退化为 Policy Gradient 是不是有点过于原始,
虽然天下苦 Critic 久矣,PPO 中其他先进 features 咱们还是可以保留的:比如 importance sampling 和 clip。
于是,整个优化目标就变成这样:
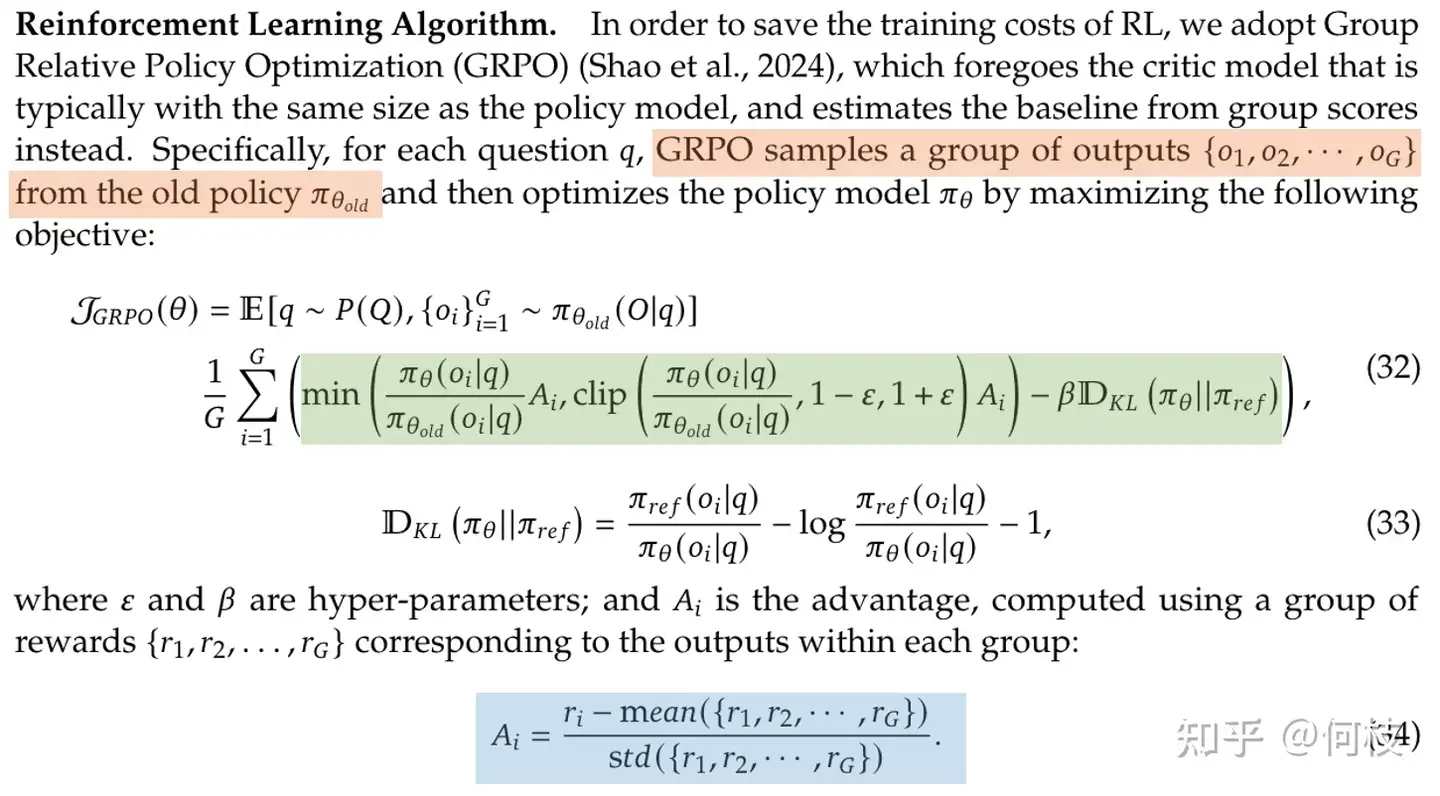
GRPO 的优化目标(绿色部分)和 PPO 几乎完全一样(只是 Advantage 的计算方式变了)
上图中绿色部分是不是非常眼熟,这不就是 PPO 的优化目标嘛。
但现在的问题是:公式中的 AiA_i 在 PPO 中是需要通过 Critic 去参与计算的( r+Vsnext−Vsr + V_{s_{next}} - V_{s} ),可是GRPO 里没有 Critic 啊,这咋计算!
我们回想一下:Critic 的目标是去估计一个状态的期望值(从而降低方差),而期望的近义词是均值,
那我们直接暴力的去采样 N 次求均值来代替这个期望不就好了!
没错,这就是 GRPO 暴力且有效的方法:
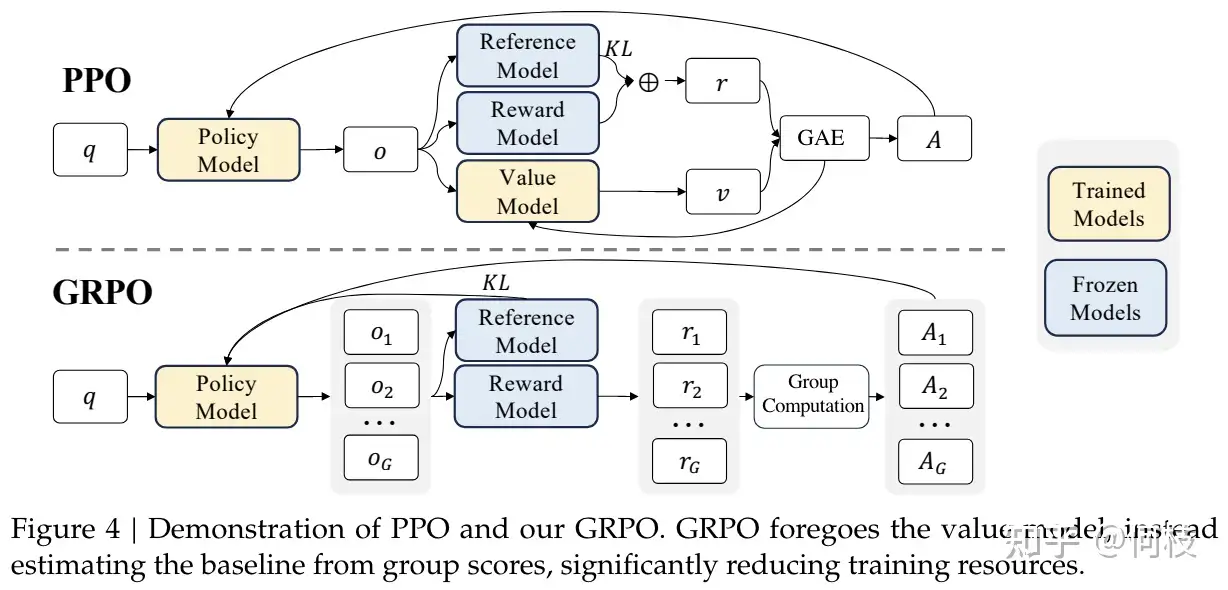
PPO v.s. GRPO,对于同一个 prompt 采 G 个答案,平均 G 个答案的得分当作 baseline
这里有几个值得注意的细节:
- GRPO 中也加入了 KL Penalty,只不过不像 PPO 的实现是每个 token 位置上加一个惩罚,而是直接一并计算完后加到最后的 loss 中去。
- KL Penalty 使用 Schulman 近似值 用以保证 KL 始终为正数,即: ratio−1−logratioratio - 1 - logratio 。
- 句子的最终得分为: Ai=ri−mean(r)std(r)A_i = \frac{r_i - mean(r)}{std(r)} ,由于在 LLM 里我们通常将 GAE 中的 γ\gamma 设置为 1.0,因此在这里 GRPO 也直接将这个最终得分复制到句子中的每一个 token 上进行训练。
尽管这种方法确实可以省掉一个 Critic,但成功需要具备 2 个关键:
- SFT 对给定的 prompt 不能有着太 diverse 的输出,否则方差会比较大。
- 对同一个 prmopt 采样的数量要可能大,这样才能降低方差。
我推测这可能是论文选择在「数学任务」上使用这种方式进行训练的原因。
2. Offline 路线
尽管人们一直在尝试使用各种方法来降低训练门槛, Online 的方法依然有着不小的资源 & 人力需求量,
就算砍掉一个 Critic,至少还需要 Actor & Reference & Reward Model 3 个模型。
有没有什么办法我们只使用 1 个模型就能完成 RLHF,就和 SFT 训练一样呢?
还真有。
还记得最早我们举的「学王者荣耀」的例子吗,有一种训练方法是:
不用你亲自下场玩游戏,而是给你一堆「好操作」和「坏操作」的视频给你,你从里面尽可能的去学习「好操作」,避免「坏操作」。这种通过看别人的操作学习,既不需要教练(Critic),也不需要裁判(Reward Model),只需要你一个人(Actor)自己看就行了,这不就剩资源了吗。
2.1 Direct Preference Optimization(DPO)
DPO 就是第一个使用这种方法来进行 RLHF 的算法,
其思路很直觉:对于同一个 propmt,给定一个好的回答 ywy_w 和一个不好的回答 yly_l,通过降低不好回答被采样的概率,提升好回答的概率,从而进行模型训练。这个数据和训练 Reward Model 的 pair 数据格式完全一致,都是同一个 prompt 对应两个不同质量的 responses。
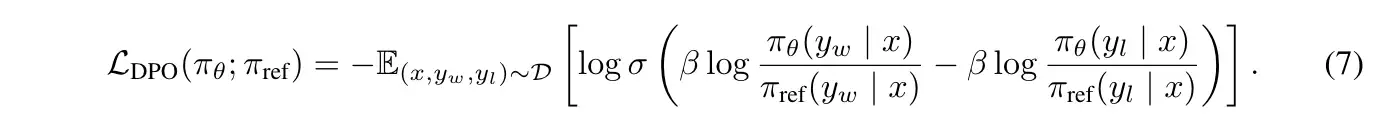
DPO 的 loss function
源码 中计算 loss 的部分:
def dpo_loss(
        self,
        policy_chosen_logps,
        policy_rejected_logps,
        reference_chosen_logps,
        reference_rejected_logps,
    ):
        """Compute the DPO loss for a batch of policy and reference model log probabilities.

        Args:
            policy_chosen_logps: Log probabilities of the policy model for the chosen responses. Shape: (batch_size,)
            policy_rejected_logps: Log probabilities of the policy model for the rejected responses. Shape: (batch_size,)
            reference_chosen_logps: Log probabilities of the reference model for the chosen responses. Shape: (batch_size,)
            reference_rejected_logps: Log probabilities of the reference model for the rejected responses. Shape: (batch_size,)
        """
        pi_logratios = policy_chosen_logps - policy_rejected_logps
        ref_logratios = reference_chosen_logps - reference_rejected_logps

        pi_logratios = pi_logratios.to(self.accelerator.device)
        ref_logratios = ref_logratios.to(self.accelerator.device)
        logits = pi_logratios - ref_logratios

        losses = -F.logsigmoid(self.beta * logits)
        return losses
2.2 Fixing Failure Modes of Preference Optimisation with DPO-Positive(DPOP)
DPO 有一个非常致命的问题,
由于 DPO 的训练 loss 目标是「尽可能最大化好答案和坏答案之间的采样概率差」,
一种常见的情况是:好答案 & 坏答案被采样的概率同时在变低,只不过坏答案降低的比好答案更多。
这样一来,虽然好坏答案之间的概率差变大了,但这个过程中「好答案」被采样的概率也降低了,
这并不是我们想要的!
这种情况在 chosen 和 rejected 答案有大部分内容相同,仅有少部分内容不同时较为常见。
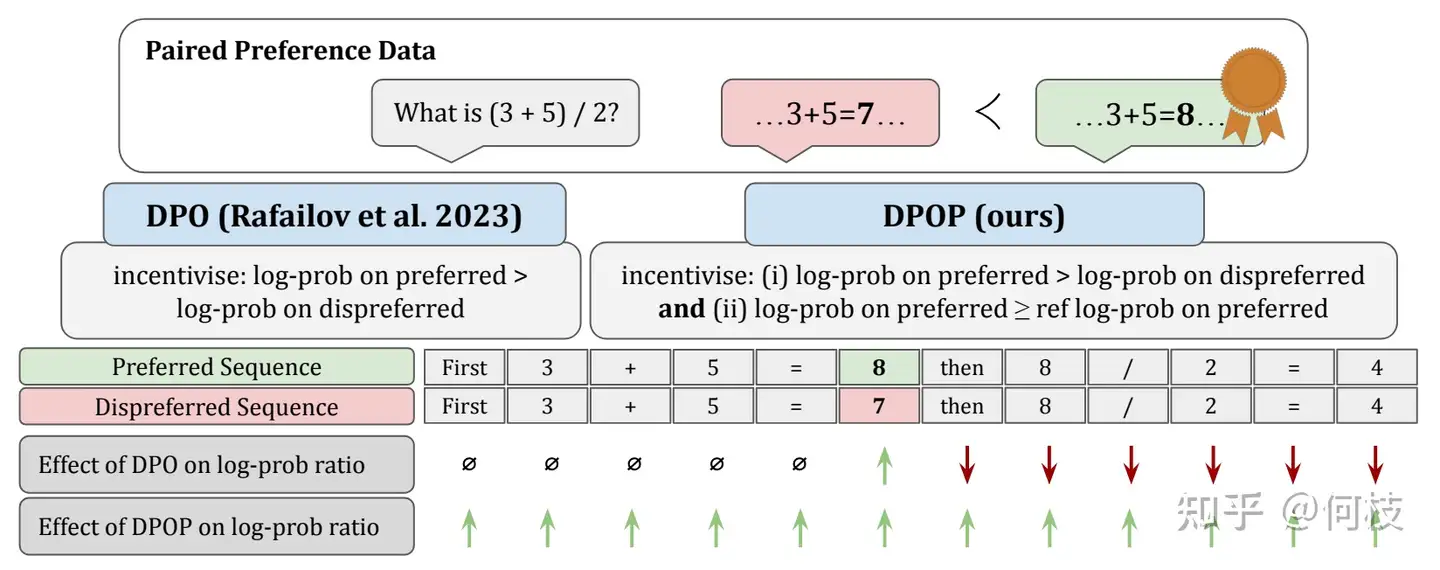
好答案 / 坏答案只差了一个 token,但是作为坏的答案,then 之后的正确部分在 DPO 训练过程中也将被降低采样概率
为此,DPOP 在 DPO loss 的基础上加入了一个正则项:
- 若当前 chosen 答案在 SFT 模型中采样概率 > 当前 Policy 模型的采样概率,则减去一个正则化系数(当前的 chosen 答案 policy 还没有拟好,别再更新那么猛了);
- 若当前 chosen 答案在 Policy 模型中采样概率更高,证明 Policy 已经对这个 chosen 答案拟合的比较充分了,此时着重降低一下坏答案的采样概率。
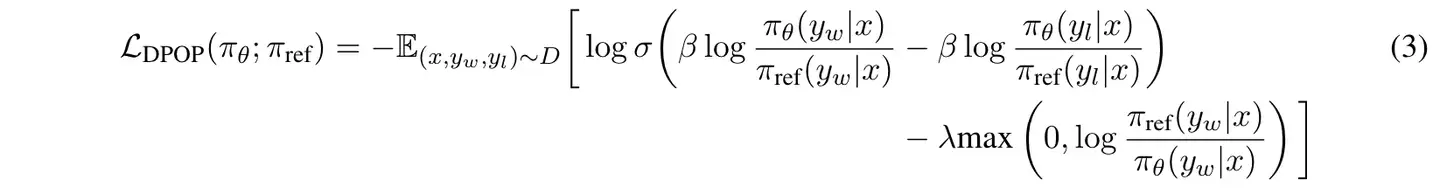
DPOP loss function,尾巴上添加一个正则化项
使用这种方法,相当于在「好答案」和「坏答案」中添加了一个截断式的 “attention”,让模型优先学会 chosen 答案,当对好答案学的足够好时再着重考虑惩罚坏答案,从而降低 DPO 模型 “训崩” 的可能性,最起码也要不弱于单拿 chosen 数据出来做 SFT 的效果。
2.3 Token-level Direct Preference Optimization(TDPO)
在 PPO 训练的时候,我们通常会加上 KL 惩罚来约束模型不要偏离 reference model 过远,
但在 DPO 的实现中却没有并没有添加这一项。
TDPO 提出了这一改进,在原来的 DPO loss 上新增了 kl 惩罚项:
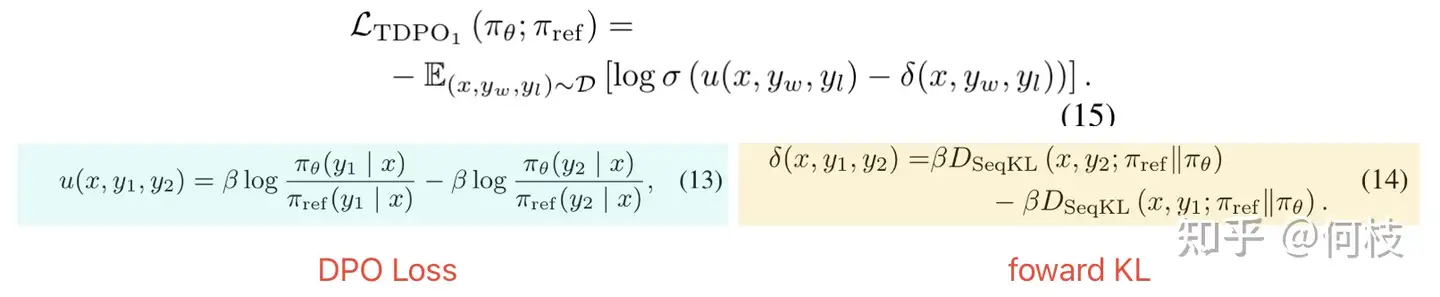
TDPO loss function,在尾部加了一个 KL 惩罚
不过,不同于 PPO 中使用 backward KL,TDPO 则是使用 forward KL 来计算 KL 惩罚,
因为 KL 是一个非对称的距离函数,所谓 forward 和 backward 其意思就是「以 SFT 计算采样概率」还是「以 Policy Model 计算采样概率」。
在 源码 中我们能更直观的看到 forward KL 的计算方式:
vocab_logps = logits.log_softmax(-1)

reference_vocab_ps = reference_logits.softmax(-1)
reference_vocab_logps = reference_vocab_ps.log()

# forward kl 计算
# backward kl (PPO) 应为: vocab_logps - reference_vocab_logps
per_position_kl = (reference_vocab_ps * (reference_vocab_logps - vocab_logps)).sum(-1)
per_token_logps = torch.gather(vocab_logps, dim=2, index=labels.unsqueeze(2)).squeeze(2)
per_reference_token_logps = torch.gather(reference_vocab_logps, dim=2, index=labels.unsqueeze(2)).squeeze(2)
由于 backward KL 的目标是拟合整个分布中的「一部分」,而 forward KL 的目标是尽可能 cover 整个分布中的大部分。因此,TDPO 训练后的模型会比 PPO 训练后的模型,在输出多样性上更加自由。
PS:经过 PPO 后的模型基本一眼就能看出来,输出风格都非常一致,因为此时输出分布已经「聚集」到一个局部分布上了,reward 方差会比 SFT 小很多。
完成 loss 函数如下:
def tdpo_loss(
        chosen_logps_margin,
        rejected_logps_margin,
        chosen_position_kl,
        rejected_position_kl,
        beta: float,
        alpha: float = 0.5,
        if_tdpo2: bool = True
    ):
    """Compute the TDPO loss for a batch of policy and reference model log probabilities.

    Args:
        chosen_logps_margin: The difference of log probabilities between the policy model and the reference model for the chosen responses. Shape: (batch_size,)
        rejected_logps_margin: The difference of log probabilities between the policy model and the reference model for the rejected responses. Shape: (batch_size,)
        chosen_position_kl: The difference of sequential kl divergence between the policy model and the reference model for the chosen responses. Shape: (batch_size,)
        rejected_position_kl: The difference of sequential kl divergence between the policy model and the reference model for the rejected responses. Shape: (batch_size,)
        beta: Temperature parameter for the TDPO loss, typically something in the range of 0.1 to 0.5. We ignore the reference model as beta -> 0.
        alpha: Temperature parameter for the TDPO loss, used to adjust the impact of sequential kl divergence.
        if_tdpo2: Determine whether to use method TDPO2, default is True; if False, then use method TDPO1.
    """
    chosen_values = chosen_logps_margin + chosen_position_kl
    rejected_values = rejected_logps_margin + rejected_position_kl
    chosen_rejected_logps_margin = chosen_logps_margin - rejected_logps_margin

    if not if_tdpo2:
        logits = chosen_rejected_logps_margin - (rejected_position_kl - chosen_position_kl)    # tdpo1
    else:
        logits = chosen_rejected_logps_margin - alpha * (rejected_position_kl - chosen_position_kl.detach())  # tdpo2
    losses = -F.logsigmoid(beta * logits)

    chosen_rewards = beta * chosen_values.detach()
    rejected_rewards = beta * rejected_values.detach()

    return losses, chosen_rewards, rejected_rewards
2.4 Monolithic Preference Optimization without Reference Model(ORPO)
上述一系列类 DPO 的方法已经将 RLHF 的训练成本从 4 个模型砍到 2 个,
在这种情况下,咱们还能再省吗?
当然!说到省,现在天猫 618...想多了,我接不到广告。
不管是哪种 DPO,除了 policy model 外,都还有一个 reference model,我们能不能把 ref_model 也干掉。
回想一下,在 DPOP 中,我们使用 ref_model 来保证模型在 chosen 上的概率不要过低,
如果只是为了保证模型能够拟合 chosen 答案,那我们是不是直接把 chosen 答案拿出来做 SFT 就好,
这不就不需要 ref_model 来吗?
ORPO 的目标函数一共由两部分组成(SFT Loss + Odds Ratio Loss):
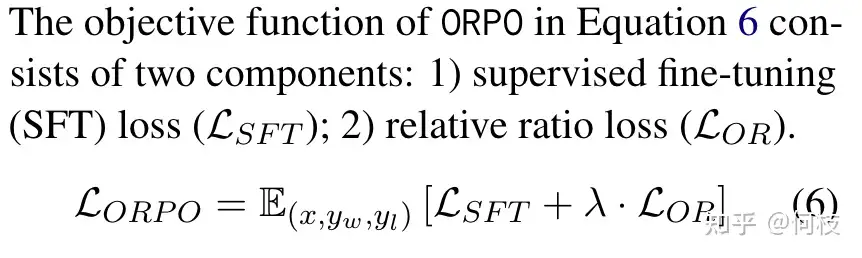
ORPO 的 loss function
其中 SFT Loss 就是拿 chosen 答案算 CrossEntropy Loss,这很好理解,剩下的就是这个 Odds Ratio 是什么。
在统计学和概率论中,odds 指的是「某事件发生与不发生的比例」,
比如,如果一件事情发生的概率是 pp,那么它不发生的概率就是 1−p1 - p,其 odds 计算公式就为:
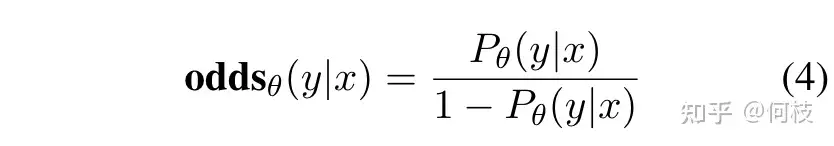
odds 值的计算公式
当一件事情的发生概率越大,其对应的 odds 值就越大。
知道 odds 的概念后,我们再一起上述 loss function 的后半部分 LORL_{OR} 的定义:
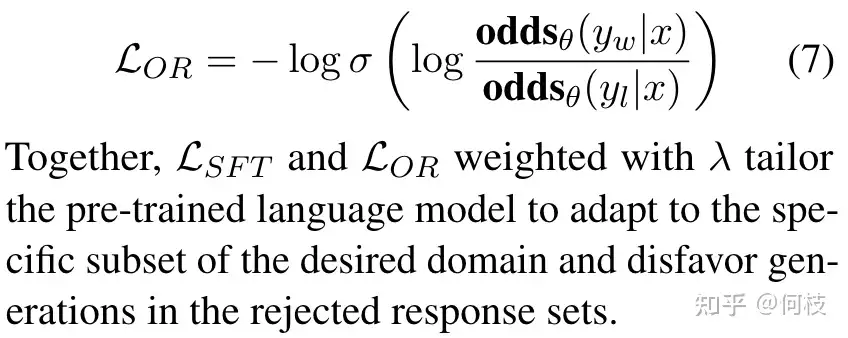
式子中上半部分为「好样本」发生的 odds 值,下半部分为「坏样本」发生的 odds 值
通过 minimize 这个 loss 值,我们就需要 maximize 括号内的值,也就是尽可能的让「好句子」发生的概率增大,「坏句子」发生的概率减小。
由此可见,ORPO 通过定义了一个神奇的 odds 值来提升好样本的概率,降低坏样本的概率,并通过一个 SFT loss 来保证模型对 chosen response 的基本拟合。
源码 中对 odds_ratio 的计算如下:
def odds_ratio_loss(
        self,
        policy_chosen_logps,
        policy_rejected_logps,
    ):
        """Compute ORPO's odds ratio (OR) loss for a batch of policy and reference model log probabilities.

        Args:
            policy_chosen_logps: Log probabilities of the policy model for the chosen responses. Shape: (batch_size,)
            policy_rejected_logps: Log probabilities of the policy model for the rejected responses. Shape: (batch_size,)

        Returns:
            A tuple of three tensors: (losses, chosen_rewards, rejected_rewards).
            The losses tensor contains the ORPO loss for each example in the batch.
            The chosen_rewards and rejected_rewards tensors contain the rewards for the chosen and rejected responses, respectively.
            The log odds ratio of the chosen responses over the rejected responses ratio for logging purposes.
            The `log(sigmoid(log_odds_chosen))` for logging purposes.
        """
        # Derived from Eqs. (4) and (7) from https://arxiv.org/abs/2403.07691 by using
        # log identities and exp(log(P(y|x)) = P(y|x)
        log_odds = (
            policy_chosen_logps - policy_rejected_logps
            ) - (
            torch.log1p(-torch.exp(policy_chosen_logps)) -
            torch.log1p(-torch.exp(policy_rejected_logps))
        )
        sig_ratio = F.sigmoid(log_odds)
        ratio = torch.log(sig_ratio)
        losses = self.beta * ratio
        return losses
好啦,以上就是一些对 RLHF 的介绍啦,其实不管 On Policy 还是 Off Policy,找到适合自己场景的方法才是最重要的,很开心能看到如今百花争鸣的繁荣景象,希望未来会越来越好。