大语言模型介绍
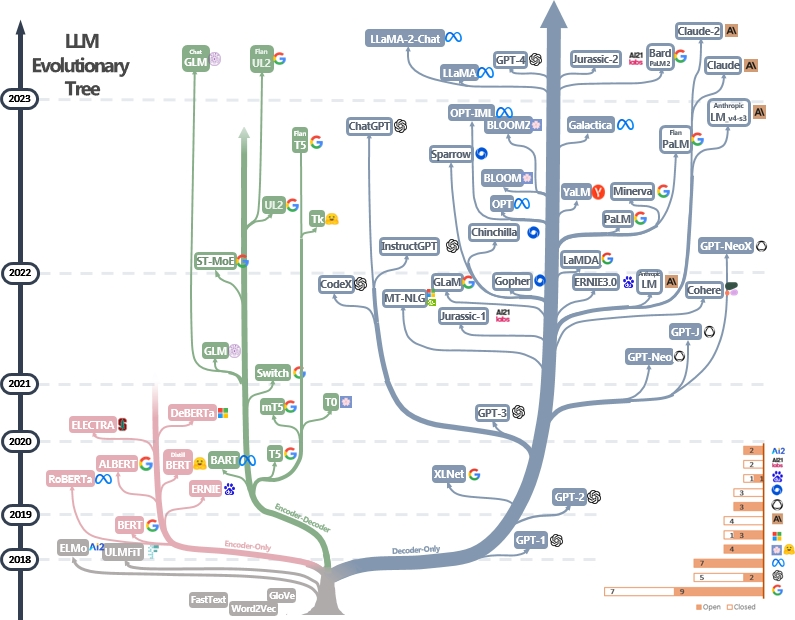
- 大语言模型(Large Language Model,LLM),旨在理解和生成人类语言,处理各种自然语言任务,如文本分类、问答、翻译、对话等等
- 通常,LLM 是指参数量达到数十亿甚至数千亿规模的语言模型(目前主流观点认为超过 10B 的模型即可称为大语言模型)。例如: GPT-3、ChatGPT、GLM、BLOOM、LLaMA
语言模型
- 语言模型(Language Model)旨在建模词汇序列的生成概率,使机器能够模拟人类说话、写作的模式进行自动文本输出。
- 语言模型就是用来计算一个句子的概率
- 核心逻辑:AI 理解语言,靠的是“预测下一个词”
设定场景:让语言模型能够计算某句话是“人话”的概率是多少
- 给定词典
- 要测试的句子 "我在清华学习",
方法一:计数(死记硬背)
假设语言模型读过100万个句子(数据库)
计算 “我在清华学习” 这句话在其中出现的次数,假设有50次,那概率就是 50/1000000
弊端:假设这句话,模型之前没有读过,那它数出来的次数就是 0
概率就直接变为 0,这显然是不合理的
方法二:拆解句子
- 将句子拆开,一段一段地看,如:我、我在、我在清华、我在清华学习
- 链式法则:
- 通过这种方式,只要其中的句子段都有出现过,就能算出一个非零的概率,从而判断出这个句子大概率是一句“人话”
语言模型的 四个阶段(主要类别)
基于规则和统计 的语言模型
N-gram 语言模型
由人工设计特征并使用统计方法对固定长度的文本窗口序列进行建模分析的语言模型
马尔科夫假设:任意一个词出现的概率只与它前面出现的 有限的一个或者几个词 有关
N-gram(N 元模型):当前词的出现概率只与它前面的 个词有关
常用的 N-gram 语言模型
unigram(一元语言模型):如果一个词的出现与它周围的词是独立的
bigram:如果一个词的出现仅依赖于它前面出现的一个词
trigram:如果一个词的出现仅依赖于它前面出现的两个词
特点
优点:
- 采用极大似然估计,参数易训练
- 完全包含了前 n-1 个词的全部信息
- 可解释性强,直观易理解
缺点:
- 只能建模到前 n-1 个词
- 随着 n的增大,参数空间呈指数增长
- 数据稀疏,难免会出现 OOV问题
- 泛化能力差
神经网络 语言模型
神经网络 语言模型
通过数据驱动自动学习词的分布式表示(词向量),并利用非线性网络结构对上下文序列进行端到端建模的语言模型
分布式假设:语义或句法功能相似的词在连续向量空间中距离相近,模型可通过向量空间的连续插值实现语义泛化,而非依赖精确匹配
上下文动态建模:摒弃离散计数与固定窗口限制,利用隐藏层或循环状态动态融合历史信息,输出下一词的条件概率分布
常用的神经网络语言模型
FFNN LM(前馈神经网络语言模型):将前 个词的词向量拼接后输入多层感知机,首次将神经网络引入语言建模,突破传统统计模型的硬性截断
RNN LM(循环神经网络语言模型):利用时序隐藏状态传递历史上下文,理论上可捕捉任意长度的依赖关系
LSTM/GRU LM:在 RNN 基础上引入门控机制(输入/遗忘/输出门或更新/重置门),有效缓解长序列训练中的梯度消失/爆炸问题,显著提升长程依赖建模能力
特点
优点:
- 采用分布式连续表示,有效缓解数据稀疏问题,对未见过的词组合具备强泛化能力
- 突破固定长度窗口限制,能够捕捉长距离上下文依赖与非线性语义关系
- 支持端到端可微训练,易于与子词切分技术(BPE/WordPiece)结合,大幅降低 OOV 影响
缺点:
- 参数量庞大,训练与推理对算力、显存及数据规模要求高
- 内部表征与决策过程缺乏直观可解释性(典型黑盒模型)
- 早期循环结构的时间步依赖导致其难以充分并行化训练;前馈结构仍受限于预设上下文长度,灵活性不足
基于 Transformer 的预训练语言模型
基于 Transformer 的预训练语言模型
- 以 Self-Attention 机制为核心,通过大规模无标注语料进行自监督预训练,学习上下文感知的动态词表示,并支持迁移到下游任务的通用语言建模范式
- 全局依赖建模假设:任意两个词之间的关联强度可通过注意力权重动态计算,无需依赖递归或卷积的局部归纳偏置,实现长距离语义的精准捕捉
- 预训练 + 微调范式:先在通用语料上学习语言通用知识(如掩码预测、下一句预测),再在特定任务数据上进行有监督微调,实现知识的高效迁移
预训练模型的使用方式
- 预训练:在大规模数据集上事先训练神经网络模型,使其学习到通用的特征表示和知识
- 微调:在具体的下游任务中使用预训练好的模型进行迁移学习,以获取更好的泛化效果
常用的 Transformer 预训练语言模型
- BERT 系列(Bidirectional Encoder Representations from Transformers):采用双向 Encoder 架构,通过掩码语言建模(MLM)任务学习上下文融合表示
GPT 系列(Generative Pre-trained Transformer):采用单向 Decoder 架构,基于自回归语言建模目标,擅长文本生成与连贯性建模 $$P(S) = \prod_{t=1}^{n} P(w_t | w_{<t}; \Theta)$$
- Encoder-Decoder 系列(如 T5、BART):融合双向理解与序列生成能力,通过去噪自编码或序列到序列任务预训练,适用于摘要、翻译等生成式任务
特点
优点:
- 自注意力机制支持全局上下文建模,可精准捕捉任意距离的词依赖关系,显著优于局部窗口或循环结构
- 高度并行化计算架构,训练效率远超 RNN/LSTM,支撑千亿参数与万亿 token 级别的超大规模预训练
- 强大的迁移学习与泛化能力,通过预训练知识迁移,在少样本、零样本场景下仍表现优异
- 注意力权重具备一定可解释性,可可视化分析模型对关键上下文的聚焦行为
缺点:
- 自注意力计算复杂度为 ,长序列建模时显存与计算成本陡增,需借助稀疏注意力、分块等优化策略
- 严重依赖海量高质量语料与大规模算力集群,训练门槛高,资源消耗大
- 预训练与下游任务的数据分布差异可能导致领域适配困难,小数据场景易过拟合
- 静态编码模型(如 BERT)难以处理动态生成的长文本,推理延迟较高,实时性场景部署挑战大
大语言模型
大语言模型(通常指大语言模型,Large Language Models, LLMs)
基于 Transformer 架构,以超大规模参数量(百亿至万亿级)、海量多源语料与巨量算力训练而成的通用人工智能基座模型,具备强大的语言理解、生成、推理与跨任务泛化能力
规模效应假设(Scaling Laws):模型性能随参数量、数据量与计算量的增加呈幂律提升,当规模跨越临界阈值时,模型将涌现出小模型不具备的复杂能力
涌现能力(Emergent Abilities):当模型规模达到一定量级后,突然具备的上下文学习(In-Context Learning)、思维链推理(Chain-of-Thought)、指令遵循(Instruction Following)等非显式训练的新能力
常用的 大语言模型
通用基座模型(Base Models):在大规模无标注语料上通过自回归语言建模预训练,具备强大的知识存储与文本续写能力,但缺乏任务对齐
- 代表模型:LLaMA 系列、Qwen、PaLM、Falcon
指令对齐模型(Instruction-Tuned Models):在基座模型基础上,通过有监督微调(SFT)与人类反馈强化学习(RLHF/DPO)对齐人类偏好,支持多轮对话与复杂指令执行
- 代表模型:ChatGPT、Claude、Qwen-Chat、Llama-3-Instruct
多模态大模型(Multimodal LLMs):通过视觉/音频编码器与语言模型的对齐融合,实现图文理解、视觉问答、跨模态生成等能力
- 代表模型:GPT-4V、Qwen-VL、LLaVA、Gemini
特点
优点:
- 强大的零/少样本泛化能力:通过上下文学习(In-Context Learning)无需参数更新即可适配新任务,显著降低数据标注与模型迭代成本
- 复杂的逻辑推理与代码能力:结合思维链(CoT)与工具调用(Tool Use),可完成数学推导、代码生成、多步规划等高阶认知任务
- 统一的多任务建模范式:通过指令微调将分类、生成、抽取等异构任务统一为序列到序列形式,简化系统架构与工程部署
- 持续进化的知识边界:支持通过检索增强(RAG)、持续预训练或在线学习动态更新知识,缓解静态模型的时效性局限
缺点:
- 幻觉与事实一致性风险:模型可能生成看似合理但事实错误的内容,关键场景需结合外部知识库或验证机制进行约束
- 高昂的资源与部署成本:训练需千卡级集群与数月周期,推理需大显存与高带宽,边缘端部署依赖量化、蒸馏等压缩技术
- 安全对齐与伦理挑战:可能复现训练数据中的偏见、有害内容或隐私信息,需通过红队测试、内容过滤与价值对齐持续治理
- 长上下文建模的精度衰减:尽管支持超长窗口(32K~1M+ tokens),但关键信息在极长序列中的定位与利用仍面临"中间丢失"(Lost in the Middle)等挑战
语言模型的 评估指标
Accuracy (准确率): 模型预测正确的样本数量占总样本量的比重
Precision(精确率): 在被识别为正类别的样本中,为正类别的比例
Recall(召回率): 在所有正类别样本中,被正确识别为正类别的比例
BLEU 分数:评估一种语言翻译成另一种语言的文本质量的指标. 它将“质量”的好坏定义为与人类翻译结果的一致性程度
取值范围是[0, 1], 越接近1, 表明翻译质量越好
ROUGE 指标:在机器翻译、自动摘要、问答生成等领域常见的评估指标. ROUGE 通过将模型生成的摘要或者回答与参考答案(一般是人工生成的)进行比较计算,得到对应的得分
PPL:用来度量一个概率分布或概率模型预测样本的好坏程度
PPL越小,标明模型越好
BLEU
评估文本翻译的质量;bleu值范围【0-1】,值越大,翻译质量越好,否则,越差
BLEU 根据
n-gram可以划分成多种评价指标,其中n-gram指的是连续的单词个数为 n,通常n取 1~4,然后对进行加权平均基本步骤:
- 一般基于N-gram指标来计算,所以首先分别去计算生成文本的N-Gram,再计算真实文本的N-Gram,最后统计匹配的个数
- 基于匹配的N-gram个数/生成文本的N-Gram总个数
分别计算 candidate句和 reference句的 N-grams模型,然后统计其匹配的个数,计算匹配度.
假设机器翻译的译文candidate和一个参考翻译reference如下:
候选译文 candidate: It is a nice day today 参考译文 reference: today is a nice day
使用1-gram进行匹配:
candidate: {it, is, a, nice, day, today} reference: {today, is, a, nice, day} 结果:其中{today, is, a, nice, day}匹配,所以匹配度为5/6
使用2-gram进行匹配:
candidate: {it is, is a, a nice, nice day, day today} reference: {today is, is a, a nice, nice day} 结果:其中{is a, a nice, nice day}匹配,所以匹配度为3/5
使用3-gram进行匹配:
candidate: {it is a, is a nice, a nice day, nice day today} reference: {today is a, is a nice, a nice day} 结果:其中{is a nice, a nice day}匹配,所以匹配度为2/4
使用4-gram进行匹配:
candidate: {it is a nice, is a nice day, a nice day today} reference: {today is a nice, is a nice day} 结果:其中{is a nice day}匹配,所以匹配度为1/3
通过上面的例子分析可以发现,匹配的个数越多,BLEU值越大,则说明候选句子更好
但是也会出现下面的极端情况:
candidate: the the the the reference: The cat is standing on the ground 如果按照1-gram的方法进行匹配,则匹配度为1,显然是不合理的
优化方法:
首先,计算一个单词在任意一个参考句子出现的最大次数, 然后用每个(非重复)单词在参考句子中出现的最大次数来修剪--单词在候选句子的出现次数. 如下所示的公式:
其中k表示在候选句子(candidate)中出现的第k个词语, 则代表在候选句子中这个词语出现的次数,而 则代表在参考文本(reference)中这个词语出现的次数.
# pip install nltk
from nltk.translate.bleu_score import sentence_bleu
def cumulative_bleu(reference, candidate):
    # BP*exp(Σ w_n*log(p_n) )
    # - BP = 1, c>=r; exp^{1-r/c}), c<r。   r: 参考文本长度  c: 生成文本长度
    # - w_n = 对应 n-gram 的权重 weights
    # - p_n = Σ min(Count_cand(ngram), max_{ref∈Refs} Count_ref(ngram)) / Σ Count_cand(ngram)
    # BP*exp(1*log(p_1)))
    bleu_1_gram = sentence_bleu(reference, candidate, weights=(1, 0, 0, 0))
    # BP*exp(0.5*log(p_1)) + 0.5*log(p_2))
    bleu_2_gram = sentence_bleu(reference, candidate, weights=(0.5, 0.5, 0, 0))
    # BP*exp(0.33*log(p_1)) + 0.33*log(p_2)) + 0.33*log(p_3))
    bleu_3_gram = sentence_bleu(reference, candidate, weights=(0.33, 0.33, 0.33, 0))
    # BP*exp(0.25*log(p_1)) + 0.25*log(p_2)) + 0.25*log(p_3)) + 0.25*log(p_4))
    bleu_4_gram = sentence_bleu(reference, candidate, weights=(0.25, 0.25, 0.25, 0.25))
    return bleu_1_gram, bleu_2_gram, bleu_3_gram, bleu_4_gram

reference_texts =  [["This", "is",  "a",  "reference", "text"]]  # 参考文本列表
generated_text =  ["This", "is",  "some",  "generated", "text"]  # 生成文本
# 计算 Bleu 指标
c_bleu = cumulative_bleu(reference_texts, generated_text)
print("The Bleu score is:", c_bleu)  # 打印结果
# The Bleu score is: (0.6, 0.3872983346207417, 1.5949011744633917e-102, 9.283142785759642e-155)
ROUGE
- 用来衡量生成结果和标准结果的匹配程度,不同的是ROUGE基于 召回率,BLEU更看重 准确率
- 分为四种方式:ROUGE-N,ROUGE-L,ROUGE-W,ROUGE-S
ROUGE-N:将模型生成的结果和标准结果按N-gram拆分后,计算召回率
假设模型生成的文本candidate和一个参考文本reference如下: candidate: It is a nice day today reference: today is a nice day
使用ROUGE-1进行匹配: candidate: {it, is, a, nice, day, today} reference:
结果:其中{today, is, a, nice, day}匹配,所以匹配度为5/5=1, 这说明生成的内容完全覆盖了参考文本中的所有单词,质量较高.
# pip install rouge
from rouge import Rouge

generated_text = "This is some generated text."  # 生成文本
reference_texts = "This is another generated reference text."  # 参考文本
# 计算 ROUGE 指标
rouge = Rouge()
scores = rouge.get_scores(generated_text, reference_texts)
# 打印结果
print("ROUGE-1 precision:", scores[0]["rouge-1"]["p"])  # precision
print("ROUGE-1 recall:", scores[0]["rouge-1"]["r"])     # recall
print("ROUGE-1 F1 score:", scores[0]["rouge-1"]["f"])   # F1 score
# ROUGE-1 precision: 0.8
# ROUGE-1 recall: 0.6666666666666666
# ROUGE-1 F1 score: 0.7272727223140496
PPL
- 困惑度(perplexity,PPL)用来度量一个概率分布或概率模型预测样本的好坏程度
- 困惑度越低表示模型预测序列概率越高
- 两种方式:
- (实际使用)
import math
# 定义语料库
sentences = [
    ['I', 'have', 'a', 'pen'],
    ['He', 'has', 'a', 'book'],
    ['She', 'has', 'a', 'cat']
]
# 定义语言模型
unigram = {'I': 1/12, 'have': 1/12, 'a': 3/12, 'pen': 1/12,
           'He': 1/12, 'has': 2/12,'book': 1/12,
           'She': 1/12, 'cat': 1/12}

# 计算困惑度
perplexity = 0
# PP(S) = 2^{-\frac{1}{N} \sum \log(P(w_i))}
for sentence in sentences:
    sentence_prob = 1
    for word in sentence:
        sentence_prob *= unigram[word]  # \sum \log(P(w_i)) -> \log(P(w_1)*P(w_2)...)
    temp = -math.log(sentence_prob, 2) / len(sentence)
    perplexity += 2**temp
perplexity = perplexity / len(sentences)

print('困惑度为:', perplexity)
# 困惑度为: 8.150887576576553
思考总结
1. 什么是大语言模型?
答案:指包含数千亿(或更多)参数的语言模型。
2. 语言模型的主要类别是什么?
答案:N-Gram、神经网络、预训练模型、大语言模型。
3. 常用的N-Gram语言模型是什么?
答案:bigram、trigram。
1. 语言模型的评估指标是什么?
答案:Accuracy、Precision、Recall、BLEU、ROUGE、PPL。
2. 怎么理解BLEU指标?
答案:评估一种语言翻译成另一种语言的文本质量的指标。取值范围是[0, 1],越接近1,表明翻译质量越好。
3. 怎么理解ROUGE指标?
答案:ROUGE指标用来衡量生成结果和标准结果的匹配程度,不同的是ROUGE基于召回率,BLEU更看重准确率。
4. 怎么理解PPL指标?
答案:PPL用来度量一个概率分布或概率模型预测样本的好坏程度。
1. 什么是自编码模型?
答案:是在输入中随机MASK掉一部分单词,根据上下文预测这个词。
2. BERT模型的核心架构?
答案:transformer的Encoder模块。
3. BERT的预训练任务?
答案:MLM和NSP。
1. 什么是自回归模型?
答案:从左往右学习的模型,只能利用上文或者下文的信息。
2. GPT模型的核心架构?
答案:transformer的Decoder模块(去除中间的第二个子层)。
3. GPT的预训练任务?
答案:无监督的预训练 和 有监督任务的微调。
1. 什么是序列到序列模型?
答案:同时使用编码器和解码器,它将每个task视作序列到序列的转换/生成。
2. T5模型的核心架构?
答案:transformer架构。
3. T5的预训练任务?
答案:采用了类似于BERT和GPT的大规模自监督学习策略,预训练任务包括两种类型:Causal Language Modeling(因果语言建模)和填空任务(Masked Language Modeling)。
1. LLM主要类别架构?
答案:Encoder-Only、Decoder-Only、Encoder-Decoder。
2. 自编码模型的基本原理?
答案:是在输入中随机MASK掉一部分单词,根据上下文预测这个词。
3. 自回归模型的基本原理?
答案:从左往右学习的模型,只能利用上文或者下文的信息。
4. 序列到序列模型的基本原理?
答案:同时使用编码器和解码器。它将每个task视作序列到序列的转换/生成。
LLM 主要架构
LLM 主要类别
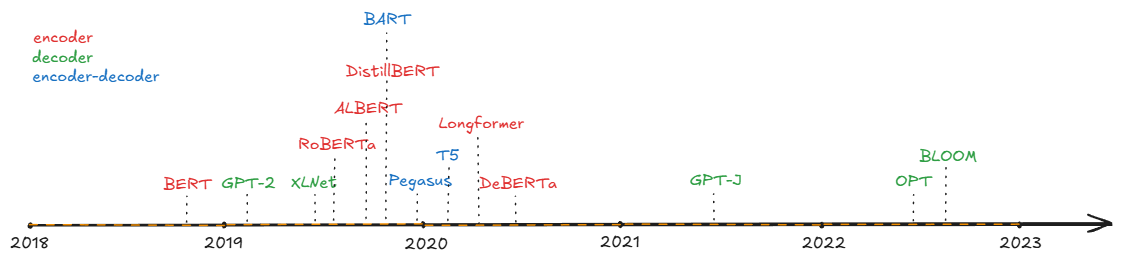
目前主流的LLM 基本都是基于 transformer 架构,LLM一般分为三种:
- 自编码模型 encoder
- 自回归模型 decoder
- 序列到序列模型 encoder-decoder
自编码模型
AutoEncoder model(AE),特点:Encoder-Only
基本原理:在输入中随机 MASK 一部分单词,根据上下文预测这个词
AE 模型通常用于内容理解任务,比如自然语言理解中的分类任务:情感分析、提取式问答
- 优点:使用双向transformer,在自然语言理解(NLU)相关任务中表现很好
- 缺点:输入噪声,预训练-微调 存在差异,不适合自然语言生成(NLG)
代表模型:BERT(Bidirectional Encoder Representation from Transformers)
- 核心架构:双向的 transformer-encoder
- 预训练任务:MLM、NSP
- 数据集:BooksCorpus (800M words) + English Wikipedia (2,500M words)
- 关键参数:
- transformer 层数:12
- 特征维度:768
- transformer head数:12
- 总参数:1.15亿
自回归模型
- Autoregressive model(AR),特点:Decoder-Only
- 基本原理:从左往右学习的模型,只能利用上文或者下文的信息
- AR 模型通常用于生成式任务,长文本的生成能力很强,比如自然语言生成领域的任务:摘要、翻译或抽象问答
- 优点:生成能力很强,适合长文本生成
- 缺点:不能完全捕捉 token的内在联系
- 代表模型:GPT(Generative Pre-trained Transformer)
- 核心架构:单向的 transformer-decoder(去除了 encoder-decoder attention子层)
- 预训练任务:无监督的预训练 和 有监督任务的微调
- 数据集:BooksCorpus,5GB,7400w+句子,由7000本不同的书组成 书籍文本包含大量高质量长句,保证模型学习长距离信息依赖。
- 关键参数:
- transformer 层数:12
- 特征维度:768
- transformer head数:12
- 总参数量:1.17亿
序列到序列模型
- Sequence to Sequence model(S2S),特点:Encoder-Decoder
- 基本原理:将每个task视作序列到序列的转换或者生成
- S2S 模型通常用于需要内容理解和生成的任务,比如机器翻译、代码生成等(文本到文本,文本到图像、图像到文本的多模态任务)
- 优点:能够处理多种NLP任务,具有良好的扩展性,相比GPT2、GPT3等模型,参数量相对较少
- 缺点:训练时间长,需要更大的算力,模型的可解释性不足
- 代表模型:T5(Text-to-Text Transfer Transformer)
- 目的为构建任务的统一框架,将所有BLP任务都视为文本转换任务
- 核心架构:transformer(将Layer Norm 放在外面,简化版的相对位置编码)
- 预训练任务:因果语言建模(Causal Language Modeling,CLM)和填空任务(Masked Language Modeling,MLM)
- 多任务微调:不仅可以 无监督预训练,还能进行 有监督多任务预训练
- 数据集:C4:the Colossal Clean Crawled Corpus
- 关键参数:
- transformer 层数:24
- 特征维度:768
- transformer head数:12
- 总参数:2.2亿
LLM 的主流模型架构
Decoder-only 架构
- 训练效率和工程实现上具有优势
- encoder的双向注意力会存在低秩问题,这可能会削弱模型表达能力,就生成任务而言,引入双向注意力并无实质好处
- 而Encoder-Decoder架构之所以能够在某些场景下表现更好,大概只是因为它多了一倍参数。
- 所以,在同等参数量、同等推理成本下,Decoder-only架构就是最优选择了。
ChatGPT 模型原理
GPT-1
- 模型架构:Decoder-only
- 预训练任务:无监督预训练,有监督任务微调
- 基本参数:
- transformer 层数:12
- transformer head数:12
- 特征维度:768
- batch_size:64
- 上下文长度:512
- 总参数:1.17亿
GPT-2
- 模型架构:Decoder-only(Pre_LayerNorm, 最后一层加入LayerNorm)
- 预训练任务:无监督预训练
- 基本参数:
- transformer 层数:12、24、36、48
- transformer head数:12、16、20、25
- 特征维度:768、1024、1280、1600
- batch_size:512
- 上下文长度:1024
- 总参数:0.1B、0.35B、0.77B、1.5B
- 提出的新思想
- zero-shot:零样本学习,达到开箱即用的效果
GPT-3
- 模型架构:Decoder-only(Pre_LayerNorm,最后一层加入LayerNorm,sparse attention)
- 预训练任务:无监督预训练
- 基本参数:
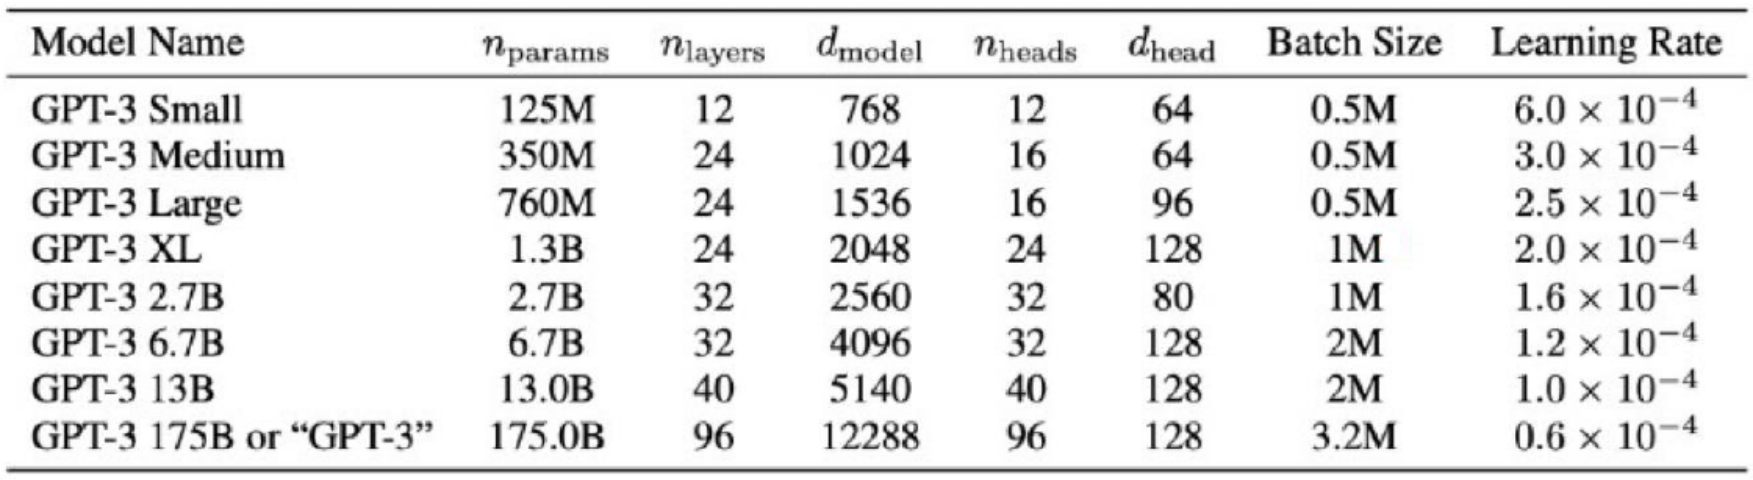
- 提出的新思想:ICL(in-context learning: Few-Shot、 One-Shot、 Zero-Shot)
- Few-Shot:使用少量样本在下游任务上去做微调,让模型给出更准确的答案
ChatGPT 的介绍
由OpenAI 2022年11月发布的聊天机器人模型
能够通过学习和理解人类的语言来进行对话,真正像人类一样交流
甚至完成撰写邮件、视频脚本、文案、翻译、代码等任务
ChatGPT是基于GPT-3.5而构建聊天机器人,ChatGPT通过使用GPT-3.5 的语言生成能力来与用户进行对话
原始 GPT-3 虽然能生成类似人类的文本,但其输出并不总是符合人类的期望或意图(缺乏意图对齐)
ChatGPT为解决模型不一致问题,使用 强化学习(RLHF) 即利用人类的反馈来指导学习,对模型进一步训练
ChatGPT 基本原理:有监督的微调+奖励模型+强化学习
强化学习
强化学习(Reinforcement Learning, RL), 又称增强学习, 是机器学习方法的一种, 用于描述和解决智能体(agent)在与环境的交互过程中通过学习策略以达成回报最大化或实现特定目标的问题
- 机器学习的一种方法
- 关注智能体与环境之间的交互
- 目标追求最大回报
基本要素:
- agent(智能体):强化学习训练的主题
- environment(环境):整个环境的大背景,包括:agent、地面、柱子、建筑等
- state(状态):当前 environment 和 agent 所处的状态,属于动态变化
- policy(策略):根据观测到的状态来进行决策,来控制agent运行
- reward(奖励):agent 在当前 state 下,采去了某个特定的 action 后,会获得环境的一定反馈(奖励)
AI实现自动打游戏
- 通过强化学习(机器学习方法)学出Policy函数, 该步骤目的是用Policy函数来控制Agent.
- 获取当前状态为s1, 并将s1带入Policy函数来计算概率, 从概率结果中抽样得到a1, 同时环境生成下一状态s2, 并且给Agent一个奖励r1.
- 将新的状态s2带入Policy函数来计算概率, 抽取结果得到新的动作a2、状态s3、奖励r2.
- 循环2-3步骤, 直到打赢游戏或者game over, 这样我们就会得到一个游戏的trajectory(轨迹), 这个轨迹是每一步的状态, 动作, 奖励.
ChatGPT 强化学习步骤
从人类的反馈中进行强化学习:
- 监督学习微调(SFT 模型): 通过在有标注数据上进行有监督训练,从而使模型适应特定任务和场景。
- 训练奖励模型(reward): 刻画SFT模型的输出是否在人类看来表现不错。即,输入 [提示(prompt),模型生成的文本],输出一个刻画文本质量的标量数字(奖励值)。
- 强化学习(PPO算法): 利用PPO强化学习算法,基于 reward模型将奖励最大化,从而进一步调优SFT模型。 优点:
- 回答理性又全面, ChatGPT更能做到多角度全方位回答
- 降低学习成本, 可以快速获取问题答案 缺点:
- 由于ChatGPT服务不稳定,对于部分任务比如: “查询某语言系统关键字”等, 会给出没有意义的答案
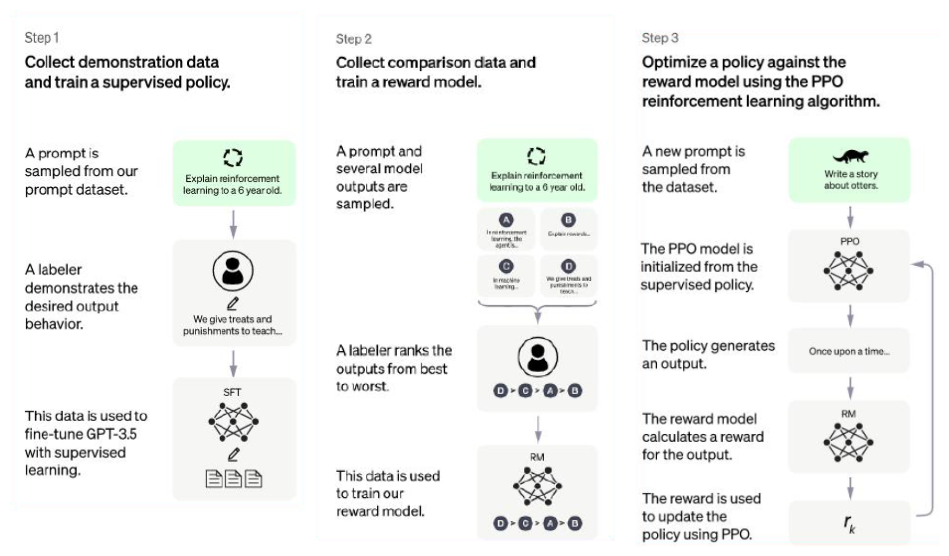
监督学习微调:
- 数据收集: 选择一个问题列表, 标注人员按要求写下预期的输出. 可用于调优预训练的语言模型.
- 模型选择: 基线模型是最新版的 text-davinci-003(通过对程序代码调优的 GPT-3 模型)
由于此步骤的数据量有限, 该过程获得的 SFT 模型可能会输出仍然并非用户关注的文本, 并且通常会出现不一致问题. 为了克服这个问题, 使用的策略是让人工标注者对 SFT 模型的不同输出进行排序,我们关注哪个输出是最好的,进而提出 RM 模型, 而不是让人工标注者创建一个更大的精选数据集.
训练奖励模型: 为 SFT 模型输出进行打分, 代表这些输出对于人类来说可取程度有多大. 即模仿人类偏好的系统
- 选择问题列表, SFT 模型为每个问题生成多个输出(4 到 9 之间的任意值)
- 标注者将输出从最佳到最差排序. 结果是一个新的标签数据集, 该数据集的大小大约是用于 SFT 模型的精确数据集的 10 倍
- 此新数据用于训练 RM 模型 . 该模型将 SFT 模型输出作为输入, 并按优先顺序对它们进行排序
模型选择: RM模型是GPT-3的蒸馏版本(参数量为6亿), 目的是通过该训练模型得到一个预测值(得分), 模型损失函数为:
强化学习:通过优化 RM 模型来调优 SFT 模型. 所使用的特定算法称为 近端策略优化(PPO)
- 输入问题
- 将问题输入到PPO模型 (可以理解为ChatGPT模型), 得到输出结果
- 将第二步得到的结果输入到RM奖励模型中, 然后得到一个奖励分数
- 模型基于分数去调整自己的参数,目的是得到个较高的分数, 不断更新ChatGPT、RM模型
开源主流的 LLM
ChatGLM-6B
- 清华大学提出的一个开源、支持中英双语的对话语言模型
- 基于 General Language Model (GLM) 架构,具有 62 亿参数
- 使用了和 ChatGPT 相似的技术,经过约 1T 标识符的中英双语训练(中英文比例为 1:1),辅以监督微调、反馈自助、人类反馈强化学习等技术的加持,62 亿参数的 ChatGLM-6B 已经能生成相当符合人类偏好的回答(目前中文支持最好)
GLM 架构
- 一种基于自回归空白填充目标的通用预训练框架
- GLM 将 NLU 任务转化为包含任务描述的完形填空问题,可以通过自回归生成的方式来回答
- 原理:在输入文本中随机挖去一些连续的文本片段,然后训练模型按照任意顺序重建这些片段
完形填空问题: 是指在输入文本中用一个特殊的符号(如[MASK])替换掉一个或多个词,然后训练模型预测被替换掉的词
- 训练目标: GLM 会在输入中随机遮挡多个连续片段,然后训练模型以自回归方式、按任意排列顺序逐一重建这些片段。
- 改动点: Embedding层梯度缩减;Deep Norm; GeGLU激活函数;RoPE位置编码
GLM 实现思想
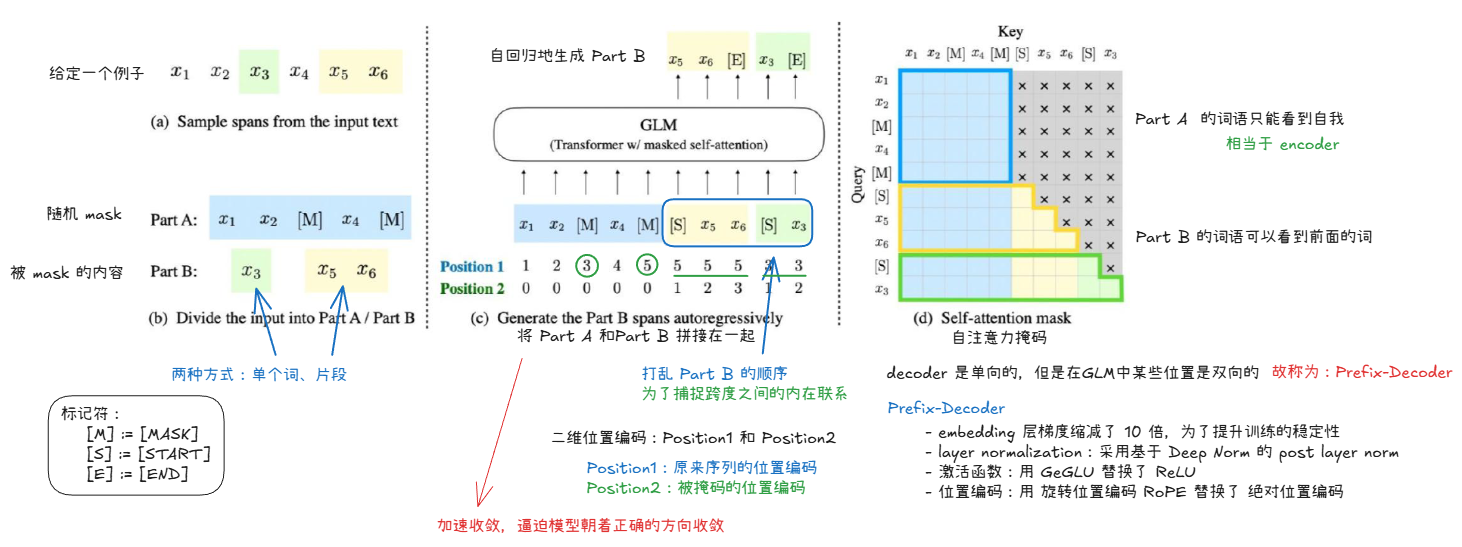
模型配置(6B)与硬件要求
| 配置 | 数据 |
|---|---|
| 参数 | 6.2B |
| 隐藏层维度 | 4096 |
| 层数 | 28 |
| 注意力头数 | 32 |
| 训练数据 | 1T |
| 词表大小 | 130528 |
| 最大长度 | 2048 |
| 量化等级 | 最低GPU显存(推理) | 最低GPU显存(高效参数微调) |
|---|---|---|
| FP16(无量化) | 13GB | 14GB |
| INT8 | 10GB | 9GB |
| INT4 | 7GB | 6GB |
优缺点
优点:
- 较低的部署门槛: INT4 精度下,只需6GB显存,使得 ChatGLM-6B 可以部署在消费级显卡上进行推理.
- 更长的序列长度: 相比 GLM-10B(序列长度1024),ChatGLM2-6B 序列长度达32K,支持更长对话和应用。
- 人类类意图对齐训练
缺点:
- 模型容量小,相对较弱的模型记忆和语言能力。
- 较弱的多轮对话能力。
衍生应用
langchain-ChatGLM: 基于 langchain 的 ChatGLM 应用,实现基于可扩展知识库的问答。 闻达: 大型语言模型调用平台,基于 ChatGLM-6B 实现了类 ChatPDF 功能.
迭代版本
ChatGLM2-6B:
- 更强大的性能: 在 各 项 对 话 任 务 中 , ChatGLM2-6B相比ChatGLM-6B有了巨大的提升。例如,在数学任务上,性能提升了整整571%
- 更长的上下文: ChatGLM2-6B采用了FlashAttention技术,使其支持32K的上下文长度,而ChatGLM-6B只能支持2K
- 更高效的推理: ChatGLM2-6B引入了Multi-Query Attention技术,在更低的显存资源下以更快的速度进行推理,相比第一代提升了42%.
ChatGLM3-6B:
- 多模态理解能力: 在10余个国际标准图文评测集上取得SOTA
- 代码增强模块: 根据用户需求生成代码并执行,自动完成数据分析、文件处理等复杂任务
- 网络搜索增强: 能自动根据问题在互联网上查找相关资料并在回答时提供参考相关文献或者文章链接.
LLaMA
- LLaMA(Large Language Model Meta AI),由 Meta AI 于2023年发布的一个开放且高效的大型基础语言模型,共有 7B、13B、33B、65B(650 亿)四种版本
- LLaMA训练数据是以英语为主的拉丁语系,另外还包含了来自 GitHub 的代码数据。
- LLaMA-65B 和 LLaMA-33B 是在 1.4万亿 (1.4T) 个 token上训练的,而最小的模型 LLaMA-7B 和LLaMA-13B 是在 1万亿 (1T) 个 token 上训练的
- 训练目标:语言模型,即根据已有的上文去预测下一个词
- 关于tokenizer,LLaMA 的训练语料以英文为主,使用了BPE 作为 tokenizer,词表大小只有 32000.词表里的中文 token 很少,只有几百个,LLaMA tokenizer 对中文分词的编码效率比较低
- 改动点:RMS-Norm(Pre_Layer Norm); SwiGLU激活函数;RoPE位置编码
模型结构
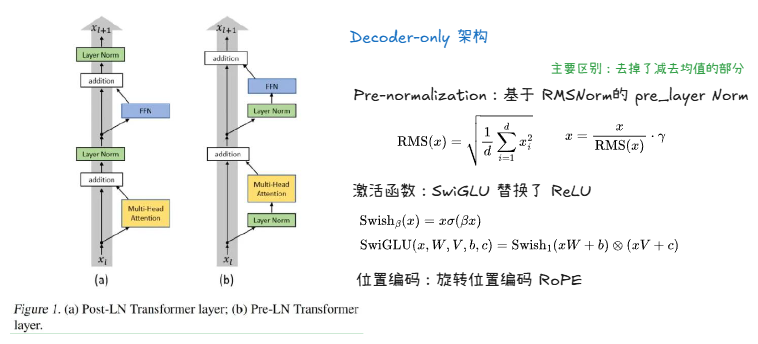
模型配置(7B)与硬件要求
| 配置 | 数据 |
|---|---|
| 参数 | 6.7B |
| 隐藏层维度 | 4096 |
| 层数 | 32 |
| 注意力头数 | 32 |
| 训练数据 | 1T |
| 词表大小 | 32000 |
| 最大长度 | 2048 |
| 硬件要求:65B的模型,在2048个80G的A100 GPU上,可以达到380 tokens/sec/GPU的速度。训练1.4T tokens需要21天 |
优缺点
优点:
- 具有 130 亿参数的 LLaMA 模型「在大多数基准上」可以胜过GPT-3( 参数量达 1750 亿).
- 可以在单块 V100 GPU 上运行;而最大的 650 亿参数的 LLaMA模型可以媲美谷歌的Chinchilla-70B 和 PaLM-540B
缺点:
- 会产生偏见性、有毒或者虚假的内容
- 在中文上效果差,训练语料不包含中文或者一个汉字切分为多个token,编码效率低,模型学习难度大
衍生应用
- Alpaca: 斯坦福大学在 52k 条英文指令遵循数据集上微调了 7B 规模的 LLaMA
- Vicuna: 加州大学伯克利分校在 ShareGPT 收集的用户共享对话数据上,微调了 13B 规模的 LLaMA
- BELLE: 链家仅使用由 ChatGPT 生产的数据,对 LLaMA 进行了指令微调,并针对中文进行了优化
- Chinese LLaMA: 扩充中文词表,常见做法:在中文语料上使用 Sentence Piece 训练一个中文 tokenizer,使用了 20000 个中文词汇.然后将中文 tokenizer 与原始的 LLaMA tokenizer 合并起来,通过组合二者的词汇表,最终获得一个合并的 tokenizer,称为 Chinese LLaMA tokenizer。词表大小为 49953.
迭代版本
LLaMA 2:
- LLama2训练语料相比LLaMA多出40%,上下文长度是由之前的2048升级到4096,可以理解和生成更长的文本
- 新增预预训练数据,并注重安全&隐私问题
- 训练出了chat版本:llama-2-chat(SFT、RLHF)
LLaMA 3:
- 词汇表扩大到了128k:更高效地编码语言,从而大大提高了模型性能
- 提升推理效率:在8B和70B大小的数据上都采用了 分 组 查 询 注 意 力(GQA),来提升推理速度
- 预训练数据继续扩大:训练数据上,用了超过15T的token进行预训练,比之前的Llama 2模型的数据集大了7倍
BLOOM
- 由 Hugging Face公司训练的大语言模型.
- 训练数据包含了英语、中文、法语、西班牙语、葡萄牙语等共 46 种语言,另外还包含 13 种编程语言。1.5TB 经过去重和清洗的文本,其中中文语料占比为 16.2%
- 按照模型参数量,BLOOM 模型有 560M、1.1B、1.7B、3B、7.1B 和 176B 这几个不同参数规模的模型
- 训练目标:语言模型,即根据已有的上文去预测下一个词
- 关于tokenizer,BLOOM 在多语种语料上使用 Byte Pair Encoding(BPE)算法进行训练得到 tokenizer,词表大小为 250880
- 改动点:Embedding Layer Norm; Pre Layer Norm; GeLU激活函数;ALiBi位置编码
模型结构
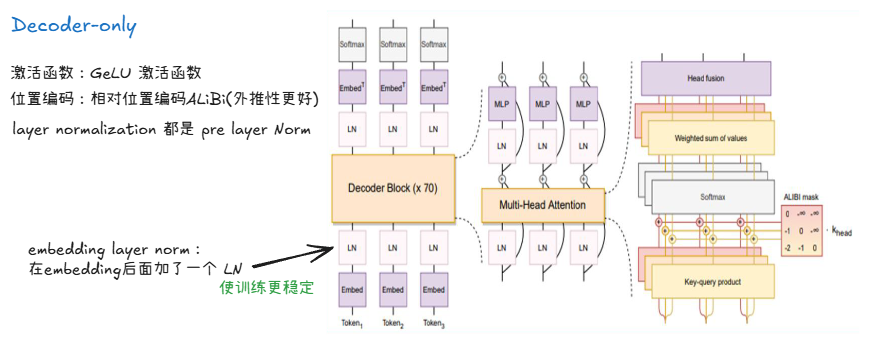
模型配置(176B)与硬件要求
| 配置 | 数据 |
|---|---|
| 参数 | 176B |
| 隐藏层维度 | 14336 |
| 层数 | 70 |
| 注意力头数 | 112 |
| 训练数据 | 366B |
| 词表大小 | 250880 |
| 最大长度 | 2048 |
| 硬件要求:176B-BLOOM 模型在384 张 NVIDIA A100 80GB GPU上,训练于 2022 年 3 月至 7 月期间,耗时约 3.5 个月完成 (约 100 万计算时),算力成本超过300万欧元 |
优缺点
优点:具有良好的多语言适应性,能够在多种语言间进行切换,且无需重新训练 缺点:会产生偏见性、有毒或者虚假的内容
衍生应用
- 轩辕:金融领域大模型,度小满在 BLOOM-176B 的基础上针对中文通用领域和金融领域进行了针对性的预训练与微调.
- BELLE:链家仅使用由 ChatGPT 生产的数据,对 BLOOMZ-7B1-mt 进行了指令微调
Baichuan-7B
- 由百川智能于2023年6月发布的一个开放且可商用的大型预训练语言模型,其支持中英双语,是在约 1.2万亿 (1.2T) 个 token上训练的70亿参数模型
- 关于数据,原始数据包括开源的中英文数据和自行抓取的中文互联网数据,以及部分高质量知识性数据
- 训练目标:语言模型,即据已有的上文去预测下一个词
- 关于tokenizer,使用了BPE分词算法作为 tokenizer,词表大小64000
模型结构
几乎复用了LLaMA的设计(RoPE+SwiGLU+RMSNorm),可视为LLaMA的一个“双语优化版”。但Baichuan-13B通过采用ALiBI,在13B规模上走出了自己的技术路径
模型配置(7B)与模型特点
| 配置 | 数据 |
|---|---|
| 参数 | 7B |
| 隐藏层维度 | 4096 |
| 层数 | 32 |
| 注意力头数 | 32 |
| 训练数据 | 1.2T |
| 词表大小 | 64000 |
| 最大长度 | 4096 |
- baichuan-7B具有较强的通用型,可广泛应用于自然语言处理、机器翻译、问答系统等领域,在智能客服、金融、医疗、教育、人工智能等各行各业都具有很高的潜力和应用前景.
- 在标准的中文和英文权威 benchmark(C-EVAL/MMLU)上均取得了同参数规模下的最好效果.
迭代版本
- Baichuan-13B
- 更大尺寸、更多数据:参数量达到 130 亿,训练了 1.4 万亿 tokens.支持中英双语,使用 ALiBi 位置编码,上下文窗口长度为 4096
- 更高效的推理:开源了 int8 和 int4 的量化版本,相对非量化版本在几乎没有效果损失的情况下大大降低了部署的机器资源门槛,可以部署在如 Nvidia 3090 这样的消费级显卡上
- 开源免费可商用:Baichuan-13B 不仅对学术研究完全开放,开发者也仅需邮件申请并获得官方商用许可后,即可以免费商用
Qwen
- 由阿里巴巴训练并开源的一系列大语言模型
- 最早于2023年8月份开源70亿参数规模,随后几个月时间内陆续开源了4个不同规模版本的模型,最低参数18亿,最高参数720亿
- Qwen系列模型包括:Qwen系列、Qwen1.5 系列、Qwen2 系列、Qwen2.5 系列
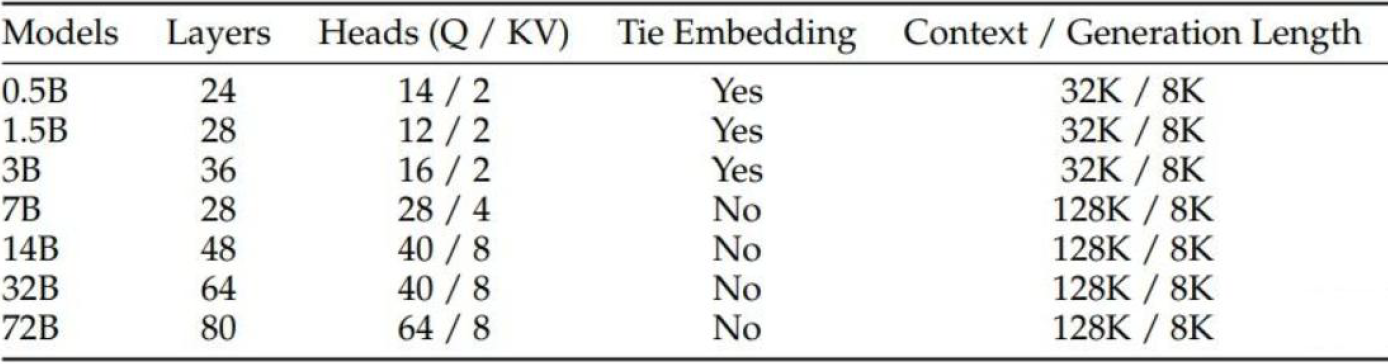
模型结构
改动点:GQA; RMSNorm; SwiGLU激活函数;RoPE位置编码
- 主要采用Transformer Decoder架构,核心组件包括SwiGLU激活函数、RMSNorm和RoPE旋转位置编码(部分多模态模型使用M-ROPE)
- 从Qwen2系列开始,所有尺寸模型都采用了分组查询注意力(GQA)以提升推理效率
- Qwen1.5系列:标准Decoder-only密集模型。其MoE版本(Qwen1.5-MoE-A2.7B)采用混合专家架构,激活参数少但性能可比肩7B模型。
- Qwen2系列:包含0.5B、1.5B、7B、72B四个密集模型和一个57B总参、14B激活的MoE模型(Qwen2-57B-A14B)。
- 多模态模型:
- Qwen2-VL:采用ViT视觉编码器 + Qwen2语言模型的串联结构,支持动态分辨率输入。
- Qwen2.5-Omni:采用“Thinker-Talker”双核架构,Thinker模块处理多模态输入,Talker模块负责流式语音合成。
- Qwen3.5中型系列:采用了“门控增量网络 + 稀疏混合专家(MoE)”的新架构组合,包含122B-A10B、35B-A3B两款MoE模型和一款27B的密集模型。 简而言之,Qwen开源模型在保持Transformer核心的基础上,通过引入GQA、MoE以及针对多模态任务的特化架构(如双核、ViT串联)来实现性能、效率与多模态能力的平衡
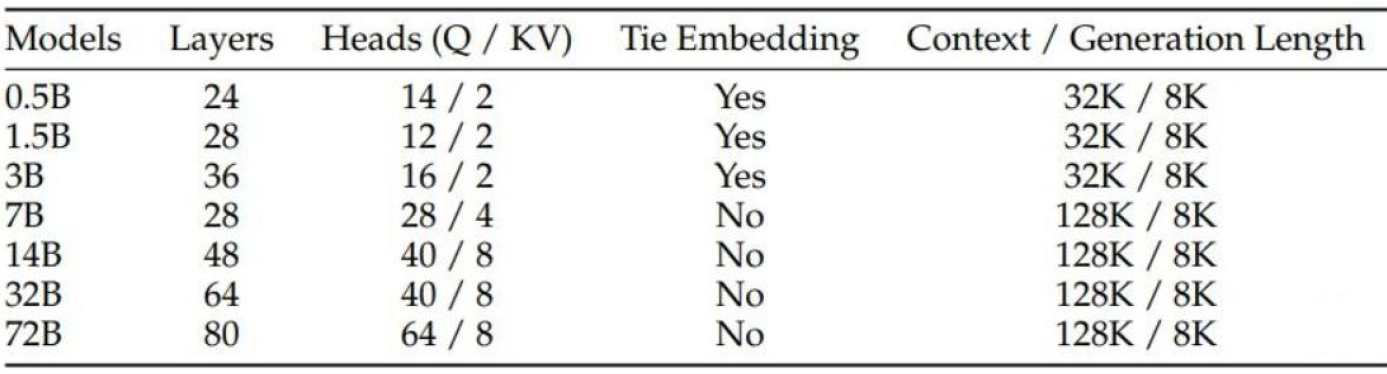
模型配置(Qwen2.5-7B-Instruct)与模型特点
| 配置 | 数据 |
|---|---|
| 参数 | 7B |
| 隐藏层维度 | 3584 |
| 层数 | 28 |
| 注意力头数 | 28个query、4个key-value |
| 训练数据 | 1.2T |
| 词表大小 | 151936 |
| 最大长度 | 32768 |
- Qwen2.5的核心改进在于其预训练和后训练阶段的优化。
- 预训练阶段,Qwen2.5使用了高达18万亿的token数据,相比Qwen2的7万亿token有了显著提升。
- 后训练阶段,Qwen2.5引入了复杂的监督微调和多阶段强化学习,显著提升了模型在长文本生成、结构化数据分析和指令遵循等方面的能力
思考总结
GPT-1 思考总结
- GPT-1模型架构?
答案:Transformer的Decoder模块(去除中间第二个子层) - GPT-1预训练任务?
答案:1、无监督预训练;2、有监督任务微调。 - GPT-1模型基本参数?
答案:12层、12个head、768维、参数量1.17亿
GPT-2 思考总结
- GPT-2模型架构?
答案:相较GPT-1做了微小的改动:1. Pre_LayerNorm;2. 最后一层后加入LN层;3. 序列长度扩大到1024 - GPT-2预训练任务?
答案:无监督预训练 - GPT-2提出的新思想?
答案:zero-shot:零样本学习,达到开箱即用的效果
GPT-3 思考总结
- GPT-3模型架构?
答案:和GPT-2基本一致,提出sparse attention - GPT-3预训练任务?
答案:无监督预训练 - GPT-3提出的新思想?
答案:ICL:Few-Shot、One-Shot、Zero-Shot
ChatGPT 思考总结
- ChatGPT模型原理?
答案:有监督的微调+奖励模型+强化学习 - 强化学习的关键信息?
答案:1. 一种机器学习方法;2. 关注智能体和环境的交互;3. 目标追求最大回报。
ChatGLM-6B 思考总结
- ChatGPT-6B的模型架构?
答案:Prefix-Decoder-Only: 一种基于GLM的自回归空白填充目标的通用预训练模型 - ChatGPT-6B的训练目标?
答案:在输入文本中随机挖去一些连续的文本片段,然后训练模型按照任意顺序重建这些片段。 - ChatGPT-6B模型的改动点?
答案:Embedding层梯度缩减;Deep Norm;GeGLU激活函数;RoPE位置编码
LLaMA 思考总结
- LLaMA的模型架构?
答案:和GPT系列一样,LLaMA模型也是Decoder-only架构 - LLaMA的训练目标?
答案:根据已有的上文去预测下一个词。 - LLaMA模型的改动点?
答案:RMS-Norm(Pre_Layer Norm);SwiGLU激活函数;RoPE位置编码
BLOOM 思考总结
- BLOOM的模型架构?
答案:和GPT系列一样,BLOOM模型也是Decoder-only架构 - BLOOM的训练目标?
答案:根据已有的上文去预测下一个词。 - BLOOM模型的改动点?
答案:Embedding Layer Norm; Pre Layer Norm; GeLU激活函数;ALiBi位置编码
Baichuan-7B 思考总结
- Baichuan-7B的模型架构?
答案:和LLaMA架构一致,也是Decoder-only架构 - Baichuan-7B的训练目标?
答案:根据已有的上文去预测下一个词。 - Baichuan-7B模型的改动点?
答案:Pre Layer Norm; SwiGLU激活函数;RoPE位置编码
Qwen 思考总结
- Qwen-2.5的模型架构?
答案:也是基于Transformer模型的Decoder-only架构 - Qwen-2.5的训练目标?
答案:也属于Causal Model,根据已有的上文去预测下一个词。 - Qwen-2.5模型的改动点?
答案:GQA;RMSNorm;SwiGLU激活函数;RoPE位置编码
Prompt-tuning
NLP 任务的四种范式
- 第一范式:基于「传统机器学习模型」的范式,如TF-IDF特征+朴素贝叶斯等机器算法
- 第二范式:基于「深度学习模型」的范式,如word2vec特征+LSTM等深度学习算法,相比于第一范式,模型准确有所提高,特征工程的工作也有所减少
- 第三范式:基于「预训练模型+fine-tuning」的范式,如Bert+fine-tuning的NLP任务,相比于第二范式,模型准确度显著提高,模型也随之变得更大,但小数据集就可训练出好模型
- 第四范式:基于「预训练模型+Prompt+预测」的范式,如Bert+Prompt的范式相比于第三范式,模型训练所需的训练数据显著减少
在整个NLP领域,整个发展历程是朝着精度更高、少监督,甚至无监督的方向发展的。而 Prompt-Tuning是目前学术界向这个方向进军最新也是最火的研究成果。
Fine-Tuning
- 一种迁移学习方式
- 在NLP中,Fine-Tuning是用于预训练的语言模型适应于特定任务或领域
- 基本思想:采用已经在大量文本上进行训练的预训练语言模型,然后在小规模的任务特定文本上继续对其训练
- 痛点:
- 下游任务的目标和预训练的目标差距过大可能会导致出现过拟合
- 微调过程中需要依赖大量的监督语料等等
- 解决办法:Prompt-Tuning,通过添加模板的方法来避免引入额外的参数,从而让模型可以在小样本(few-shot)或者零样本(zero-shot)场景下达到理想的效果
Prompt-tuning 的介绍
通过添加模板的方法来避免引入额外的参数,从而让模型可以在 小样本(few-shot)或者零样本(zero-shot)场景下达到理想的效果
- 基于Fine-Tuning的方法是让预训练模型去迁就下游任务,
- 而基于Prompt-Tuning的方法可以让下游任务去迁就预训练模型,
- 其目的是将Fine-tuning的下游任务目标转换为Pre-training的任务
- 核心思想:不改变模型参数,通过设计合适的输入文本(提示),引导预训练模型按照我们期望的方式输出答案。
三个关键组成部分: [Input] + [Template] + [Verbalizer(可选)] → [Output]
| 组件 | 作用 | 分类任务示例 | 生成任务示例 |
|---|---|---|---|
| Input | 原始输入数据 | The movie is fantastic. | Translate to Chinese: I love Disney. |
| Template | 任务描述 + 占位符,把任务“伪装”成预训练任务 | It was [MASK]. | 直接接在后面,或用 [MASK] 引导生成 |
| Verbalizer | (仅分类需要)把模型输出的词映射回类别标签 | great → Positive, terrible → Negative | 不需要,生成的文本即答案 |
以分类任务为例:
- 示例具体:[CLS] I like the Disney films very much. [SEP]
- 传统的Fine-tuning方法: 将其通过BERT模型获得 [CLS] 表征之后再喂入新增加的MLP分类器进行二分类,预测该句子是积极的(positive)还是消极的(negative),因此需要一定量的训练数据来训练.
- Prompt-tuning执行步骤:
- 构建模板 (Template): 生成与给定句子相关的一个含有[MASK]标记的模板. 例如It was [MASK], 并拼接到原始的文本中,获得Prompt-Tuning的输入:[CLS] I like the Disney films very much. [SEP] It was [MASK]. [SEP].将其喂入BERT模型中,并复用预训练好的MLM分类器,即可直接得到[MASK]预测的各个token的概率分布
- 标签词映射 (Verbalizer): 因为[MASK]只对部分词感兴趣,因此需要建立一个映射关系. 例如如果[MASK]预测的词是“great”,则认为是positive类,如果是“terrible”,则认为是negative类
- 训练: 根据Verbalizer,则可以获得指定label word的预测概率分布,并采用交叉信息熵进行训练。此时因为只对预训练好的MLM head进行微调,所以避免了过拟合问题
Prompt-tunning 技术发展历程
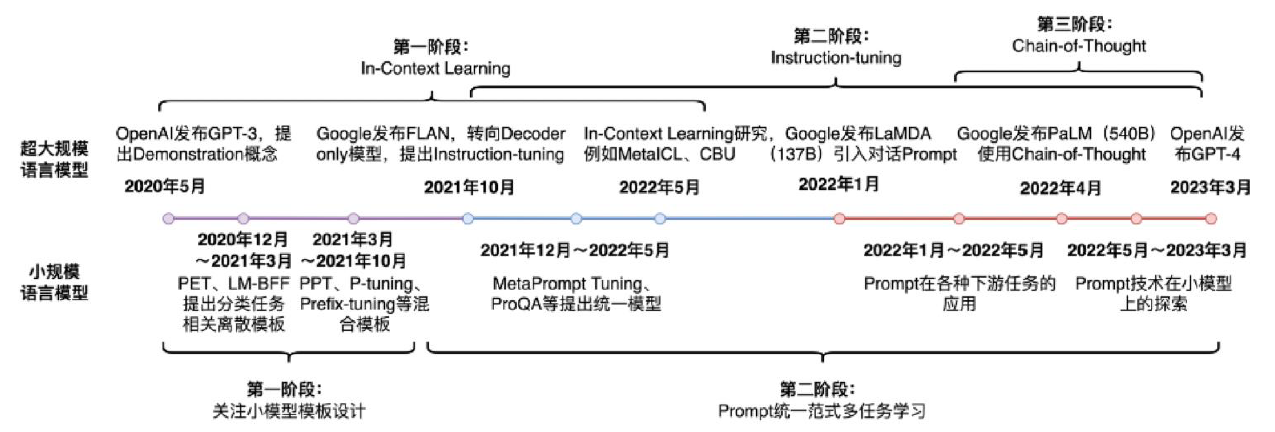
Prompt-tunning 主要方法
前言
Prompt-tunning 的鼻祖
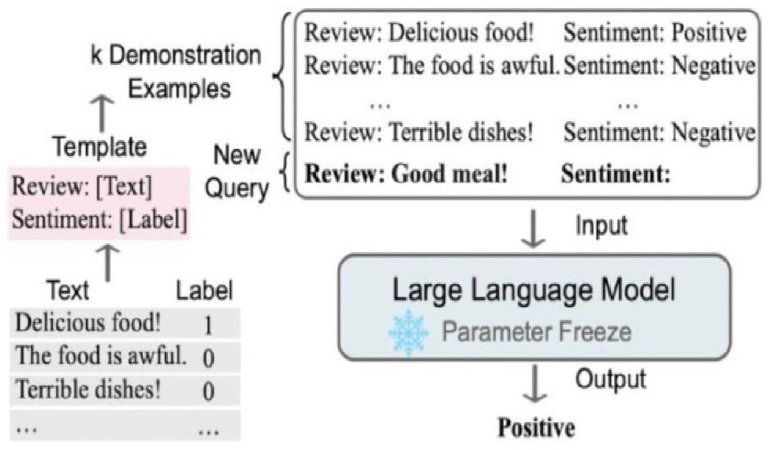
- GPT-3 提出 In-context Learning 的思想,即:无需修改模型即可实现 few-shot、zero-shot的learning
- 同时引入 Demonstrate Learning,即让模型知道与标签相似的语义描述,提升推理能力
- 问题:
- 建立在超大规模的预训练语言模型上.模型参数数量通常超过100亿,在真实场景中很难应用.
- 该方法应用于参数规模小的模型,效果会下降很多,因此后续提出Prompt-Tuning
- GPT3中提供的prompt过于简单, 泛化性能低
PET 模型
PET (Pattern-Exploiting Training)出自《Exploiting Cloze Questions for Few Shot Text Classification and Natural Language Inference》(EACL2021),根据论文题目则可以看出,Prompt-Tuning启发于文本分类任务,并且试图将所有的分类任务转换为与MLM一致的完形填空
例如:将语料中的类别字眼,如“体育” 进行[MASK],变成一个完型填空任务,让模型去预测被掩码的内容
PET模型提出两个很重要的组件(简称PVP):
- Pattern (Template): 记作T, 即上文提到的Template,其为额外添加的带有[mask]标记的短文本,通常一个样本只有一个Pattern, 由于不同的任务、不同的样本可能会有其更加合适的pattern 因此如何构建合适的pattern是Prompt-Tuning的研究点之一
- Verbalizer: 记作V, 即标签词的映射,对于具体的分类任务,需要选择指定的标签词(label word).例如情感分析中,我们期望Verbalizer可能是 (positive和negative是类标签). 同样,不同的任务有其相应的label word,但需要注意的是,Verbalizer的构建需要取决于对应的Pattern 因此如何构建Verbalizer是另一个研究挑战
基于Pattern-Verbalizer-Pair(PVP)组件训练目标:
目前基于PVP框架, 最需要关注的问题是如何选择或构建合适的Pattern和Verbalizer . 一种简单的方法是根据特定任务的性质和先验知识人工设计模板. 注意:在同样的数据集和训练条件下. 选择不同的Pattern和Verbalizer会产生差异很大的结果 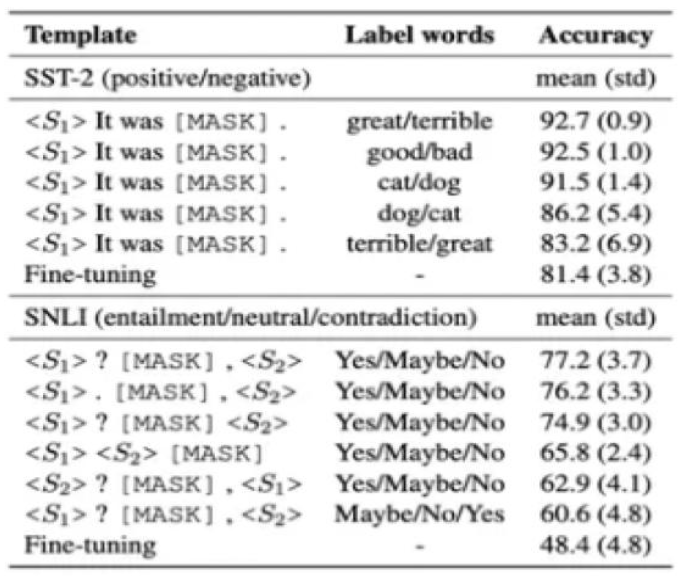
缺陷:
- 采用人工构建的方法成本高,需要与领域任务相关的先验知识
- 人工设计的Pattern和Verbalizer不能保证获得最优解,训练不稳定,不同的PVP对结果产生的差异明显,方差大
- 在预训练阶段MLM任务并非完全按照PVP的模式进行训练的,因此人工构建的Pattern和Verbalizer使得Prompt-Tuning与MLM在语义和分布上依然存在差异.
Prompt-Oriented Fine-Tuning
本质:将目标任务转换为适应预训练模型的预训练任务,以适应预训练模型的学习体系
以情感分析任务为例:
- BERT Fine-Tuning:将训练文本经过Bert编码后,生成向量表征,再利用该向量表征,连接全连接层,实现最终的情感类别识别
- 弊端:预训练任务与下游任务存在 gap
- Prompt-Oriented Fine-Tuning:
- 构建prompt文本:It was [MASK].
- 将prompt文本与输入text文本 text = The film isattractive.拼接生成: It was [MASK].The film is attractive.
- 输入至预训练模型中,训练任务目标和MLM任务的目标一致,即识别被[MASK]掉的词
Prompt-Oriented Fine-Tuning方法中,预训练模型参数是可变的, 本质是Prompt-Tuning+Fine-Tuning的结合体.
弊端:该方法在Bert类相对较小的模型上表现较好,但是随着模型越来越大,如果每次针对下游任务,都需要更新预训练模型的参数,资源成本及时间成本都会很高 解决办法:不更新预训练模型参数,单纯只针对prompt进行调优的方法.
Prompt调优方法分类
针对Prompt调优方法的分类:Hard Prompt 和 Soft Prompt
Hard Prompt
- 离散提示模板: 是一种固定的提示模板,通过将特定的关键词或短语(真实的文本字符串)直接嵌入到文本中,引导模型生成符合要求的文本.
- 特点: 提示模板是固定的,不能根据不同的任务和需求进行调整.
- 缺陷:依赖人工,改变prompt中的单个单词会给实验结果带来巨大的差异
Soft Prompt:
- 连续提示模板:是指通过给模型输入一个可参数化的提示模板,从而引导模型生成符合特定要求的文本.
- 特点: 提示模板中的参数可以根据具体任务和需求进行调整,以达到最佳的生成效果.
- 优点:不需要显式地指定这些模板中各个token具体是什么,而只需要在语义空间中表示一个向量即可
常见下游任务的Prompt设计(Hard Prompt):
| 任务特性 | 模板 |
|---|---|
| 电影评论情感分析(二分类) | The movie review is [x]. It was [mask]. |
| 新闻分类 | A [mask] News: [x]. |
| 实体识别 | Shanghai is in the west of China. The entity Shanghai is [mask]. |
| 多项选择 | Question: , Options: . The result is . |
| 文本摘要 | Context: . Abstract: |
Soft Prompt
基于Soft Prompt, 不同的任务、数据可以自适应地在语义空间中寻找若干合适的向量,来代表模板中的每一个词,相较于显式的token,这类token称为 伪标记(Pseudo Token)
基于连续提示的模板定义:假设针对分类任务,给定一个输入句子x,连续提示的模板可以定义为 ,其中 是伪标记,其仅代表一个抽象的token,并没有实际的含义,本质上是一个向量
总结来说:Soft Prompt方法, 是将模板变为可训练的参数,不同的样本可以在连续的向量空间中寻找合适的伪标记,同时也增加模型的泛化能力. 因此, 连续法需要引入少量的参数并在训练时进行参数更新,但预训练模型参数是不变的,变的是prompt token对应的词向量(Word Embedding)表征及其他引入的少量参数
Prompt Tuning方法(NLG任务)
Prompt Tuning 是2021年谷歌在论文《The Power of Scale for Parameter-Efficient Prompt Tuning》中提出的微调方法。该方法基于T5模型(最大参数11B)为每一个输入文本假设一个固定前缀提示,该提示由神经网络参数化,并在下游任务微调时进行更新,整个过程中预训练的大模型参数被冻结。
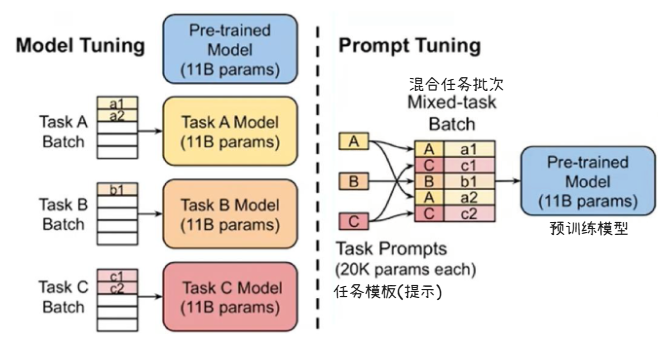
思想:
- 给定 n个tokens, 记作 , 通过一个预训练模 型对应的embedding table,可以将n个token表示为一 个向量矩阵
- 将连续模板中的每个伪标记vi视为参数,可以通过另一 个embedding table获得p个伪token标记为向量矩阵
- 将文本和Prompt拼接获得新的输入
- 新的输入喂入一个MLP获得新的表征. 注意,只有 prompt对应的向量表征参数 会随着训练进行更新
优缺点
- 优点:
- 大模型的微调新范式
- 模型参数规模大了之后,可以将大模型参数固定,指定 附加参数来适配下游任务, 而且适配性能基本和全参数 微调相当
- 缺点:
- 在小样本学习场景上表现不太行
- 收敛速度比较慢
- 调参比较复杂
P-Tuning V1方法(NLU任务)
核心思想:P-tuning 固定 LLM 参数, 利用多层感知机 (MLP)和 LSTM 对 Prompt 进行编码,编码之后与其他向量进行拼接之后正常输入 LLM. 注意,训练之后只保留 Prompt 编码之后的向量即可,无需保留编码器
出处:2022年清华在论文《GPT Understands, Too》中提出的微调方法 为了解决的问题:大模型的 Prompt 构造方式严重影响下游任务的效果 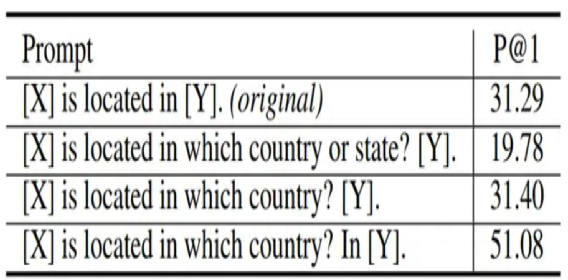 解决办法:将 Prompt 转换为可以学习 的 Embedding 层,只是考虑到直接对 Embedding 参数进行优化
直接对 Embedding 参数进行优化会存在两个挑战(直接优化Prompt为什么不行):
- Discretenes(不连续性): 对输入正常语料的 Embedding 层已经经过预训练,而如果直接对输入的 prompt embedding进行随机初始化训练,容易陷入局部最优
- Association(关联性分析):没法捕捉到 prompt embedding 之间的相关关系
P-Tuning V1 的解决办法(训练思想): 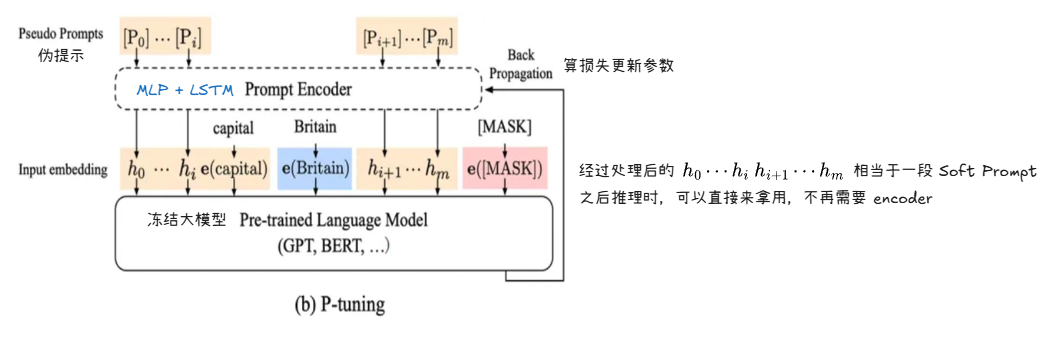
- 用 MLP + LSTM 的方式来对 prompt embedding 进行一层处理
- P-tuning 固定 LLM 参数, 利用多层感知机 (MLP)和 LSTM 对 Prompt 进行编码,编码之后与其他向量进行 拼接之后正常输入 LLM. 注意,训练之后只保留 Prompt 编码之后的向量即可,无需保留编码器
P-Tuning与Prompt Tuning的区别:
- Prompt Tuning 是将额外的 embedding 加在开头,看起来更像是模仿 Instruction 指令;而 P-Tuning 的位置则不固定
- Prompt Tuning 不需要加入 MLP 来参数初始化;而 P-Tuning 通过 LSTM+MLP 来初始化
迭代版本:
- P-Tuning V2
- 主要解决P-Tuning V1 在小参数量模型上表现差的问题
- 详细信息可参考《P-Tuning v2: Prompt Tuning Can Be Comparable to Fine-tuning Universally Across Scales and Tasks》
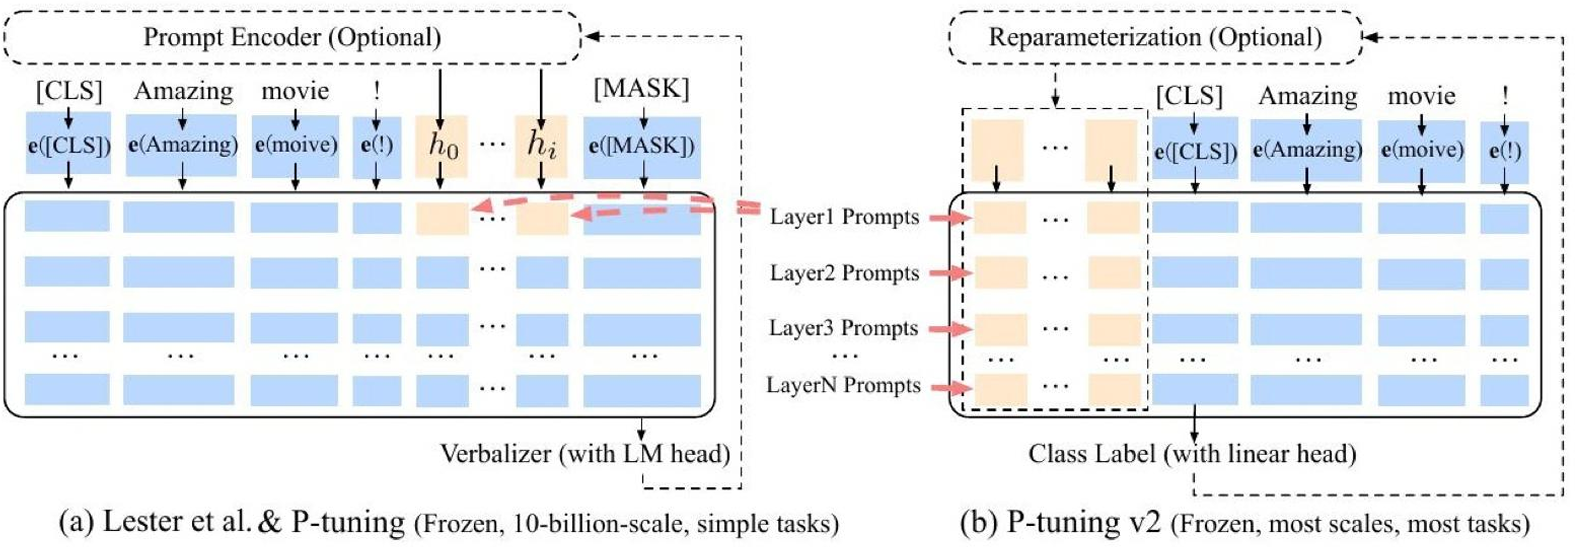
- P-Tuning v2 方法的核心思想:在模型的每一层都应用连续的 prompts, 并对 prompts 参数进行更新优化. 同时, 该方法 也是针对 NLU 任务优化和适配的
超大规模参数模型 Prompt-Tuning方法
- 上下文学习 In-Context Learning(ICL):直接挑选少量的样本作为该任务的提示
- 指令学习 Instruction Tuning:构建任务指令集,促使模型根据任务指令做出反馈
- 思维链 Chain-of Thought(CoT):给予或激发模型具有推理 和解释的信息,通过线性链式的模式指导模型生成合理的结果
In-Context Learning(ICL)
- zero-shot learning:给出任务的描述, 然后提供测试数据对其进行预测, 直接让预训练好的模型去 进行任务测试
- one-shot learning:给出任务的描述, 在进行新数据预测前, 插入一个样本做指导,相当于给一个 例子让模型理解,然后再提供测试数据对其进行预测
- few-shot learning:给出任务的描述, 在进行新数据预测前, 插入N个样本做指导. 相当于给N个例 子让模型理解, 然后再提供测试数据对其进行预测
Instruction-Tuning
[指令] 请将以下中文翻译成英文
[输入] 今天天气真好
[输出] The weather is really nice today- 指令(Instruction):描述任务目标的自然语言(如"分类""总结""翻译")
- 输入(Input):任务的具体实例内容(可选)
- 输出(Response):期望的理想回答/结果
核心流程:多任务指令数据集 -> 统一格式封装 -> 监督微调预训练模型 -> 获取指令跟随能力 -> 零样本泛化新任务
指令微调和提示微调的区别:
- Prompt-Tuning:激发模型的补全能力;只更新少量prompt参数,模型主体冻结;在没有精调的预训练模型上也能有一定效果
- Instruction-Tuning:激发模型的理解能力;必须对模型进行微调,更新模型参数让模型学会指令模式;必须经过指令微调训练才能生效
- Prompt模式:
“带女朋友去了一家餐厅,她吃的很开心,这家餐厅太_了!”- Instruction模式:
“判断这句话的情感:带女朋友去了一家餐厅,她吃的很开心。选项:A=好,B=一般,C=差” 判别比做生成更容易
Chain-of-Thought (CoT)
思维链(Chain-of-Thought, CoT)的概念是在Google的论文《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》中首次提出。
- CoT是一种改进的提示策略,用于提高LLM在复杂推理任务中的性能,如算术推理、常识推理和符号推理。
- CoT是一种离散式提示学习,更具体地,是大模型下的上下文学习(即不进行训练,将例子添加到当前样本输入的前面,让模型一次输入这些文本进行输出完成任务)。
- 相比传统上下文学习(通过 作为输入来让大模型补全输出 ),思维链多了中间的推导提示。
以求解数学题为例:
- 标准Prompting:模型无法做出正确回答。
- CoT Prompting:模型在给出答案之前,会自动给出推理步骤。 例如:
- “罗杰先有5个球,2盒3个网球等于6个,5+6=11”
- “食堂原来有23个苹果,用了20个,23-20=3;又买了6个苹果,3+6=9” 就像数学考试,需要写出解题过程再得出答案。
分类:
- Few-shot CoT
ICL的一种特殊情况,通过融合CoT推理步骤,将每个演示 <input, output> 扩充为 <input, CoT, output>。 - Zero-shot CoT
直接生成推理步骤,然后使用生成的CoT来导出答案。
例如:先由“Let’s think step by step”提示生成推理步骤,再由“Therefore, the answer is”提示得出最终答案。
当模型规模超过一定规模时,这种策略会大大提高性能,但对小规模模型无效。
特点:
- 逻辑性:思维链中的每个思考步骤都应该是逻辑关系的,相互连接,形成完整的思考过程。
- 全面性:尽可能地全面和细致地考虑问题,确保不忽略任何可能的因素和影响。
- 可行性:每个思考步骤都应该是可行的,可以被实际操作和实施。
- 可验证性:每个思考步骤都应该是可以验证的,可以通过实际的数据和事实来验证其正确性和有效性。
PEFT
PEFT (Parameter-Efficient Fine-Tuning)参数高效微调方法是目前大模型在工业界应用的主流方式之一。PEFT方法仅微调少量或额外的模型参数,固定大部分预训练参数,大大降低了计算和存储成本,同时最先进的PEFT技术也能实现与全量微调相当的性能。
PEFT的优势:
使PLM高效适应各种下游应用任务,而无需微调预训练模型的所有参数,且让大模型在消费级硬件上进行全量微调(Full Fine-Tuning)变得可行。
PEFT的分类:
- Prefix/Prompt-Tuning
在模型的输入或隐层添加k个额外可训练的前缀伪tokens,只训练这些前缀参数。 - Adapter-Tuning
将较小的神经网络层或模块插入预训练模型的每一层,这些新插入的神经模块称为adapter(适配器),下游任务微调时也只训练这些适配器参数。 - LoRA
通过学习小参数的低秩矩阵来近似模型权重矩阵W的参数更新,训练时只优化低秩矩阵参数。
Prefix-Tuning
2021年论文《Prefix-Tuning: Optimizing Continuous Prompts for Generation》中提出。该方法是在输入token之前构造一段任务相关的virtual tokens作为Prefix,训练时只更新Prefix部分的参数,而Transformer中的其他部分参数固定。 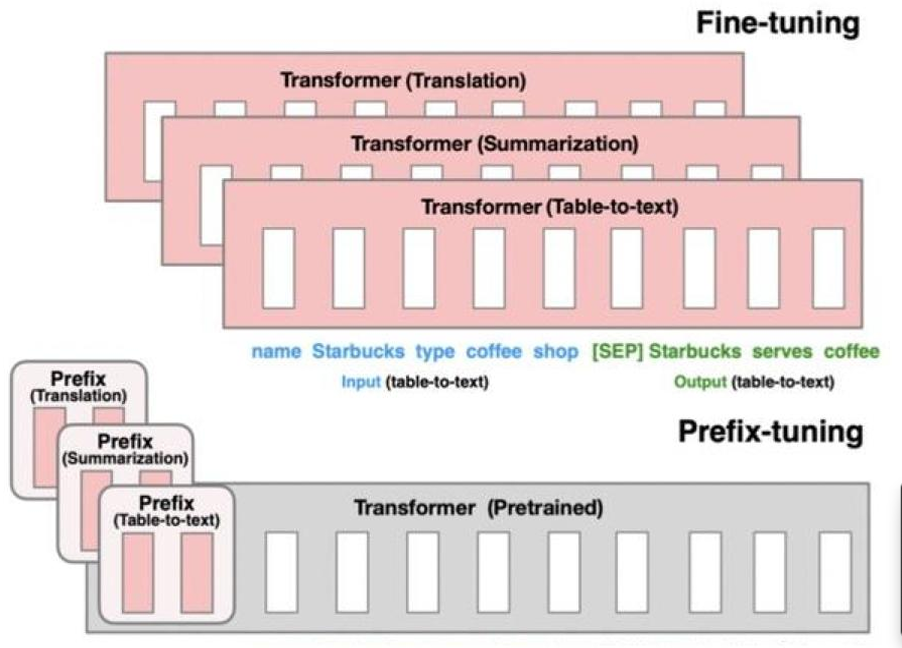
任务形式: 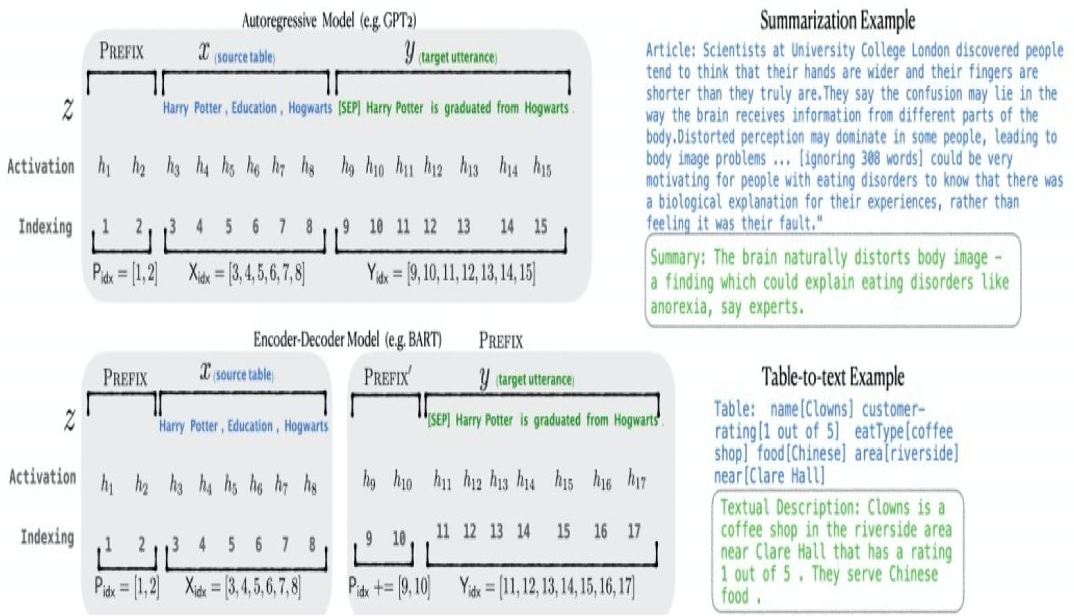 , 为前缀序列索引, 为前缀长度。前缀索引对应由0参数化的向量矩阵 ,维度为 。
注意:直接更新Prefix参数会导致训练不稳定,作者在Prefix层面加了MLP结构(相当于将Prefix分解为更小维度的Input与MLP的组合后输出),训练完成后只保留Prefix参数。
Prefix-Tuning特点:
- 对比P-Tuning:
- Prefix-Tuning将额外的embedding加在开头,更像模仿Instruction指令,而P-Tuning位置不固定。
- Prefix-Tuning在每个层都添加可训练参数,通过MLP初始化;P-Tuning只在输入时加入embedding,并通过LSTM+MLP初始化。
- 对比Prompt Tuning:
- Prompt Tuning可看作是Prefix-Tuning的简化,只在输入层加入prompt tokens
- Prefix-Tuning在每个层都添加可训练参数
Adapter Tuning
2019年谷歌研究人员在论文《Parameter-Efficient Transfer Learning for NLP》中提出针对BERT的PEFT微调方式,拉开了PEFT研究的序幕。
不同于Prefix-Tuning在输入前添加可训练prompt参数,Adapter-Tuning是在预训练模型内部的网络层之间添加新的网络层或模块来适配下游任务。模型训练时,固定预训练模型参数不变,只对新增的Adapter结构进行微调。
模型结构: 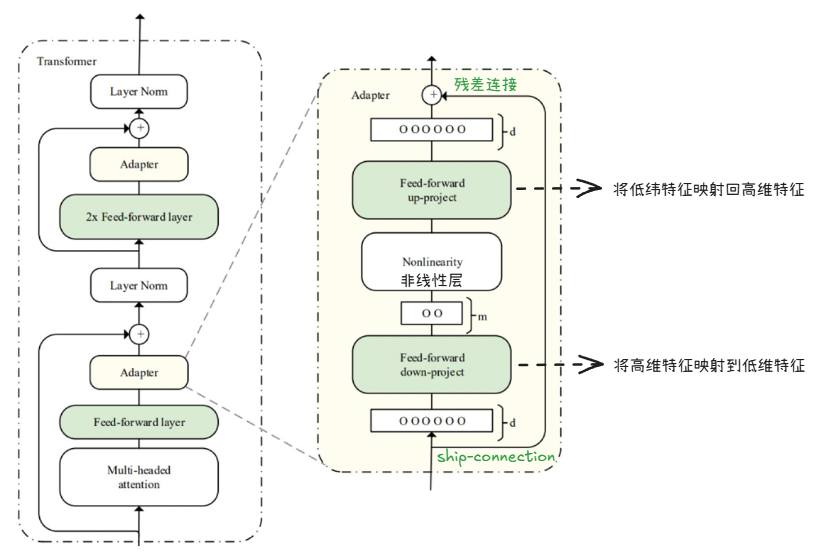 首先是一个down-project层将高维度特征映射到低维特征,然后经过非线性层后,再用up-project结构将低维特征映射回原来的高维特征。同时设计了skip-connection结构,确保在最差情况下能够退化为identity(类似残差结构)。
LoRA
LoRA (Low-Rank Adaptation,低秩适应)是一种参数高效的微调技术,核心思想是对大型模型的权重矩阵进行隐式的低秩转换,即通过较低维度的表示来近似表示高维矩阵或数据集。
==个人理解==:维度是现实世界的映射,进行升维所添加的维度,即是特定领域的知识
LoRA的产生背景:
Adapter-Tuning在PLM基础上添加适配器层会引入额外计算,带来推理延迟;Prefix-Tuning难以优化,性能随可训练参数规模非单调变化,且为前缀保留序列长度会减少用于处理下游任务的序列长度。因此微软推出了LoRA方法。
LoRA 原理: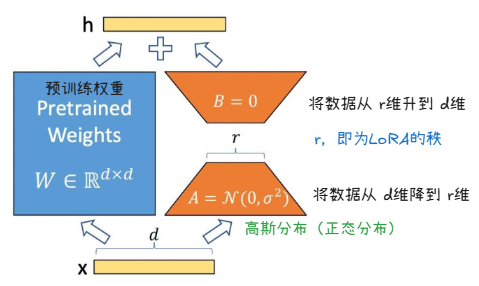
伪代码:
input_dim = 768   # 预训练模型的隐藏大小
output_dim = 768  # 层的输出大小
rank = 8          # 低秩适应的等级'r'

W = ...           # 来自预训练网络的权重,形状为 input_dim x output_dim

W_A = nn.Parameter(torch.empty(input_dim, rank))  # LoRA权重A
W_B = nn.Parameter(torch.empty(rank, output_dim)) # LoRA权重B

# 初始化LoRA权重
nn.init.kaiming_uniform_(W_A, a=math.sqrt(5))
nn.init.zeros_(W_B)

def regular_forward_matmul(x, W):
    h = x @ W
    return h

def lora_forward_matmul(x, W, W_A, W_B):
    h = x @ W                     # 常规矩阵乘法
    h += x @ (W_A @ W_B) * alpha  # 使用缩放的LoRA权重,alpha为缩放因子
    return h
LoRA方法是目前最通用、同时也是效果最好的微调方法之一。
思考总结
1. NLP任务四范式? 答案:
- 传统机器学习
- 深度学习模型
- 预训练+fine-tuning
- 预训练+prompt+预测
2. 什么是Fine-Tuning? 答案:采用已经在大量文本上进行训练的预训练语言模型,然后在小规模的任务特定文本上继续训练它。
3. Prompt-Tuning的实现? 答案:
- 构建模版
- 标签词映射
- 训练
1. 什么是Prompt-Tuning? 答案:通过添加模板的方法来避免引入额外的参数,从而让模型可以在小样本(few-shot)或者零样本(zero-shot)场景下达到理想的效果。
2. PET模型的主要组件? 答案:Pattern(模板)与 Verbalizer(标签词映射)。
3. P-tuning V1的核心思想? 答案:P-tuning 固定 LLM 参数,利用多层感知机(MLP)和 LSTM 对 Prompt 进行编码,编码之后与其他向量进行拼接之后正常输入 LLM。注意,训练之后只保留 Prompt 编码之后的向量即可,无需保留编码器。
1. 什么是指令学习? 答案:通过给出更明显的指令/指示,让模型去理解并做出正确的action。
2. 指令学习和Prompt的区别? 答案:指令学习激发语言模型的理解能力;指令学习激发语言模型的补全能力。
1. 什么是思维链方法? 答案:相比于之前传统的上下文学习(即通过x1,y1,x2,y2,···xtest作为输入来让大模型补全输出ytest),思维链多了中间的推导提示。
2. 思维链的分类? 答案:Few-shot CoT 以及 Zero-shot CoT。
1. 什么是Prefix Tuning? 答案:该方法是在输入 token 之前构造一段任务相关的 virtual tokens 作为 Prefix,然后训练的时候只更新 Prefix 部分的参数,而 Transformer 中的其他部分参数固定。
2. Prefix-Tuning和P-Tuning的区别? 答案:
- Prefix-Tuning 是将额外的embedding加在开头,而P-Tuning位置不固定;
- Prefix-Tuning 通过在每个层都添加可训练参数,通过MLP初始化,而P-Tuning只在输入的时候加入embedding,并通过LSTM+MLP初始化。
3. Prefix-Tuning和Prompt-Tuning的区别? 答案:Prompt Tuning 方式可以看做是 Prefix Tuning 的简化,只在输入层加入 prompt tokens,并不需要加入 MLP 进行调整来解决难训练的问题。
1. 什么是Adapter Tuning? 答案:在预训练模型内部的网络层之间添加新的网络层或模块来适配下游任务。
2. 什么是LoRA? 答案:一种特殊的adapter,一种高效参数微调方法;对大型模型的权重矩阵进行隐式的低秩转换。
3. LoRA原理? 答案:冻结预训练模型的权重,并在每个Transformer块中注入可训练层(称为秩分解矩阵),即在模型的Linear层的旁边增加一个“旁支”A和B。其中,A将数据从d维降到r维,这个r是LoRA的秩,是一个重要的超参数;B将数据从r维升到d维,B部分的参数初始为0。模型训练结束后,需要将A+B部分的参数与原大模型的参数合并在一起使用。