RNN的基础概念
什么是RNN模型
RNN(Recurrent Neural Network,循环神经网络)
一般以序列数据为输入, 通过网络内部的结构设计有效捕捉序列之间的关系特征, 一般也是以序列形式进行输出.
RNN单层网络结构
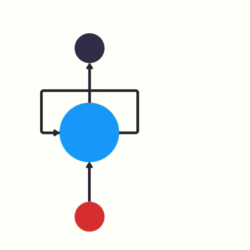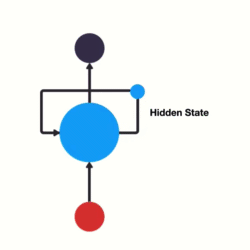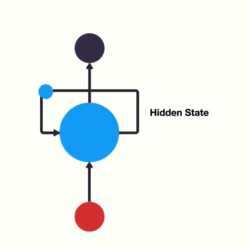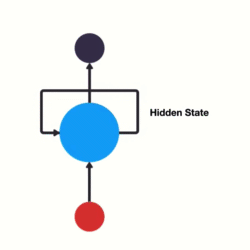
以时间步对RNN进行展开后的单层网络结构:
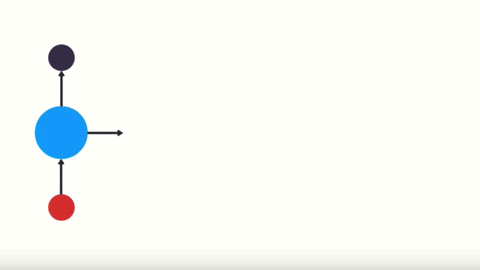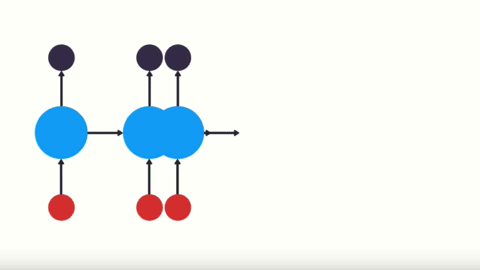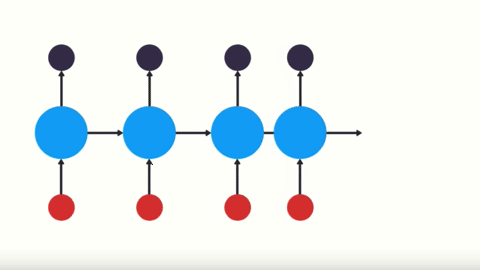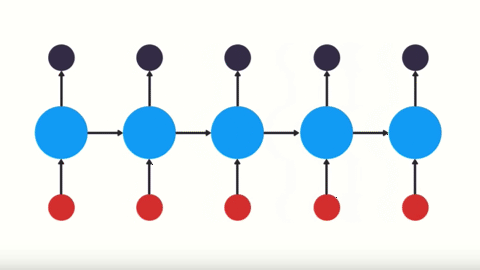
RNN的循环机制使模型隐层上一时间步产生的结果, 能够作为当下时间步输入的一部分(当下时间步的输入除了正常的输入外还包括上一步的隐层输出)对当下时间步的输出产生影响.
RNN的作用
因为RNN结构能够很好利用序列之间的关系, 因此针对自然界具有连续性的输入序列, 如人类的语言, 语音等进行很好的处理, 广泛应用于NLP领域的各项任务, 如文本分类, 情感分析, 意图识别, 机器翻译等.
RNN的分类
按照RNN的内部构造进行分类:
- 传统RNN
- LSTM
- Bi-LSTM
- GRU
- Bi-GRU
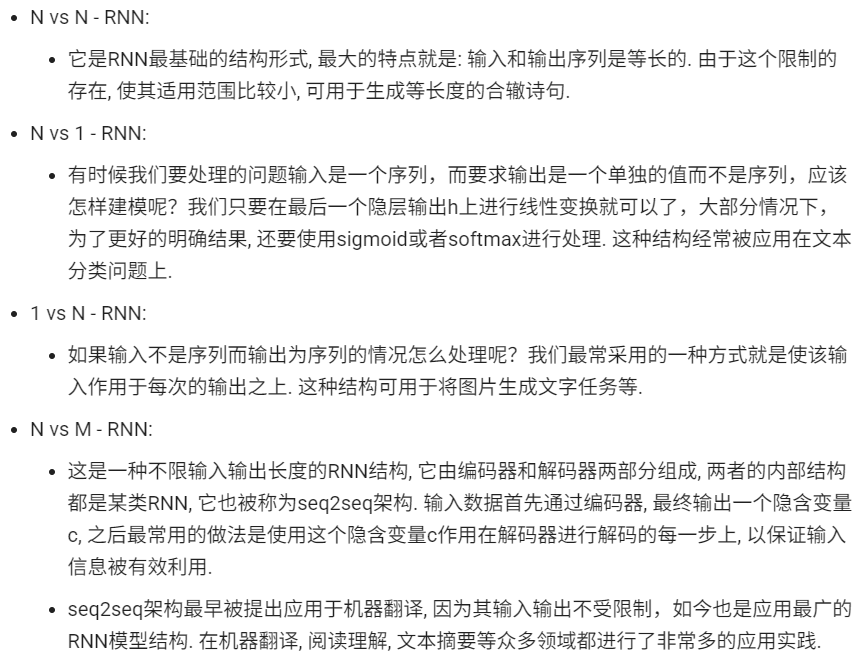
按照输入和输出的结构进行分类:
- N vs N - RNN
- N vs 1 - RNN
- 1 vs N - RNN
- N vs M - RNN
传统RNN
RNN 结构分析
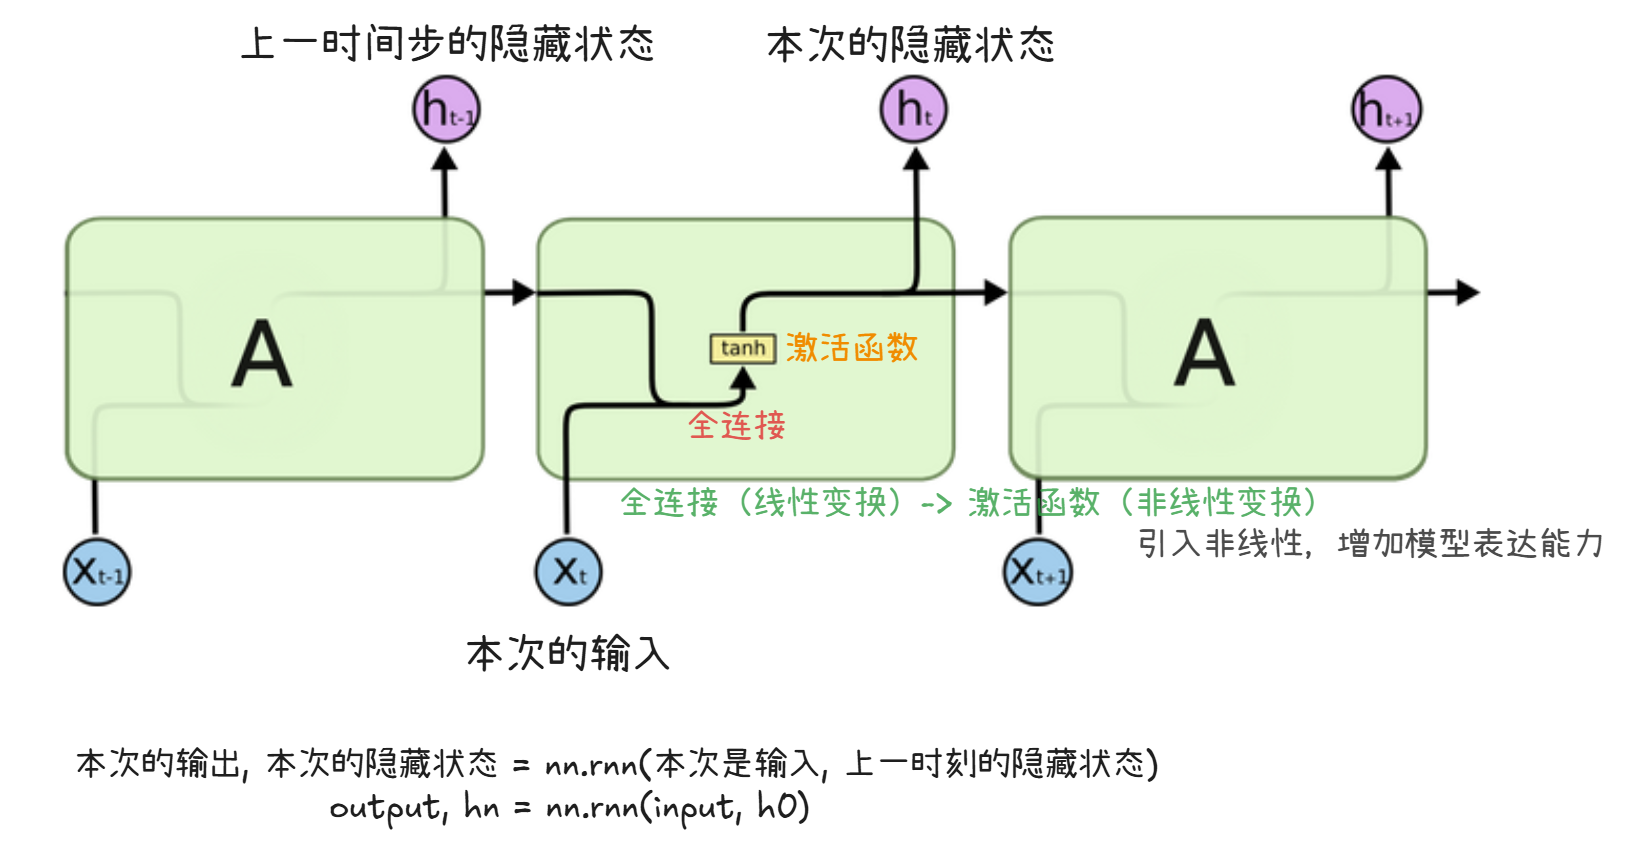
本次的输出 = 权重矩阵 * [本次的输入, 上一时刻的隐藏状态] + 本次的偏置
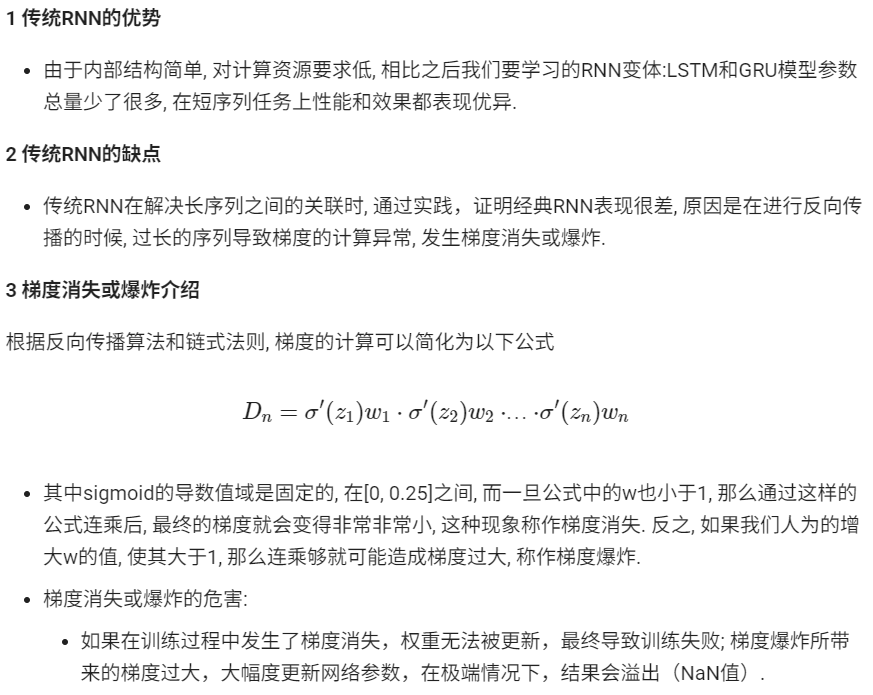
优缺点
代码示例
import torch
import torch.nn as nn

def rnn_base():
    # 创建RNN模型
    rnn = nn.RNN(input_size=10, hidden_size=6, num_layers=1)
    # - input_size: 输入的维度(词嵌入的维度、词向量维度)
    # - hidden_size: 隐藏层的维度(输出维度)
    # - num_layers: 隐藏层的层数
    input = torch.randn(5, 3, 10)  # (seq_len, batch_size, input_size)
    h0 = torch.randn(1, 3, 6)      # (num_layers, batch_size, hidden_size)
    # 实例化模型
    output, hn = rnn(input, h0)
    print(rnn)  # 输出模型结构 - (10, 6)
    print(output.shape)  # (seq_len, batch_size, hidden_size) - [5, 3, 6]
    print(hn.shape)      # (num_layers, batch_size, hidden_size) - [1, 3, 6]
    '''修改句子长度 seq_len'''
    input = torch.randn(20, 3, 10)  # 5 -> 20
    h0 = torch.randn(1, 3, 6)
    output, hn = rnn(input, h0)
    print(output.shape)  # [5, 3, 6] -> [20, 3, 6]
    print(hn.shape)      # [1, 3, 6]
    '''修改隐藏层的层数 num_layers'''
    input = torch.randn(5, 3, 10)
    h0 = torch.randn(2, 3, 6)  # 1 -> 2
    rnn = nn.RNN(input_size=10, hidden_size=6, num_layers=2)
    output, hn = rnn(input, h0)
    print(output.shape)  # [5, 3, 6]
    print(hn.shape)      # [1, 3, 6] -> [2, 3, 6]


rnn_base()
LSTM
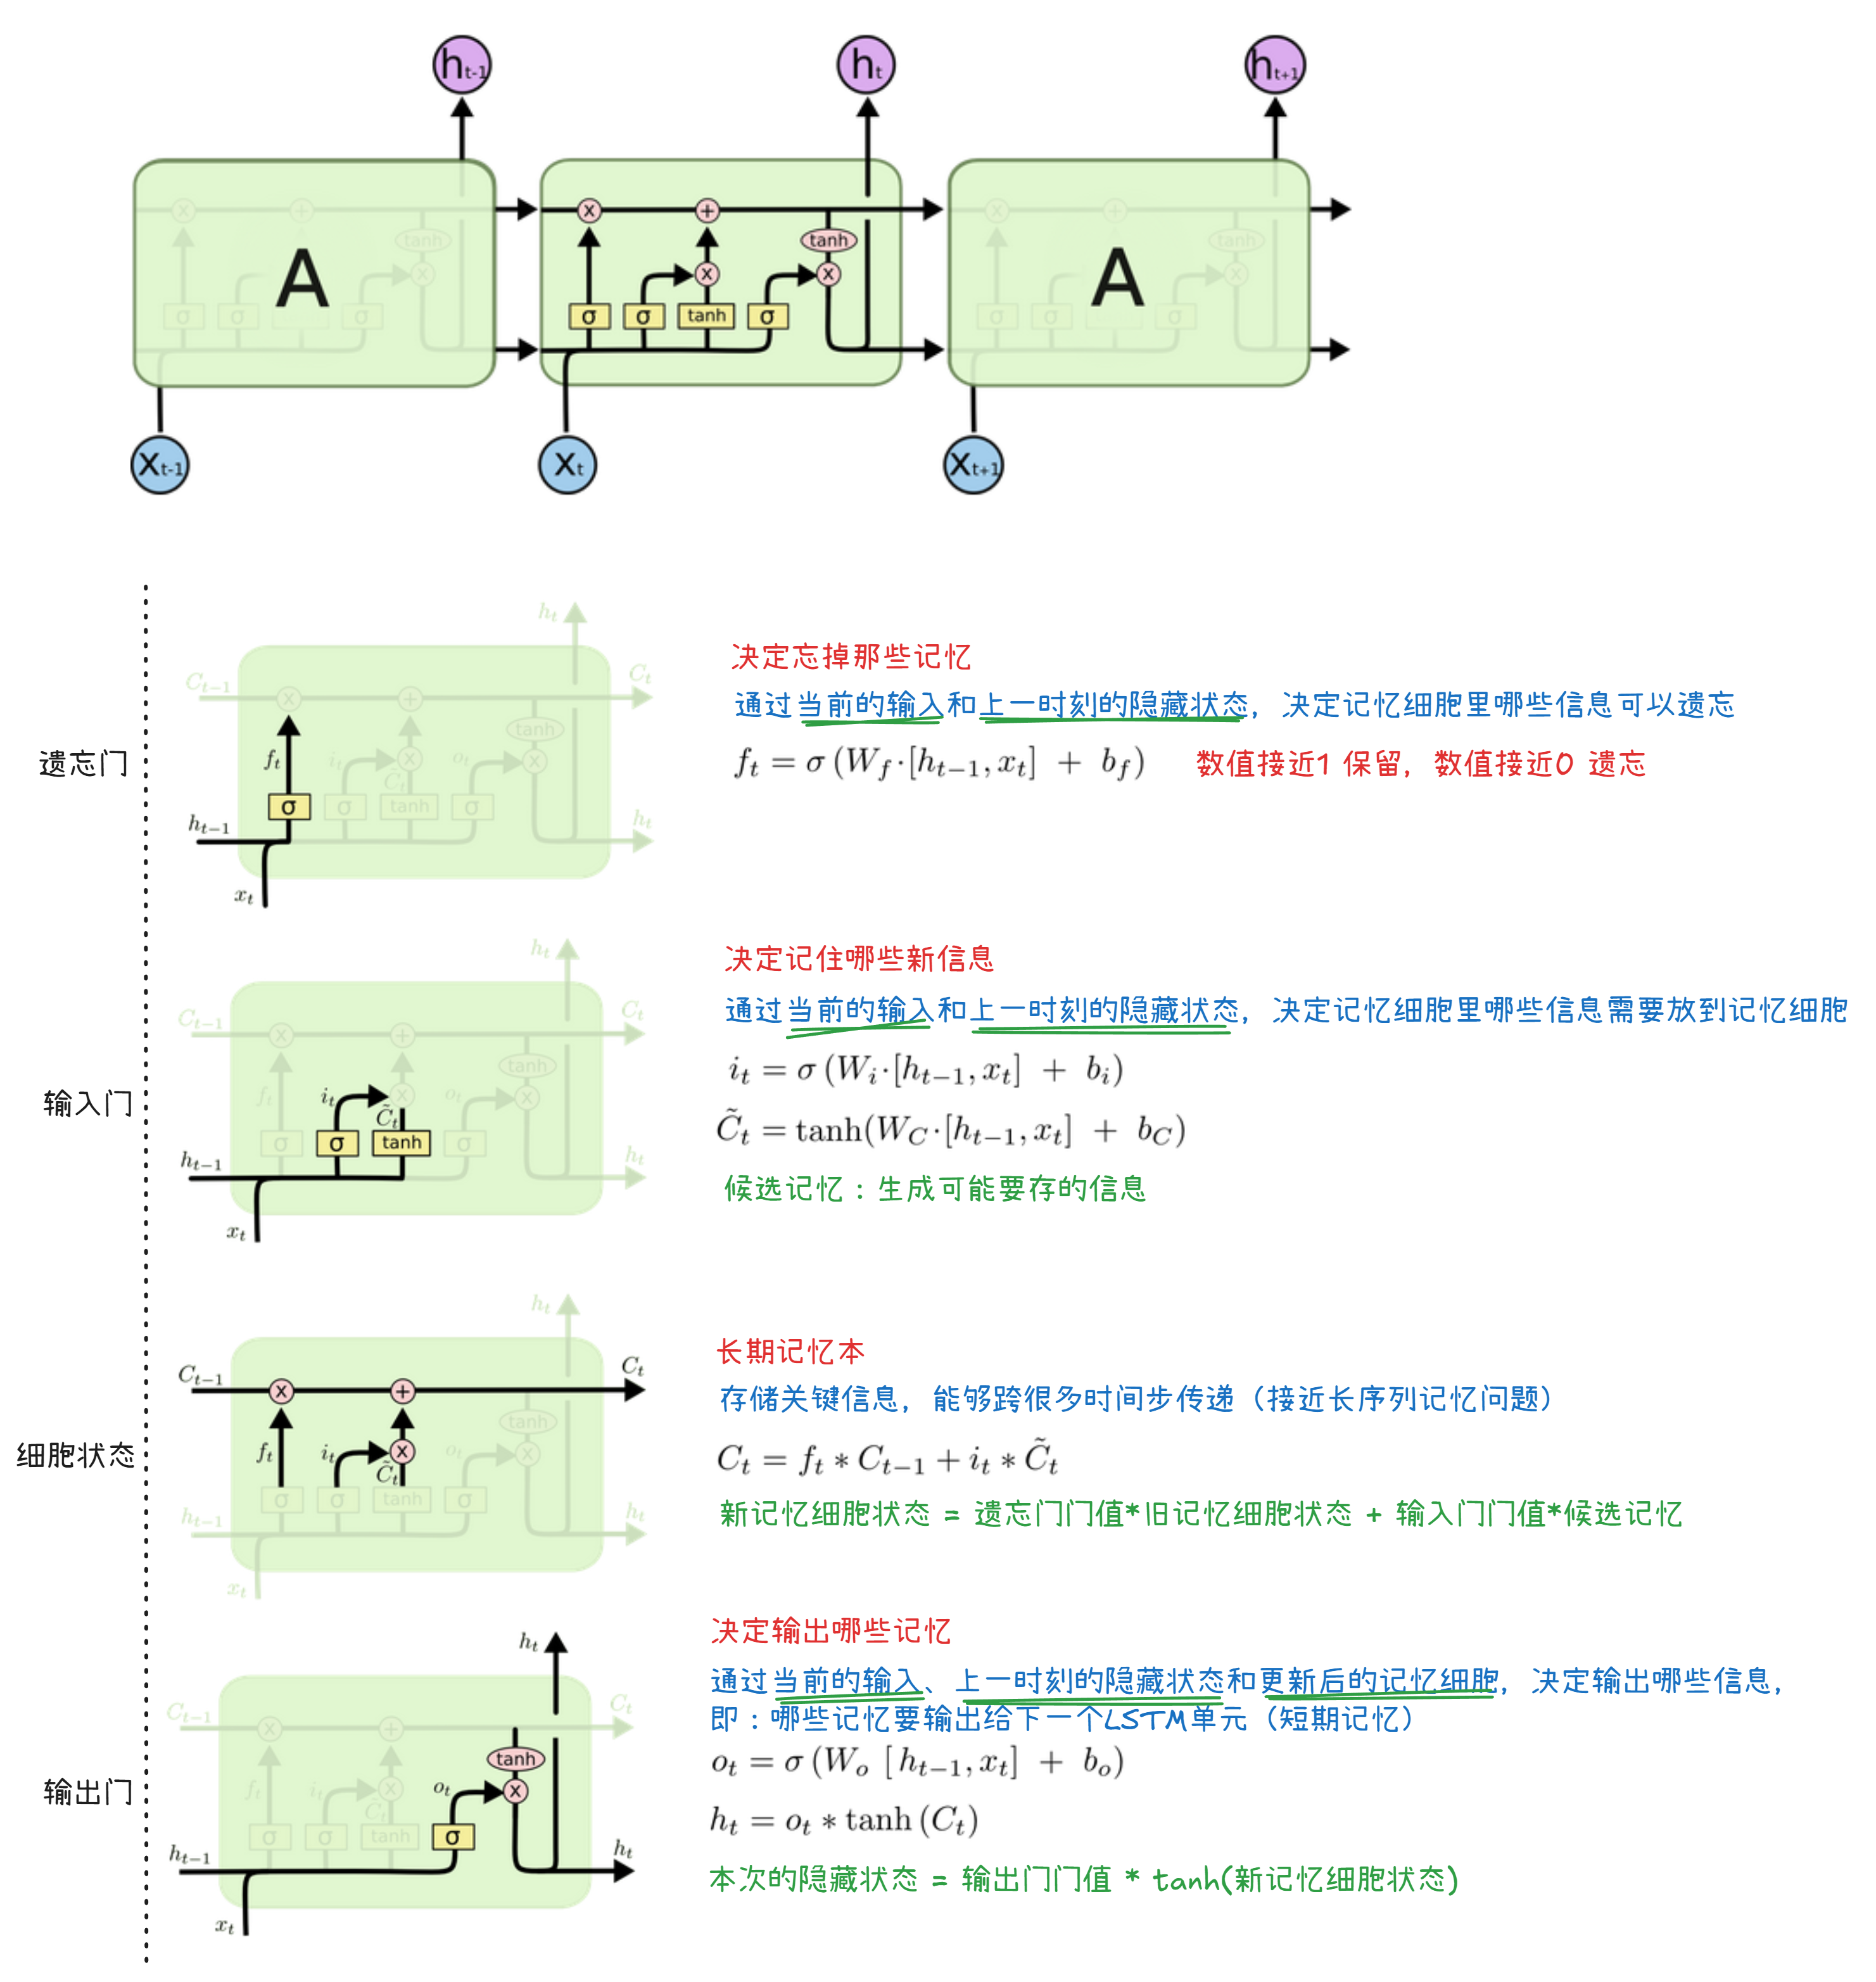
LSTM(Long Short-Term Memory,长短时记忆结构)是传统RNN的变体
与经典RNN相比能够有效捕捉长序列之间的语义关联,缓解梯度消失或爆炸现象
同时LSTM的结构更复杂, 它的核心结构可以分为四个部分去解析:
- 遗忘门
- 输入门
- 细胞状态
- 输出门
LTSM的核心:3个门 + 1个记忆细胞。
把LSTM想象成一个小房间,里面有:
- 3个门(开关):遗忘门、输入门、输出门,分别控制信息的留、进、出
- 1个记忆细胞(cell):专门存重要的信息,相当于“长期记忆本”
整理流程总结:有点像管家整理记忆
- 遗忘门:筛选旧记忆(丢垃圾)-> 更新长期记忆本
- 输入门:筛选新信息(捡宝贝)-> 加到长期记忆本
- 记忆细胞:长期保存关键信息(记到小本本中)
- 输出门:筛选要传递的记忆(挑重点)-> 传递给下一个管家
LSTM 结构分析
优缺点
- 优点:LSTM的门结构能够有效减缓长序列问题中可能出现的梯度消失或爆炸, 虽然并不能杜绝这种现象, 但在更长的序列问题上表现优于传统RNN.
- 缺点:由于内部结构相对较复杂, 因此训练效率在同等算力下较传统RNN低很多.
代码示例
import torch
import torch.nn as nn

def lstm_base():
    # 创建LSTM模型
    lstm = nn.LSTM(input_size=5, hidden_size=6, num_layers=1)
    input = torch.randn(5, 3, 5)  # (seq_len, batch_size, input_size)
    h0 = torch.randn(1, 3, 6)     # (num_layers, batch_size, hidden_size)
    c0 = torch.randn(1, 3, 6)     # (num_layers, batch_size, hidden_size)
    output, (hn, cn) = lstm(input, (h0, c0))
    print(lstm)
    print(output.shape)  # [5, 3, 6] - (seq_len, batch_size, hidden_size)
    print(hn.shape)      # [1, 3, 6] - (num_layers, batch_size, hidden_size)
    print(cn.shape)      # [1, 3, 6] - (num_layers, batch_size, hidden_size)

lstm_base()
Bi-LSTM
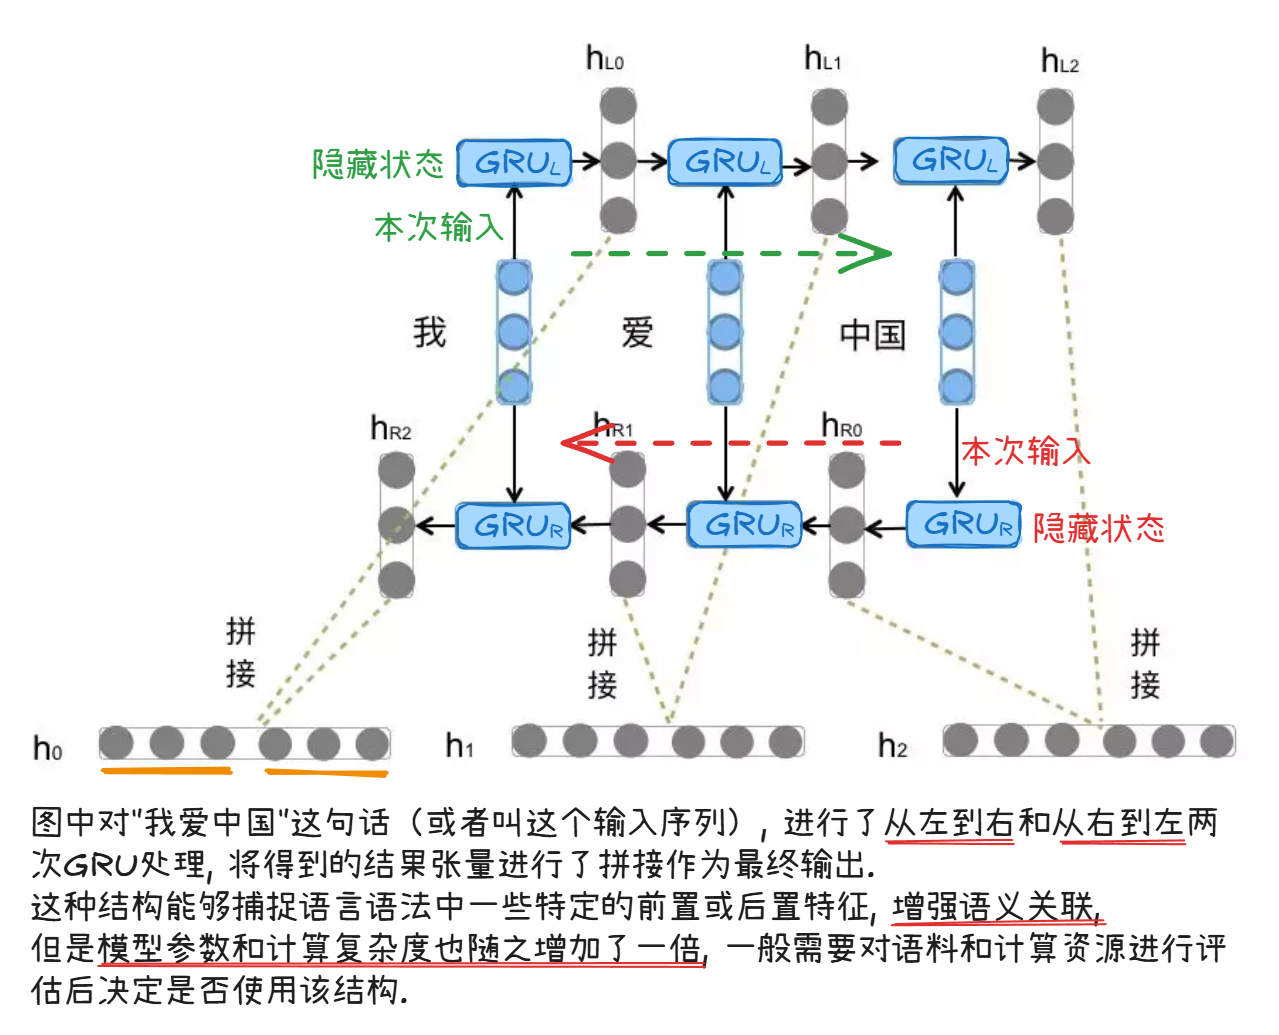
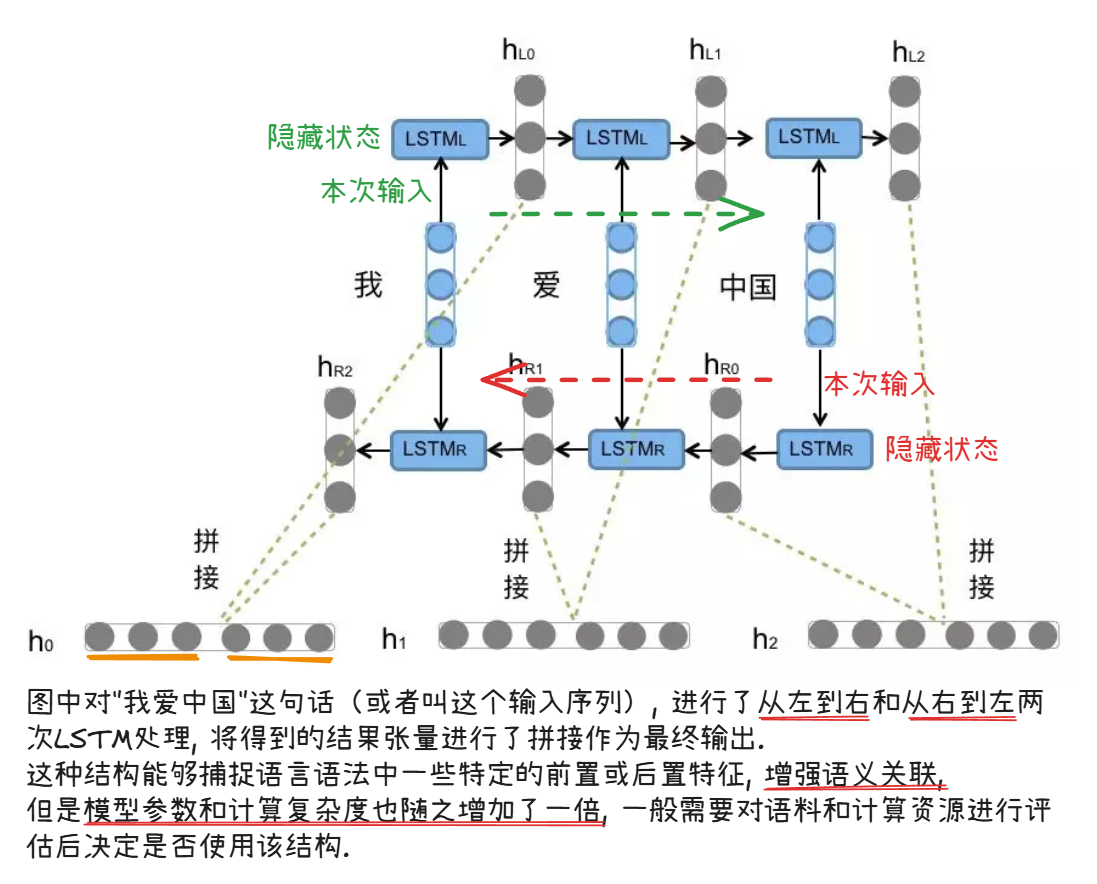
- Bi-LSTM 即:双向LSTM,它没有改变LSTM本身任何的内部结构
- 只是将LSTM应用两次且方向不同, 再将两次得到的LSTM结果进行拼接作为最终输出
GRU
GRU(Gated Recurrent Unit)也称门控循环单元结构
对比LSTM,为什么还需要GRU?
LSTM靠‘三个门+记忆细胞’接近长序列记忆问题,但是结构复杂,计算慢
GRU想的是“能否简化结构,又保留智能记忆的功能”,它把LSTM的部分门合并,变成了更轻量的“记忆管家”,训练更快,还能解决长序列问题
它也是传统RNN的变体, 同LSTM一样能够有效捕捉长序列之间的语义关联, 缓解梯度消失或爆炸现象.
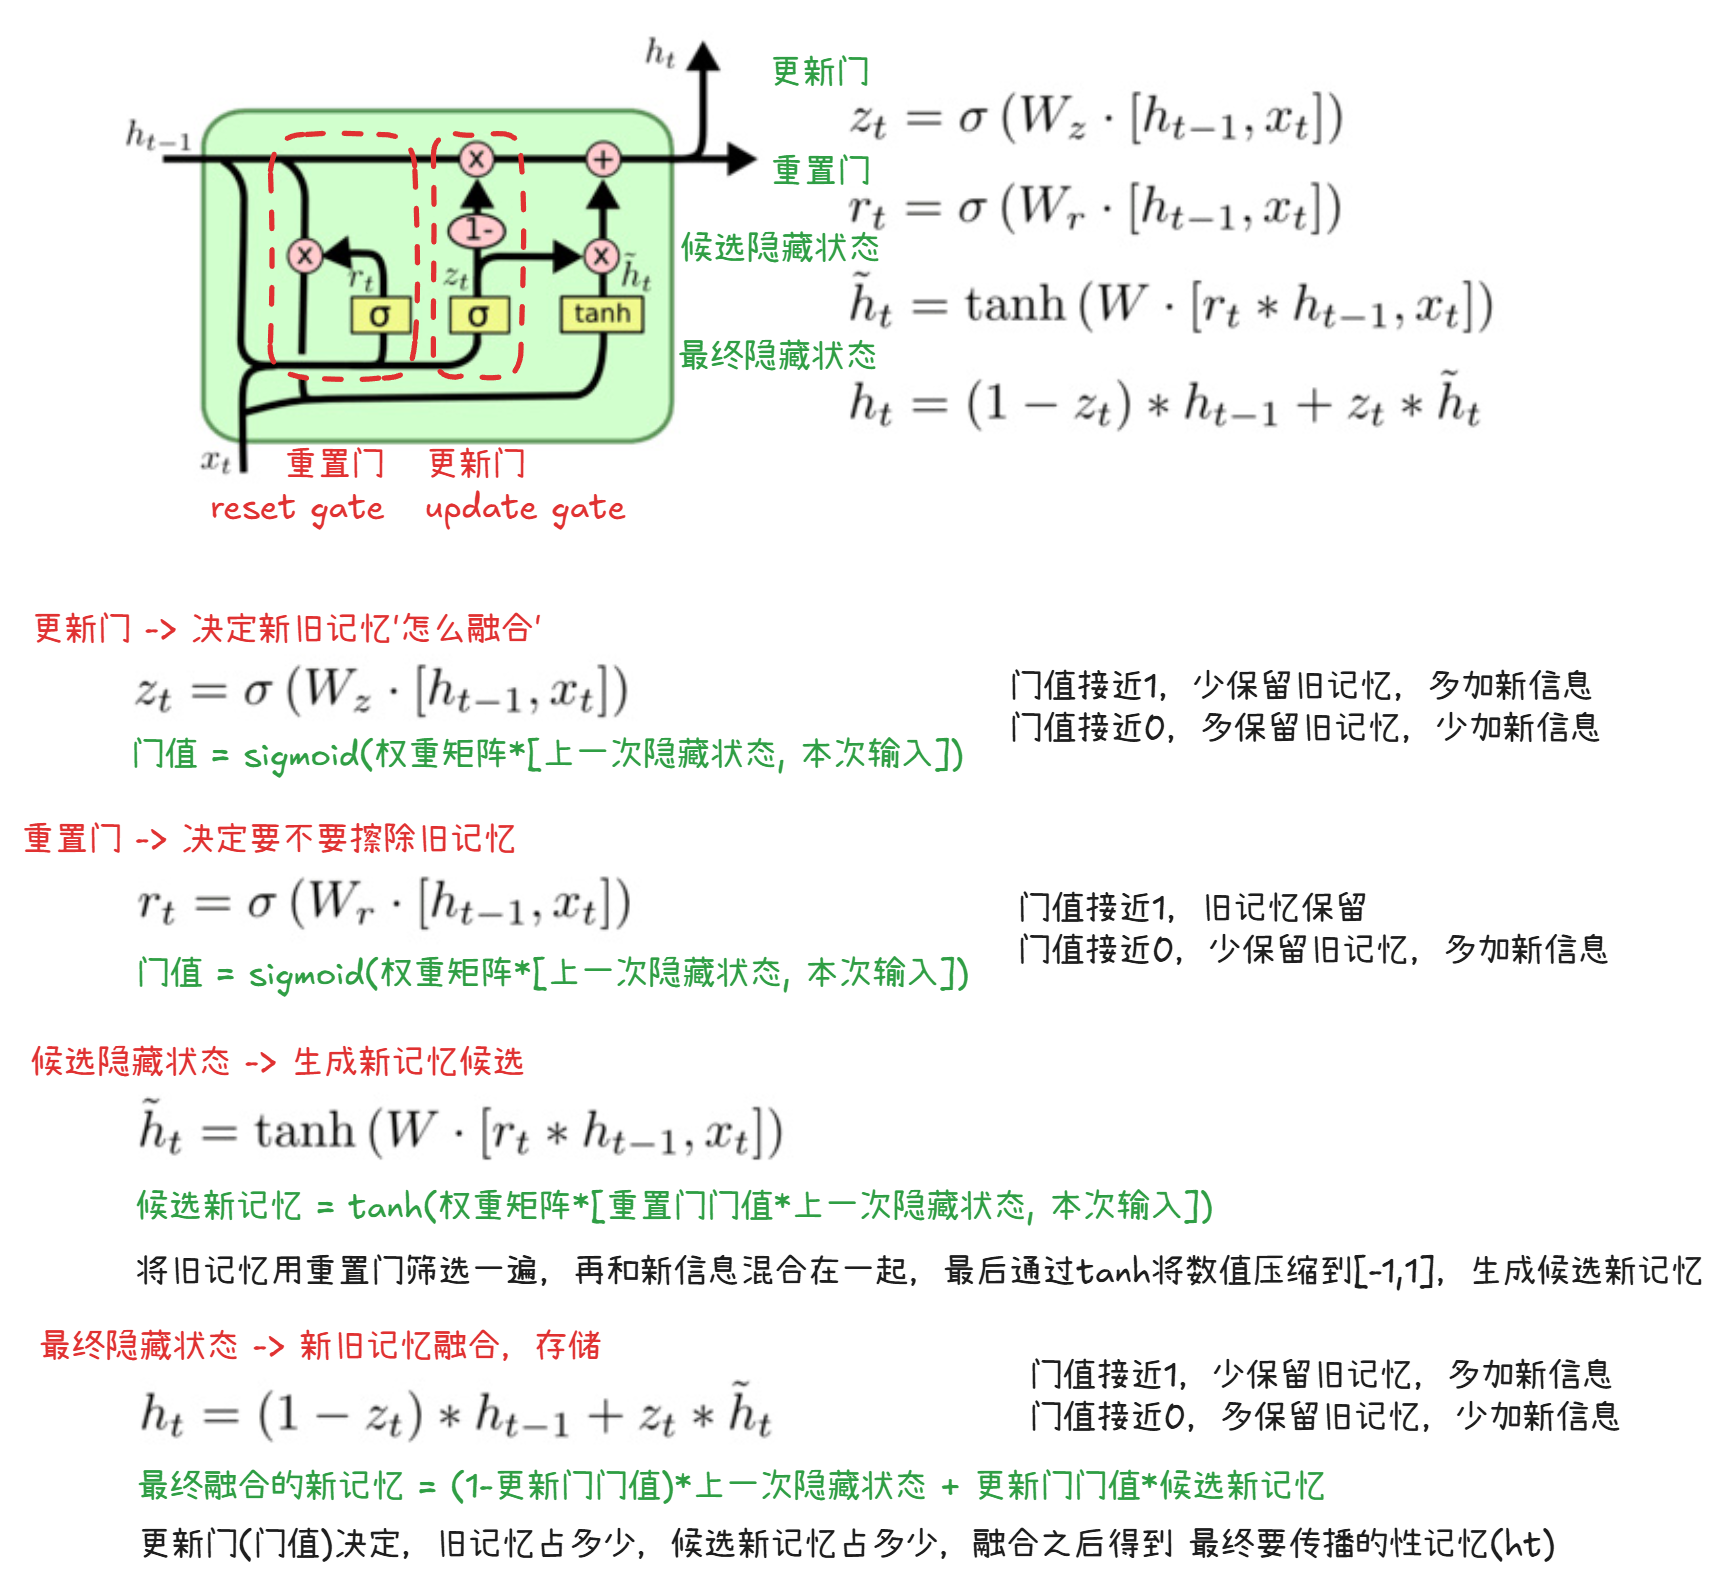
同时它的结构和计算要比LSTM更简单, 它的核心结构可以分为两个部分去解析:
- 更新门
- 重置门
GRU的核心:两个门+1个隐藏状态
- 两个门:重置门+更新门 -> 对比LSTM少1个门,更简单
- 隐藏状态:存关键信息,相当于“记忆本”,比LSTM的记忆细胞更简单
GRU 结构分析
优缺点
- GRU的优势:GRU和LSTM作用相同, 在捕捉长序列语义关联时, 能有效抑制梯度消失或爆炸, 效果都优于传统RNN且计算复杂度相比LSTM要小.
- GRU的缺点:GRU仍然不能完全解决梯度消失问题, 同时其作用RNN的变体, 有着RNN结构本身的一大弊端, 即不可并行计算, 这在数据量和模型体量逐步增大的未来, 是RNN发展的关键瓶颈.
代码示例
import torch
import torch.nn as nn

def lstm_base():
    # 创建LSTM模型
    gru = nn.GRU(input_size=5, hidden_size=6, num_layers=1)
    input = torch.randn(5, 3, 5)  # (seq_len, batch_size, input_size)
    h0 = torch.randn(1, 3, 6)     # (num_layers, batch_size, hidden_size)
    output, hn = gru(input, h0)
    print(gru)
    print(output.shape)  # [5, 3, 6] - (seq_len, batch_size, hidden_size)
    print(hn.shape)      # [1, 3, 6] - (num_layers, batch_size, hidden_size)

lstm_base()
Bi-GRU
Bi-GRU与Bi-LSTM的逻辑相同, 都是不改变其内部结构, 而是将模型应用两次且方向不同, 再将两次得到的GRU结果进行拼接作为最终输出