作用
核心作用:将杂乱、非结构化的原始文本转化为干净、规范、计算机易于处理的格式,通过去除噪声、统一标准,为后续的特征提取和模型训练奠定高质量的数据基础。
- 让文本语料符合模型输入要求
- 还能有效指导模型超参数的选择,提升模型评估指标
主要环节:
文本处理的基本方法:分词、词性标注 NER、命名实体识别 POS
文本张量的表示方法:one-hot、word2vec、wordEmbedding
文本语料的数据分析:标签数量分析(类别不均衡问题)、句子长度分析、词频统计和关键词词云
文本特征处理:添加 n-gram 特征、文本长度规范
数据增强方法:回译数据增强
文本处理的基本方法
分词
分词: 将连续的字序列按照一定的规范(语法)重新组合成词序列的过程
一般模型训练的时候,模型接受的文本基本最小单位是词语。在英文的行文中,单词之间是以空格作为自然分界符的,而中文只是字、句和段能通过明显的分界符来简单划界,唯独词没有一个形式上的分界符。分词过程就是找到这样分界符的过程。
作用:词作为语言语义理解的最小单元,是人类理解文本语言的基础。因此也是AI解决NLP领域高阶任务,如自动问答,机器翻译,文本生成的重要基础环节。
分词工具:jieba、IK、SnowNLP、pyltp、THULAC
'''


精确模式: 尽量将句子精确地切分


全模式:将句子所有可以成词的词语都进行切分


搜索引擎模式:在精确模式的基础上,对长词再次切分,提高召回率,适合搜索引擎


'''


import jieba


content = "我喜欢学习,我要学习自然语言处理"


# 返回 list


jieba.lcut(content, cut_all=False)  # 精确模式


jieba.lcut(content, cut_all=True)   # 全模式


jieba.lcut_for_search(content)      # 搜索引擎模式


# 返回 generator 生成器


# jieba.cut_for_search(content)


jieba.cut(content, cut_all=False)


'''


cut_all: False 精确模式(默认)、True 全模式


use_paddle: False pyjieba模式(默认), True paddlepaddle模式


'''
'''


自定义词典: 可以根据自定义词典,修改jieba分词方式,优先考虑词典里面的词来切分


格式:词语 词频(可省略) 词性(可省略)


dict.txt:中华大学 5 n


'''


content = "我来到北京中华大学"


jieba.load_userdict("./data/dict.txt")


jieba.lcut(content)
命名实体识别
命名实体识别(Named Entity Recognition,NER),识别出一段文本中可能存在的命名实体。
命名实体: 是指文本中指代现实世界中具体事物或概念的专有名词,通常包括人名、地名、组织机构名、日期时间、货币金额等。
核心价值:将文本中分散的关键信息转化为机器可读的数据,为搜索引擎、知识图谱构建、智能问答和情感分析等上层应用提供关键的语义元素。
词性标注
词性标注(Part Of Speech Tagging,POS),标注出一段文本中每个词汇的词性。
词性:语言中对词的一种分类方法,以语法特征为主要依据、兼顾词汇意义对词进行划分的结果,常见的词性有14种,如: 名词, 动词, 形容词等。
核心价值:消除词语的歧义并为语法结构分析提供基础,帮助计算机理解词语在上下文中的具体功能和含义,从而为句法分析、信息抽取和机器翻译等任务提供支撑。
import jieba.posseg as pseg


content = "我来到北京清华大学"


words = pseg.lcut(content)  # 词性标注


for word, flag in words:


    print(word, flag)  # 词语 词性
jieba词性对照表
- a 形容词


    - ad 副形词


    - ag 形容词性语素


    - an 名形词


- b 区别词


- c 连词


- d 副词


    - df


    - dg 副语素


- e 叹词


- f 方位词


- g 语素


- h 前接成分


- i 成语


- j 简称略称


- k 后接成分


- l 习用语


- m 数词


    - mg


    - mq 数量词


- n 名词


    - ng 名词性语素


    - nr 人名


    - nrfg


    - nrt


    - ns 地名


    - nt 机构团体名


    - nz 其他专名


- o 拟声词


- p 介词


- q 量词


- r 代词


    - rg 代词性语素


    - rr 人称代词


    - rz 指示代词


- s 处所词


- t 时间词


    - tg 时语素


- u 助词


    - ud 结构助词 得


    - ug 时态助词


    - uj 结构助词 的


    - ul 时态助词 了


    - uv 结构助词 地


    - uz 时态助词 着


- v 动词


    - vd 副动词


    - vg 动词性语素


    - vi 不及物动词


    - vn 名动词


    - vq


- x 非语素词


- y 语气词


- z 状态词


    - zg
文本张量的表示方法
文本张量表示:将一段文本使用张量进行表示,将词汇表示成向量(词向量),再由各个词向量按顺序组成矩阵形成文本表示。即:用词向量的形式来描述文本
作用:将文本表示成张量(矩阵)形式,能够使语言文本可以作为计算机处理程序的输入,进行接下来一系列的解析工作。
One-Hot 词向量表示
One-Hot 又称独热编码
将每个词表示成具有n个元素的向量,向量中只有一个元素是1,其他元素都是0,不同词汇元素为1的位置不同
n 的大小是整个语料中不同词汇的总数,即词表的大小
优缺点:
优点:操作简单,容易理解
缺点:1、相似度为0;2、大语料情况下,占用大量资源;3、完全割裂了词与词的关系
import jieba    # 分词


import joblib  # 用于对象保存与加载


from tensorflow.keras.preprocessing.text import Tokenizer  # 词汇映射器


# 获取one-hot编码


def get_one_hot(text):


    tokenizer = Tokenizer()  # 创建一个映射器


    tokenizer.fit_on_texts(text)   # 在语料库上训练


    vocabs = tokenizer.word_index  # 获取映射关系


    print(vocabs)


    # one-hot编码


    for vocab in vocabs:


        # 语料库的列表


        zero_list = [0] * len(vocabs)


        # 获取当前词汇的索引(索引从1开始)


        idx = tokenizer.word_index[vocab] - 1


        # 将当前索引位置的元素设置为1


        zero_list[idx] = 1


        print(vocab, zer_list)


    # 保存映射关系


    joblib.dump(tokenizer, './model/tokenizer')


    print('模型保存成功!\n')


# 使用one-hot编码


def use_one_hot(token):


    tokenizer = joblib.load('./model/tokenizer')


    print(f"词汇表:{tokenizer.word_index}")


    zero_list = [0] * len(tokenizer.word_index)


    idx = tokenizer.word_index[token] - 1


    zero_list[idx] = 1


    print(token, zero_list)


if __name__ == '__main__':


    text = {"周杰伦", "陈奕迅", "王力宏", "张学友", "林志玲"}


    get_one_hot(text)


    token = "张学友"


    use_one_hot(token)
# 简易版:获取one-hot编码


def get_one_hot_easy(text):


    vocabs = {word:i for i, word in enumerate(text)}


    for vocab in vocabs:


        zero_list = [0] * len(vocabs)


        idx = vocabs[vocab]


        zero_list[idx] = 1


        print(vocab, zero_list)


text = {"周杰伦", "陈奕迅", "王力宏", "张学友", "林志玲"}


get_one_hot_easy(text)
Word2Vec
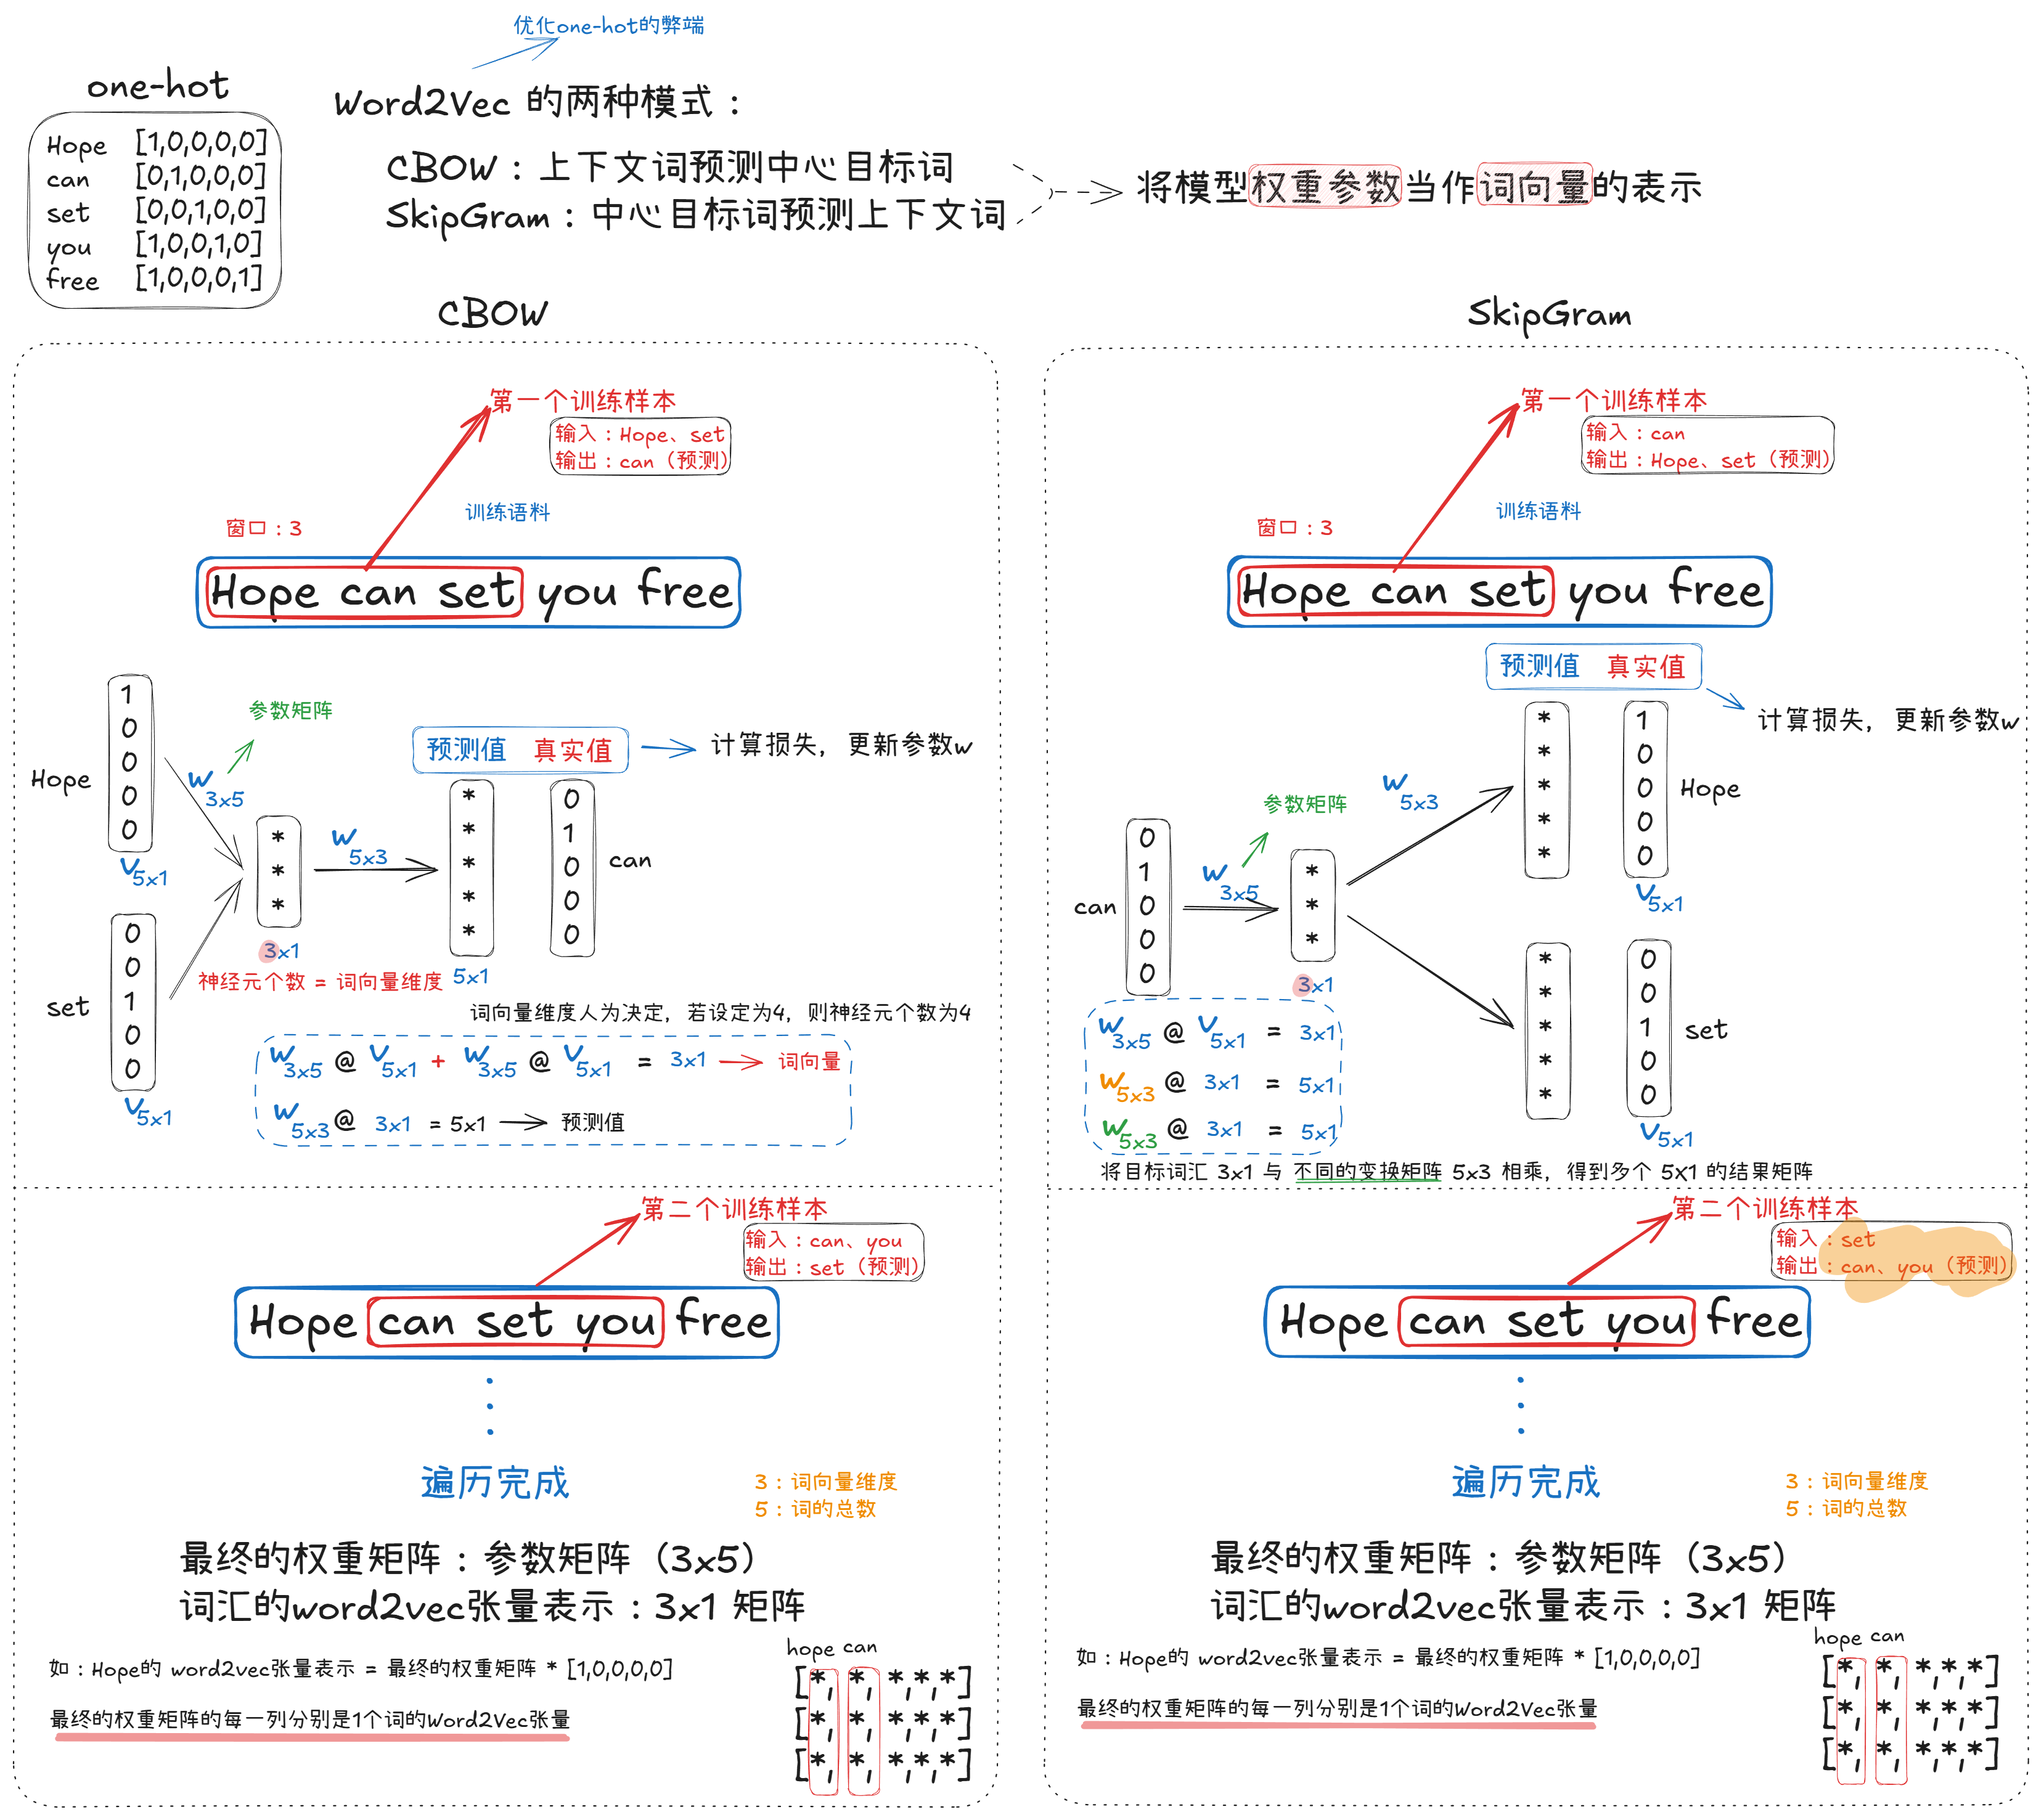
将词汇表示成向量的无监督训练方法
构建神经网络模型,将网络参数作为词汇的向量表示
训练模式:CBOW、skipgram
CBOW(Continuous bag of words,又称为连续词袋模型):给定一段用于训练的文本语料,再选定某段长度(窗口)作为研究对象,使用上下文词汇预测目标词汇
skipgram( 又称为跳字模式) :给定一段用于训练的文本语料,再选定某段长度(窗口)作为研究对象,使用目标词汇预测上下文词汇
代码示例
pythonimport fasttext def fasttext_train_save_load(): # 训练模型,无监督 model = fasttext.train_unsupervised('./data/word2vec/fil9', lr=0.1, epoch=1) # 参数: # - model:skipgram(默认)、cbow # - lr:学习率(默认为0.05) # - epoch: 训练循环次数(默认为5) # - thread: 线程(默认为 cpu_count() - 1 ) # 保存模型 model.save_model('./model/word2vec_fil9.bin') # bin: 二进制文件 def fasttext_load_model(word): # 加载模型 model = fasttext.load_model('./model/word2vec_fil9.bin') # 获取词向量 results = model.get_word_vector(word) print('词向量的维度为:', len(results)) print('词向量:\n', results) # 获取相似词 results = model.get_nearest_neighbors(word) print('最相似的10个词为:\n', results) if __name__ == '__main__': fasttext_train_save_load() word = 'pig' fasttext_load_model(word)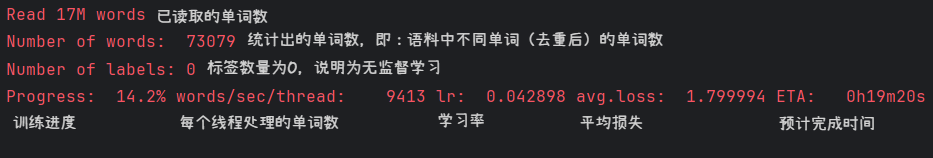
fil9:124M words
Word Embedding
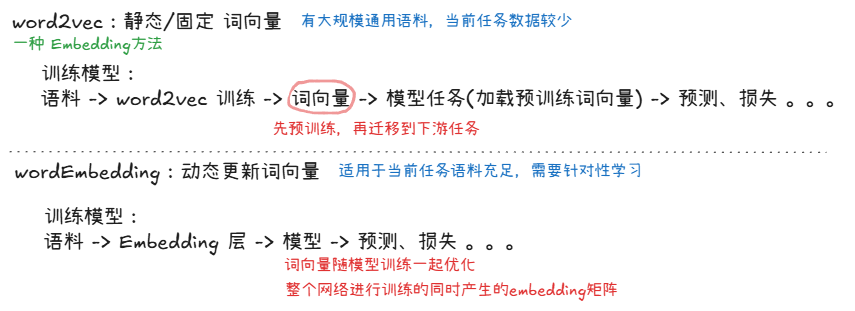
- 将词汇映射到指定维度(一般是更高维度)的空间
代码示例
pythonimport jieba import torch import torch.nn as nn from torch.utils.tensorboard import SummaryWriter # 可视化映射器 from tensorflow.keras.preprocessing.text import Tokenizer # 词汇映射器 # 1. 文本分词:将原始句子转换为词列表 sentence1 = 'I like eating apples.' sentence2 = 'I like eating oranges.' sentences = [sentence1, sentence2] word_list = [] # 词列表 for sentence in sentences: word_list.append(jieba.lcut(sentence)) print(word_list) # 2. 文本序列化:建立词汇表,将词映射为唯一整数索引 tokenizer = Tokenizer() # 词汇映射器 tokenizer.fit_on_texts(word_list) # 训练 print(tokenizer.word_index) # 词索引 dict_values = tokenizer.word_index.values() # 词索引值 print(dict_values) # 分词文本 -> 词索引 sequences = tokenizer.texts_to_sequences(word_list) print(sequences) # 3. 词嵌入层:将离散词索引映射为连续稠密向量 emb = nn.Embedding(num_embeddings=len(dict_values), embedding_dim=8) # 查看词嵌入层的权重参数(随机初始化的词向量) print(f'embedding:{emb.weight.data}') print(f'embedding.shape:{emb.weight.data.shape}') # 4. 词向量可视化:使用 TensorBoard 的 Embedding Projector summary = SummaryWriter(log_dir='./runs') summary.add_embedding(mat=emb.weight.data, metadata=dict_values) # - mat:词向量矩阵 # - metadata:词向量对应的列表,用来标注每个点的位置 summary.close() # 关闭写入器 # 5. 词向量详情查看:遍历输出每个词的向量表示 for idx in range(len(tokenizer.word_index)): word = tokenizer.index_word[idx + 1] temp_vector = emb(torch.tensor(idx)) print(f'{word}:{temp_vector.detach().numpy()}')在终端启动 tensorboard 服务
python$ cd ~ # 进入当前代码的目录 $ tensorboard --logdir=runs --host 0.0.0.0 # 通过http://localhost:6006/访问浏览器可视化页面
文本数据分析
作用:快速检查出语料可能存在的问题,并指导模型训练中超参的选择
例如:
数据质量类:错别字、语法错误、重复内容、缺失值 ...
数据均衡类:标签分布不均、句子长度不同
文本分析的方式(重点):
标签的数量分布
获取句子长度分布
词频统计
关键字词云
import jieba


import jieba.posseg as pseg     # 词性标注


import pandas as pd


import seaborn as sns           # 绘图


import matplotlib.pyplot as plt # 绘图


from itertools import chain     # 迭代器


from wordcloud import WordCloud # 词云


plt.rcParams['font.sans-serif'] = ['SimHei']


plt.rcParams['axes.unicode_minus'] = False
# 数据集:真实的中文酒店评论语料


train_data = pd.read_csv('data\\data_analysis\\train.tsv', sep='\t')


dev_data = pd.read_csv('data\\data_analysis\\dev.tsv', sep='\t')


# 添加:句子长度列


# train_data['sentence_length'] = train_data['sentence_length'].apply(lambda x: len(x))


train_data['sentence_length'] = list(map(lambda x: len(x), train_data['sentence'])) # 效果同上


dev_data['sentence_length'] = list(map(lambda x: len(x), dev_data['sentence']))
计算标签分布
检查正负样本比例是否维持在1:1左右
def label_distribution():


    # 统计训练集标签的0(负)和1(正)的分组数量并可视化


    sns.countplot(x='label', data=train_data, hue='label', legend=False)


    plt.title('train_data')


    plt.show()


    # 统计验证集标签的0(负)和1(正)的分组数量并可视化


    sns.countplot(x='label', data=dev_data, hue='label', legend=False)


    plt.title('dev_data')


    plt.show()


label_distribution()
句子长度分布
可以得知语料中大部分句子长度的分布范围
def sentence_lengths_distribution():


    # 绘制句子长度分布


    sns.countplot(x='sentence_length', data=train_data)  # 绘制直方图


    plt.title('训练集句子长度分布_直方图')


    plt.xticks([])


    plt.show()


    sns.displot(x='sentence_length', data=train_data, kde=True)  # 绘制密度图(曲线)


    plt.title('训练集句子长度分布_密度图')


    plt.show()


sentence_lengths_distribution()
正负样本长度散点分布
可以有效定位异常点的出现位置
def scatter_lengths():


    # 正负样本长度散点图


    sns.stripplot(x='label', y='sentence_length', data=train_data)


    plt.title('训练集-正负样本长度散点分布')


    plt.show()


    sns.stripplot(x='label', y='sentence_length', data=dev_data)


    plt.title('测试集-正负样本长度散点分布')


    plt.xlabel('label')


scatter_lengths()
词频统计
不同词汇总数统计
def word_frequency():


    train_vocab = set(chain(*map(lambda x: jieba.lcut(x), train_data['sentence'])))


    print(f"训练集的词数:{len(train_vocab)}")


    test_vocab = set(chain(*map(lambda x: jieba.lcut(x), dev_data['sentence'])))


    print(f"测试集的词数:{len(test_vocab)}")


    return train_vocab, test_vocab


word_frequency()
词云
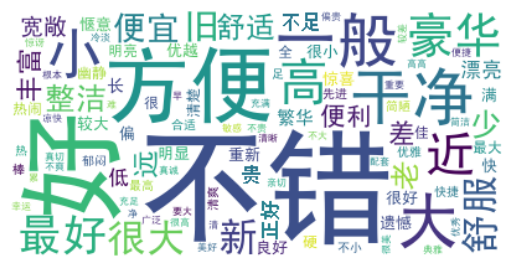
根据高频词云,可对语料质量进行简单评估
# 获取文本中形容词列表


def get_adj_list(text):


    adj_list = []


    # 词性标注, value = 词 + 词性


    for value in pseg.cut(text):


        if value.flag == 'a':


            adj_list.append(value.word)


    return adj_list


# 基于给定的词列表,生成词云


def generate_wordcloud(word_list):


    # 实例化词云生成器


    wc = WordCloud(font_path='./data/data_analysis/SimHei.ttf', max_words=100, background_color='white')


    # list -> str


    word_str = ' '.join(word_list)


    # 生成词云


    wc.generate(word_str)


    # 绘制词云


    plt.figure()


    plt.imshow(wc, interpolation='bilinear')  # interpolation='bilinear'(插值方法: 双线性插值)


    plt.axis('off')


    plt.show()


# 基于数据集正样本中的所有形容词,生成词云


def adj_wordcloud(text):


    # 获取训练集正样本


    p_train_data = text[text['label'] == 1]['sentence']


    # 获取训练集正样本中的所有形容词


    adj_list = list(chain(*map(lambda x: get_adj_list(x), p_train_data)))


    # 生成词云


    generate_wordcloud(adj_list)


adj_wordcloud(train_data)


adj_wordcloud(dev_data)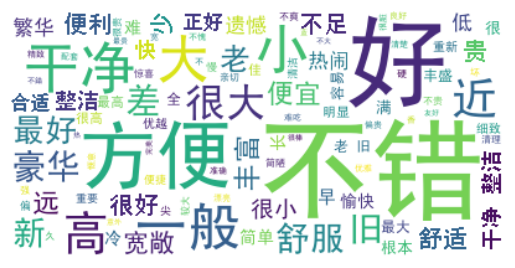
文本特征处理
作用:为语料添加具有普适性的文本特征
文本特征处理方法:
添加 n-gram 特征
规范文本长度
n-gram
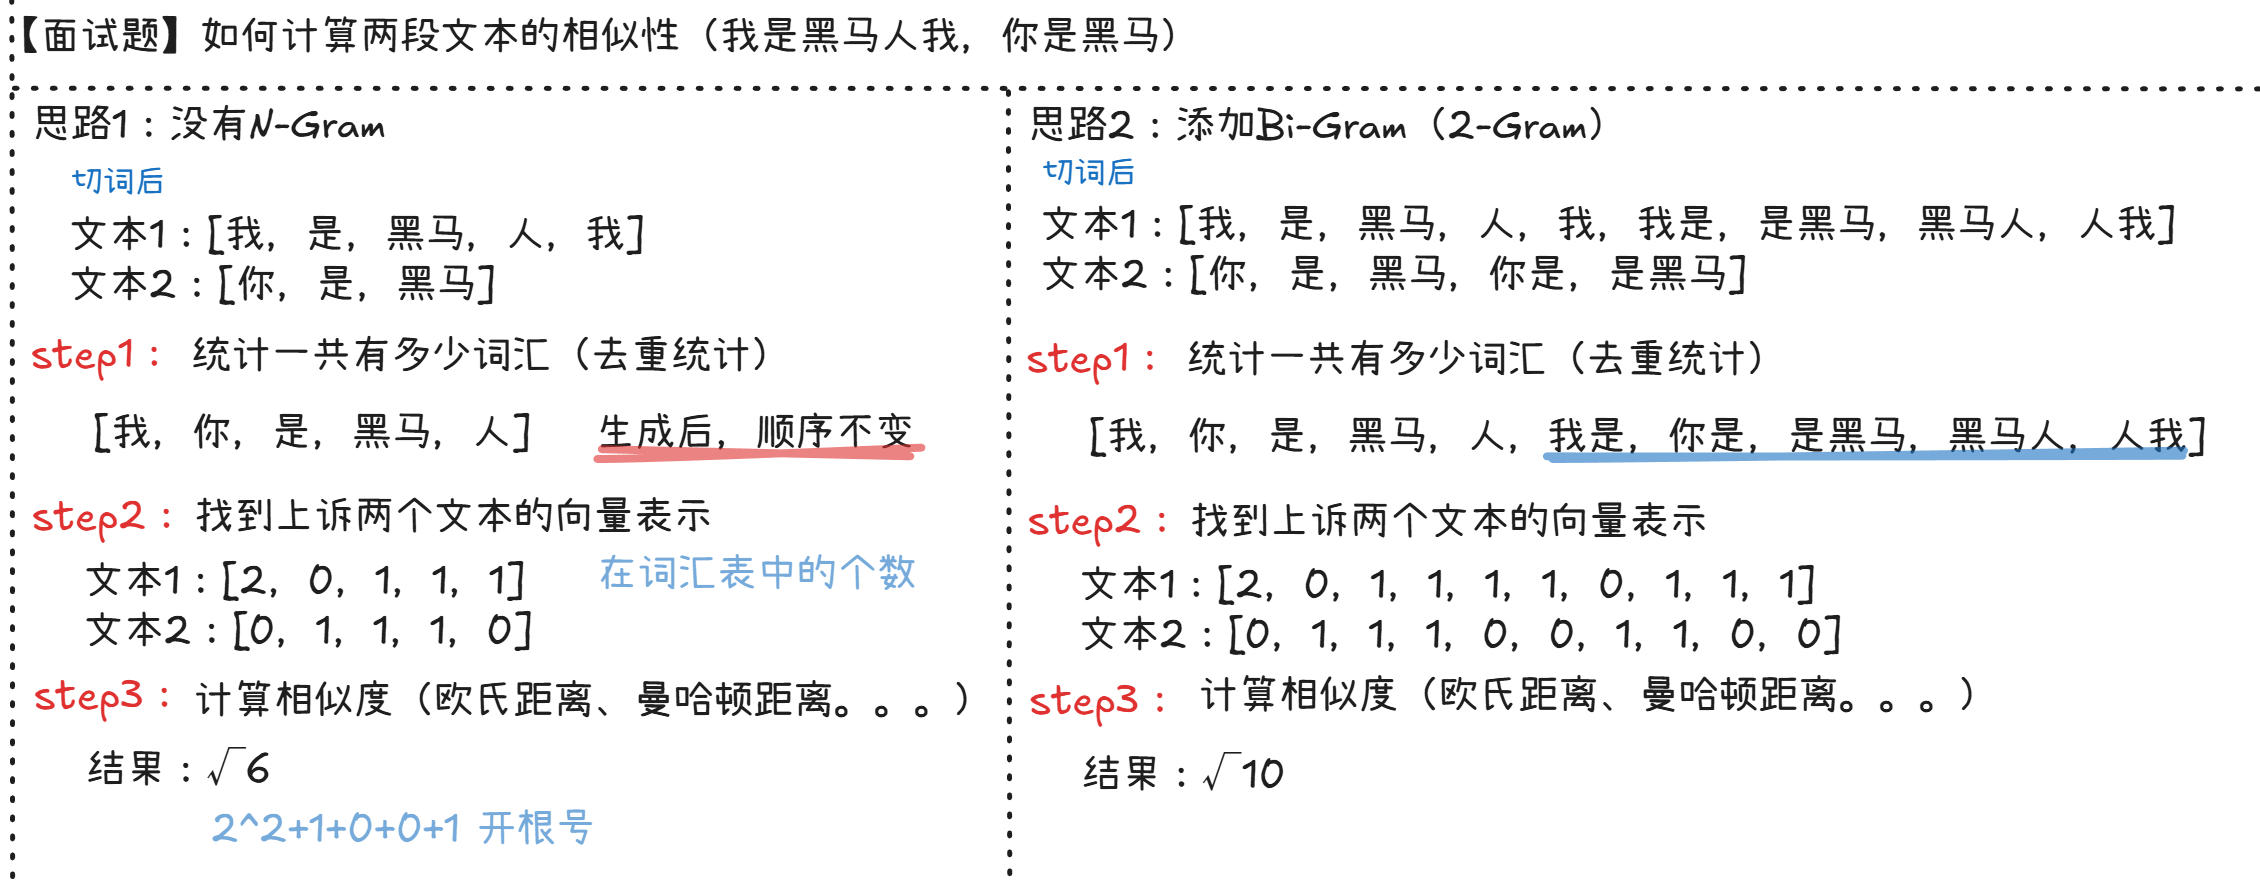
n-gram:将n个连续相邻的token组合到一起,作为新的特征
本质:让计算机更好地理解文本规律
例如:“是谁”,“敲动”,“我心”,单看敲动来讲,不知道敲动什么,如果结合后续词就变成了“敲动我心”,计算机就能用这些特征做情感分析,可能和浪漫有关系
n-gram 的分类:1-gram(Uni-Gram)、2-gram(Bi-Gram)、3-gram(Tri-Gram)
n_gram = 2


# 生成 2-gram 特征


def create_ngram(input_list):


    sliced_list = [input_list[i:] for i in range(2)]


    ngram_tuples = list(zip(*sliced_list))


    return set(ngram_tuples)


result = create_ngram(['我', '是', '小', '明'])


print(result)
规范文本长度
意义: 模型一般需要固定尺寸的输入,因此需要对文本句子进行补齐(一般用0补齐)或者截断
# 通过 API 规范文本长度


from tensorflow.keras.preprocessing import sequence


def pad_sequence(text, max_len):


    # 待处理的文本张量,最大长度,截断方式(post:从后往前截取),填充方式(post:后填充)


    return sequence.pad_sequences(text, maxlen=max_len, truncating='post', padding='post')


# 手写代码


def paddomg_custom(text, max_len):


    lst = []


    for value in text:


        # 处理超长文本


        if len(value) > max_len:


            value = value[:max_len]


        else:


            lst.append(value + [0] * (max_len - len(value)))


    return lst


text = [[1, 23, 5, 32, 55, 63, 2, 21, 78, 32, 23, 1],


        [2, 32, 1, 23, 1]]


result1 = pad_sequence(text, 10)


result2 = paddomg_custom(text, 100)


print(result1)


print(result2)
文本数据增强
回译数据增强法:将文本数据翻译成另一种语音,之后再翻译回原语音,即可认为得到与原语料同标签的新语料。新语料加入到原数据集中,即可认为是对原数据集的数据增强
优势:操作简便, 获得新语料质量高
问题:在短文本回译过程中, 新语料与原语料可能存在很高的重复率, 并不能有效增大样本的特征空间.
高重复率解决办法:进行连续的多语言翻译, 如: 中文→韩文→日语→英文→中文, 根据经验, 最多只采用3次连续翻译, 更多的翻译次数将产生效率低下, 语义失真等问题.
import requests


def dm_translate():


    url = 'http://fanyi.youdao.com/translate'


    # 第一次翻译,目标语言英文


    text1 = '这个价格非常便宜'


    data1 = {'from': 'zh-CHS', 'to': 'en', 'i': text1, 'doctype': 'json'}


    response1 = requests.post(url=url, params=data1)


    res1 = response1.json()


    # 打印第一次翻译结果


    print(res1)


    # 第二次翻译, 目标语言中文


    text2 = 'The price is very cheap'


    data2 = {'from': 'en', 'to': 'zh-CHS', 'i': text2, 'doctype': 'json'}


    response2 = requests.post(url=url, params=data2)


    res2 = response2.json()


    # 打印第二次翻译结果


    print(res2)
'AUTO': '自动检测语言'


'zh-CHS': '中文',


'en': '英文'


'ja': '日语'


'ko': '韩语'


'fr': '法语'


'de': '德语'