线性回归
基本概念
线性回归(Linear regression)
利用 回归方程(函数) 对 一个或多个自变量(特征值)和因变量(目标值)之间 关系进行建模的一种分析方式。
通过拟合一个线性模型(超平面)来预测连续型目标变量。
输入/输出:
- 输入:特征向量
- 输出:连续值
数学模型
预测函数
预测函数(又称为:假设函数,hypothesis function)
线性回归的预测函数是输入特征的线性组合,根据特征数量可分为:
一元线性回归(单特征):
目标值只与一个因变量有关
【案例】通过身高预测体重
多元线性回归(多特征):
目标值与多个因变量有关
线性组合形式(显式偏置)
- :输入特征向量(不含常数项)
- :权重向量
- :偏置(bias / intercept)
矩阵形式(增广向量表示)
- :增广特征向量
- :增广权重向量
损失函数
损失函数(Loss Function,也叫代价函数、成本函数、目标函数 Cost Function):衡量每个样本预测值与真实值效果的函数
损失函数是对每个样本预测误差进行非负变换后,再聚合(求和或平均)得到的标量值。
损失函数 = 用来描述每个样本 和 其预测值之间关系的
= 各个样本的误差和让损失函数最小,即让模型整体预测误差最小,拟合效果越好。
红色直线能更好的拟合所有点,即误差最小,误差和最小
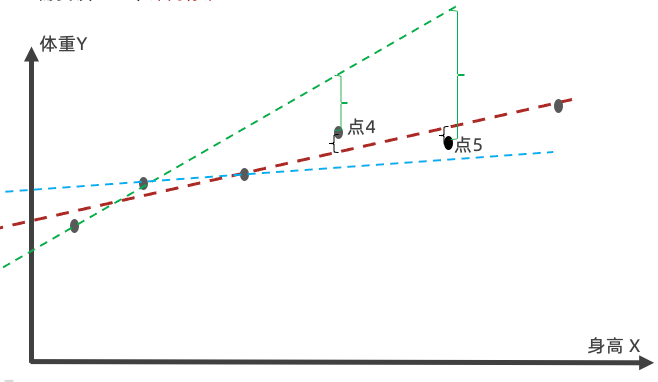
最小化误差平方和(Sum Squares Error,SSE):最小二乘法
均方误差(Mean-Square Error,MSE) :
【注】此处引入 仅为简化计算
均方根误差(Root Mean Square Error, RMSE)
平均绝对误差(Mean Absolute Error,MAE)
- :样本数量
- 目标:最小化
优化方法
正规方程法
一元线性回归
损失函数:
偏导数:
正规方程法:
将数据带入两式,即可求解
多元线性回归
模型:
损失函数:
正规方程:$w=(X^⊤X)^{−1}X^⊤y $
梯度下降算法(Gradient Descent)
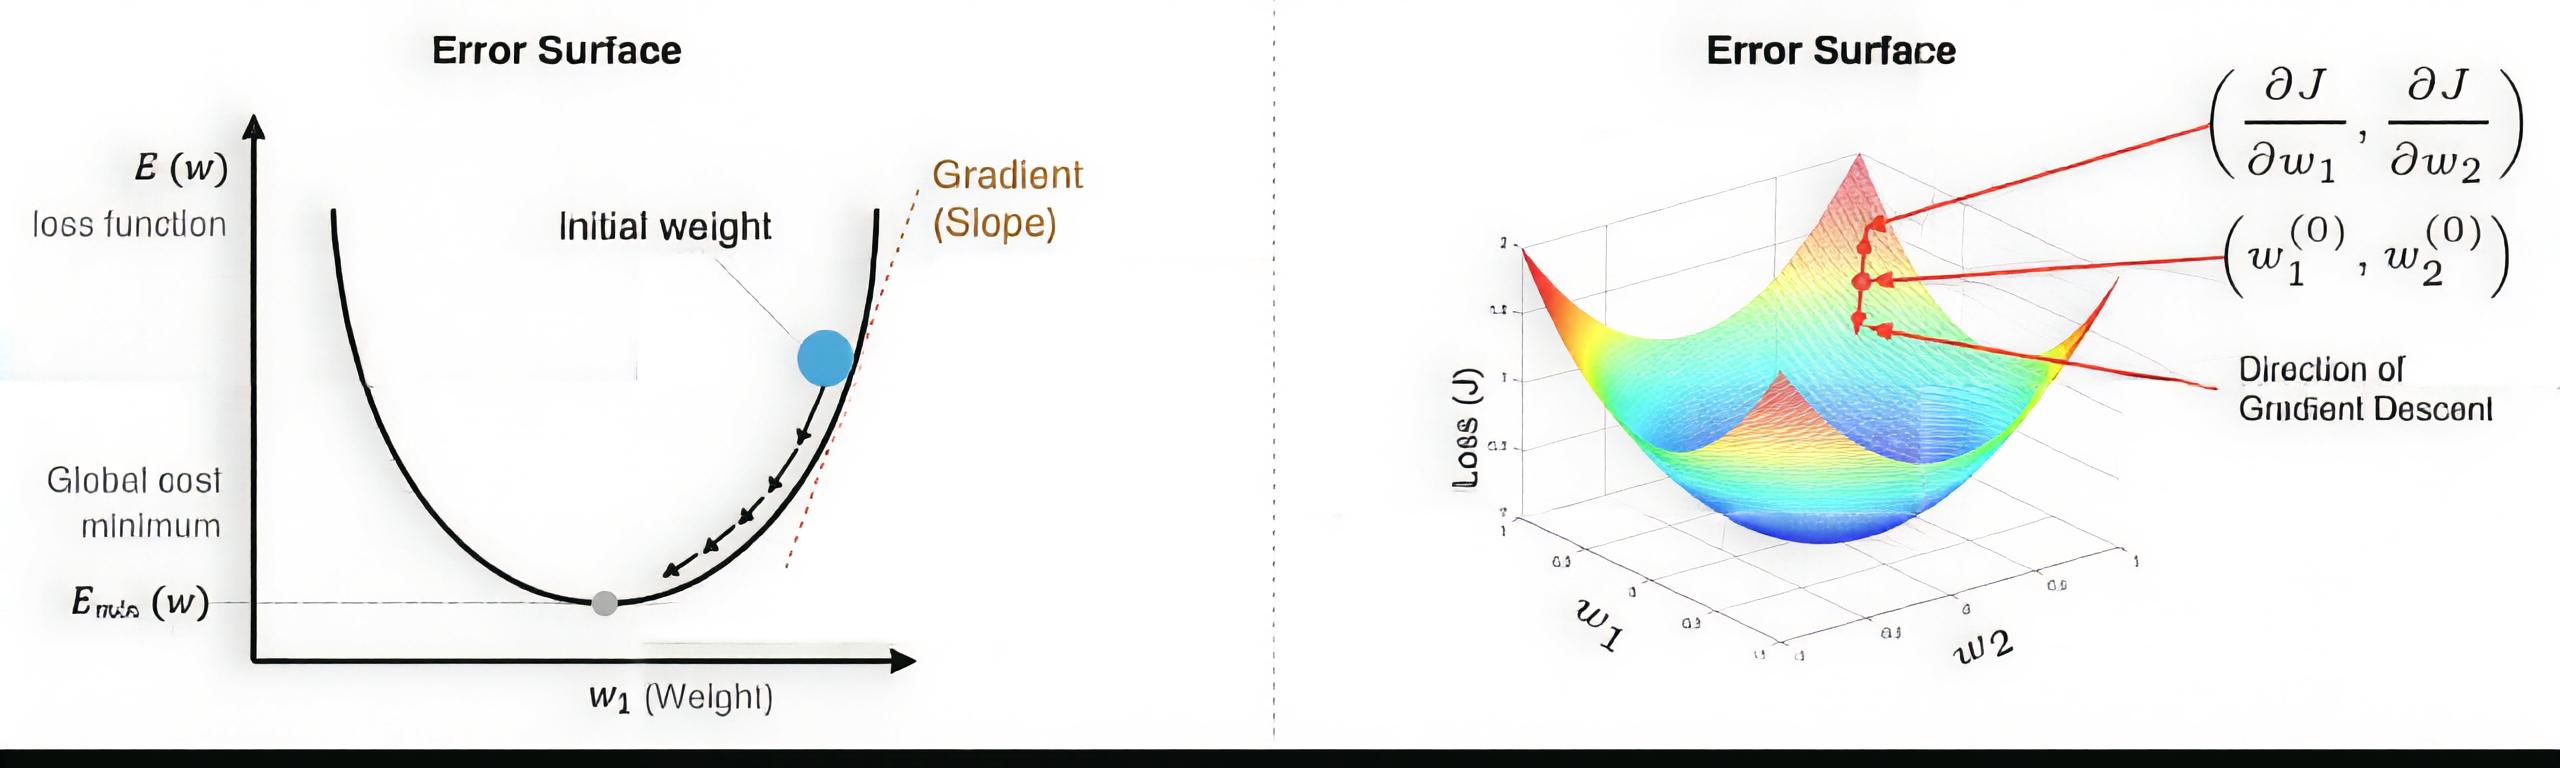
什么是梯度下降法
顾名思义,沿着梯度下降的方向求解极小值
寻找使得损失函数最小化的方法。
举个例子:坡度最陡下山法
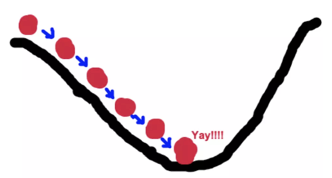
- 输入:初始化位置S;每步距离为a 。输出:从位置S到达山底
- 步骤1:令初始化位置为山的任意位置S
- 步骤2:在当前位置环顾四周,如果四周都比S高返回S;否则执行步骤3
- 步骤3: 在当前位置环顾四周,寻找坡度最陡的方向,令其为x方向
- 步骤4:沿着x方向往下走,长度为a,到达新的位置S‘
- 步骤5:在S‘位置环顾四周,如果四周都比S‘高,则返回S‘。否则转到步骤3
小结:通过循环迭代的方法不断更新位置S (相当于不断更新权重参数w)
单变量 和 多变量 的梯度下降
- 单变量函数中,梯度就是某一点切线斜率(某一点的导数);有方向为函数增长最快的方向
- 多变量函数中,梯度就是某一个点的偏导数;有方向:偏导数分量的向量方向
梯度下降
参数更新规则:
- “ ” 表示赋值操作(即原地更新)
- :学习率(步长)【机器学习中:0.001~0.01】
- 损失函数
- 梯度 是一个向量,指向 增长最快的方向
- 梯度下降公式:
下个点 = 当前点 - 学习率*损失函数 - 循环迭代求当前点的梯度,更新当前的权重参数
- 梯度是上升最快的方向,而需要的是下降最快的方式,所以要加负号
批量梯度下降
损失函数(以均方误差为例):
对每个参数 求偏导:
参数同步更新(所有 同时更新):
梯度下降优化过程:
给定初始位置、步长(学习率)
计算该点当前的梯度的负方向
向该负方向移动步长
重复 2-3 步 直至收敛
- 两次差距小于指定的阈值
- 达到指定的迭代次数
学习率(Learning rate,步长)
- 步长决定了在梯度下降迭代的过程中,每一步沿梯度负方向前进的长度
- 学习率太小,下降的速度会很慢
- 学习率太大,容易造成错过最低点、产生下降过程中的震荡、甚至梯度爆炸
梯度下降算法 分类
全梯度下降算法 FGD (Full Gradient Descent)
每次迭代时,使用全部样本的梯度值。
公式:
有 个样本,求梯度时用了所有 个样本。
小批量梯度下降算法 mini-batch
每次迭代时,随机选择并使用小批量的样本梯度值。
从 个样本中,选择 个样本进行迭代( )。
公式:
【注】若
batch_size=1,则变成了 SGD;若batch_size=m,则变成了 FGD。随机梯度下降算法 SGD
每次迭代时,随机选择并使用一个样本梯度值。
公式:
from sklearn.linear_model import SGDRegressor
随机平均梯度下降算法 SAG
每次迭代时,随机选择一个样本的梯度值和以往样本梯度值的均值。
公式:
步骤:
- 随机选择一个样本,假设选择 样本,计算其梯度值并存储到列表 ,然后使用列表中的梯度值均值,更新模型参数。
- 随机再选择一个样本,假设选择 样本,计算其梯度值并存储到列表 ,然后使用列表中的梯度值均值,更新模型参数。
- 随机再选择一个样本,假设又选择了 样本,重新计算该样本梯度值,并更新列表中 样本的梯度值,使用列表中梯度值均值,更新模型参数。
- 以此类推,直到算法收敛。
| 算法名称 | 全梯度下降算法 (FGD) | 随机梯度下降算法 (SGD) | 小批量梯度下降算法 (mini-batch) | 随机平均梯度下降算法 (SAG) |
|---|---|---|---|---|
| 描述 | 使用全部数据集进行梯度计算 | 每次迭代使用一个样本进行梯度计算 | 结合了SGD的胆大和FG的细心,表现居于SG和FG之间 | 每轮梯度更新结合了上一轮梯度值 |
| 优点 | 训练速度较慢 | 简单、高效、不稳定 | 避免了FG运算效率低成本大和SG收敛效果不稳定的缺点 | 训练初期表现不佳,优化速度较慢 |
| 缺点 | 容易陷入局部最优解 |
目前使用较多:小批量梯度下降
梯度下降 & 正规方程
梯度下降:
- 需要选择学习率
- 需要迭代求解
- 特征数量较大可以使用
- 应用场景:更加普适,迭代的计算方式,适合于嘈杂、大数据应用场景
- 注意:梯度下降在各种损失函数(目标函数)求解中大量使用。深度学习中更是如此,深度学习模型参数很轻松就上亿,只能通过迭代的方式求最优解。
正规方程:
- 不需要学习率
- 一次运算得出,一蹴而就
- 应用场景:小数据量场景、精准的数据场景
- 缺点:计算量大、容易受到噪声、特征强相关性的影响
- 注意: 的逆矩阵不存在时,无法求解
- 注意:计算 的逆矩阵非常耗时
- 如果数据规律不是线性的,无法使用或效果不好