案例
自动微分
梯度基本计算
import torch


# 创建张量


w = torch.tensor(10, requires_grad=True, dtype=torch.float)


                        # requires_grad 表示是否需要计算梯度(仅支持浮点型)


print(f'初始权重为:{w}')                                   # 初始权重为:10.0


# 损失函数


loss = 2 * w ** 2


print(f'梯度函数类型为:{type(loss.grad_fn)}')              # 梯度函数类型为:<class 'MulBackward0'>


print(f'梯度函数求和为:{loss.sum()}')                      # 梯度函数求和为:200.0


# 计算梯度,梯度 = 损失函数的导数


loss.sum().backward()   # 计算结果返回到 w.grad


                        # 使用 sum() 可保证loss结果为标量


print(f'梯度为:{w.grad}')                                  # 梯度为:40.0


# 带入 权重更新公式:w = w - lr * w.grad


w.data = w.data - 0.01 * w.grad


print(f'更新后的权重为:{w}')                               # 更新后的权重为:9.98
梯度下降最优解
import torch


# 创建张量


w = torch.tensor(10, requires_grad=True, dtype=torch.float)


print(f'初始权重为:{w}')


# 求最优解


for i in range(1, 101):


    # 正向计算(前向传播)


    loss = w ** 2 + 20


    # 梯度清零(梯度默认是累加的,所以每次迭代前要清零)


    if w.grad is not None:   # 确保梯度不为None


        w.grad.zero_()


    # 计算梯度(反向传播)


    loss.sum().backward()


    # 权重更新


    w.data = w.data - 0.01 * w.grad


    print(f'第{i}次迭代,loss为:{loss:.5f},梯度为:{w.grad:.5f},权重为:{w:.5f}')


print(f'【最终结果】loss为:{loss},梯度为:{w.grad},权重为:{w}')
detach()
import torch


import numpy as np


t1 = torch.tensor([10, 20], requires_grad=True, dtype=torch.float)


print(f't1: {t1}, type: {type(t1)}')


t2 = t1.detach()  # 返回一个新张量 t2,它与 t1 共享底层数据内存,用于阻断梯度反向传播


                  # 不可自动微分(自动梯度计算)


print(f't2: {t2}, type: {type(t2)}')


print(f't1.requires_grad: {t1.requires_grad}')


print(f't2.requires_grad: {t2.requires_grad}')  # False


# torch.Tensor -> numpy.ndarray


# n = t1.numpy() # 错误,张量自动微分后无法直接转换为numpy


n1 = t2.numpy()


n2 = t1.detach().numpy()
自动微分的真实应用场景
import torch


x = torch.ones(2, 5)


print(f'x: {x}')


y = torch.zeros(2, 3)


print(f'y: {y}')


w = torch.randn(5, 3, requires_grad=True)


print(f'w: {w}')


b = torch.randn(3, requires_grad=True)


print(f'b: {b}')


z = torch.matmul(x, w) + b  # 前向传播(正向传播),计算出 预测值(z)


print(f'z: {z}')


loss = torch.nn.MSELoss()   # 损失函数


l = loss(z, y)              # 计算损失


print(f'loss: {l}')


l.backward()  # 反向传播


print(f'w.grad: {w.grad}')
【案例】模拟线性回归
导入模块 + 解决 plt 显示问题
pythonimport torch import matplotlib.pyplot as plt from torch.utils.data import TensorDataset # 构造张量数据集 from torch.utils.data import DataLoader # 数据加载器,可分批读取数据 from torch import nn # 有平方损失函数和假设函数 from torch import optim # 有优化器 from sklearn.datasets import make_regression # 生成线性回归数据 plt.rcParams['font.sans-serif'] = ['SimHei'] # 用来正常显示中文标签 plt.rcParams['axes.unicode_minus'] = False # 解决负号显示问题生成线性数据
python# 生成数据 x, y, coef = make_regression( n_samples=100, # 样本数量 n_features=1, # 特征数量 noise=10, # 噪声 coef=True, # 是否返回系数 bias=14.5, # 偏置 random_state=42 # 随机数种子 ) x = torch.tensor(x).float() y = torch.tensor(y).float() print(f'x:{x},\ny:{y},\ncoef:{coef}')构建 张量数据集对象
TensorDataset构建 数据加载器
DataLoader数据按 batch_size 数量划分,保存到对象中
遍历对象时,将 batch 数据加载到内存中,避免内存溢出
创建回归模型对象
nn.Linear()创建 MSE 损失函数对象
nn.MSEloss()遍历循环训练次数以及内部循环遍历数据加载器进行模型训练
pythondataset = TensorDataset(x, y) # 张量数据集 dataloader = DataLoader( # 数据加载器 dataset, # 数据集对象 batch_size=2, # 批次大小 shuffle=True # 是否打乱数据 ) model = nn.Linear(1, 1) # 线性回归模型 # 输入层维度,输出层维度 criterion = nn.MSELoss() # 损失函数 optimizer = optim.SGD(model.parameters(), lr=0.01) # 优化器 # 模型参数,学习率 # 初始化变量: 训练轮数、损失列表(每轮的损失值)、总损失、总样本数 epochs, loss_list, total_loss, total_sample = 100, [], 0.0, 0 # 训练 for epoch in range(epochs): # 每轮从数据加载器中获取批次数据 for train_x, train_y in dataloader: y_pred = model(train_x) # 模型预测 loss = criterion(y_pred, train_y.reshape(-1, 1)) # 计算(每批的平均)损失 # 累计损失 + 累计样本数 total_loss += loss.item() # item() 获取张量的值 total_sample += 1 # 梯度清零 + 反向传播 + 梯度更新 optimizer.zero_grad() loss.backward() optimizer.step() loss_list.append(total_loss/total_sample) print(f'第{epoch+1}轮,平均损失:{total_loss/total_sample:.4f}') print(f'{epochs}轮的平均损失分别为:{loss_list}') print(f'模型参数,权重:{model.weight},偏置:{model.bias}')绘图
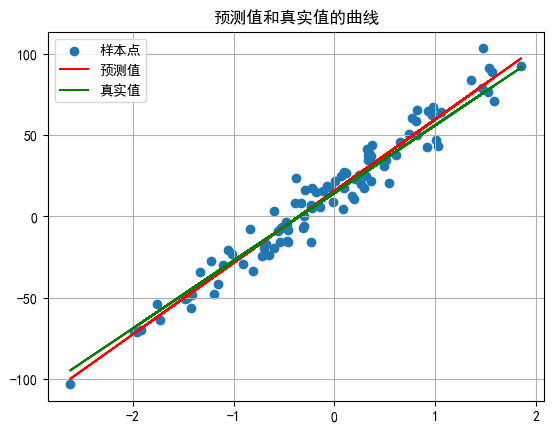
python# 绘制损失曲线 plt.plot(range(epochs), loss_list) plt.title('平均损失曲线变化图') plt.grid() plt.show() # 绘制预测值和真实值的曲线 plt.scatter(x, y, label = '样本点') # 绘制样本点分布情况 y_pred = torch.tensor(data = [v * model.weight + model.bias for v in x]) y_true = torch.tensor(data = [v * coef + 14.5 for v in x]) # 绘制预测值和真实值的曲线 plt.plot(x, y_pred, c='red', label = '预测值') plt.plot(x, y_true, c='green', label = '真实值') plt.title('预测值和真实值的曲线') plt.legend() # 显示图例 plt.grid() plt.show()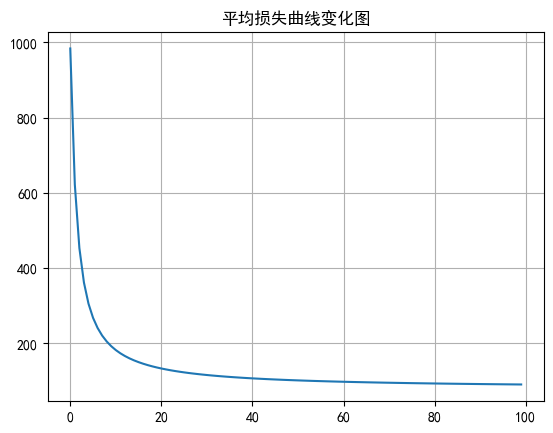
神经网络
【案例】基础神经网络搭建
import torch


import torch.nn as nn


from torchsummary import summary  # 计算模型参数,查看模型结构
# 搭建神经网络:自定义基础 nn.model


class Net(nn.Module):


    # 初始化


    def __init__(self):


        # 初始化父类


        super(Net, self).__init__() # 继承父类


        # 定义网络结构


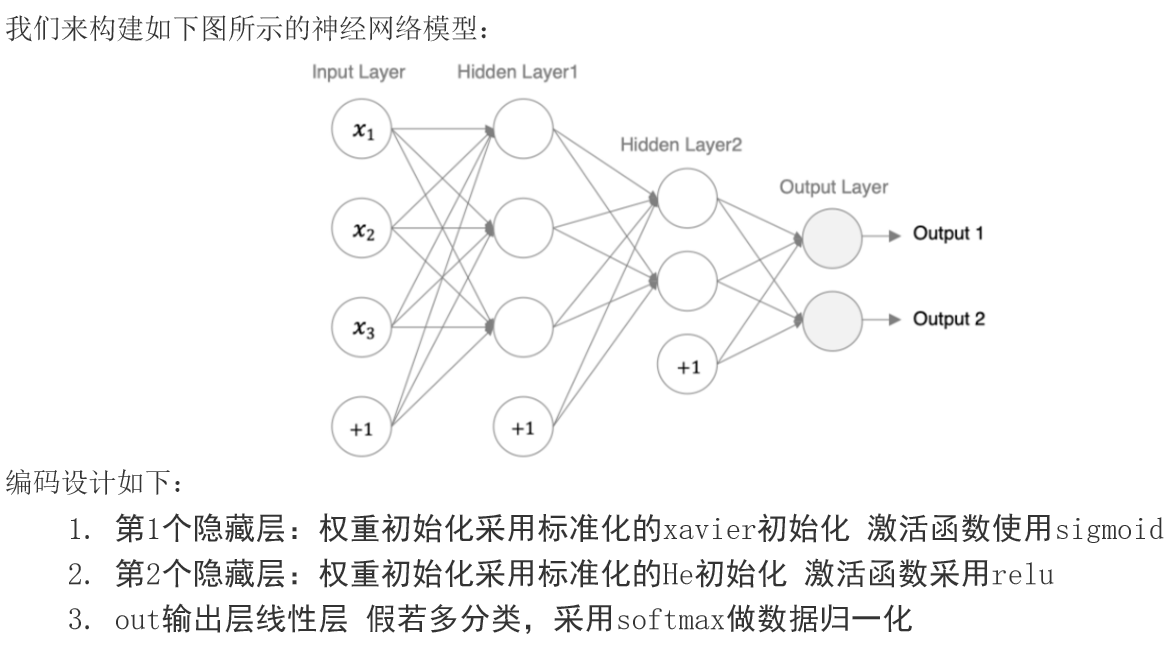
        self.linear1 = nn.Linear(3, 3)  # 隐藏层1:输入3维,输出3维


        self.linear2 = nn.Linear(3, 2)  # 隐藏层2:输入3维,输出2维


        self.output = nn.Linear(2, 2)   # 输出层:输入2维,输出2维


        # 自定义参数初始化(训练时通常使用默认初始化即可)


        nn.init.xavier_normal_(self.linear1.weight)


        nn.init.zeros_(self.linear1.bias)


        nn.init.kaiming_normal_(self.linear2.weight)


        nn.init.zeros_(self.linear2.bias)


    # 前向传播


    def forward(self, x):


        # 隐藏层1:加权、激活


        # x = self.linear1(x)


        # x = torch.sigmoid(x)


        x = torch.sigmoid(self.linear1(x))


        # 隐藏层2


        x = torch.relu(self.linear2(x))


        # 输出层


        x = torch.softmax(self.output(x), dim=1)


        # - dim=1 表示按行归一化(对第1维操作)


        # - dim=0 表示按列归一化(对第0维操作)


        return x
# 模型训练


def train():


    data = torch.randn(5,3)


    print(data)  # 3列数据


    model = Net()


    output = model(data)


    print(output) # 2列输出


    # 计算模型参数


    print('='*20 +'计算模型参数' + '='*20)


    summary(model, input_size=(5, 3), device='cpu')  # input_size 输入数据维度, device='cpu' 运行设备


    # 查看模型参数


    print('='*20 +'查看模型参数' + '='*20)


    for name, param in model.named_parameters():  # 获取模型参数


        print('-',name)


        print(' ',param)


train()
tensor([[-0.3143,  0.0130, -0.7514],


        [-0.6826,  0.2408,  0.9662],


        [-0.4209, -0.0591, -0.9512],


        [-0.7903,  0.3372, -0.0423],


        [ 0.4769, -1.5183, -0.7736]])


tensor([[0.5056, 0.4944],


        [0.4878, 0.5122],


        [0.5052, 0.4948],


        [0.4934, 0.5066],


        [0.5066, 0.4934]], grad_fn=<SoftmaxBackward0>)


====================计算模型参数====================


----------------------------------------------------------------


        Layer (type)               Output Shape         Param #


================================================================


            Linear-1                 [-1, 5, 3]              12


            Linear-2                 [-1, 5, 2]               8


            Linear-3                 [-1, 5, 2]               6


================================================================


Total params: 26


Trainable params: 26


Non-trainable params: 0


----------------------------------------------------------------


Input size (MB): 0.00


Forward/backward pass size (MB): 0.00


Params size (MB): 0.00


Estimated Total Size (MB): 0.00


----------------------------------------------------------------


====================查看模型参数====================


- linear1.weight


  Parameter containing:


tensor([[-0.5273, -0.1029, -0.1817],


        [ 0.9099,  0.2624, -0.6081],


        [ 1.1116,  0.7724, -1.4670]], requires_grad=True)


- linear1.bias


  Parameter containing:


tensor([0., 0., 0.], requires_grad=True)


- linear2.weight


  Parameter containing:


tensor([[-0.4326,  0.4747, -1.1672],


        [ 0.6484,  0.0215, -0.4402]], requires_grad=True)


- linear2.bias


  Parameter containing:


tensor([0., 0.], requires_grad=True)


- output.weight


  Parameter containing:


tensor([[-0.6729, -0.4878],


        [ 0.1188, -0.1630]], requires_grad=True)


- output.bias


  Parameter containing:


tensor([0.4327, 0.3832], requires_grad=True)
模型参数的计算
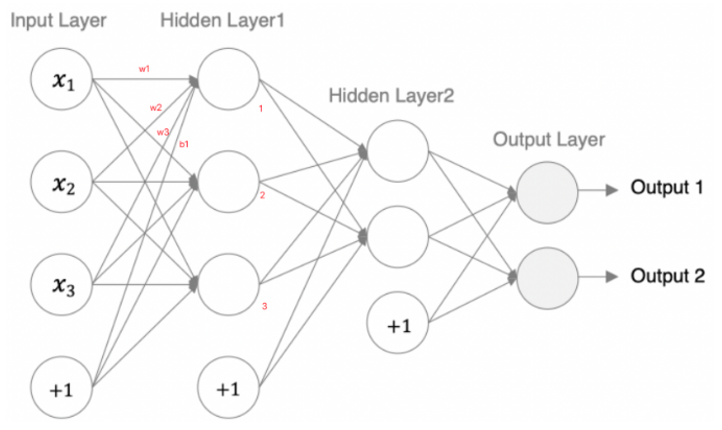
以第一个隐层为例:该隐层有3个神经元,每个神经元的参数为:4个(w1,w2,w3,b1),所以一共用3x4=12个参数。
输入数据和网络权重是两个不同的事儿!
【ANN案例】手机价格分类案例
需求分析
小明创办了一家手机公司,他不知道如何估算手机产品的价格。为了解决这个问题,他收集了多家公司的手机销售数据。该数据为二手手机的各个性能的数据,最后根据这些性能得到4个价格区间,作为这些二手手机售出的价格区间。
主要包括:
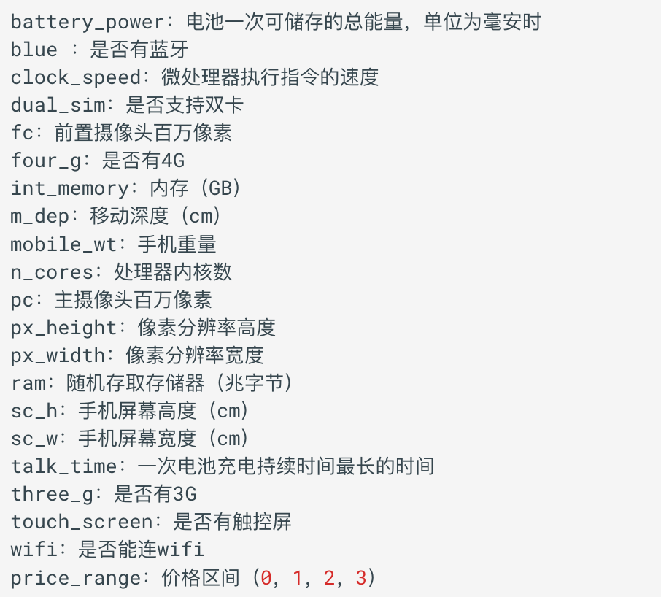
我们需要帮助小明找出手机的功能(例如:RAM等)与其售价之间的某种关系。我们可以使用机器学习的方法来解决这个问题,也可以构建一个全连接的网络。
需要注意的是: 在这个问题中,我们不需要预测实际价格,而是一个价格范围,它的范围使用 0、1、2、3 来表示,所以该问题也是一个分类问题。
接下来我们还是按照四个步骤来完成这个任务:
准备训练集数据
构建要使用的模型
模型训练
模型预测评估
导入相关模块
pythonimport time # 时间模块 import torch # PyTorch import torch.nn as nn # 神经网络 import torch.optim as optim # 优化器 import numpy as np # 数组(矩阵)处理 import pandas as pd # 数据处理 import matplotlib.pyplot as plt # 绘图 from torchsummary import summary # 模型结构可视化 from torch.utils.data import TensorDataset, DataLoader # 数据集对象、数据加载器对象 from sklearn.model_selection import train_test_split # 分割数据集 device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')构建数据集
数据共有 2000 条, 其中 1600 条数据作为训练集, 400 条数据用作测试集。 我们使用 sklearn 的数据集划分工作来完成。并使用 PyTorch 的 TensorDataset 来将数据集构建为 Dataset 对象,方便构造数据集加载对象。
pythondef create_dataset(): # 加载数据集 data = pd.read_csv("./data/手机价格预测.csv") # 获取 x特征列 和 y标签列 x, y = data.iloc[:, :-1], data.iloc[:, -1] x = x.astype(np.float32) # 划分训练集和测试集, stratify=y 参考y的类别进行数据抽取 x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=24, stratify=y) # 思路:数据 -> 张量 -> 数据集 -> 数据加载器 # 把数据封装成张量,再将张量封装成数据集 train_dataset = TensorDataset(torch.tensor(x_train.values), torch.tensor(y_train.values)) test_dataset = TensorDataset(torch.tensor(x_test.values), torch.tensor(y_test.values)) return train_dataset, test_dataset, x_train.shape[1], len(np.unique(y)) train_dataset, test_dataset, input_dim, output_dim = create_dataset() print(train_dataset) print(test_dataset) print(input_dim) # 训练集特征列数 -> 充当输入特征数 print(output_dim) # 训练集标签类别数 -> 充当输出类别数(标签数)搭建神经网络
构建全连接神经网络来进行手机价格分类,该网络主要由三个线性层来构建,使用relu激活函数。
网络共有 3 个全连接层, 具体信息如下:
第一层: 输入为维度为 20, 输出维度为: 128
第二层: 输入为维度为 128, 输出维度为: 256
第三层: 输入为维度为 256, 输出维度为: 4
pythonclass PhonePriceModel(nn.Module): # 定义模型结构 def __init__(self, input_dim, output_dim): super().__init__() self.linear1 = nn.Linear(input_dim, 128) self.linear2 = nn.Linear(128, 256) self.output = nn.Linear(256, output_dim) # 前向传播 def forward(self, x): x = torch.relu(self.linear1(x)) x = torch.relu(self.linear2(x)) x = self.output(x) return x model = PhonePriceModel(input_dim, output_dim).to(device) summary(model, input_size=(16, input_dim)) # 模型结构, 批次大小16, 输入维度20模型训练
所谓的训练函数,指的是输入数据读取、送入网络、计算损失、更新参数的流程,该流程较为固定。我们使用的是多分类交叉生损失函数、使用 SGD 优化方法。最终,将训练好的模型持久化到磁盘中。
pythondef train(train_dataset, input_dim, output_dim): # 数据集 -> 数据加载器,shuffle=True 表示训练时随机打乱数据 train_loader = DataLoader(train_dataset, batch_size=16, shuffle=True) device = torch.device('cuda') model = PhonePriceModel(input_dim, output_dim).to(device) # 神经网络 criterion = nn.CrossEntropyLoss() # 交叉熵损失函数 optimizer = optim.SGD(model.parameters(), lr=0.001) # 优化器 # 模型训练 epochs = 50 # 开始各个轮次的训练 for epoch in range(epochs): total_loss, total_num = 0.0, 0 # 损失值和训练批次数 start = time.time() # 开始各个批次的训练 for x, y in train_loader: model.train() y_pred = model(x.to(device)) loss = criterion(y_pred, y.to(device)) optimizer.zero_grad() loss.backward() optimizer.step() total_loss += loss.item() # 损失值累加,item(): 返回张量中的元素值 total_num += 1 # 训练批次数 print('epoch: {}, loss: {:.4f}, time: {:.4f}'.format(epoch, total_loss / total_num, time.time() - start)) # 保存模型, 模型参数,模型路径 torch.save(model.state_dict(), f='./model/phone_price_model.pth') # pth/pkl/pickle print("模型已保存。") train(train_dataset, input_dim, output_dim)模型测试(模型评估)
使用训练好的模型,对未知的样本的进行预测的过程。我们这里使用前面单独划分出来的验证集来进行评估。
pythondef evaluate(test_dataset, input_dim, output_dim): model = PhonePriceModel(input_dim, output_dim) # 创建模型 model.load_state_dict(torch.load('./model/phone_price_model.pth')) # 加载模型参数 test_loader = DataLoader(test_dataset, batch_size=16, shuffle=False) correct = 0 # 预测正确的样本个数 for x, y in test_loader: model.eval() # 测试模式 y_pred = model(x) # 模型预测,返回 logits (未归一化的分数) # argmax 返回每行最大值的索引,即预测类别 y_pred = torch.argmax(y_pred, dim=1) # print("本轮真实标签:", y.tolist()) # print("本轮预测结果:", y_pred.tolist()) correct += (y_pred == y).sum().item() # print("预测正确的样本个数:",correct) print("准确率:", correct / len(test_dataset)) evaluate(test_dataset, input_dim, output_dim)
【总体代码】
import time                 # 时间模块


import torch                # PyTorch


import torch.nn as nn       # 神经网络


import torch.optim as optim # 优化器


import numpy as np          # 数组(矩阵)处理


import pandas as pd         # 数据处理


import matplotlib.pyplot as plt  # 绘图


from torchsummary import summary # 模型结构可视化


from torch.utils.data import TensorDataset, DataLoader # 数据集对象、数据加载器对象


from sklearn.model_selection import train_test_split   # 分割数据集


device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
class PhonePriceModel(nn.Module):
# 定义模型结构
def __init__(self, input_dim, output_dim):
super().__init__()
self.linear1 = nn.Linear(input_dim, 128)
self.linear2 = nn.Linear(128, 256)
self.output = nn.Linear(256, output_dim)
# 前向传播
def forward(self, x):
x = torch.relu(self.linear1(x))
x = torch.relu(self.linear2(x))
x = self.output(x)
return x
def create_dataset():
# 加载数据集
data = pd.read_csv("./data/手机价格预测.csv")
# 获取 x特征列 和 y标签列
x, y = data.iloc[:, :-1], data.iloc[:, -1]
x = x.astype(np.float32)
# 划分训练集和测试集, stratify=y 参考y的类别进行数据抽取
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=24, stratify=y)
# 思路:数据 -> 张量 -> 数据集 -> 数据加载器
# 把数据封装成张量,再将张量封装成数据集
train_dataset = TensorDataset(torch.tensor(x_train.values), torch.tensor(y_train.values))
test_dataset = TensorDataset(torch.tensor(x_test.values), torch.tensor(y_test.values))
return train_dataset, test_dataset, x_train.shape[1], len(np.unique(y))
def train(train_dataset, input_dim, output_dim):
# 数据集 -> 数据加载器,shuffle=True 表示训练时随机打乱数据
train_loader = DataLoader(train_dataset, batch_size=16, shuffle=True)
device = torch.device('cuda')
model = PhonePriceModel(input_dim, output_dim).to(device) # 神经网络
criterion = nn.CrossEntropyLoss() # 交叉熵损失函数
optimizer = optim.SGD(model.parameters(), lr=0.001) # 优化器
# 模型训练
epochs = 50
# 开始各个轮次的训练
for epoch in range(epochs):
total_loss, total_num = 0.0, 0 # 损失值和训练批次数
start = time.time()
# 开始各个批次的训练
for x, y in train_loader:
model.train()
y_pred = model(x.to(device))
loss = criterion(y_pred, y.to(device))
optimizer.zero_grad()
loss.backward()
optimizer.step()
total_loss += loss.item() # 损失值累加,item(): 返回张量中的元素值
total_num += 1 # 训练批次数
print('epoch: {}, loss: {:.4f}, time: {:.4f}'.format(epoch, total_loss / total_num, time.time() - start))
# 保存模型, 模型参数,模型路径
torch.save(model.state_dict(), f='./model/phone_price_model.pth') # pth/pkl/pickle
print("模型已保存。")
def evaluate(test_dataset, input_dim, output_dim):
model = PhonePriceModel(input_dim, output_dim) # 创建模型
model.load_state_dict(torch.load('./model/phone_price_model.pth')) # 加载模型参数
test_loader = DataLoader(test_dataset, batch_size=16, shuffle=False)
correct = 0 # 预测正确的样本个数
for x, y in test_loader:
model.eval() # 测试模式
y_pred = model(x) # 模型预测,返回 logits (未归一化的分数)
# argmax 返回每行最大值的索引,即预测类别
y_pred = torch.argmax(y_pred, dim=1)
# print("本轮真实标签:", y.tolist())
# print("本轮预测结果:", y_pred.tolist())
correct += (y_pred == y).sum().item()
# print("预测正确的样本个数:",correct)
print("准确率:", correct / len(test_dataset))
if __name__ == "__main__":
# 构建数据集
train_dataset, test_dataset, input_dim, output_dim = create_dataset()
print("输入维度:", input_dim)
print("输出类别数:", output_dim)
# 创建模型
model = PhonePriceModel(input_dim, output_dim).to(device)
# 查看模型结构, 批次大小16, 输入维度20
summary(model, input_size=(16, input_dim))
# 模型训练
train(train_dataset, input_dim, output_dim)
# 模型测试
evaluate(test_dataset, input_dim, output_dim)
准确率: 0.6475【改进优化】
我们可以通过以下方面进行调优:
对输入数据进行 标准化
调整 优化方法
调整 学习率
增加 批量归一化层
增加 网络层数、神经元个数
增加 训练轮数
等等...
进行下如下调整:
对数据进行标准化
增加网络深度, 即: 增加网络参数量
优化方法由 SGD 调整为 Adam
学习率由 1e-3 调整为 1e-4
pythonimport time # 时间模块 import torch # PyTorch import torch.nn as nn # 神经网络 import torch.optim as optim # 优化器 import numpy as np # 数组(矩阵)处理 import pandas as pd # 数据处理 import matplotlib.pyplot as plt # 绘图 from torchsummary import summary # 模型结构可视化 from torch.utils.data import TensorDataset, DataLoader # 数据集对象、数据加载器对象 from sklearn.model_selection import train_test_split # 分割数据集 from sklearn.discriminant_analysis import StandardScaler # 数据标准化 device = torch.device('cuda' if torch.cuda.is_available() else 'cpu') class PhonePriceModel(nn.Module): # 定义模型结构 def __init__(self, input_dim, output_dim): super().__init__() # 【优化】增加网络深度 self.linear1 = nn.Linear(input_dim, 128) self.linear2 = nn.Linear(128, 256) self.linear3 = nn.Linear(256, 512) self.linear4 = nn.Linear(512, 128) self.output = nn.Linear(128, output_dim) # 前向传播 def forward(self, x): x = torch.relu(self.linear1(x)) x = torch.relu(self.linear2(x)) x = torch.relu(self.linear3(x)) x = torch.relu(self.linear4(x)) x = self.output(x) return x def create_dataset(): # 加载数据集 data = pd.read_csv("./data/手机价格预测.csv") # 获取 x特征列 和 y标签列 x, y = data.iloc[:, :-1], data.iloc[:, -1] x = x.astype(np.float32) # 划分训练集和测试集, stratify=y 参考y的类别进行数据抽取 x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=24, stratify=y) # 【优化】数据标准化 transfer = StandardScaler() x_train = transfer.fit_transform(x_train) x_test = transfer.transform(x_test) # 思路:数据 -> 张量 -> 数据集 -> 数据加载器 # 把数据封装成张量,再将张量封装成数据集 train_dataset = TensorDataset(torch.tensor(x_train), torch.tensor(y_train.values)) test_dataset = TensorDataset(torch.tensor(x_test), torch.tensor(y_test.values)) return train_dataset, test_dataset, x_train.shape[1], len(np.unique(y)) def train(train_dataset, input_dim, output_dim): # 数据集 -> 数据加载器,shuffle=True 表示训练时随机打乱数据 train_loader = DataLoader(train_dataset, batch_size=16, shuffle=True) device = torch.device('cuda') model = PhonePriceModel(input_dim, output_dim).to(device) # 神经网络 criterion = nn.CrossEntropyLoss() # 交叉熵损失函数 # 【优化】SGD 调整为 Adam,学习率从0.001 调整为 0.0001 optimizer = optim.Adam(model.parameters(), lr=1e-4) # 优化器 # 模型训练 epochs = 50 # 开始各个轮次的训练 for epoch in range(epochs): total_loss, total_num = 0.0, 0 # 损失值和训练批次数 start = time.time() # 开始各个批次的训练 for x, y in train_loader: model.train() y_pred = model(x.to(device)) loss = criterion(y_pred, y.to(device)) optimizer.zero_grad() loss.backward() optimizer.step() total_loss += loss.item() # 损失值累加,item(): 返回张量中的元素值 total_num += 1 # 训练批次数 print('epoch: {}, loss: {:.4f}, time: {:.4f}'.format(epoch, total_loss / total_num, time.time() - start)) # 保存模型, 模型参数,模型路径 torch.save(model.state_dict(), f='./model/phone_price_model.pth') # pth/pkl/pickle print("模型已保存。") def evaluate(test_dataset, input_dim, output_dim): model = PhonePriceModel(input_dim, output_dim) # 创建模型 model.load_state_dict(torch.load('./model/phone_price_model.pth')) # 加载模型参数 test_loader = DataLoader(test_dataset, batch_size=16, shuffle=False) correct = 0 # 预测正确的样本个数 for x, y in test_loader: model.eval() # 测试模式 y_pred = model(x) # 模型预测,返回 logits (未归一化的分数) # argmax 返回每行最大值的索引,即预测类别 y_pred = torch.argmax(y_pred, dim=1) # print("本轮真实标签:", y.tolist()) # print("本轮预测结果:", y_pred.tolist()) correct += (y_pred == y).sum().item() # print("预测正确的样本个数:",correct) print("准确率:", correct / len(test_dataset)) if __name__ == "__main__": # 构建数据集 train_dataset, test_dataset, input_dim, output_dim = create_dataset() print("输入维度:", input_dim) print("输出类别数:", output_dim) # 创建模型 model = PhonePriceModel(input_dim, output_dim).to(device) # 查看模型结构, 批次大小16, 输入维度20 summary(model, input_size=(16, input_dim)) # 模型训练 train(train_dataset, input_dim, output_dim) # 模型测试 evaluate(test_dataset, input_dim, output_dim)
卷积神经网络
【卷积层-案例】提取图像的局部特征,获取特征图
import torch


import torch.nn as nn


import matplotlib.pyplot as plt


def func():


    # 加载图像


    img = plt.imread('./data/img.jpg')


    print(img.shape)  # (640, 640, 3)


    # 将图像从 HWC 转为 CHW 并增加批次维度,适配 PyTorch 模型 (N, C, H, W) 输入规范


    # 1. HWC -> CHW


    img = torch.tensor(img, dtype=torch.float)


    img = img.permute(2, 0, 1)


    print(img.shape)  # torch.Size([3, 640, 640])


    # 2. CHW -> [N, C, H, W]批次大小(一次处理多少张图片)、通道数、高度、宽度


    img = img.unsqueeze(dim=0)


    print(img.shape)  # torch.Size([1, 3, 640, 640])


    # 3. 卷积层对象


    conv = nn.Conv2d(in_channels=3, out_channels=4, kernel_size=3, stride=2)


    conv_img = conv(img)


    print(conv_img.shape)  # torch.Size([1, 4, 319, 319])


    # 查看提取的特征图


    f_img = conv_img[0]


    # CHW -> HWC


    f_img = f_img.permute(1, 2, 0)


    fig, axes = plt.subplots(1, 4, figsize=(16, 4))


    # 显示4个特征图


    for i in range(4):


        feature = f_img[:, :, i].detach().numpy()


        axes[i].imshow(feature)


        axes[i].set_title(f'Feature Map {i+1}')


        axes[i].axis('off')  # 隐藏坐标轴


    plt.tight_layout()  # 自动调整子图间距


    plt.show()


func()
【池化层-案例】
import torch


import torch.nn as nn


import matplotlib.pyplot as plt


def func1():


    inputs = torch.tensor([[


        [0,1,2],


        [3,4,5],


        [6,7,8]


    ]])


    print(inputs.shape)


    # 最大池化


    pool1 = nn.MaxPool2d(kernel_size=2, stride=1, padding=0)


    output1 = pool1(inputs)


    print(output1, output1.shape)


    # 平均池化


    pool2 = nn.AvgPool2d(kernel_size=2, stride=1, padding=0)


    output2 = pool2(inputs)


    print(output2, output2.shape)


# 多通道


def func1():


    inputs = torch.tensor([


        [


            [0,1,2],


            [3,4,5],


            [6,7,8]


        ],


        [


            [9,10,11],


            [12,13,14],


            [15,16,17]


        ],


        [


            [18,19,20],


            [21,22,23],


            [24,25,26]


        ]


    ])


    print(inputs.shape)


    # 最大池化


    pool1 = nn.MaxPool2d(kernel_size=2, stride=1, padding=0)


    output1 = pool1(inputs)


    print(output1, output1.shape)


    # 平均池化


    pool2 = nn.AvgPool2d(kernel_size=2, stride=1, padding=0)


    output2 = pool2(inputs)


    print(output2, output2.shape)


func1()


func1()
输出:
torch.Size([1, 3, 3])


tensor([[[4, 5],


         [7, 8]]]) torch.Size([1, 2, 2])


tensor([[[2, 3],


         [5, 6]]]) torch.Size([1, 2, 2])


torch.Size([3, 3, 3])


tensor([[[ 4,  5],


         [ 7,  8]],


        [[13, 14],


         [16, 17]],


        [[22, 23],


         [25, 26]]]) torch.Size([3, 2, 2])


tensor([[[ 2,  3],


         [ 5,  6]],


        [[11, 12],


         [14, 15]],


        [[20, 21],


         [23, 24]]]) torch.Size([3, 2, 2])
【CNN案例】图像分类
CIFAR10 数据集
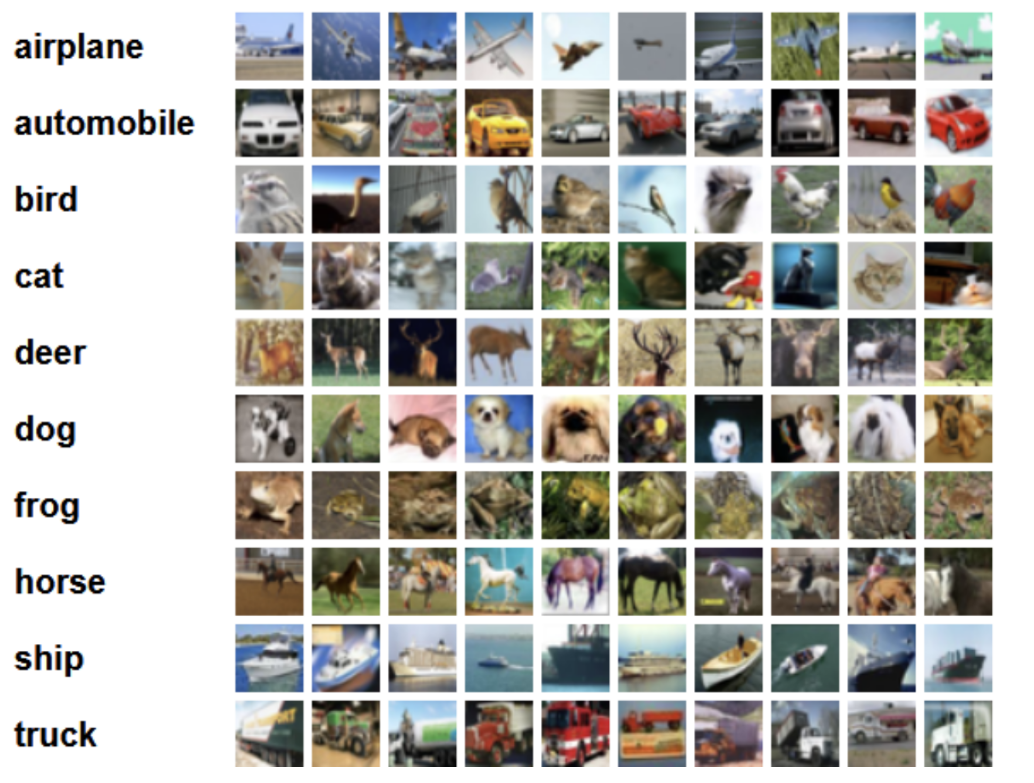
5万张训练图像、1万张测试图像、10个类别、每个类别有6k个图像,图像大小32×32×3。
下图列举了10个类,每一类随机展示了10张图片:
加载数据集
pythondef create_dataset(): # root 数据集存放路径, train 是否是训练集, transform 数据预处理(image-> Tensor), download 是否下载数据集 train_dataset = CIFAR10(root='./data', train=True, transform=ToTensor(), download=True) test_dataset = CIFAR10(root='./data', train=False, transform=ToTensor(), download=True) return train_dataset, test_dataset train_dataset, test_dataset = create_dataset() print("训练集和测试集:", train_dataset.data.shape, test_dataset.data.shape) print(f'数据集类别:{train_dataset.class_to_idx}') plt.figure(figsize=(8, 8)) plt.imshow(train_dataset.data[11]) plt.title(train_dataset.targets[11]) plt.show()输出:
python训练集和测试集: (50000, 32, 32, 3) (10000, 32, 32, 3) 数据集类别:{'airplane': 0, 'automobile': 1, 'bird': 2, 'cat': 3, 'deer': 4, 'dog': 5, 'frog': 6, 'horse': 7, 'ship': 8, 'truck': 9}
搭建CNN
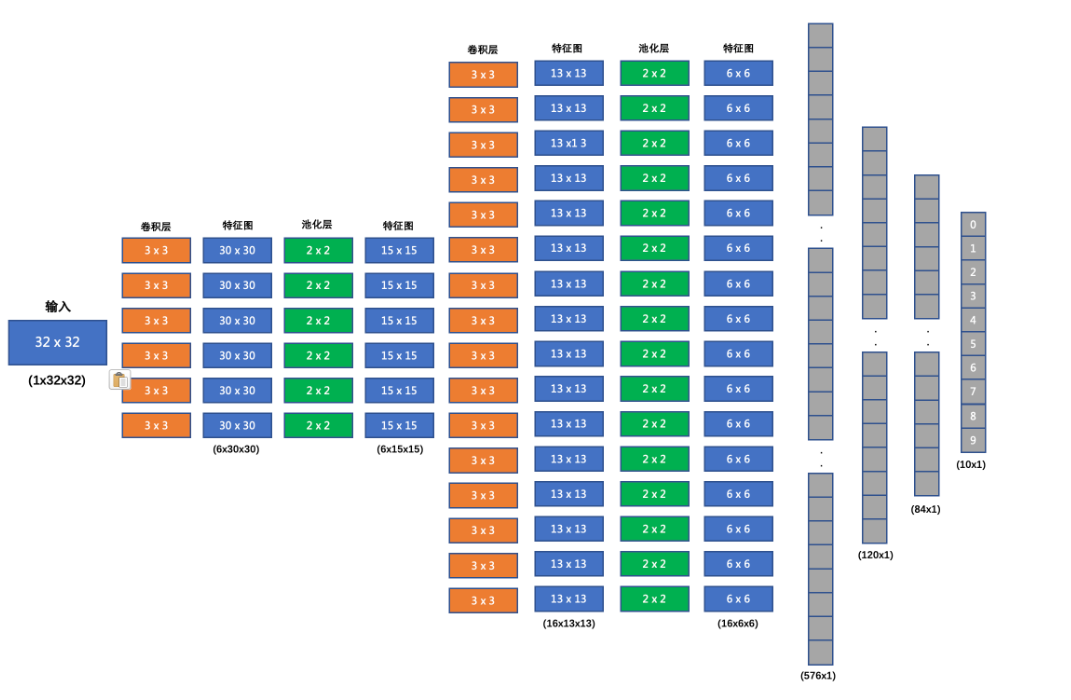
输入形状: 3x32x32
第一个卷积层(Kernel Size 为: 3x3)输入 3 个 Channel,输出 6 个 Channel,输出 6x30x30
第一个池化层(Kernel Size 为: 2x2,Stride 为: 2)输入 30x30,输出 15x15
第二个卷积层(Kernel Size 为 3x3)输入 6 个 Channel,输出 16 个 Channel,输出 16x13x13
第二个池化层(Kernel Size 为: 2x2,Stride 为: 2)输入 13x13, 输出 6x6
第一个全连接层输入 576 维=16x6x6,输出 120 维
第二个全连接层输入 120 维,输出 84 维
输出层:输入 84 维,输出 10 维(10个类别)
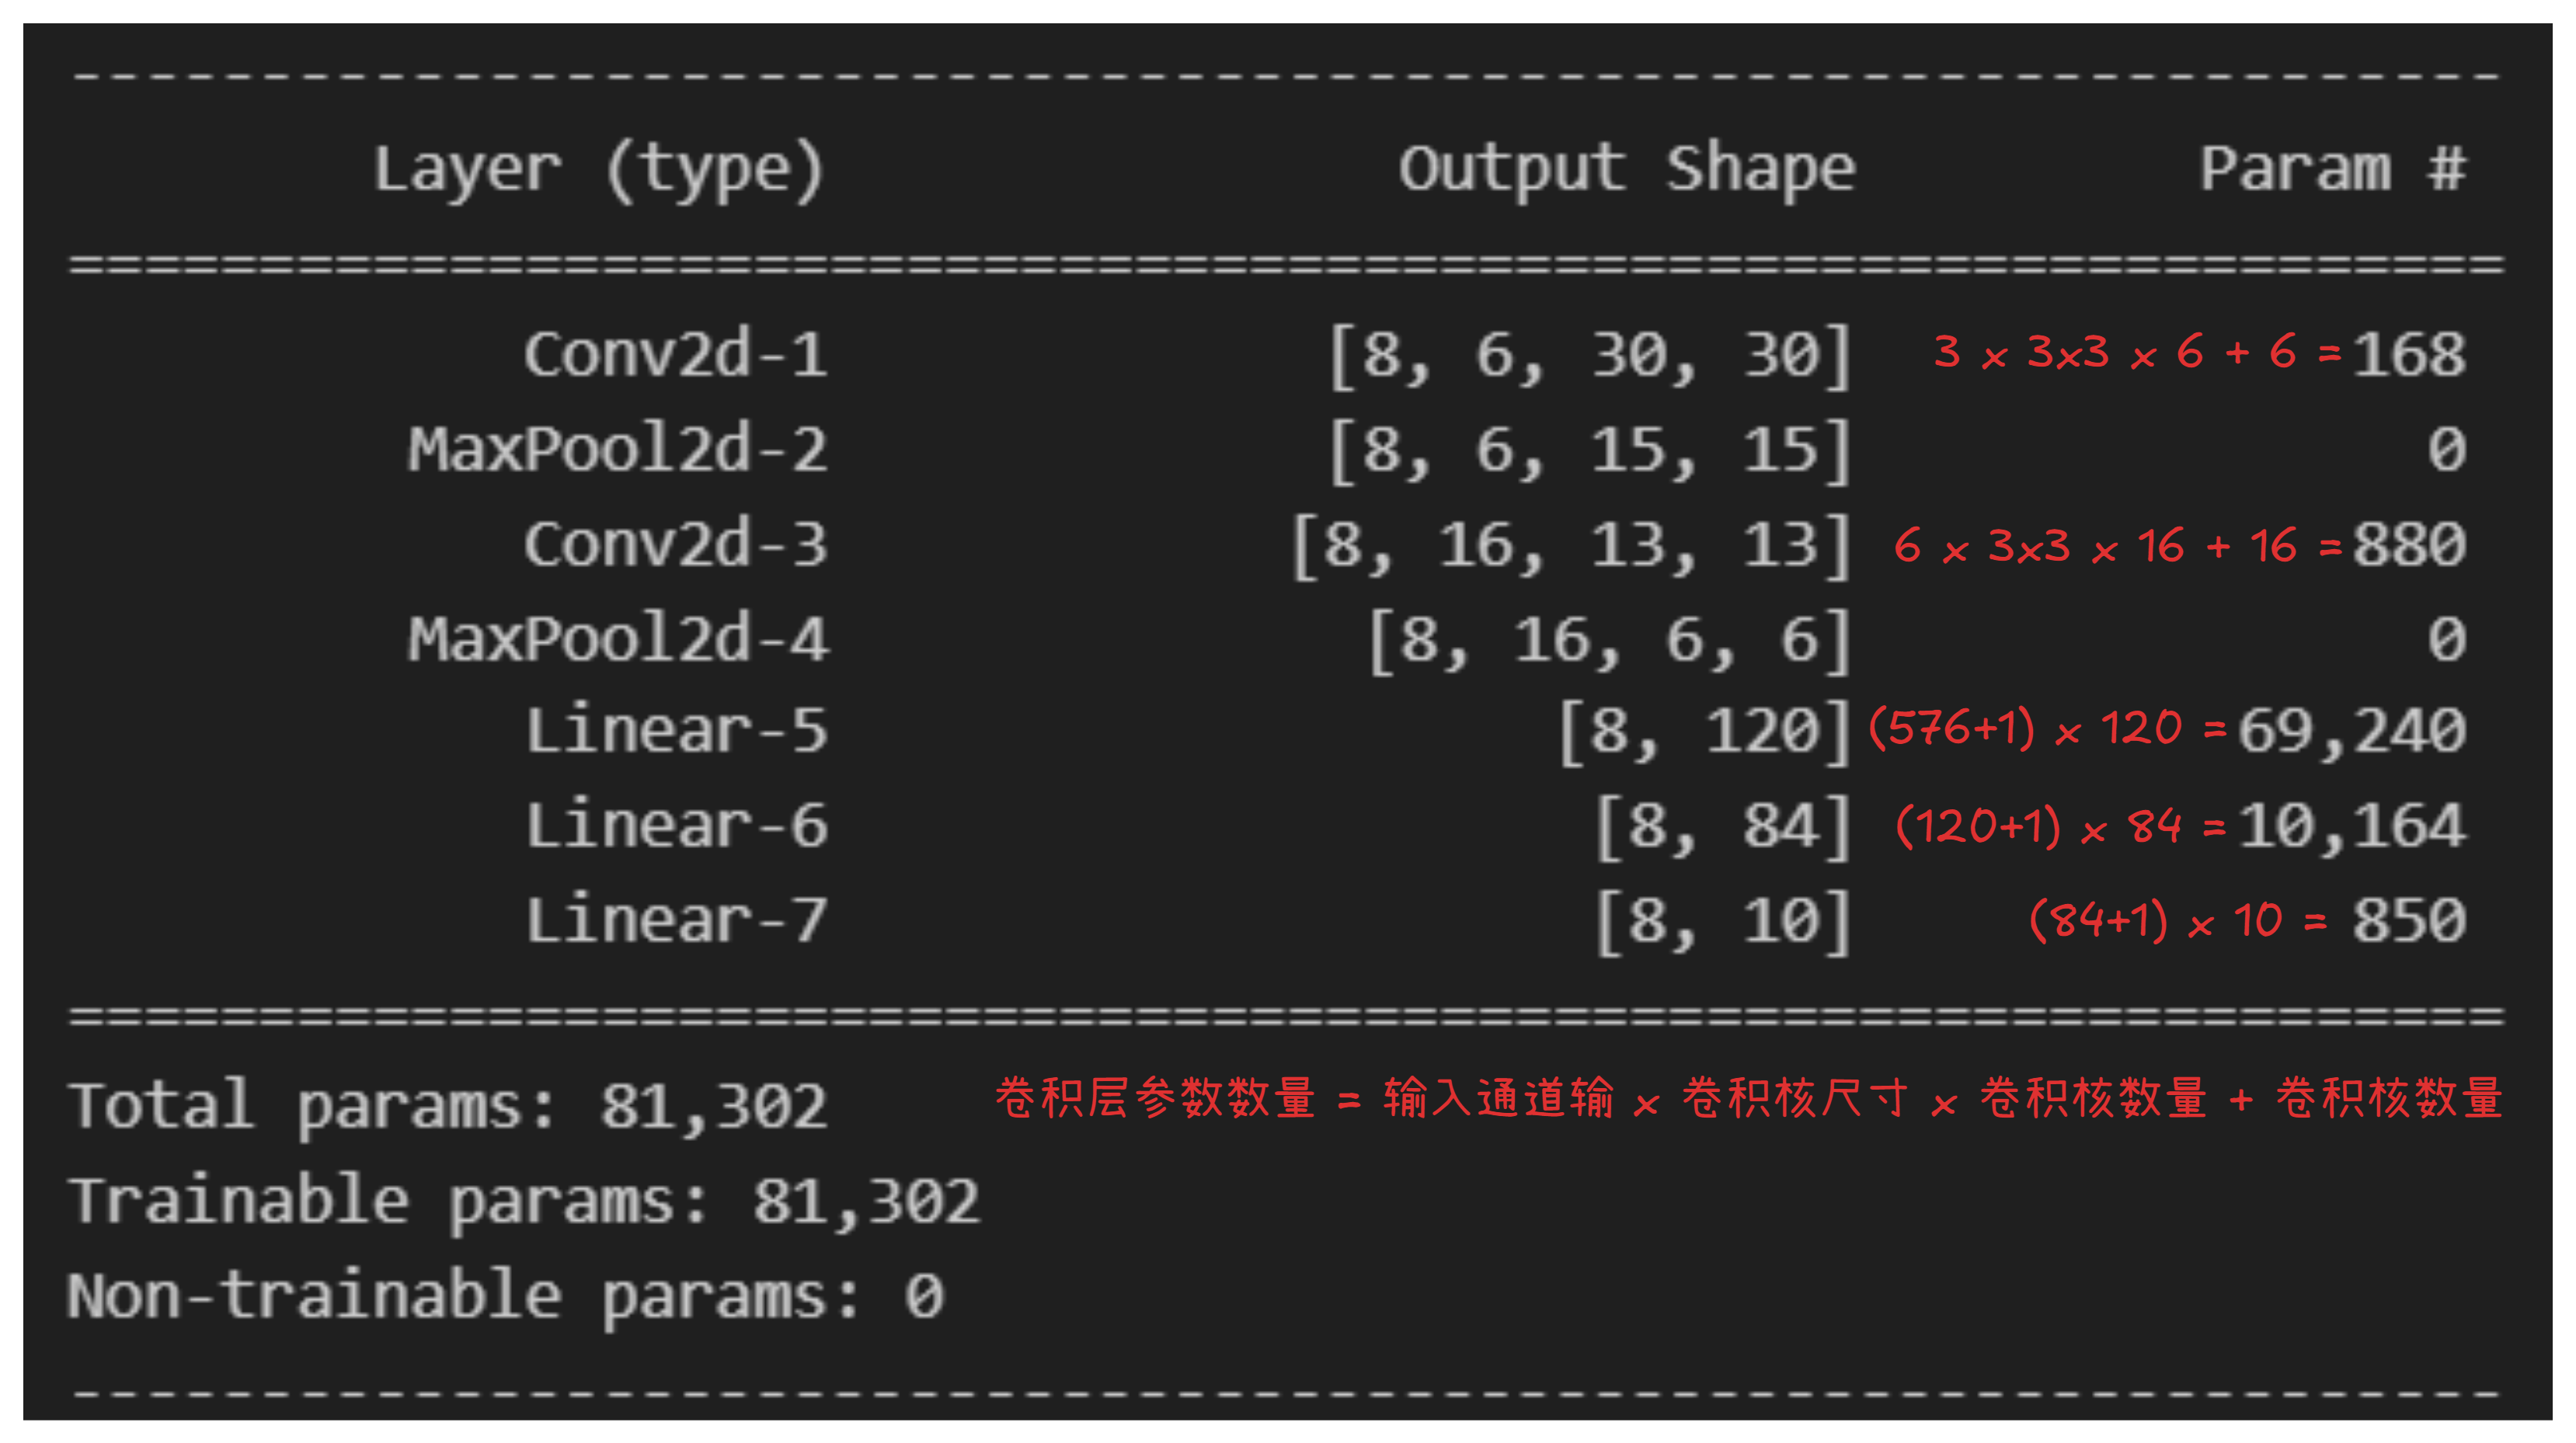 python
class ImageModel(nn.Module):


    def __init__(self):


        super().__init__()


        self.conv1 = nn.Conv2d(3, 6, kernel_size=3)


        self.pool1 = nn.MaxPool2d(kernel_size=2, stride=2)


        self.conv2 = nn.Conv2d(6, 16, kernel_size=3)


        self.pool2 = nn.MaxPool2d(kernel_size=2, stride=2)


        self.fc1 = nn.Linear(16 * 6 * 6, 120)


        self.fc2 = nn.Linear(120, 84)


        self.output = nn.Linear(84, 10)


    def forward(self, x):


        # 卷积层(加权求和) + 激活层(激活函数) + 池化层(降维)


        x = self.pool1(torch.relu(self.conv1(x)))


        x = self.pool2(torch.relu(self.conv2(x)))


        # 展平层:改变张量的形状, (8, 16, 6, 6) -> (8, 576)


        # 样本数(行数),列数(特征数):-1 表示自动计算列数


        x = x.reshape(x.shape[0], -1)


        # 全连接层(加权求和) + 激活层(激活函数)


        x = torch.relu(self.fc1(x))


        x = torch.relu(self.fc2(x))


        # 输出层(加权求和)


        x = self.output(x)


        return x


# 创建模型


device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')


model = ImageModel().to(device)


# 查看模型结构


summary(model, input_size=(3, 32, 32), batch_size=BATCH_SIZE)
模型训练
pythondef train(train_dataset): # 数据加载器 dataloader = DataLoader(train_dataset, batch_size=16, shuffle=True) # 模型对象 model = ImageModel().to(device) # 多分类交叉熵损失函数=softmax+损失计算 criterion = nn.CrossEntropyLoss() # 优化器 optimizer = optim.Adam(model.parameters(), lr=0.001) # 训练 epochs = 10 for epoch in range(epochs): # 总损失,预测正确的样本数,训练开始时间 total_loss, total_samples, total_correct, start = 0.0, 0, 0, time.time() for x, y in dataloader: x, y = x.to(device), y.to(device) model.train() y_pred = model(x) loos = criterion(y_pred, y) optimizer.zero_grad() loos.backward() optimizer.step() total_loss += loos.item()*len(y) total_samples += len(y) total_correct += (y_pred.argmax(dim=1) == y).sum().item() print(f'Epoch: {epoch+1}/{epochs}, Loss: {total_loss/total_samples:.4f}, Acc: {total_correct/total_samples:.4f}, Time: {time.time()-start:.2f}s') # 保存模型 torch.save(model.state_dict(), './model/image_model.pth') train(train_dataset)模型评估
pythondef evaluate(test_dataset): dataloader = DataLoader(test_dataset, batch_size=BATCH_SIZE, shuffle=False) model = ImageModel().to(device) model.load_state_dict(torch.load('./model/image_model.pth')) total_correct, total_samples = 0, 0 for x, y in dataloader: x, y = x.to(device), y.to(device) model.eval() y_pred = model(x) total_correct += (y_pred.argmax(dim=1) == y).sum().item() total_samples += len(y) print(f'Accuracy: {total_correct / total_samples:.4f}') evaluate(test_dataset)
查看模型结构pythonif __name__ == '__main__': # 加载数据集 train_dataset, test_dataset = create_dataset() # 创建模型 model = ImageModel().to(device) # 查看模型结构 summary(model, input_size=(3, 32, 32), batch_size=BATCH_SIZE) # # 训练模型 # train(train_dataset) # # 评估模型 # evaluate(test_dataset)
【优化】
调整学习率 1e-3 -> 1e-4
增加模型参数量
增加dropout正则化
import time


import torch


import torch.nn as nn


import torch.optim as optim


import matplotlib.pyplot as plt


from torch.utils.data import DataLoader


from torchvision.datasets import CIFAR10


from torchvision.transforms import ToTensor


from torchsummary import summary


BATCH_SIZE = 8  # 每批次训练的样本数


device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')


class ImageModel(nn.Module):


    def __init__(self):


        super().__init__()


        self.conv1 = nn.Conv2d(3, 32, kernel_size=3)


        self.pool1 = nn.MaxPool2d(kernel_size=2, stride=2)


        self.conv2 = nn.Conv2d(32, 128, kernel_size=3)


        self.pool2 = nn.MaxPool2d(kernel_size=2, stride=2)


        self.fc1 = nn.Linear(128 * 6 * 6, 2048)


        self.fc2 = nn.Linear(2048, 2048)


        self.output = nn.Linear(2048, 10)


        self.dropout = nn.Dropout(0.5)


    def forward(self, x):


        # 卷积层(加权求和) + 激活层(激活函数) + 池化层(降维)


        x = self.pool1(torch.relu(self.conv1(x)))


        x = self.pool2(torch.relu(self.conv2(x)))


        # 展平层:改变张量的形状, (8, 16, 6, 6) -> (8, 576)


        # 样本数(行数),列数(特征数):-1 表示自动计算列数


        x = x.reshape(x.shape[0], -1)


        # 全连接层(加权求和) + 激活层(激活函数)


        x = torch.relu(self.fc1(x))


        x = self.dropout(x)


        x = torch.relu(self.fc2(x))


        x = self.dropout(x)


        # 输出层(加权求和)


        x = self.output(x)


        return x


def create_dataset():


    # root 数据集存放路径, train 是否是训练集, transform 数据预处理(image-> Tensor), download 是否下载数据集


    train_dataset = CIFAR10(root='./data', train=True, transform=ToTensor(), download=True)


    test_dataset = CIFAR10(root='./data', train=False, transform=ToTensor(), download=True)


    return train_dataset, test_dataset


def train(train_dataset):


    # 数据加载器


    dataloader = DataLoader(train_dataset, batch_size=16, shuffle=True)


    # 模型对象


    model = ImageModel().to(device)


    # 多分类交叉熵损失函数=softmax+损失计算


    criterion = nn.CrossEntropyLoss()


    # 优化器


    optimizer = optim.Adam(model.parameters(), lr=0.001)


    # 训练


    epochs = 10


    for epoch in range(epochs):


        # 总损失,预测正确的样本数,训练开始时间


        total_loss, total_samples, total_correct, start = 0.0, 0, 0, time.time()


        for x, y in dataloader:


            x, y = x.to(device), y.to(device)


            model.train()


            y_pred = model(x)


            loos = criterion(y_pred, y)


            optimizer.zero_grad()


            loos.backward()


            optimizer.step()


            total_loss += loos.item()*len(y)


            total_samples += len(y)


            total_correct += (y_pred.argmax(dim=1) == y).sum().item()


        print(f'Epoch: {epoch+1}/{epochs}, Loss: {total_loss/total_samples:.4f}, Acc: {total_correct/total_samples:.4f}, Time: {time.time()-start:.2f}s')


    # 保存模型


    torch.save(model.state_dict(), './model/image_model.pth')


def evaluate(test_dataset):


    dataloader = DataLoader(test_dataset, batch_size=BATCH_SIZE, shuffle=False)


    model = ImageModel().to(device)


    model.load_state_dict(torch.load('./model/image_model.pth'))


    total_correct, total_samples = 0, 0


    for x, y in dataloader:


        x, y = x.to(device), y.to(device)


        model.eval()


        y_pred = model(x)


        total_correct += (y_pred.argmax(dim=1) == y).sum().item()


        total_samples += len(y)


    print(f'Accuracy: {total_correct / total_samples:.4f}')


if __name__ == '__main__':


    # 加载数据集


    train_dataset, test_dataset = create_dataset()


    # 创建模型


    model = ImageModel().to(device)


    # 查看模型结构


    summary(model, input_size=(3, 32, 32), batch_size=BATCH_SIZE)


    # 训练模型


    train(train_dataset)


    # 评估模型


    evaluate(test_dataset)
循环神经网络
【RNN案例】文本生成
数据集
我们收集了周杰伦从第一张专辑《Jay》到第十张专辑《跨时代》中的歌词,来训练神经网络模型,当模型训练好后,我们就可以用这个模型来创作歌词。数据集如下:
python想要有直升机 想要和你飞到宇宙去 想要和你融化在一起 融化在宇宙里 我每天每天每天在想想想想著你 这样的甜蜜 让我开始相信命运 感谢地心引力 让我碰到你 漂亮的让我面红的可爱女人 ...该数据集共有 5819 行文本。
导入模块
pythonimport time import jieba import torch import torch.nn as nn import torch.optim as optim from torch.utils.data import DataLoader获取数据
pythondef build_vocab(): # 每行文本分词结果,去重后的所有词 all_words, unique_words = [], [] for line in open('./data/jaychou_lyrics.txt', encoding='utf-8'): words = jieba.lcut(line.strip()) all_words.append(words) for word in words: # 去重 if word not in unique_words: unique_words.append(word) word_count = len(unique_words) # 词表, key: 词, value: 索引 word_to_index = {word: i for i, word in enumerate(unique_words)} # 歌词文本用索引表示 corpus_idx = [] for words in all_words: tmp = [] # 歌词索引表 for word in words: tmp.append(word_to_index[word]) tmp.append(word_to_index[' ']) # 每一行歌词之间,添加空格隔开 corpus_idx.extend(tmp) # extend()函数: 添加多个元素 # 词表(已去重),索引词表(已去重),词的数量(已去重),歌词索引表 return unique_words, word_to_index, word_count, corpus_idx构建数据集
pythonclass LyricsDataset(torch.utils.data.Dataset): def __init__(self, corpus_idx, num_chars): self.corpus_idx = corpus_idx # 歌词索引表 self.num_chars = num_chars # 每个句子的字符数量 self.word_count = len(self.corpus_idx) # 词数量 self.number = self.word_count // self.num_chars # 句子数量 def __len__(self): return self.number def __getitem__(self, idx): # 确保索引在合法范围内 start = min(max(idx, 0), self.word_count - self.num_chars - 1) # 起始索引 end = start + self.num_chars # 结束索引 # 输入值 x = self.corpus_idx[start:end] # 输出值 y = self.corpus_idx[start+1:end+1] # 删除第一个字符 # x,y -> torch return torch.tensor(x), torch.tensor(y)构建网络模型
pythonclass TextGenerator(nn.Module): def __init__(self, unique_word_count): super().__init__() # 词嵌入层 self.embedding = nn.Embedding(unique_word_count, 128) # RNN层 self.rnn = nn.RNN(128, 256, num_layers=1) # 输出层 self.output = nn.Linear(256, unique_word_count) def forward(self, inputs, hidden): # 词嵌入层 emb = self.embedding(inputs) # RNN层 output, hidden = self.rnn(emb.transpose(0, 1), hidden) # 输出层: 输入内容必须是二维数据,即:词的数量 * 词的维度 # 输入维度:(seq_len * batch, 词向量维度) # 输出维度:(seq_len * batch, 词表中词数量) output = self.output(output.reshape(shape=(-1, output.shape[-1]))) return output, hidden # 预测值和隐藏状态 # 初始化隐藏状态 def init_hidden(self, batch_size): # 网络层数,batch,隐藏层维度 return torch.zeros(1, batch_size, 256)训练模型
pythondef train(): unique_words, word_to_index, unique_word_count, corpus_idx = build_vocab() dataset = LyricsDataset(corpus_idx, 32) model = TextGenerator(unique_word_count) dataloader = DataLoader(dataset, batch_size=5, shuffle=True) critetion = nn.CrossEntropyLoss() optimizer = optim.Adam(model.parameters(), lr=0.001) # 训练 epochs = 10 for epoch in range(epochs): start, iter_num, total_loss = time.time(), 0, 0.0 for x, y in dataloader: actual_batch_size = x.size(0) # 实际的批量大小 hidden = model.init_hidden(actual_batch_size) # 初始化隐藏状态 output, hidden = model(x, hidden) # 模型计算 # 计算损失 # (batch, seq_len, dim) -> (seq_len, batch, dim) -> 一维向量 -> 每个词的下标索引 y = torch.transpose(y, 0, 1).reshape(shape=(-1,)) loss = critetion(output, y) # 梯度清零 + 反向传播 + 优化器更新参数 optimizer.zero_grad() loss.backward() optimizer.step() total_loss += loss.item() # 累计损失 iter_num += 1 # 迭代次数 print(f'Epoch: {epoch+1}/{epochs}, Loss: {total_loss/iter_num:.4f}, Time: {time.time()-start:.2f}s') # 保存模型 torch.save(model.state_dict(), './model/text_generator.pth')模型测试
pythondef eval(start_word, sentence_length): unique_words, word_to_index, unique_word_count, corpus_idx = build_vocab() model = TextGenerator(unique_word_count) model.load_state_dict(torch.load('./model/text_generator.pth')) hidden = model.init_hidden(1) # 初始化隐藏层 # 将输入的文本转换为索引 word_idx = word_to_index[start_word] # 定义列表,存放: 生成文本的索引 generated_sentence = [word_idx] # 开始词索引 # 遍历句子长度 for i in range(sentence_length): # 模型预测 ootput, hidden = model(torch.tensor([[word_idx]]), hidden) # 获取预测结果 word_idx = torch.argmax(ootput).item() # 添加预测结果 generated_sentence.append(word_idx) # 索引转换为文本 sentence = [unique_words[idx] for idx in generated_sentence] print(''.join(sentence))
if __name__ == '__main__':


    train()


    eval("一颗", 500)