什么是注意力机制
目的:将人的感知方式、注意力行为应用在机器上面,让机器学会去感知数据中重要和不重要的部分
应用在机器翻译中,就是让机器注意到每个词向量之间的相关性,有侧重地进行翻译,模拟人类理解的过程
【注】注意力机制是一种通用的思想和技术,不依赖于任何模型,换句话说,注意力机制可以用于任何模型
为什么需要注意力机制
早期在解决机器翻译这一类 seq2seq 问题时,通常采用的做法是利用一个编码器(Encoder)和一个解码器(Decoder)构建端到端的神经网络模型,但是基于编码解码的神经网络存在两个问题:
- 问题 1:如果翻译的句子很长很复杂,比如直接一篇文章输进去,模型的计算量很大,并且模型的准确率下降严重。
- 问题 2:在翻译时,可能在不同的语境下,同一个词具有不同的含义,但是网络对这些词向量并没有区分度,没有考虑词与词之间的相关性,导致翻译效果比较差。
注意力机制:解决“信息利用不细致”的问题
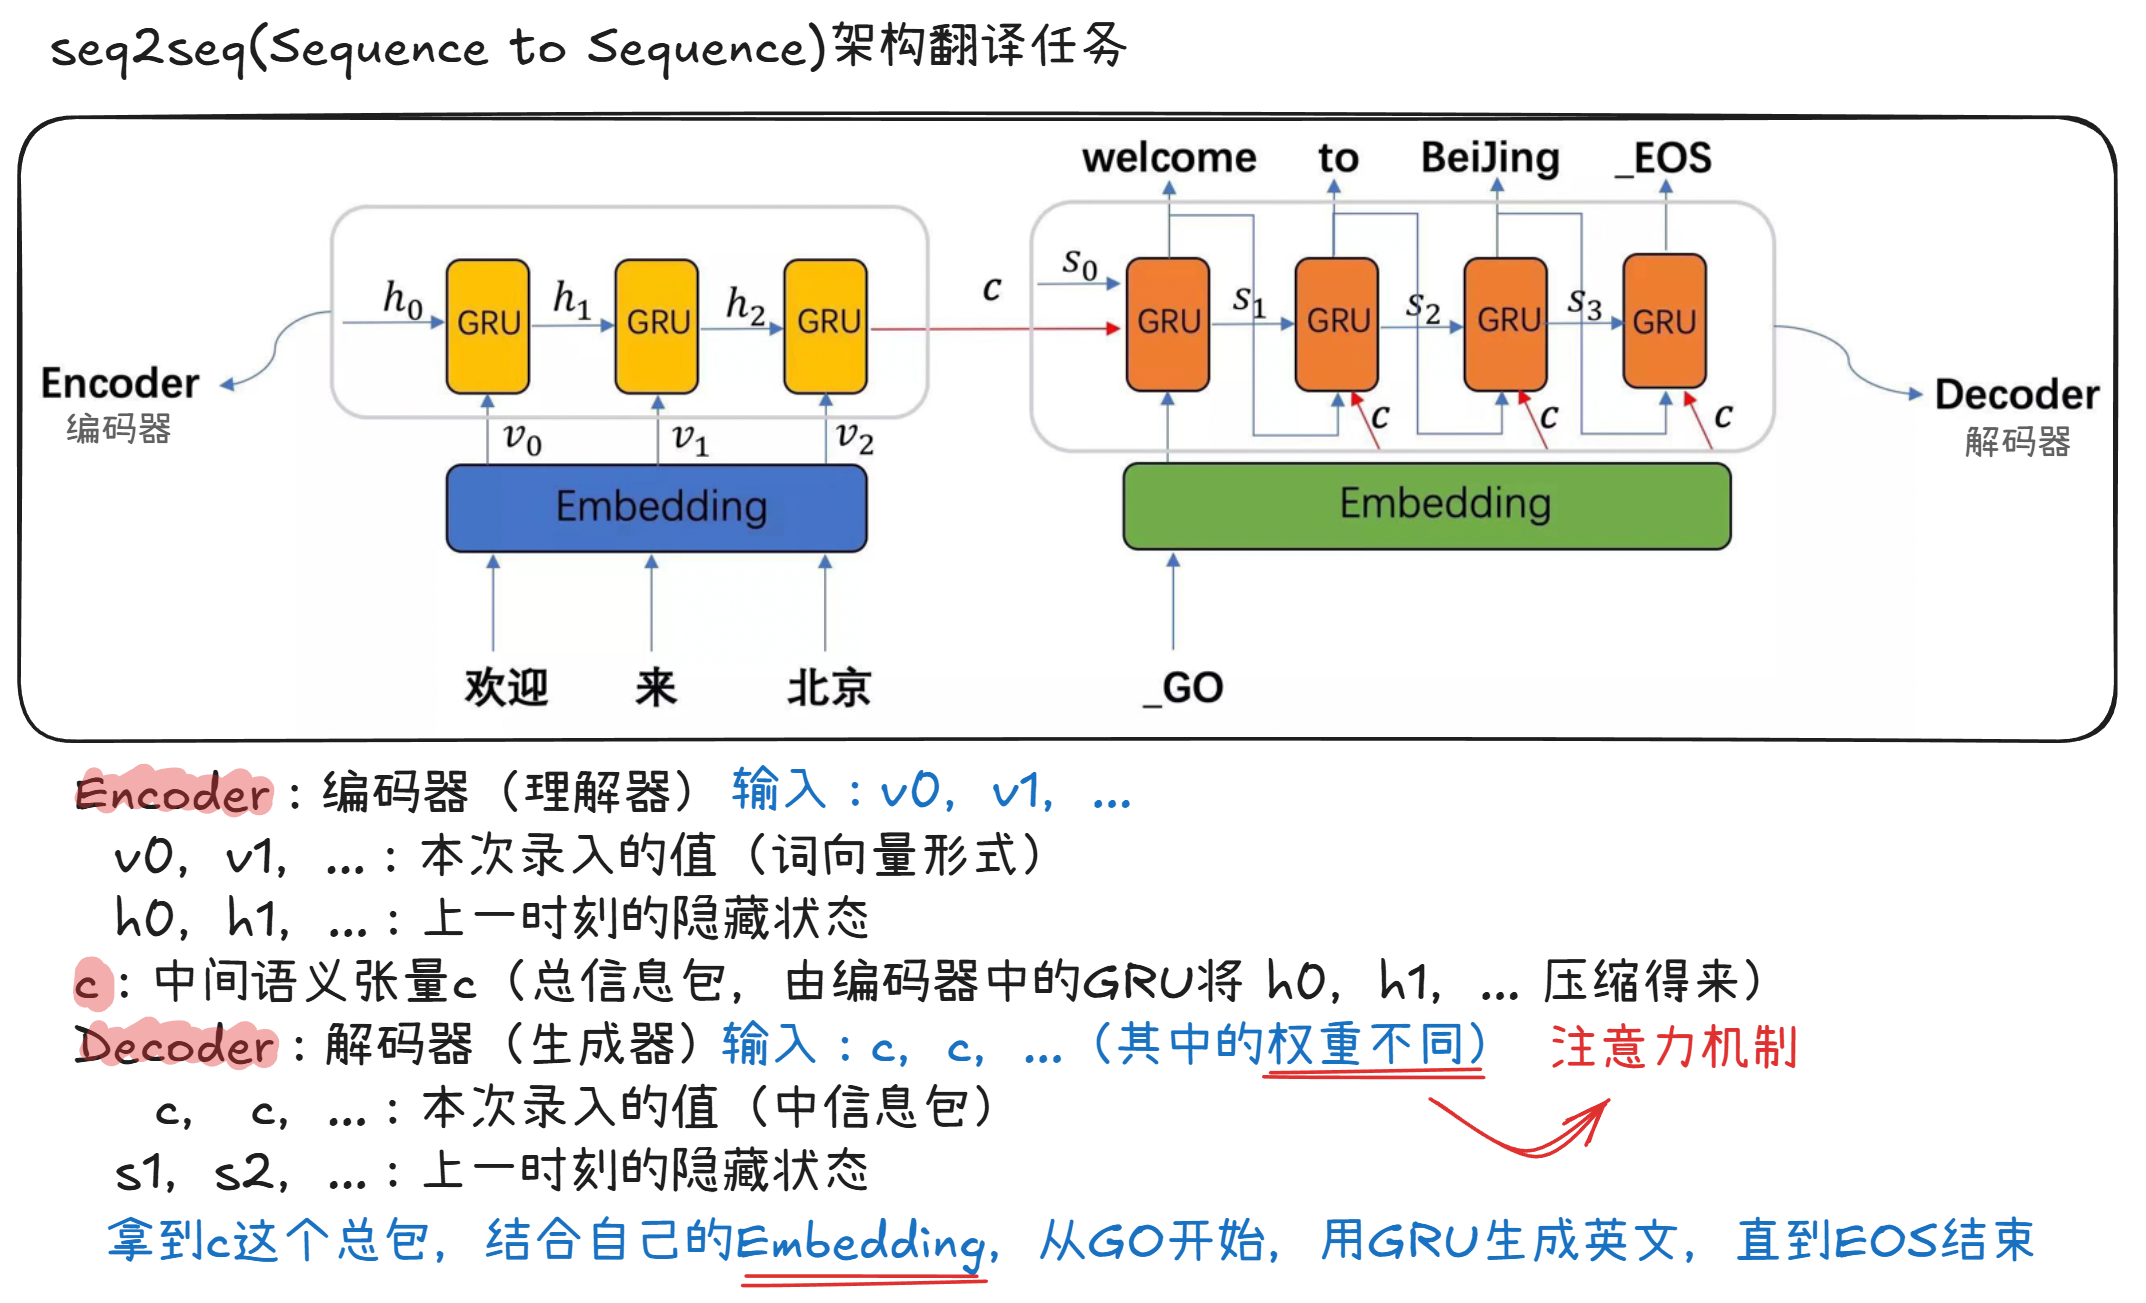
当 Decoder 要生成‘Welcome’时,让其多注意 Encoder 中‘欢迎’所对应的信息
当 Decoder 要生成‘to’时,让其多注意 Encoder 中‘来’所对应的信息
当 Decoder 要生成‘BeiJing’时,让其多注意 Encoder 中‘北京’所对应的信息
而这样比只靠 1 个‘总信息包’进行翻译要好很多,就像人翻译时,心中会一直想着原文的词,精确查找信息,翻译就更加精准,更自然
注意力机制的分类
注意力机制分为三类:软注意(全局注意)、硬注意(局部注意)、自注意(内注意)
Source == Target —— 自注意力机制 (self attention)
Source != Target
- 注意力分配系数:非 0 即 1 —— 硬注意力机制(hard attention)
- 注意力分配系数: 0~1 —— 软注意力机制(soft attention)
软注意机制(soft/global attention) :对每个输入项分配权重为 0~1 之间
某些部分关注多一点,某些则关注少一点,对大部分信息都有考虑,只不过考虑的程度不同。计算量较大
硬注意机制(hard/local attention) :对每个输入项分配权重非 0 即 1
只考虑需要关注的部分,直接舍弃一些不相关项。优势在于可以减少一定的时间和计算成本,但有可能丢掉一些本应注意的信息
自注意力机制(self/intra attention) :对每个输入项分配的权重取决于输入项之间的相互作用,即:通过输入项内部的“表决”来决定应该关注哪些输入项
相比前两种,在处理长输入时,具有并行计算的优势
Soft Attention
普通 Encoder-Decoder 框架
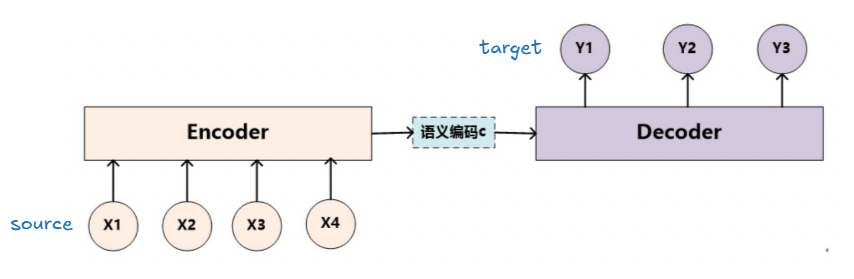
encoder,将 source 进行编码,将输入句子通过非线性变换转化为:中间语义 c
decoder,根据 c 和之前已经生成的历史信息 ,来生成 时刻要生成的单词
Target 中每个单词的生成过程如下:
:decoder 的非线性变换函数
在生成单词时,无论生成哪个单词,其使用的 都是一样的。而 又是通过对 source 经过 encoder 编码产生的,所以对于 target 中的任何一个单词,source 中任意单词对某个目标单词 来说影响力都是相同的。
故:Encoder-Decoder 框架是没有体现出“注意力”的
引入 Attention 的 Encoder-Decoder 框架
举例说明痛点:
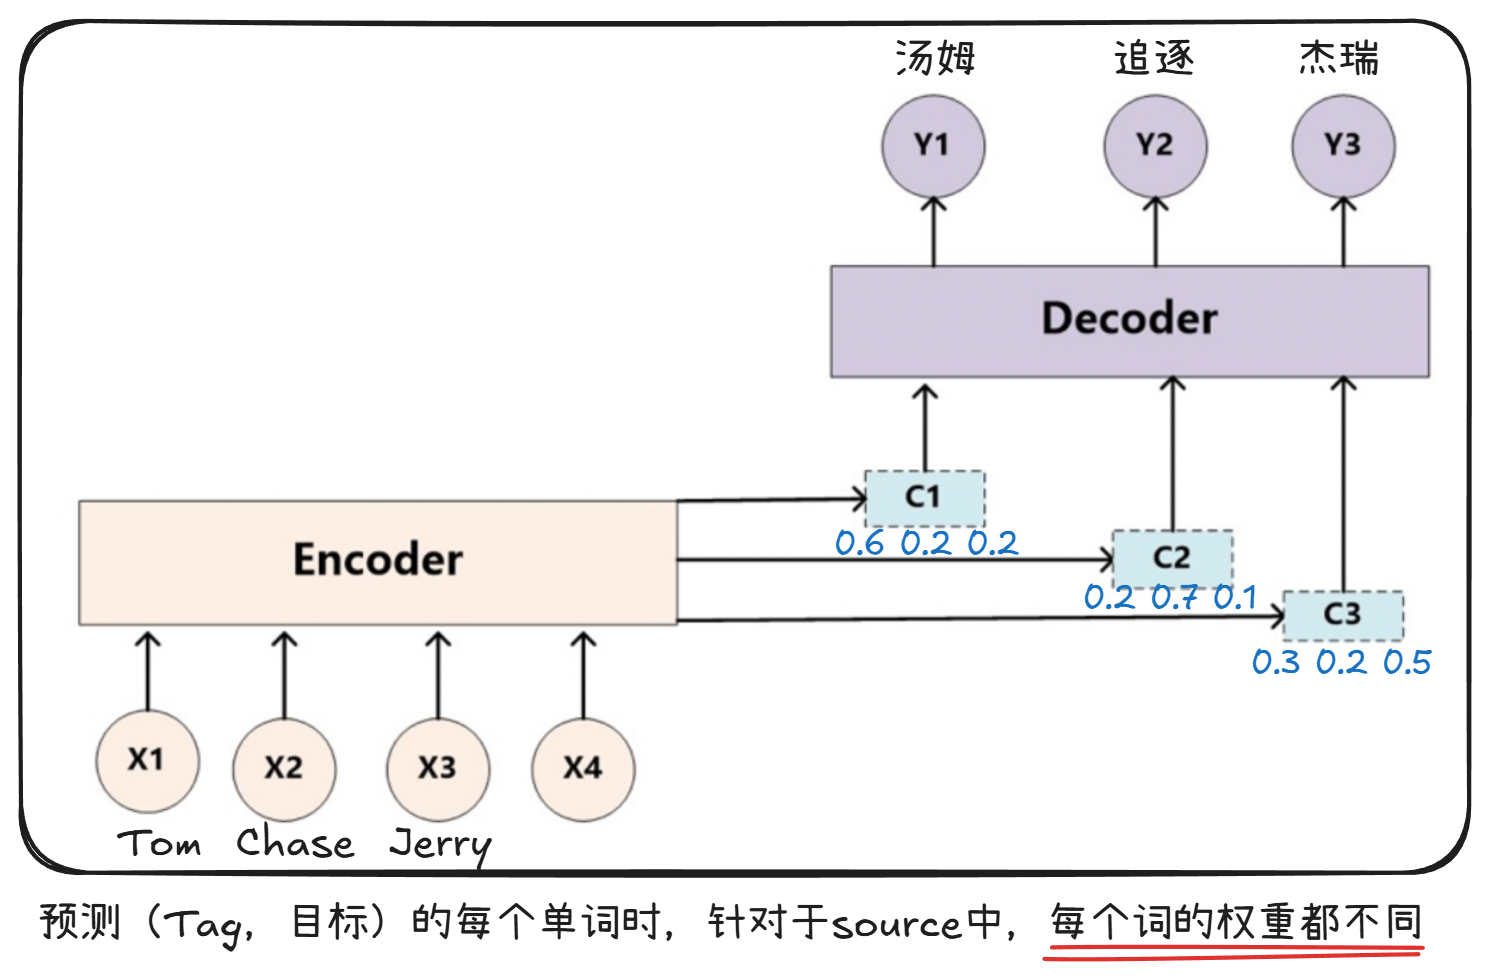
- 以机器翻译 "Tom chase Jerry" -> "汤姆 追逐 杰瑞" 为例。
- 在普通 Encoder-Decoder 中,生成目标词(如“杰瑞”)时,源句子(source)里的每个单词对它的贡献被视为相同的(即:使用一个固定的中间语义向量 )。这显然不合理,因为显然 "Jerry" 对翻译成 "杰瑞" 最重要。
引入 Attention 的改进:
- 如果引入 Attention 模型,在生成“杰瑞”时,模型会给源单词分配不同的权重(概率) 。
- 例如:(Tom, 0.3), (Chase, 0.2), (Jerry, 0.5)。这代表模型在翻译当前词时,将更多的“注意力”分配给了 "Jerry"。
核心结论:
- 对于 Target(目标句)中的每一个单词,都应该有对应 Source(源句)中单词的一组注意力分配概率。
- 关键变化:由于 Attention 的加入,生成 Target 单词时的中间语义向量 不再是固定的,而是会根据注意力概率动态变化的。这就是加 Attention 的 Encoder-Decoder 框架的核心。
 ^yd38a4
Target 中每个单词的生成过程如下:
:根据信息包 和历史信息,拼出新词的规则
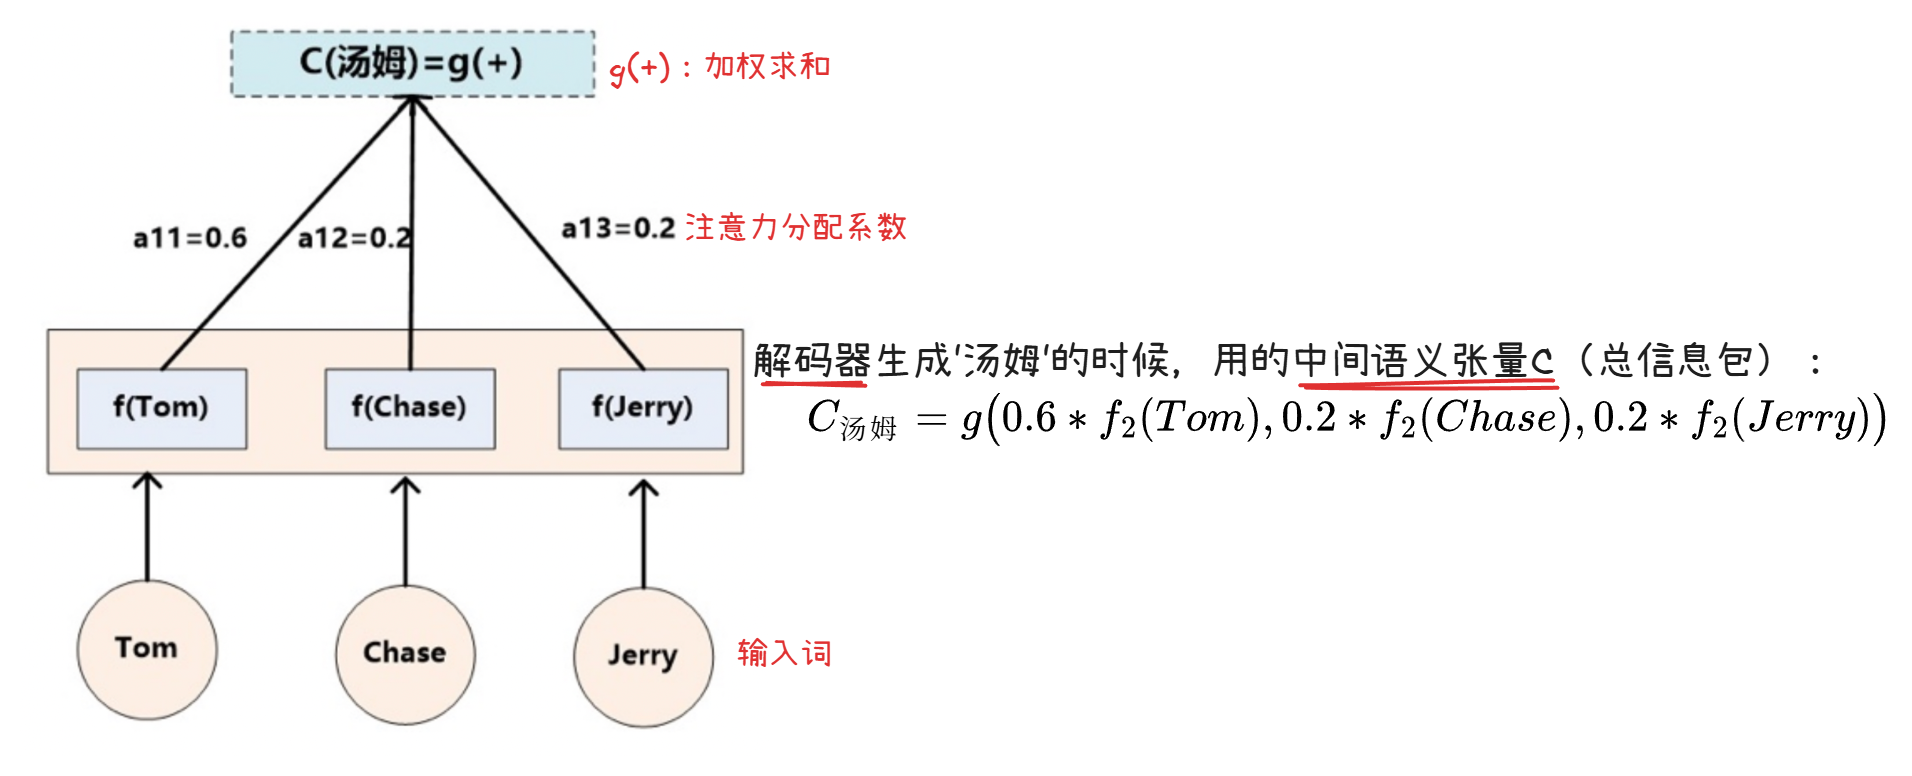
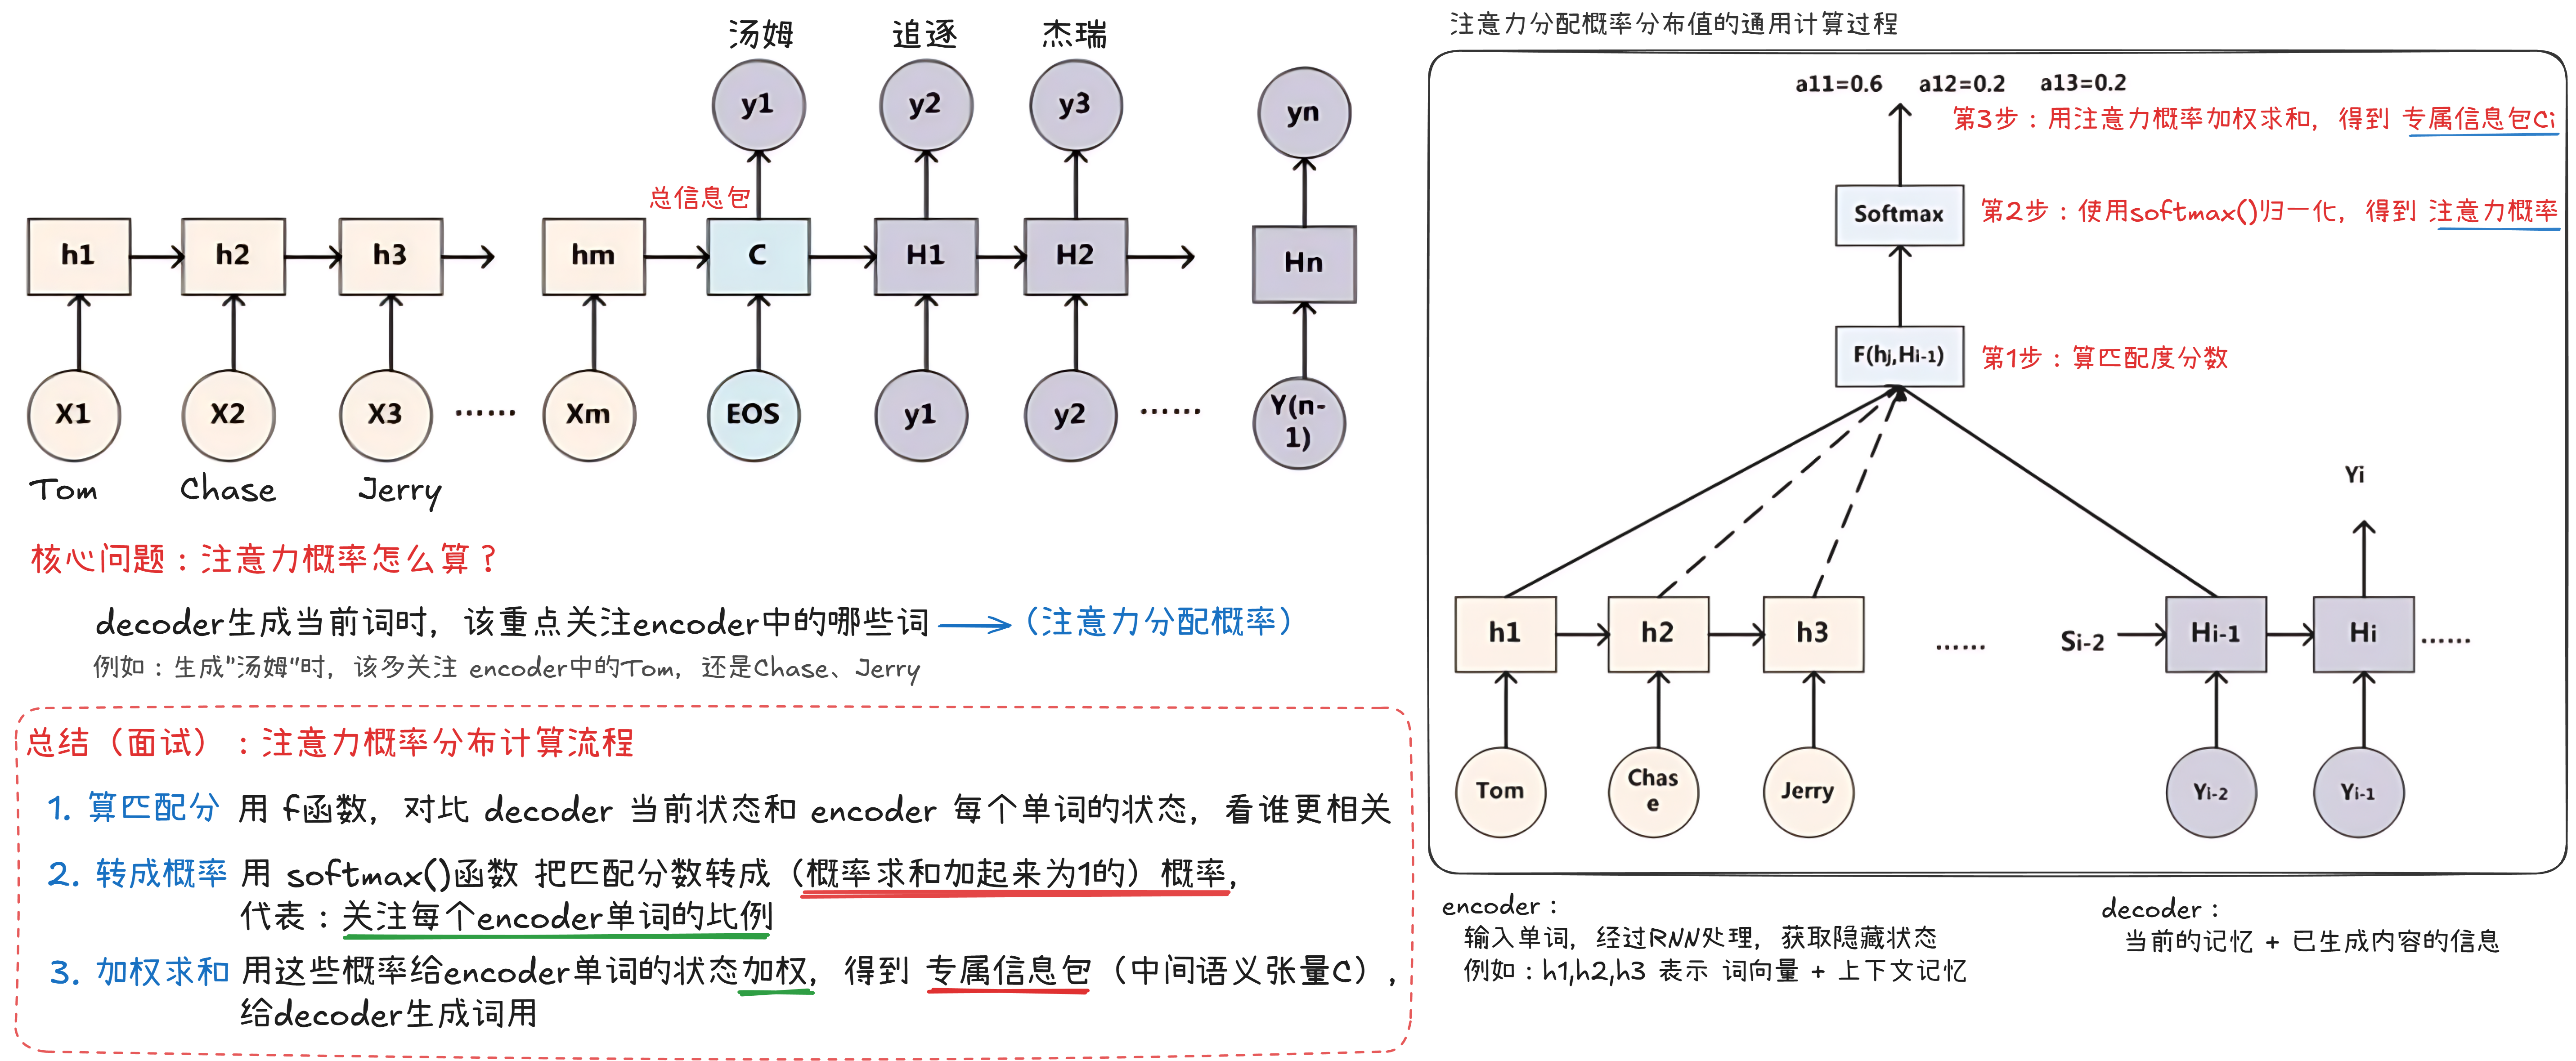
而每个 可能对应着不同的源语句子单词的注意力分配概率分布,比如对于上面的英汉翻译来说,其对应的信息可能如下:
:encoder 对每个输入词的基础处理(即:转成词向量)
:把词向量结果,按照权重(注意力分配系数)拼接起来的函数
:输入 source 的长度
:在输出(生成)target 第 个单词时,输入 source 中的第 个单词的注意力分配系数
:输入 source 中第 个单词的语义编码,例如:
如何得到注意力概率分布
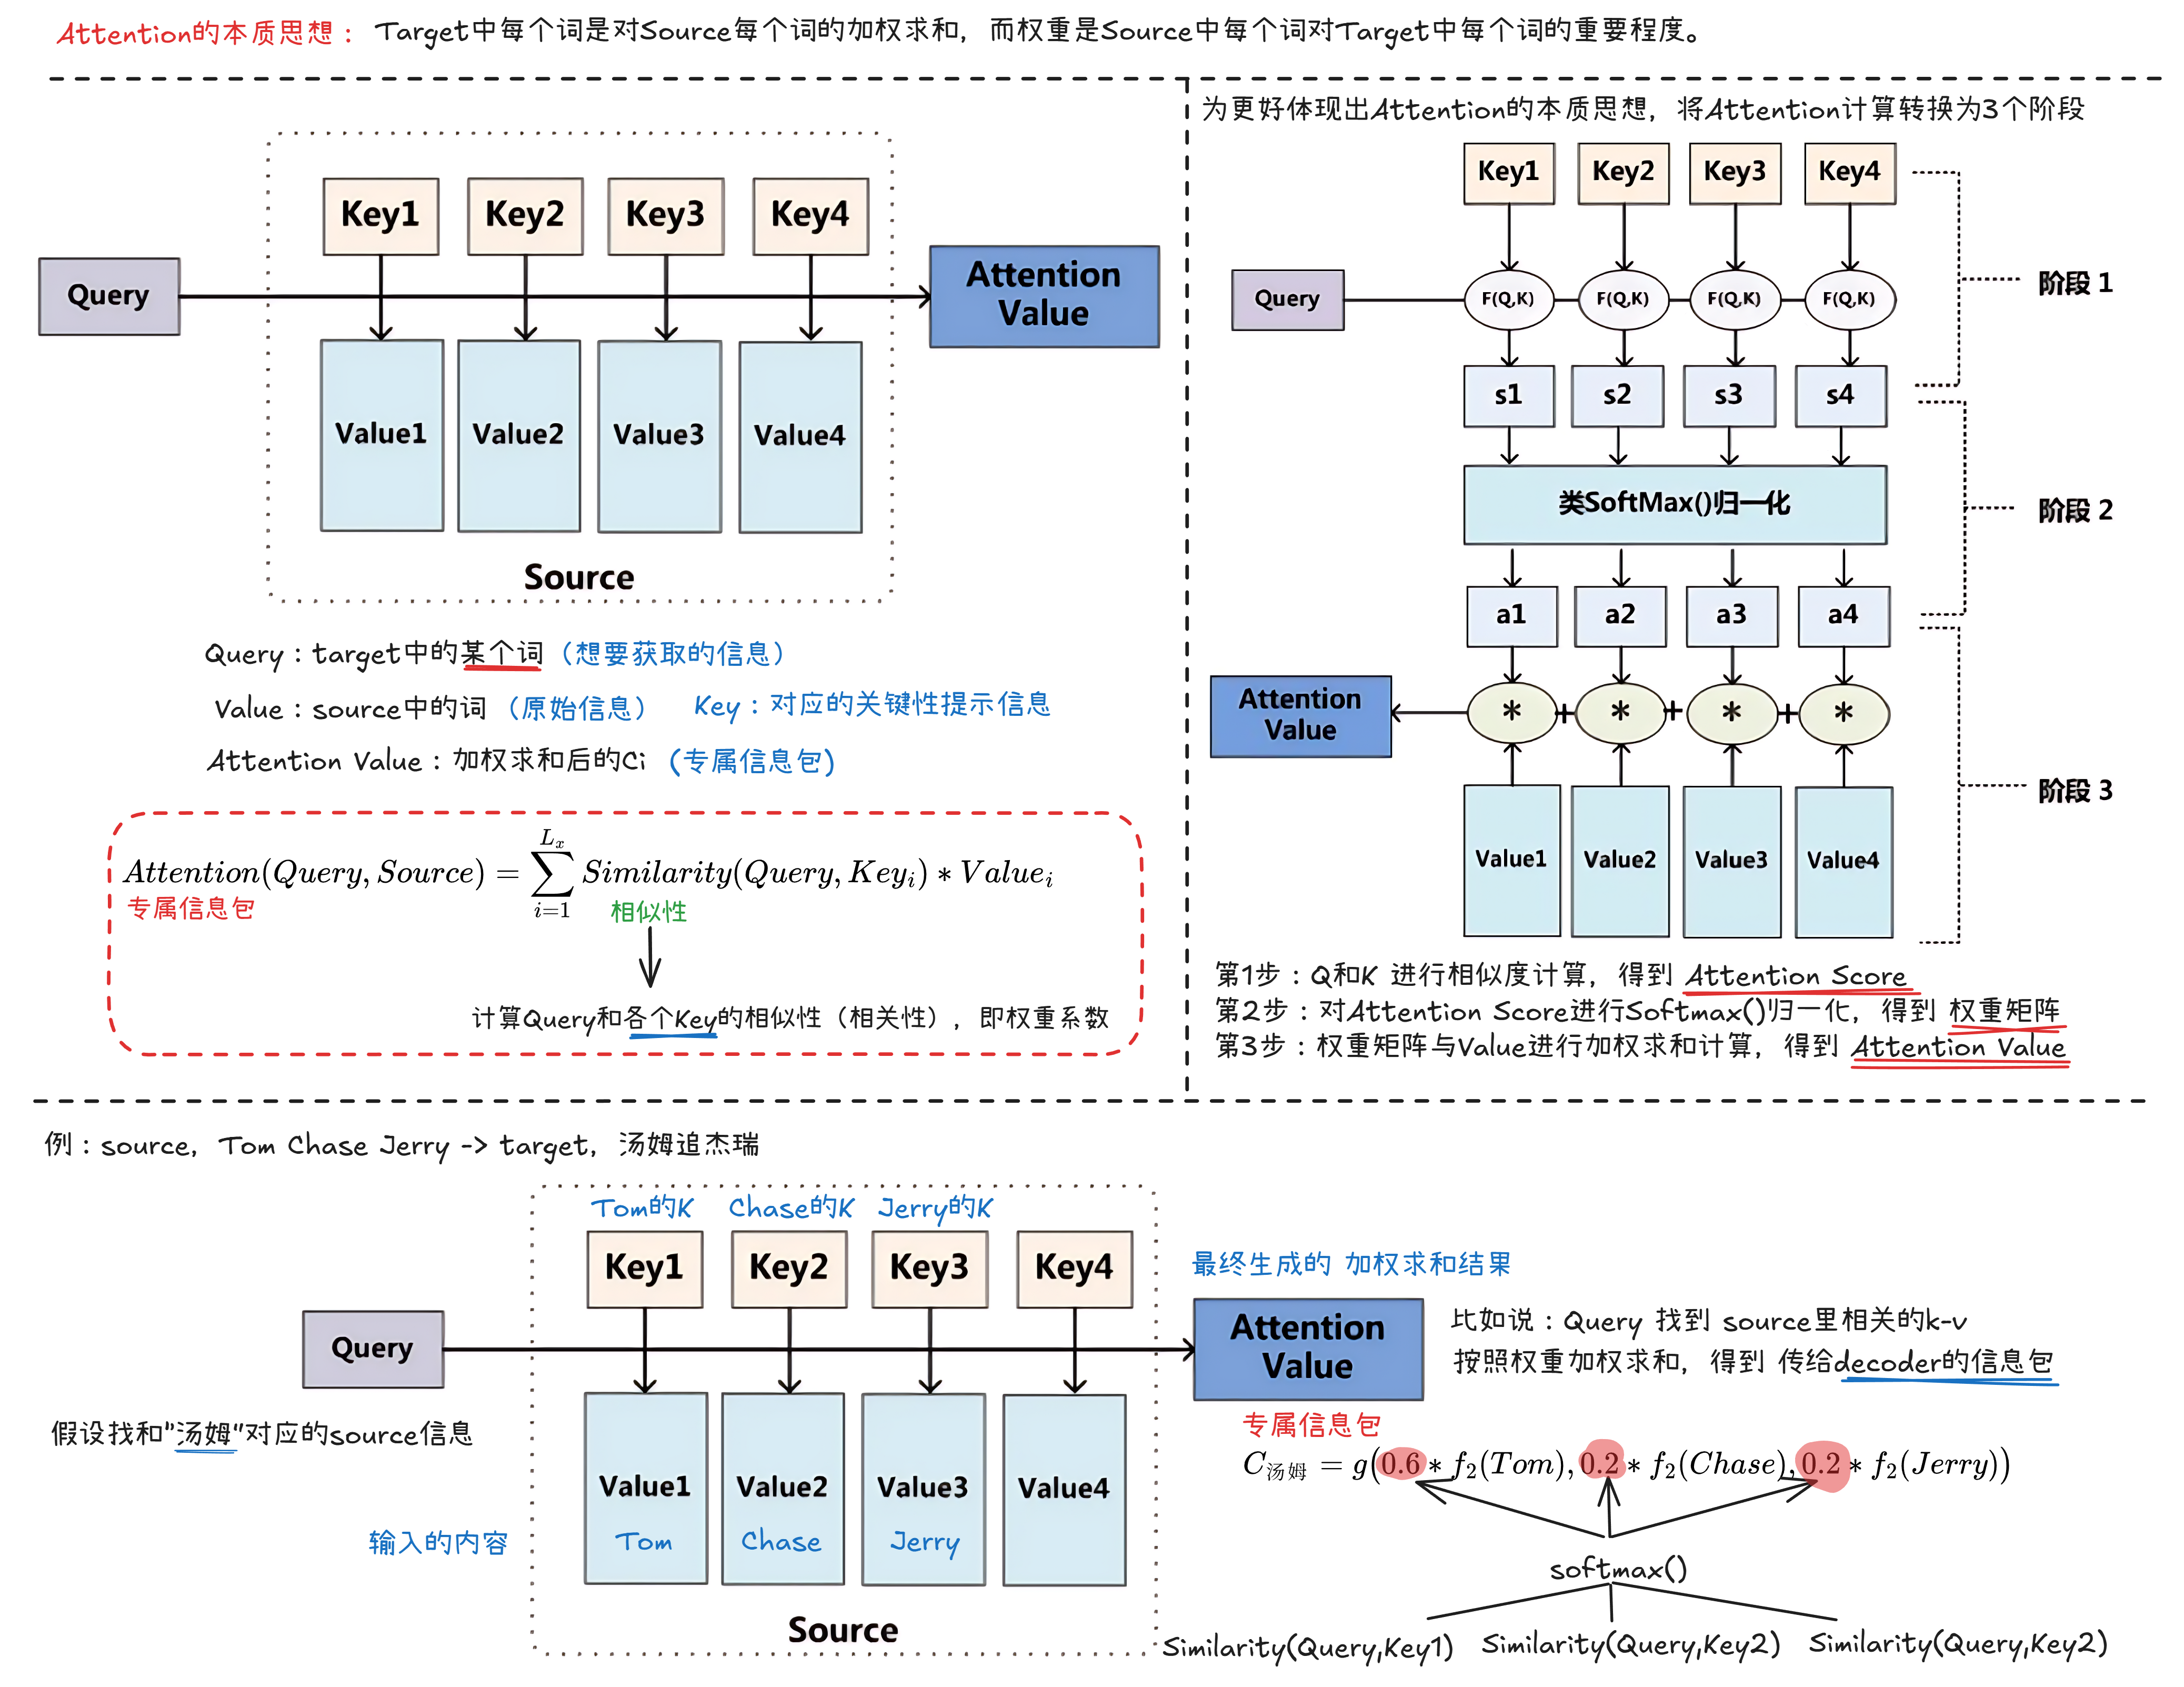
Soft Attention 机制的本质思想
Target 中每个词是对 Source 每个词的加权求和,而权重是 Source 中每个词对 Target 中每个词的重要程度。
Hard Attention
对每个输入项分配权重(注意力系数)非 0 即 1
软性注意力的方式进行 Attention 机制,它通过注意力分布来加权求和融合各个输入向量。
而硬性注意力(Hard Attention)机制则不是采用这种方式,它是根据注意力分布选择输入向量中的一个作为输出。这里有两种选择方式:
- 选择注意力分布中,分数最大的那一项对应的输入向量作为 Attention 机制的输出。
- 根据注意力分布进行随机采样,采样结果作为 Attention 机制的输出。
硬性注意力通过以上两种方式选择 Attention 的输出,这会使得最终的损失函数与注意力分布之间的函数关系不可导,导致无法使用反向传播算法训练模型,硬性注意力通常需要使用强化学习来进行训练。
因此,一般深度学习算法会使用软性注意力的方式进行计算,
Self Attention
Self Attention 是 Google 在 transformer 模型中提出的,上面介绍的都是一般情况下 Attention 发生在 Target 元素 Query 和 Source 中所有元素之间。
而 Self Attention,指的是 Source 内部元素之间 或者 Target 内部元素之间发生的 Attention 机制,也可以理解为 Target=Source 这种特殊情况下的注意力机制。
具体的计算过程仍然是一样的,只是计算对象发生了变化而已。
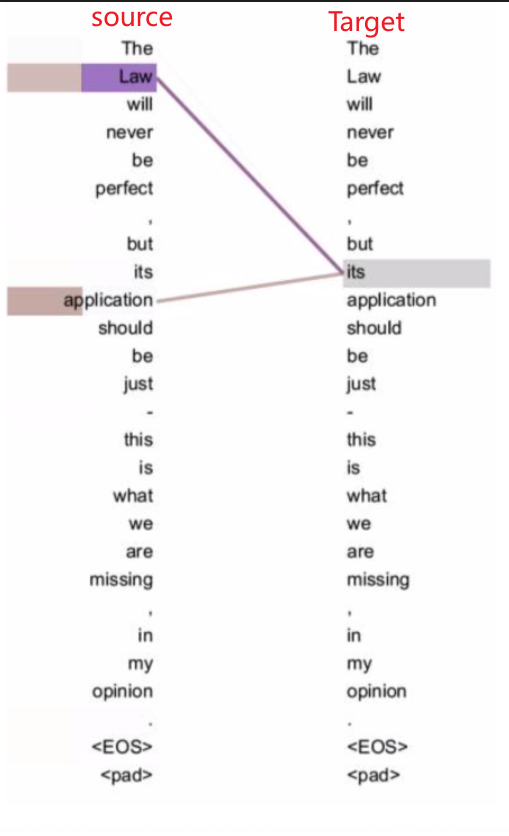
上面内容也有说到,一般情况下 Attention 本质上是 Target 和 Source 之间的一种单词对齐机制。那么如果是 Self Attention 机制,到底学的是哪些规律或者抽取了哪些特征呢?或者说引入 Self Attention 有什么增益或者好处呢?仍然以机器翻译为例来说明, 如下图所示:“正义可能会迟到,但是永远不会缺席”
Attention 的发展主要经历了两个阶段:
- 从上图中可以看到, self Attention 可以远距离的捕捉到语义层面的特征(its 的指代对象是 Law).
- 应用传统的 RNN, LSTM, 在获取长距离语义特征和结构特征的时候, 需要按照序列顺序依次计算, 距离越远的联系信息的损耗越大, 有效提取和捕获的可能性越小.
- 但是应用 self-attention 时, 计算过程中会直接将句子中任意两个 token 的联系通过一个计算步骤直接联系起来
注意力机制规则
Seq2Seq + Attention
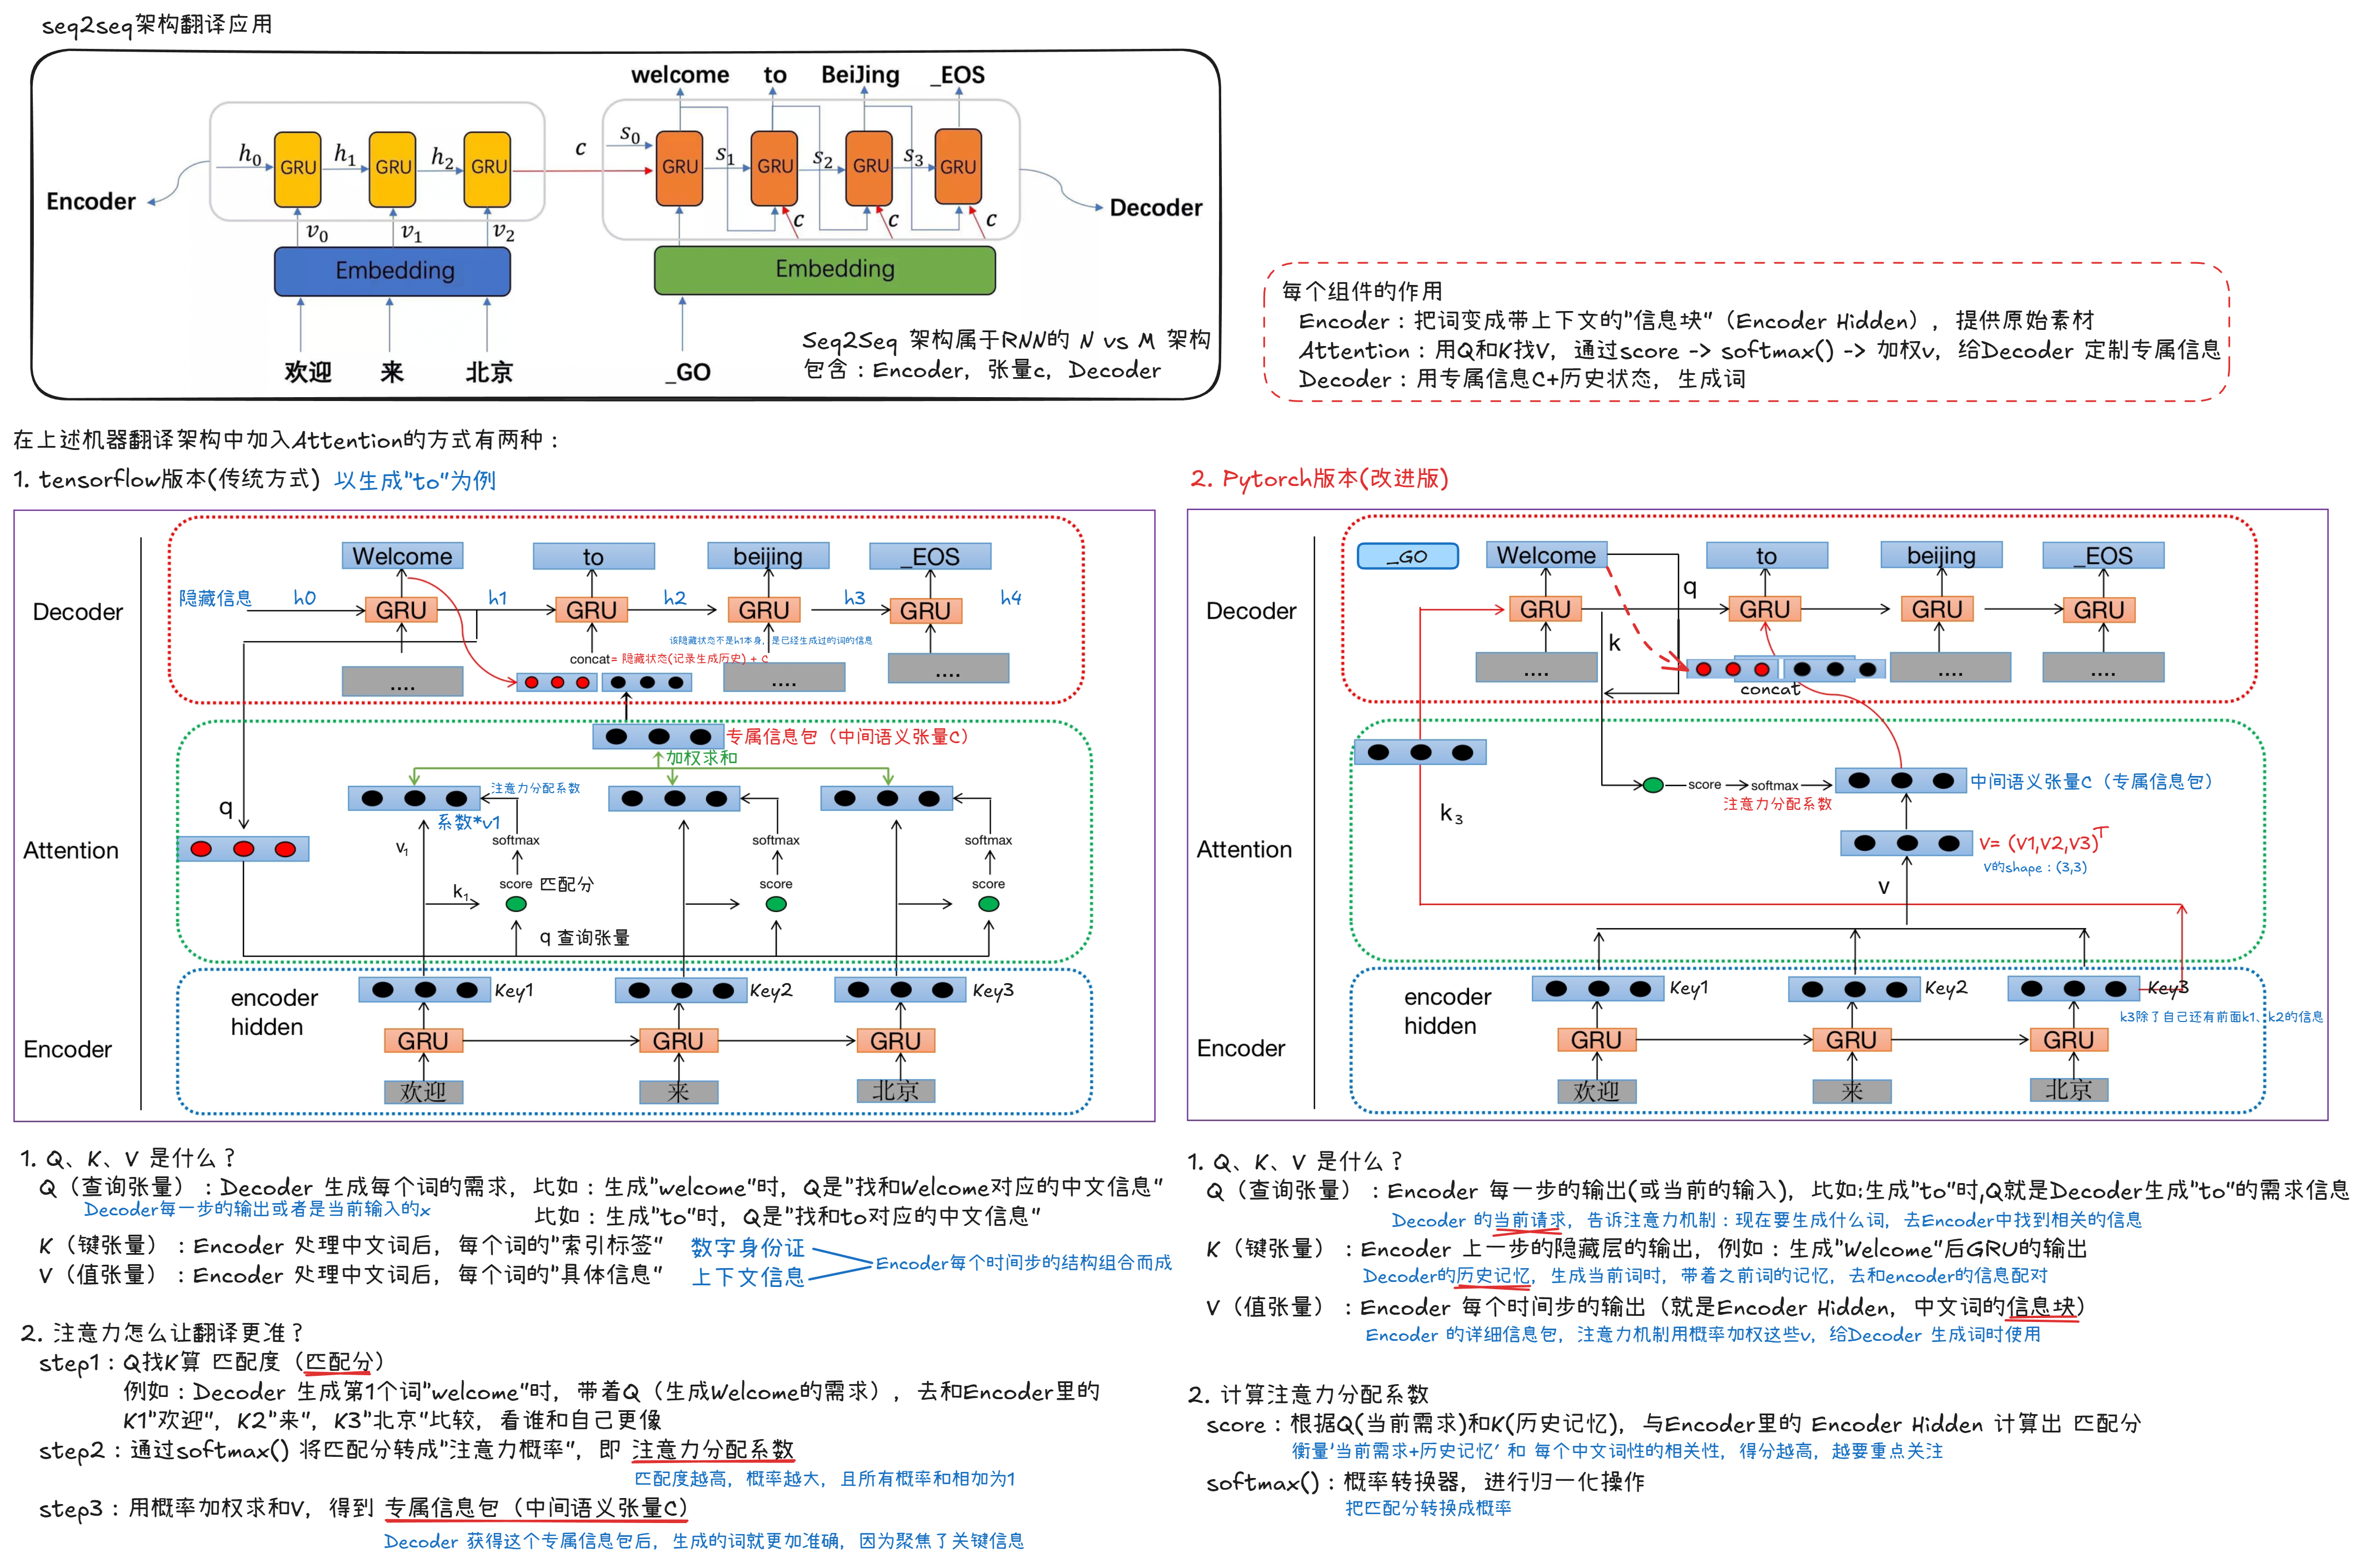
两个版本对比:
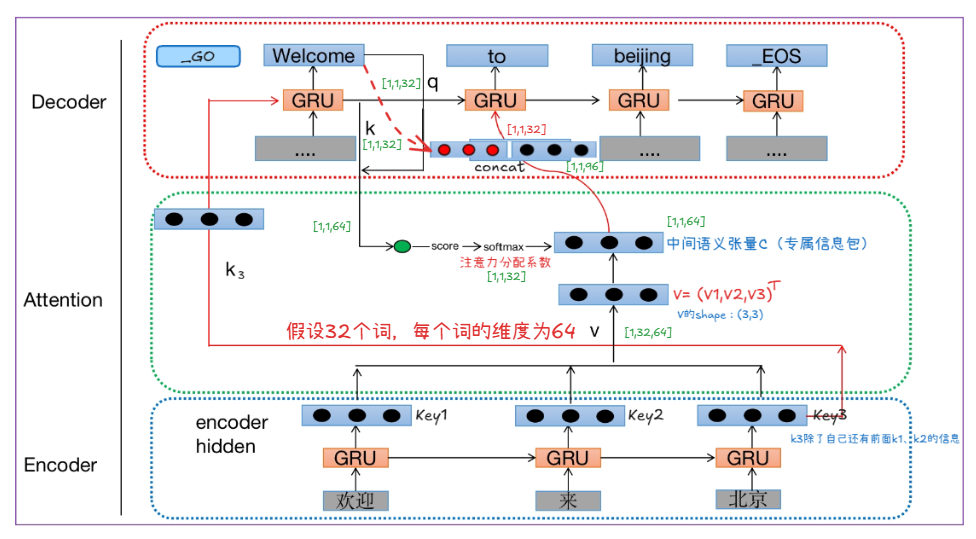
pytorch 版本的是乘型 attention,tensorflow 版本的是加型 attention。pytorch 这里直接将与上一个 unit 隐藏状态 prev_hidden 拼接起来得到 score,之后将 score 过 softmax 得到 attenion_weights.
解码过程如下:
- (1)采用自回归机制,比如:输入“go”来预测“welcome”,输入“welcome”来预测"to",输入“to”来预测“Beijing”。在输入“welcome”来预测"to"解码中,可使用注意力机制
- (2)查询张量 Q:一般可以是“welcome”词嵌入层以后的结果,查询张量 Q 为生成谁就是谁的查询张量(比如这里为了生成“to”,则查询张量就是“to”的查询张量,请仔细体会这一点)
- (3) 键向量 K:一般可以是上一个时间步的隐藏层输出
- (4)值向量 V:一般可以是编码部分每个时间步的结果组合而成
- (5)查询张量 Q 来生成“to”,去检索“to”单词和“欢迎”、“来”、“北京”三个单词的权重分布,注意力结果表示(用权重分布 乘以内容 V)
常见的注意力计算规则
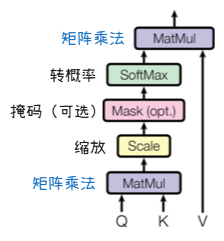
注意力机制计算规则,需要三个指定的输入 Q(query), K(key), V(value), 然后通过计算公式得到注意力的结果,这个结果代表 Q 在 K 和 V 作用下的注意力表示
- 当输入的 Q=K=V 时, 称作自注意力计算规则
- 当 Q、K、V 不相等 时称为一般注意力计算规则
将 Q,K 进行纵轴拼接, 做一次线性变化, 再使用 softmax 处理获得结果最后与 V 做张量乘法
python算匹配分 映射概率 加权 (拼接 + 线性变换 + softmax) * V将 Q,K 进行纵轴拼接, 做一次线性变化后再使用tanh函数激活, 然后再进行内部求和, 最后使用softmax处理获得结果再与 V 做张量乘法
tanh -> [-1,1],让模型捕捉更加复杂的信息,相当于增加了“非线性变化”
sum -> 求和,把“分散”的信息汇总
python(拼接 + 线性变换 + tanh + sum softmax) * V将 Q 与 K 的转置做点积运算, 然后除以一个缩放系数, 再使用 softmax 处理获得结果最后与 V 做张量乘法
python自注意力 (点积 + 缩放 + softmax) * V Q·K^T:计算Q和K的相似度 √d_k:d_k 是K的维度 目的:防止点积结果过大,导致softmax后概率极端 比如 有的得分特别高,其它特别低,模型学不到细节
说明:当注意力权重矩阵和 V 都是三维张量且第一维代表为 batch 条数时, 则做 bmm 运算
import torch
"""
matmul: 适用于通用的场景,特别是当输入维度不确定 或 需要广播时
        例如: (10,3,4)@(1,4,5) -> (10,3,5)
bmm: 专门用于批量矩阵乘法, 例如在处理序列数据时(RNN, Transformer)效率更高
     批量处理数据时, 提高计算效率(不用一组一组手动计算, 是‘并行计算’)
     例如: (10,3,4)@(10,4,5) -> 报错

    总结:
        1. 在处理批量矩阵乘法 且 输入时 3维张量时, 优先使用 bmm(), 因为效率更好
        2. 当输入维度不确定 或 需要广播时, 使用 matmul()

问题: 注意力计算规则(总结) -> 3种注意力计算方式
    不管是哪种规则, 核心都是: 算Q和K的相关性 -> 转成概率 -> 概率 * V 挑重点信息
    只是算“相关性”的方式(例如:拼接、点积) 和 中间处理(线性变化,Tanh等)不同
"""
mat1 = torch.randn(10,3,4)  # 10个批次的 3行4列的矩阵
mat2 = torch.randn(10,4,5)  # 10个批次的 4行5列的矩阵
# 批量矩阵乘法
# matmul()
res1 = torch.matmul(mat1, mat2)  # 广播机制,自动填充 (1,4,5) -> (10,4,5)
print(res1.shape, res1)
# bmm()
res2 = torch.bmm(mat1, mat2)
print(res2.shape, res2)
print(res1 == res2)  # 全部都是 True
深度神经网络注意力机制
注意力机制是注意力计算规则能够应用的深度学习网络的载体, 同时包括一些必要的全连接层以及相关张量处理, 使其与应用网络融为一体. 使自注意力计算规则的注意力机制称为自注意力机制.
(面试)为什么要在深度神经网络中引入注意力机制?
rnn 等循环神经网络,随着时间步的增长,前面单词的特征会遗忘,造成对句子特征提取不充分
rnn 等循环神经网络是一个时间步一个时间步的提取序列特征,效率低下
研究者开始思考,能不能对 32 个单词(序列)同时提取事物特征,而且还是并行的,所以引入注意力机制!
注意力机制的作用
- 在解码器端的注意力机制:能够根据模型目标有效的聚焦编码器的输出结果,当其作为解码器的输入时提升效果。改善以往编码器输出是单一定长张量,无法存储过多信息的情况
- 在编码器端的注意力机制:主要解决表征问题,相当于特征提取过程,得到输入的注意力表示,一般使用自注意力(self-attention)
注意力机制实现(计算)步骤
- 第一步: 根据注意力计算规则, 对Q,K,V进行相应的计算.
- 第二步: 根据第一步采用的计算方法, 如果是拼接方法,则需要将Q与第二步的计算结果再进行拼接, 如果是转置点积, 一般是自注意力, Q与V相同, 则不需要进行与Q的拼接.
- 第三步: 最后为了使整个attention机制按照指定尺寸输出, 使用线性层作用在第二步的结果上做一个线性变换, 得到最终对Q的注意力表示.
注意力机制在网络中实现的图形表示:
代码实现
"""
任务描述:有QKV,v是内容比如32个单词,每个单词64个特征,k是32个单词的索引,q是查询张量
我们的任务:输入查询张量q,通过注意力机制来计算如下信息:
    1. 查询张量q的注意力权重分布:查询张量q和其他32个单词相关性(相识度)
    2. 查询张量q的结果表示:有一个普通的q升级成一个更强大q;用q和v做bmm运算
    3. 注意:查询张量q查询的目标是谁,就是谁的查询张量。
        比如:查询张量q是来查询单词"我",则q就是我的查询张量
"""import torch.nn as nn
import torch.nn.functional as F
# 自定义注意力机制,实现:Q(查询张量)和键值对(K,V)的注意力计算
class MyAttention(nn.Module):
def __init__(self, query_size, key_size, value_size1, value_size2, output_size):
"""
:param query_size: 查询张量的维度
:param key_size: 键张量的维度
:param value_size1: 值张量的序列长度(即: 有多少个词)
:param value_size2: 值张量的维度(词向量)
:param output_size: 输出张量的维度
"""
super().__init__()
# 核心参数
self.query_size = query_size
self.key_size = key_size
self.value_size1 = value_size1
self.value_size2 = value_size2
self.output_size = output_size
# 注意力权重计算层:将Q和K进行拼接后,映射到 值张量的序列长度
# 例如:Q(32)+ K(32)=64, 值张量的序列长度:64
self.attn = nn.Linear(self.query_size + self.key_size, self.value_size1)
# 注意力融合层:将“原始Q”和“注意力加权后的V”拼接(融合)后,映射到 输出维度
# 例如:Q(32)+ V(64)=96, 输出维度:32
self.attn_combine = nn.Linear(self.query_size + self.value_size2, self.output_size)
def forward(self, Q, K, V):
"""
:param Q: 查询张量,维度为[1,1,query_size] -> [1,1,32]
:param K: 键张量, 维度为[1,1,key_size] -> [1,1,32]
:param V: 值张量, 维度为[1,value_size1,value_size2] -> [1,32,64]
:return: output:[1,1,output_size], attn_weights:[1,value_size1]
"""
# 1. 计算Q的 注意力权重分布
# 拼接 Q和K
qk_concat = torch.cat((Q[0], K[0]), dim=-1) # [1,query_size+key_size]
# 计算注意力得分
attn_score = self.attn(qk_concat) # [1,value_size1]
# 转换为概率分布
attn_weights = F.softmax(attn_score, dim=-1) # [1,value_size1]
print("attn_weights", attn_weights.shape)
# 2. 应用注意力权重(注意力分配系数)到 值张量V
# 扩展注意力权重维度,以匹配V的批次维度:[1,value_size1] -> [1,1,value_size1]
attn_weights_expanded = attn_weights.unsqueeze(0) # 在0维度增加一个维度
# bmm() 矩阵乘法, attn_weights_expanded * V = [1,1,value_size1] * [1,value_size1,value_size2]
attn_applied = torch.bmm(attn_weights_expanded, V) # [1,1,value_size2]
print("attn_applied", attn_applied.shape)
# 3. Q 与 attn_applied 融合,并映射到 输出维度
output_cat = torch.cat((Q, attn_applied), dim=-1) # [1,1,query_size+value_size2]
output = self.attn_combine(output_cat) # [1,1,output_size]
print("output", output.shape)
return output, attn_weights
query_size, key_size, value_size1, value_size2, output_size = 32, 32, 32, 64, 32
att = MyAttention(query_size, key_size, value_size1, value_size2, output_size)
Q = torch.randn(1,1,query_size)
K = torch.randn(1,1,key_size)
V = torch.randn(1,value_size1,value_size2)
output, attn_weights = att(Q, K, V)
print("output", output.shape)
print("attn_weights", attn_weights.shape)