KNN算法
KNN算法 简介
K-近邻算法(K Nearest Neighbor,简称KNN)
KNN算法思想:如果一个样本在特征空间中的 k 个最相似的样本中的大多数属于某一个类别,则该样本也属于这个类别
思考:如何确定样本的相似性?
样本相似性:样本都是属于一个任务数据集的。样本距离越近则越相似。
相似性:
欧式距离 = 对应维度差值平方和,开平方根【案例】利用K近邻算法预测电影类型
解决问题:分类问题(classification)、回归问题(Regression)
标签不连续(分类,投票)、标签连续(回归,均值)
分类流程 & 回归流程
计算未知样本到每一个训练样本的距离
将训练样本根据距离大小升序排列
取出距离最近的 K 个训练样本
【分类】进行多数表决,统计 K 个样本中哪个类别的样本个数最多
【回归】把这个 K 个样本的目标值计算其平均值
【分类】将未知的样本归属到出现次数最多的类别
【回归】将作为未知的样本预测的值
K值的选择
为何K值过小容易发生过拟合,而K值过大容易发生欠拟合?
K值过小:相当于用较小领域中的训练实例进行预测
容易受到异常点的影响
K值的减小就意味着整体模型变得复杂,容易发生过拟合
K值过大:相当于用较大领域中的训练实例进行预测
容易受到样本均衡的问题
K值的增大就意味着整体的模型变得简单,容易发生欠拟合
举例:K=N(N为训练样本个数)
- 无论输入实例是什么,只会按训练集中最多的类别进行预测,受到样本均衡的影响
如何对K超参数进行调优?
需要一些方法来寻找这个最合适的K值
交叉验证、网格搜索
距离度量
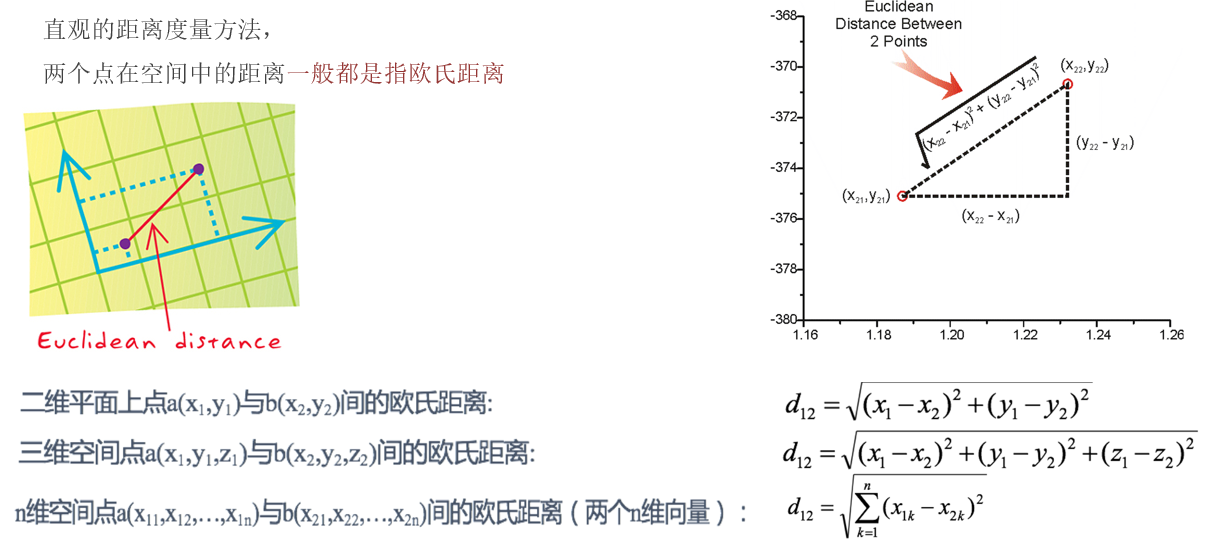
欧式距离(Euclidean Distance)
欧式距离 = 对应维度差值平方和,开平方根
曼哈顿距离(Manhattan Distance)
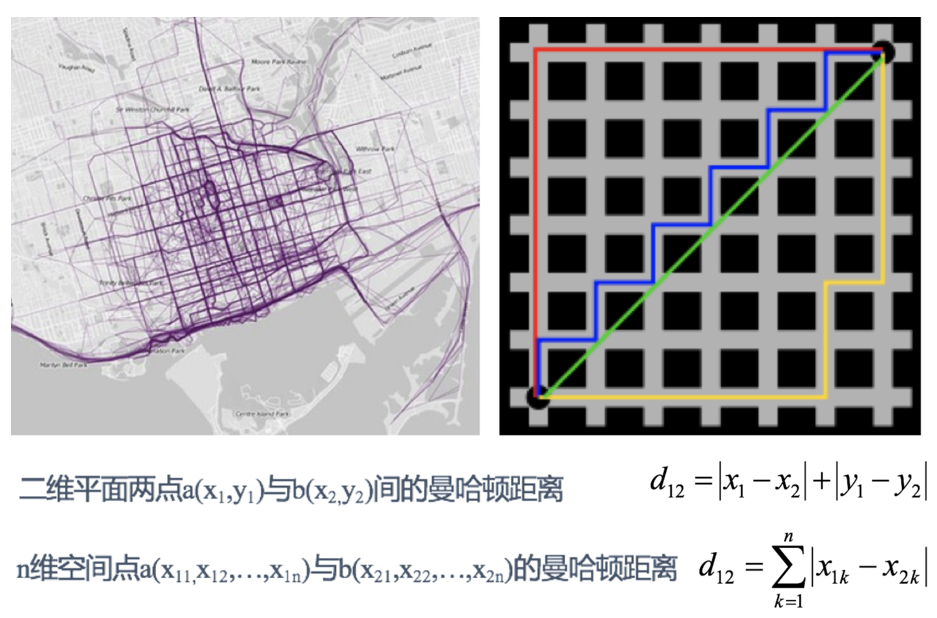
曼哈顿距离也称为“城市街区距离”(City Block distance)
曼哈顿城市特点:横平竖直
曼哈顿距离 = 对应维度差值的绝对值之和
切比雪夫距离(Chebyshev Distance)
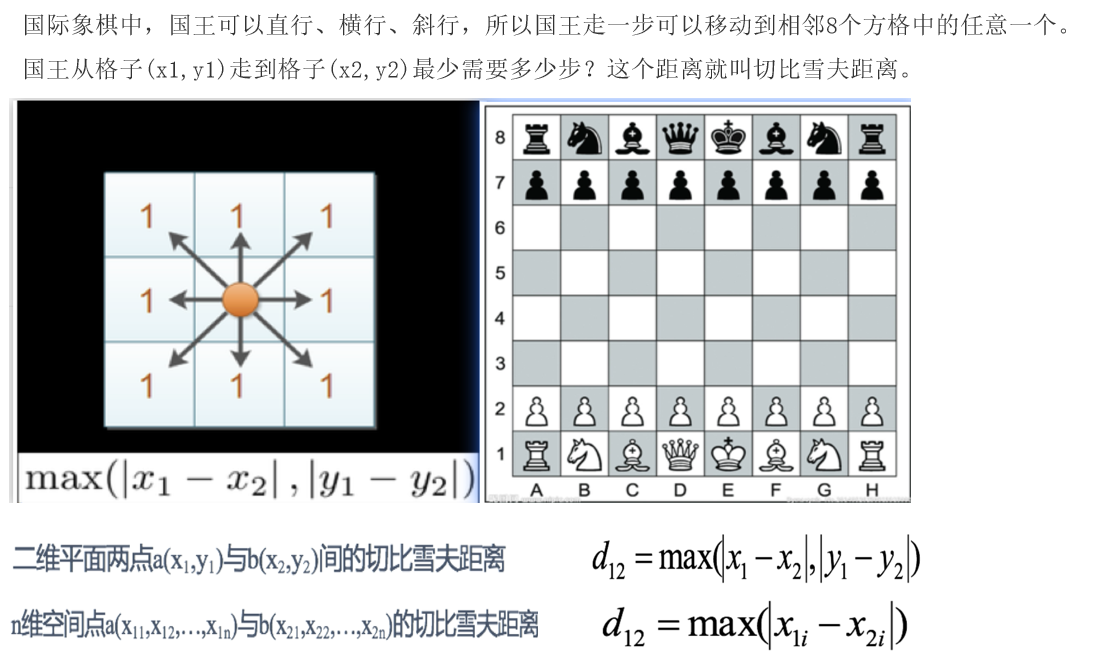
切比雪夫距离 = 对应维度差值绝对值的最大值
闵氏距离(Minkowski Distance)
闵可夫斯基距离,简称为:闵式距离
不是一种新的距离的度量方式。
而是距离的组合 是对多个距离度量公式的概括性的表述
两个 维变量 与 间的闵可夫斯基距离定义为
其中 是一个变参数:
当 时,就是曼哈顿距离;
当 时,就是欧氏距离;
当 时,就是切比雪夫距离。
根据 的不同,闵氏距离可表示某一类种的距离