聚类
基本概念
什么是聚类算法
聚类算法是一种无监督学习 方法,其核心思想是:
根据样本之间的相似性,将数据自动划分为若干个类别(簇),使得同一簇内的样本尽可能相似,而不同簇之间的样本尽可能不同。
相似性度量是关键:常用的计算方式包括欧式距离、曼哈顿距离、余弦相似度等。不同的相似度标准可能导致不同的聚类结果。
目标:揭示数据中隐藏的分组规律,帮助我们理解数据的分布特征。
✅ 举个例子:
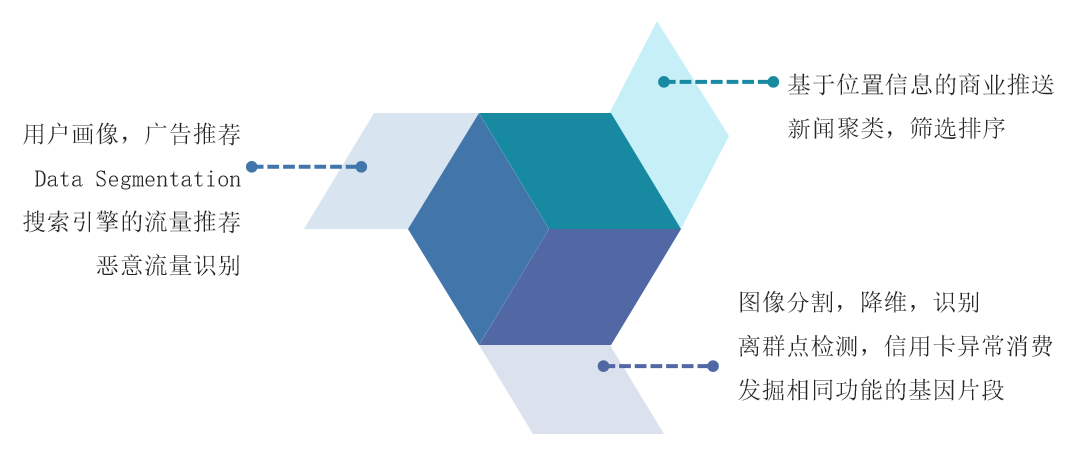
在客户数据分析中,聚类可以自动将用户分为“高消费高收入”、“低消费高收入”等群体,帮助企业制定精准营销策略。
聚类结果受准则影响:使用不同的聚类算法(如 K-Means、DBSCAN)或参数设置,会产生不同的聚类效果,因此选择合适的算法和评估指标非常重要。
|关键点|内容|
| --------| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
|本质|无监督学习算法|
|依据|样本间的相似性(如距离)|
|目的|在没有先验知识的情况下,自动发现数据的内在结构和模式|
|特点|不依赖标签,自动分组|
|输出|多个簇(Cluster),每个簇代表一个群体|
聚类算法在现实中的应用
聚类算法 分类
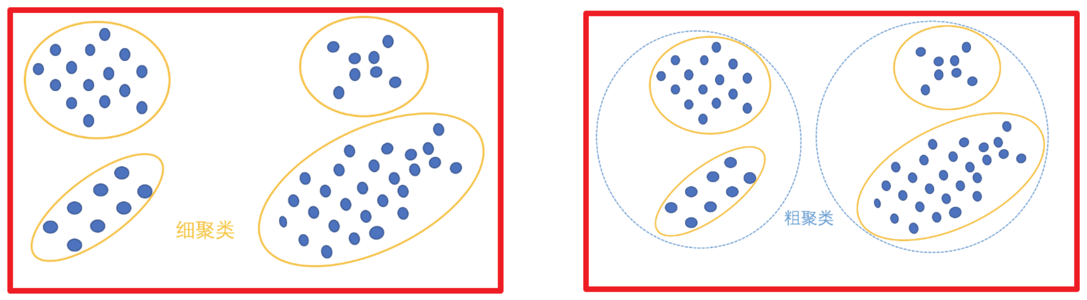
按照聚类颗粒度划分:细聚类 vs 粗聚类
|类型|特点|图解说明|
| --------| ------------------------------------------------------------------------------| ------------------------------------------------------------------------------|
|细聚类|将数据划分为多个较小的、独立的簇,每个簇代表一个具体的子群体。|如左图所示,每个椭圆圈出一组紧密聚集的点,表示对数据进行了细致划分。|
|粗聚类|在细聚类的基础上进一步合并相似的簇,形成更大的类别,体现更高层次的分组结构。|如右图所示,蓝色虚线将多个细粒度簇组合成两个更大的“超级簇”,用于宏观分析。|
✅ 应用场景对比:
- 细聚类适用于需要精细用户画像或细分市场分析。
- 粗聚类适合快速了解整体结构,常用于探索性数据分析。
按照实现方法分类(常见聚类算法)
|算法名称|核心思想|特点与适用场景|
| -------------------------------------| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------| -------------------------------------------------------------------------------------------------------------------------------------------------------------|
|K-Means|基于质心的聚类方法,通过迭代更新簇中心,使样本到其所属簇中心的距离最小化。|✅ 通用性强、计算效率高
❌ 需预先指定簇数 KK ,且假设簇为球形分布||层次聚类(Hierarchical Clustering)|对数据进行逐层划分(自底向上)或合并(自顶向下),构建树状结构(Dendrogram)。|✅ 不需预设簇数,能展示聚类过程
❌ 计算复杂度较高,不适合大数据集||DBSCAN|基于密度的聚类算法,能够识别任意形状的簇,并自动发现噪声点(离群点)。|✅ 可处理非球形簇,抗噪声能力强
❌ 对参数敏感,稀疏区域可能误判||谱聚类(Spectral Clustering)|基于图论思想,将数据视为图中的节点,利用图的拉普拉斯矩阵进行降维后再聚类。|✅ 适合复杂结构数据,如环形、月牙形分布
❌ 计算成本较高,依赖邻接图构造|
如何选择合适的聚类算法?
|数据特点|推荐算法|
| --------------------------------| ----------|
|数据分布均匀、簇为球形|K-Means|
|需要可视化聚类过程、无固定簇数|层次聚类|
|存在噪声、簇形状不规则|DBSCAN|
|数据具有复杂拓扑结构|谱聚类|
“颗粒度”反映的是聚类的精细程度,细聚类更注重细节,粗聚类关注整体趋势。
实现方法决定了算法的假设前提、性能表现和适用范围。
实际应用中,通常先尝试 K-Means,再结合业务需求选择其他高级算法。
K-Means
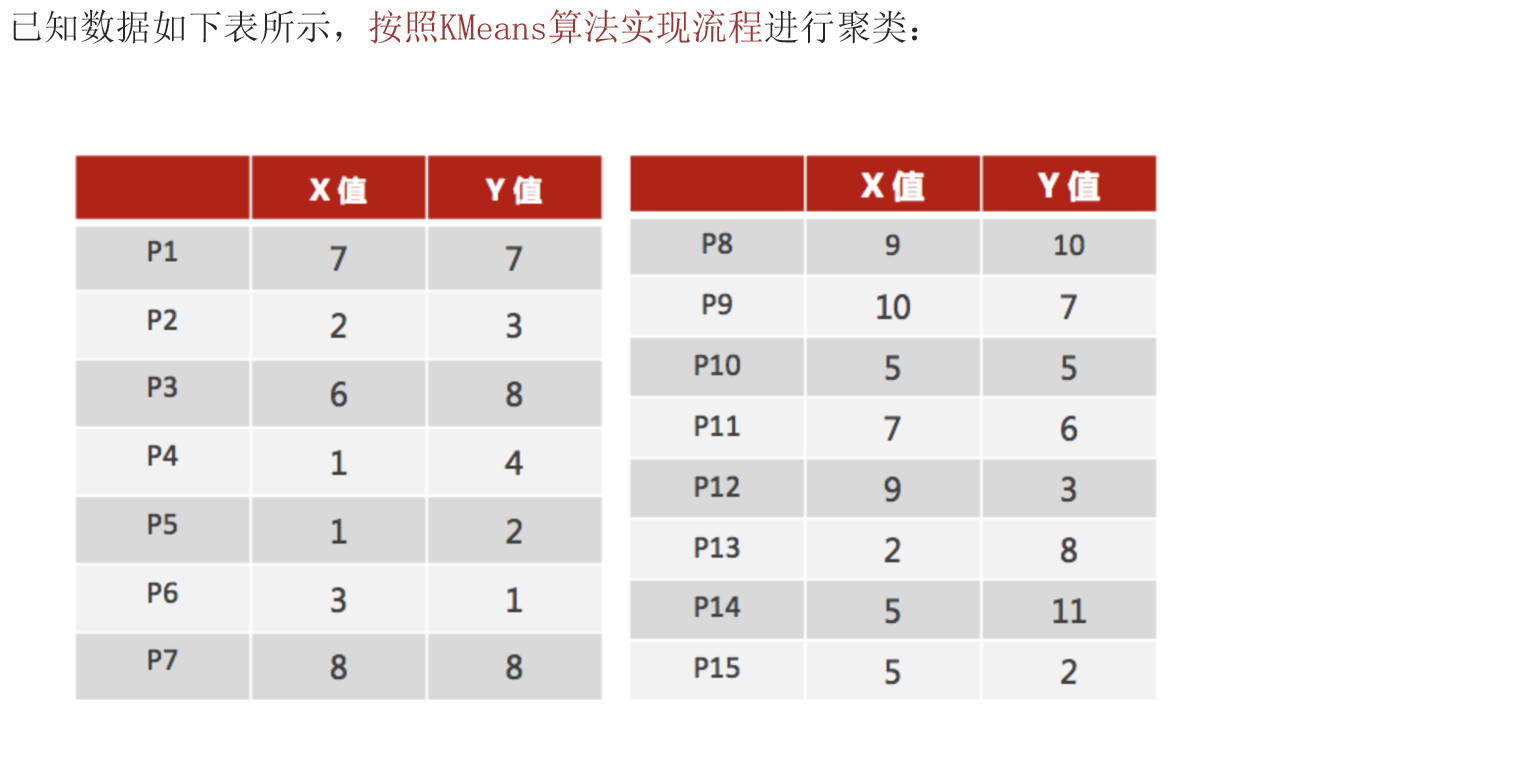
KMeans 算法实现流程
事先确定常数 K,表示最终要划分的聚类类别数。
- K 必须预先指定,通常通过肘部法则或轮廓系数确定。
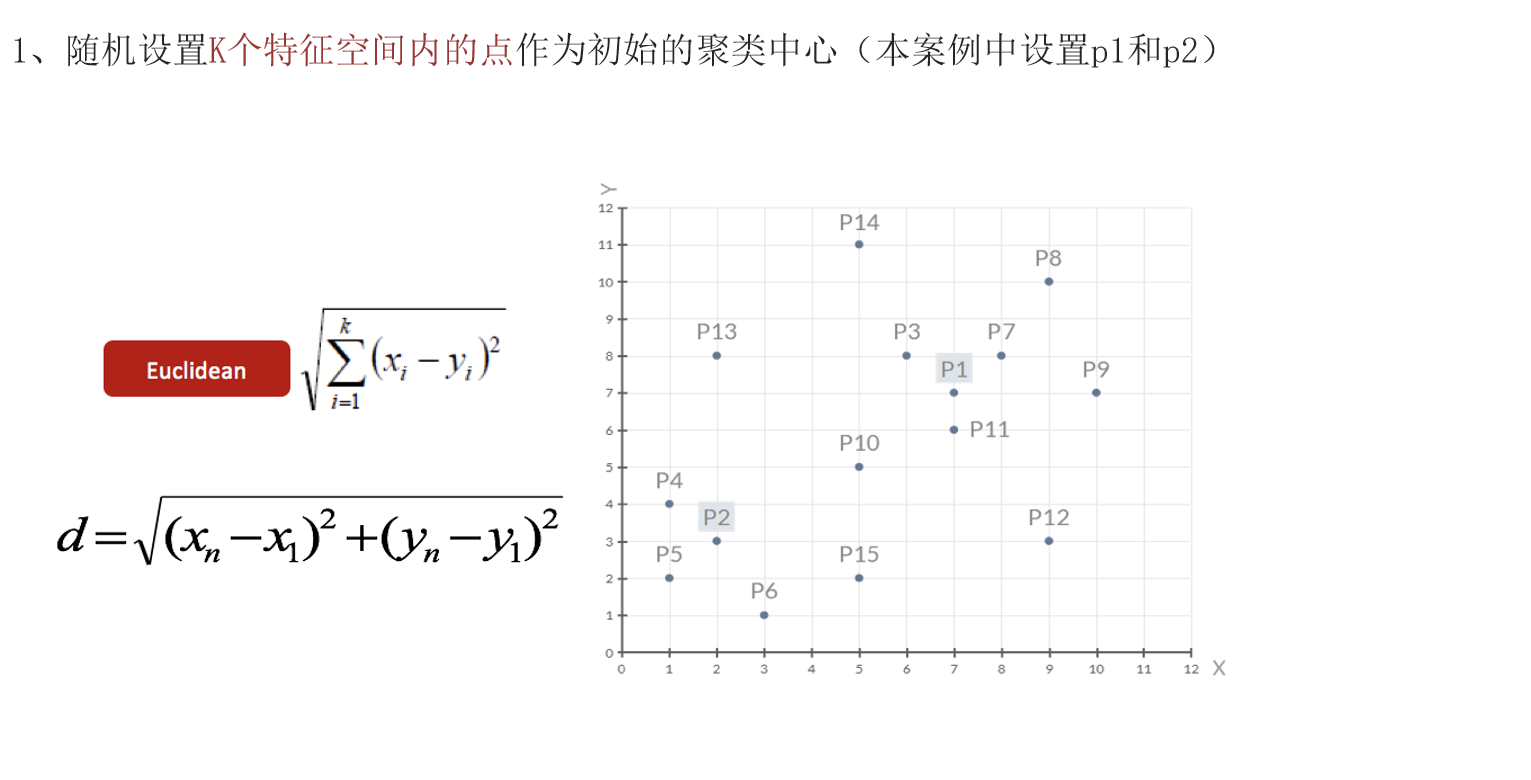
初始化 K 个聚类中心:
传统方法:随机从样本中选择 K 个点;
推荐方法:使用 k-means++ 智能初始化,提高稳定性。
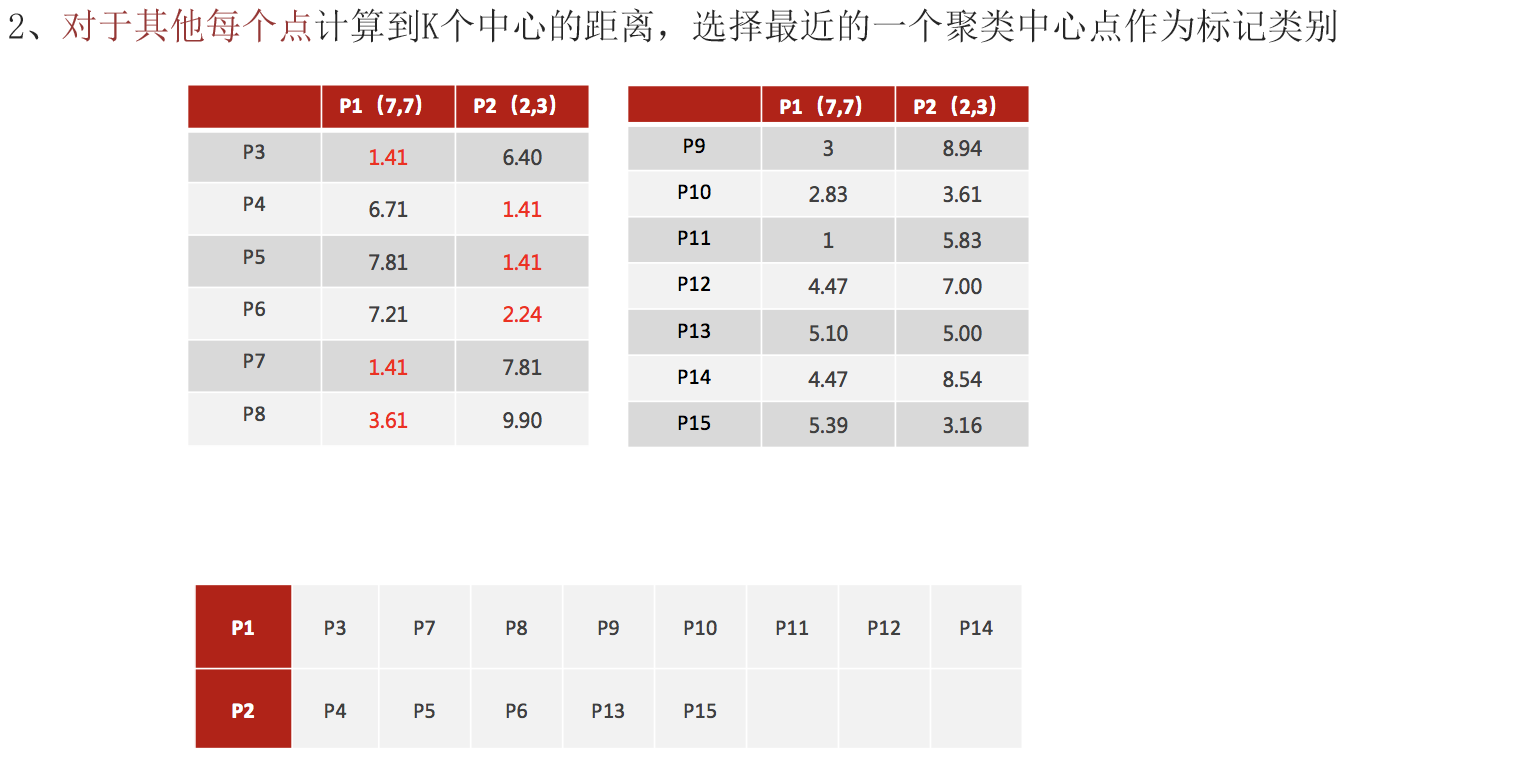
计算每个样本到 K 个中心的欧氏距离,将其分配给最近的聚类中心。
- 注意:若特征尺度差异大,需先对数据进行标准化处理。
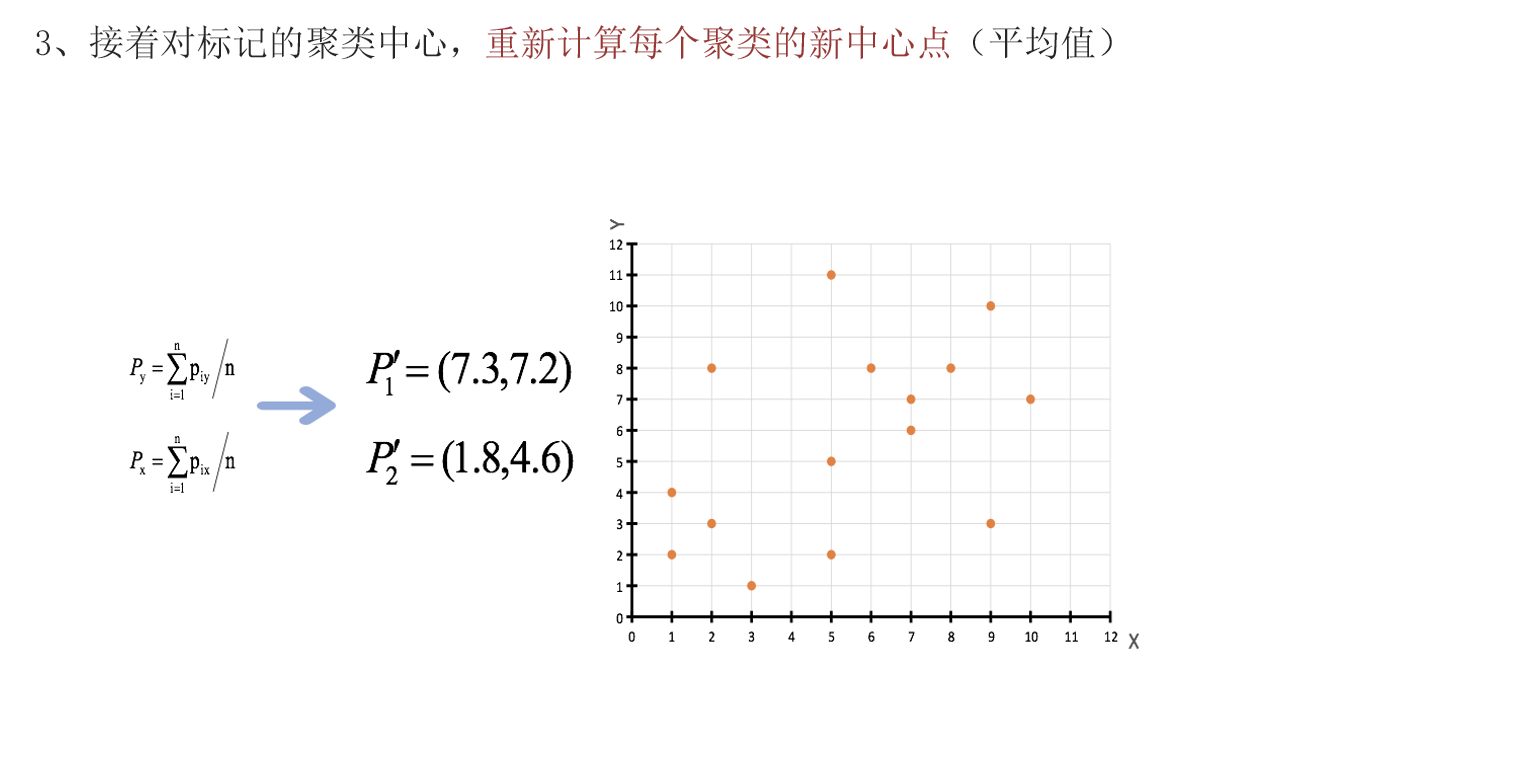
根据当前分配结果,重新计算每个簇的中心(即该簇内所有样本的均值)。
判断是否收敛:
若新中心与旧中心的变化小于设定阈值(如 tol=1e-4),则停止迭代;
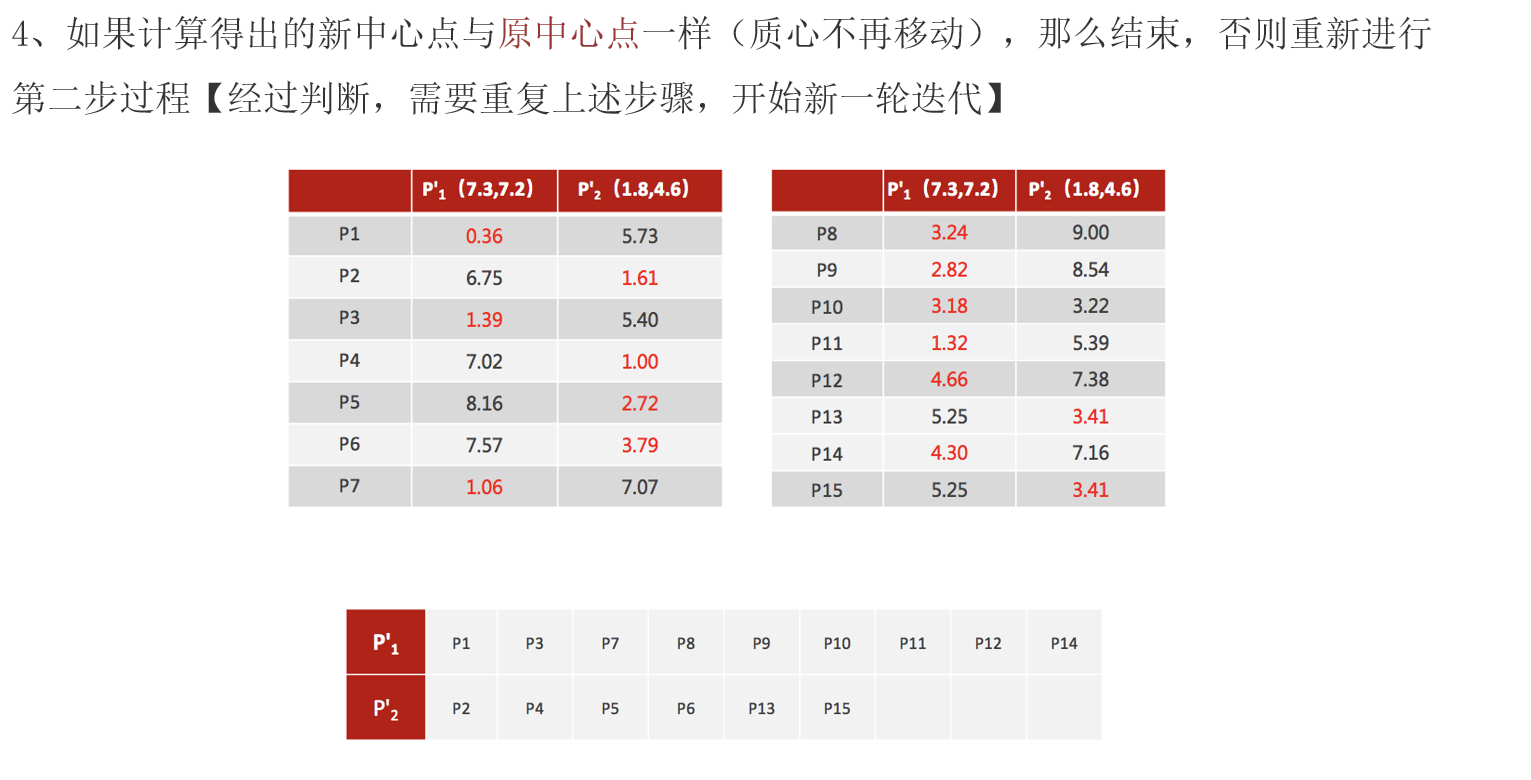
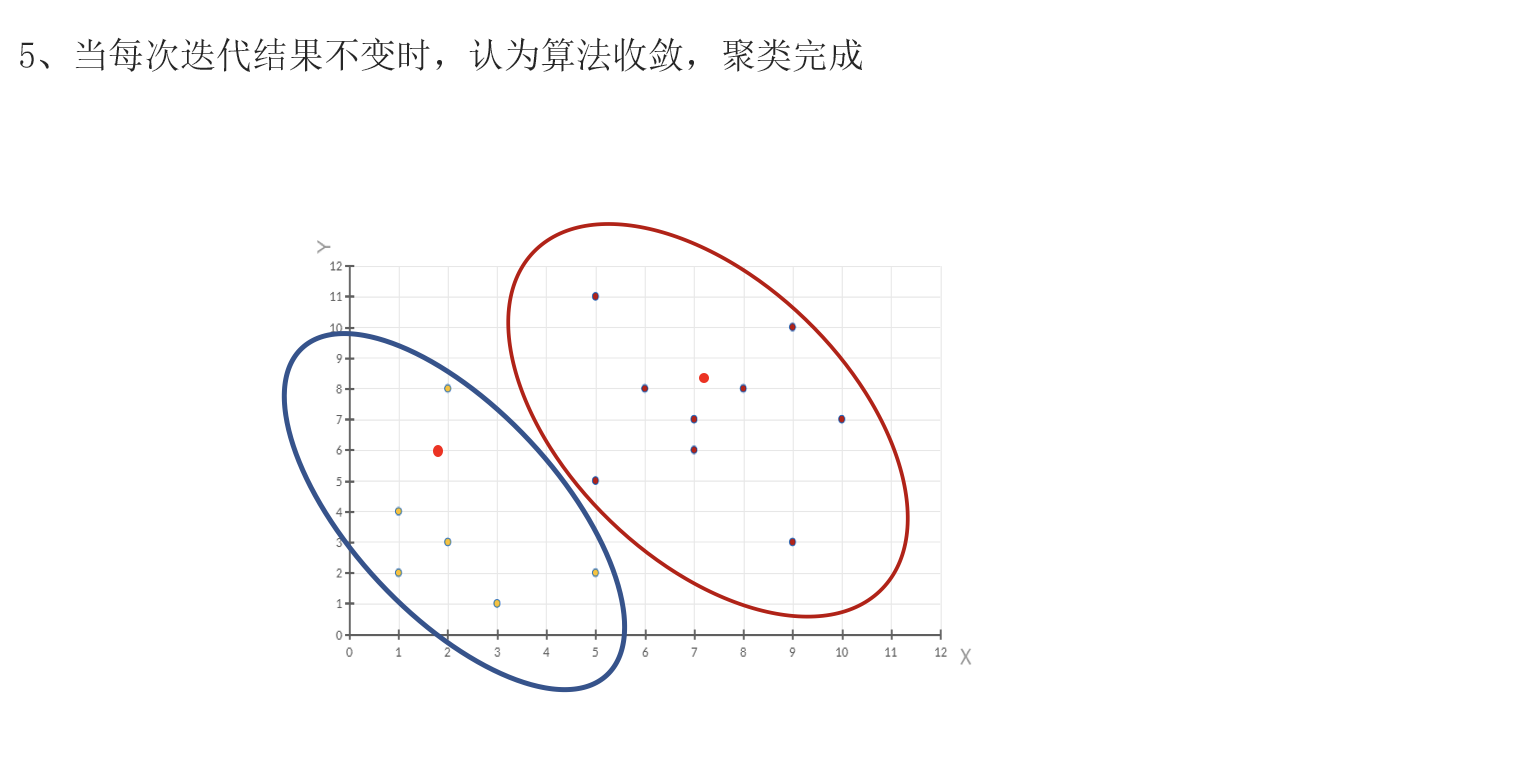
否则返回第 3 步继续迭代,直到中心不再显著变化。
输出结果:
每个样本的聚类标签(labels_)
每个簇的中心坐标(cluster_centers_)
总惯性(inertia_):衡量簇内紧密程度
【示例】