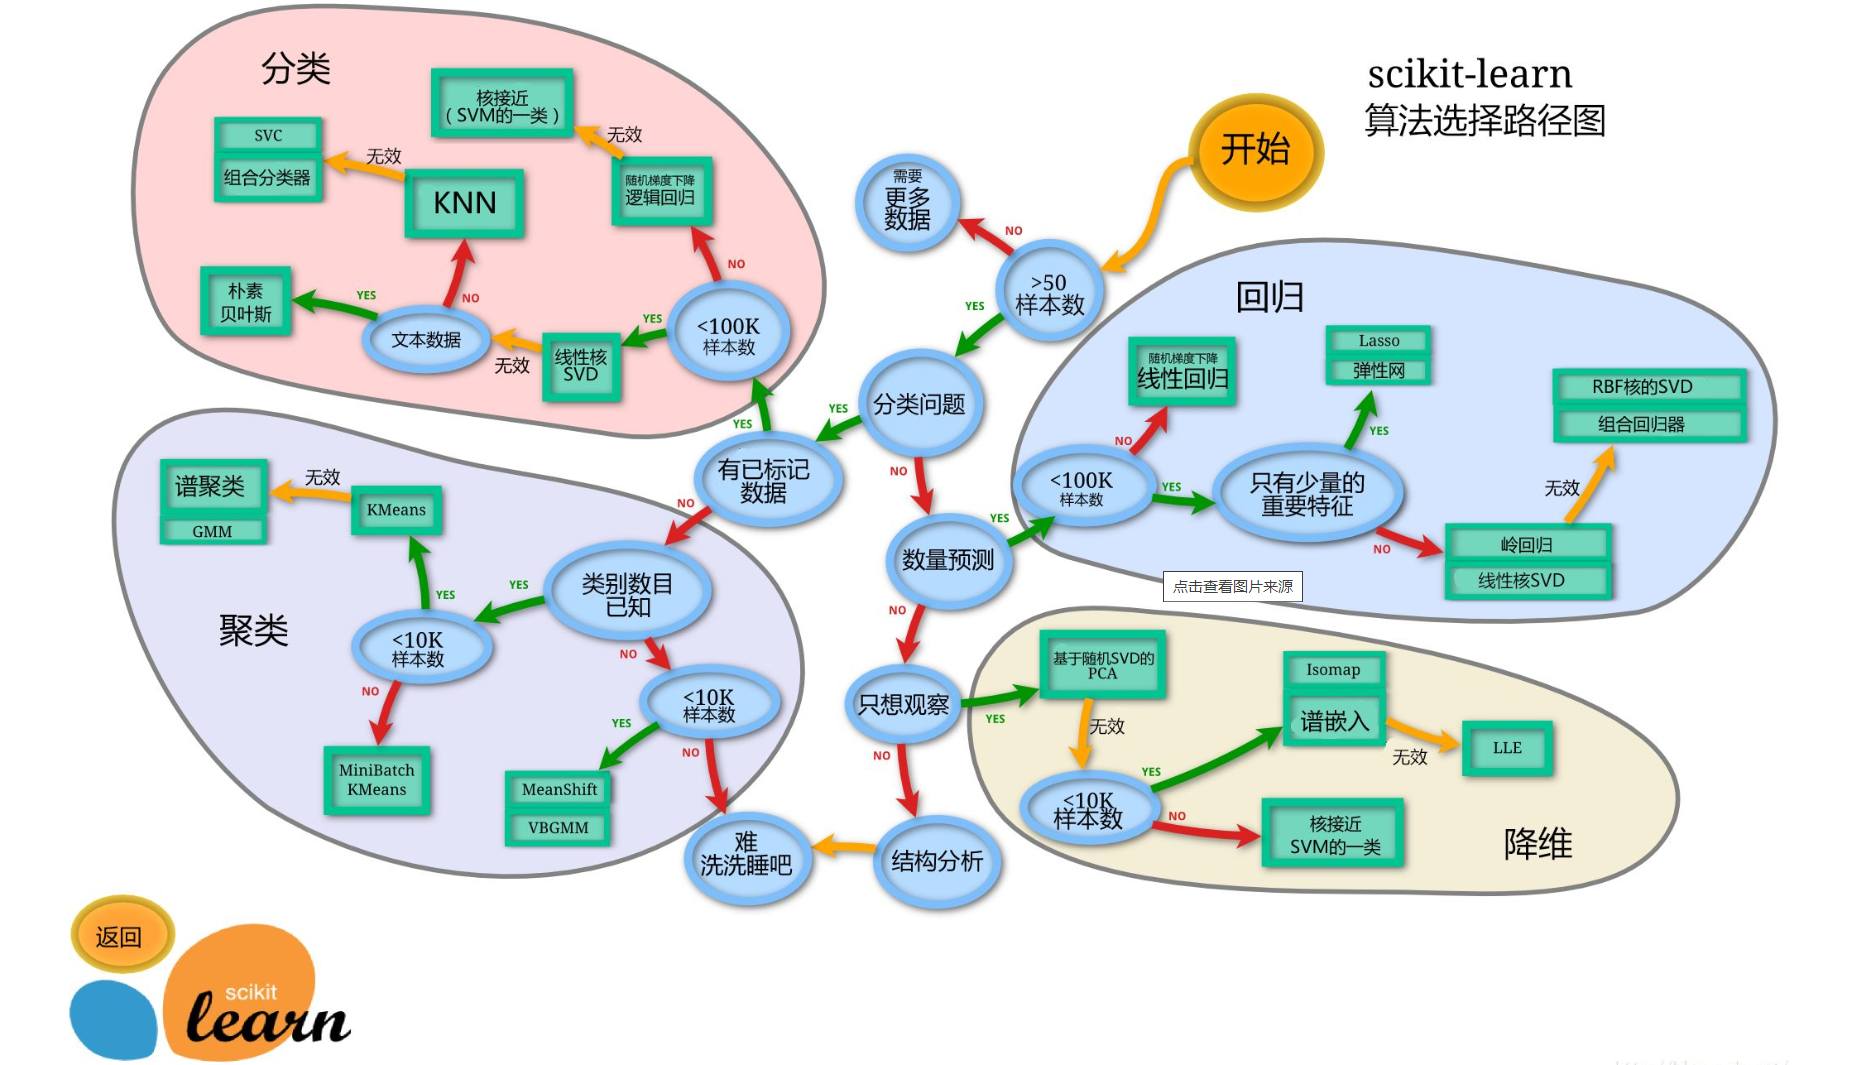
核心概念
人工智能 三大概念
人工智能(AI)、机器学习(ML)、深度学习(DL)
人工智能
什么是人工智能
Artificial Intelligence 人工智能
AI is the field that studies the synthesis and analysis of computational agents that act intelligently
人工智能是研究智能行为的计算代理的合成和分析的领域
AI is to use computers to analog and instead of human brain
人工智能是用计算机来模拟人脑(目标)
AI的期望
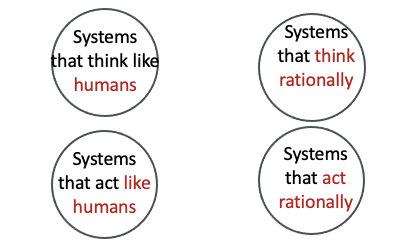
Systems that think like humans
像人一样“思考”的系统
Systems that think rationally
理性“思考”的系统
Systems that act like humans
像人一样“行动”的系统
Systems that act rationally
理性“行动”的系统
总结:AI是用计算机来模拟人脑,让计算机能够像人一样理性的思考、行动
人工智能是让机器在特定任务中表现出类人或超人智能行为的科学与工程。
机器学习
什么是机器学习
Machine Learning 机器学习
Field of study that gives computers the ability to learn without being explicitly programmed
赋予计算机学习能力而不是需要明确编程的领域
即:让机器自动学习,而不是基于规则的编程(不依赖特定规则编程)
机器如何学习
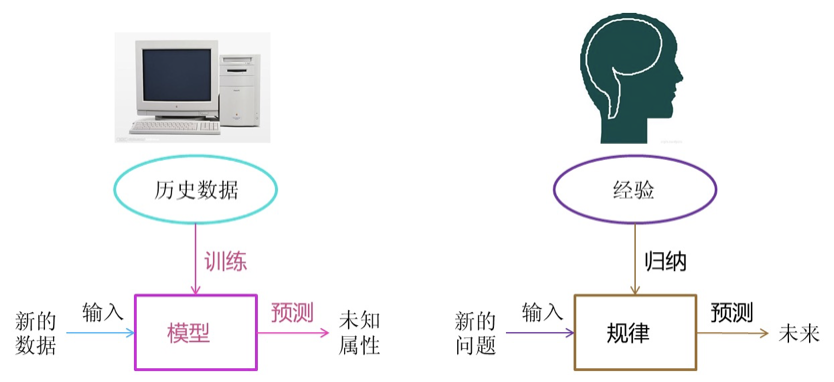
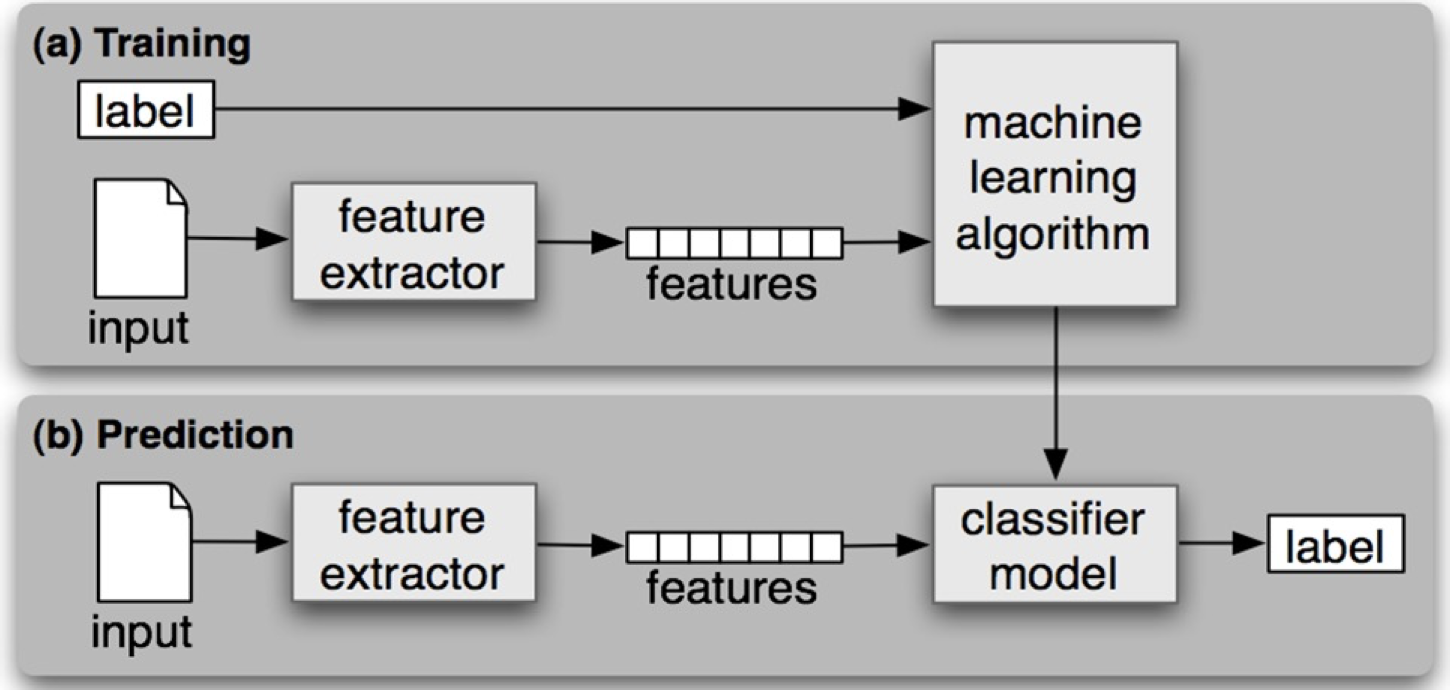
人类识别车:根据车的特征归纳出车的规律;来了一个新的图片,判断预测是否是车
机器学习识别车: 从数据中获取规律;来了一个新的数据,产生一个新的预测
深度学习
深度学习(DL, Deep Learning) 也叫深度神经网络,大脑仿生,设计一层一层的神经元模拟万事万物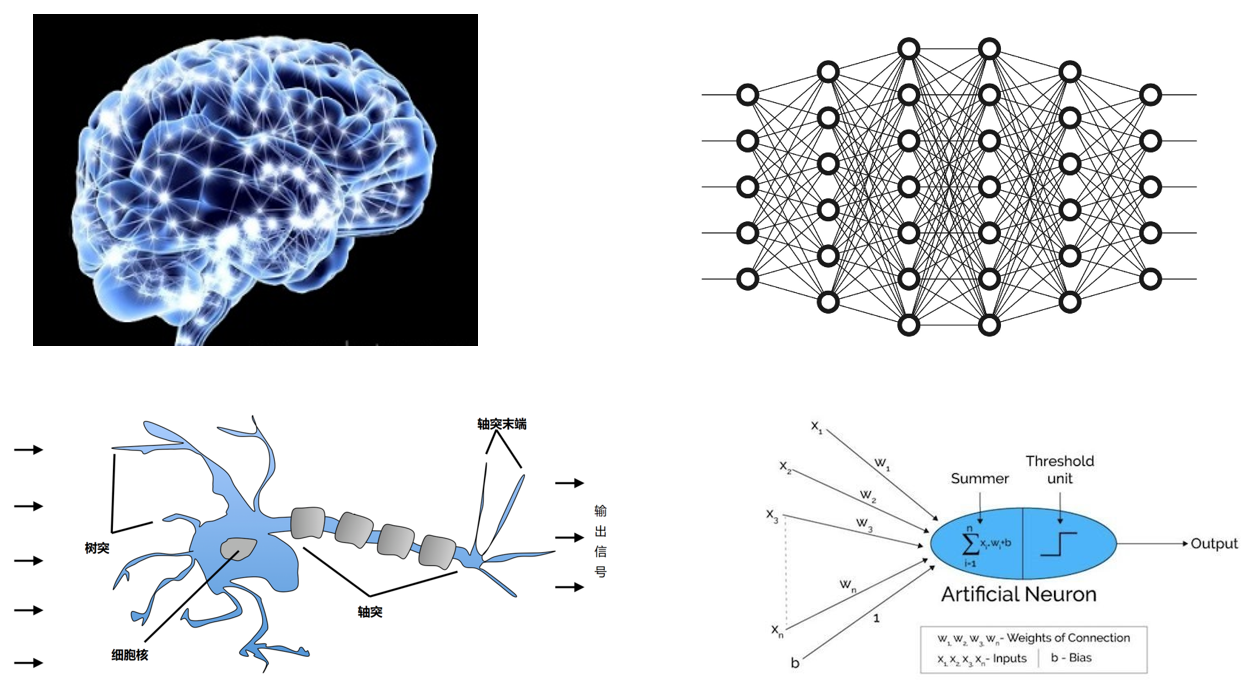
三者之间的关系
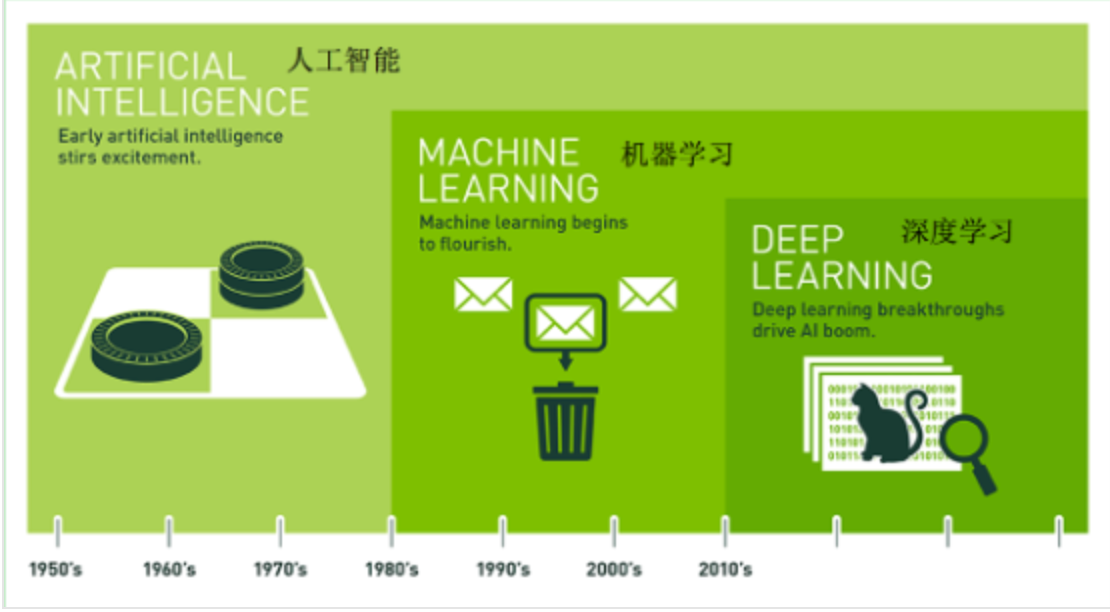
机器学习是实现人工智能的一种途径
深度学习是机器学习的一种方法
现实例子:找西瓜
算法的学习方式
基于规则的学习
基于规则的预测 : 程序员根据经验利用手工的
if-else 方式进行预测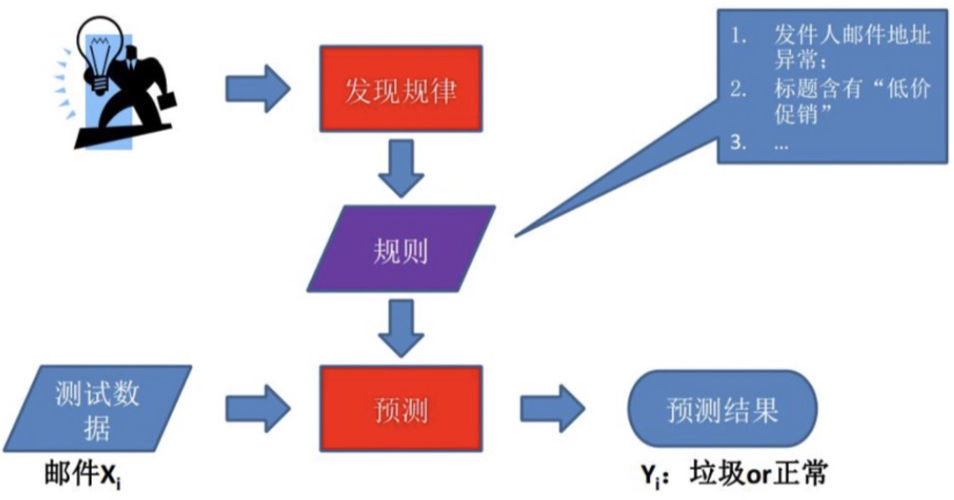
但是有很多问题, 无法明确的写下规则,此时我们无法使用规则学习的方式来解决这一类问题,比如:
图像和语音识别
自然语言处理
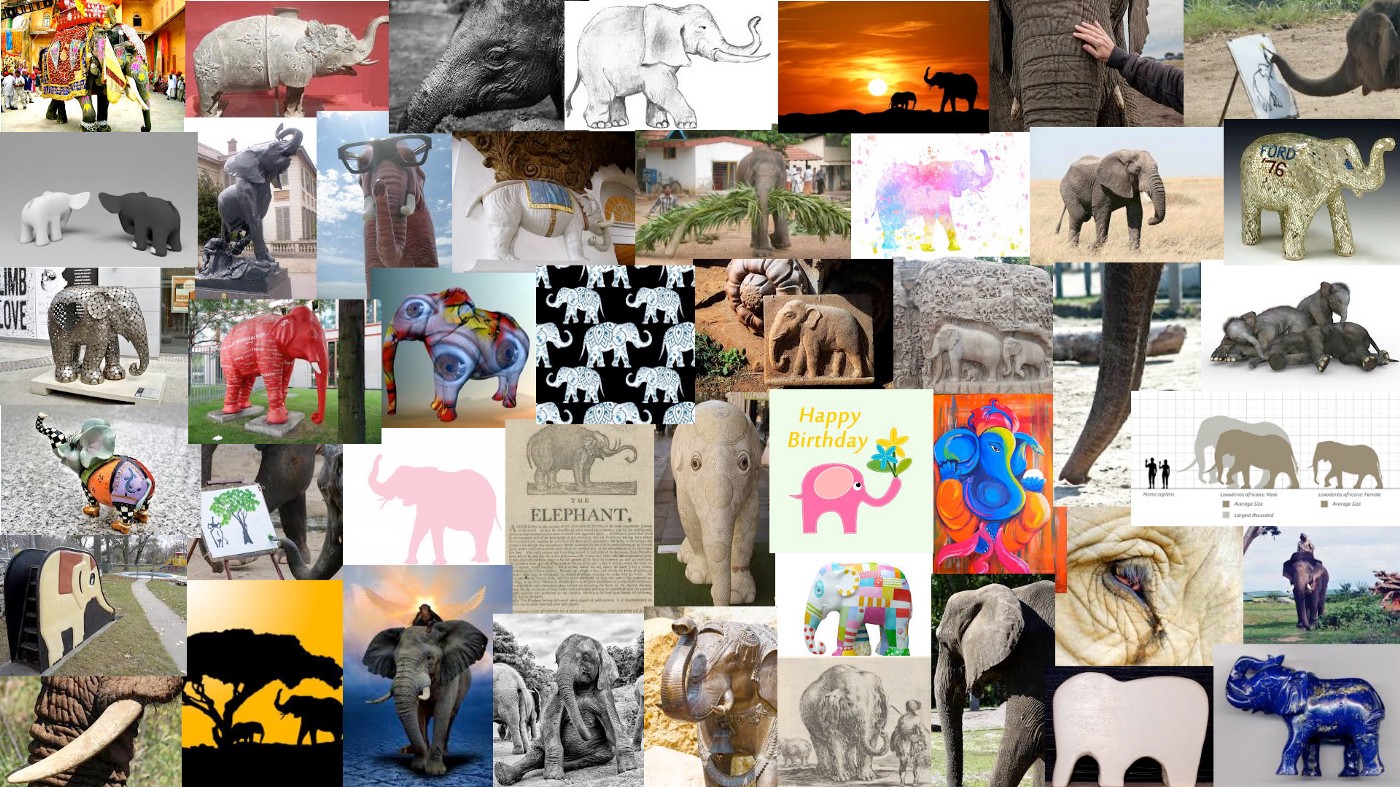
举例:我们尝试通过基于规则的学习方式让计算机识别大象,下图中的大象千差万别, 有的是实物,有的是雕塑,有的是画,我们无法通过创建一套规则的方式让计算机准确识别下面每一头大象, 此时我们需要一种新的方法来解决这类问题。
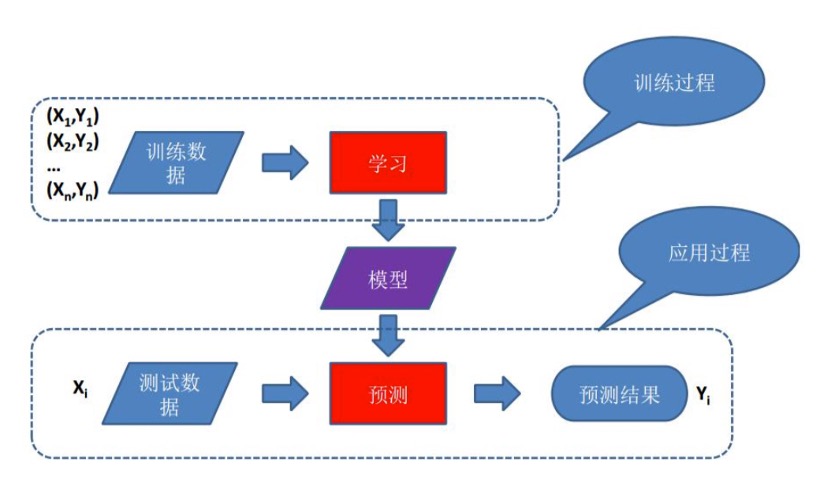
基于模型的学习
基于模型的学习,就是通过编写机器学习算法,让机器自己学习从历史数据中获得经验、训练模型:
案例
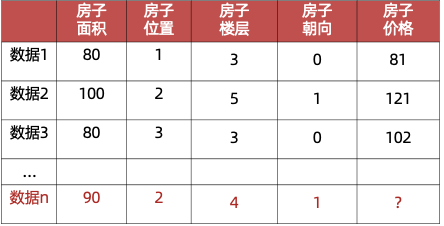
比如房价预测,数据如下图
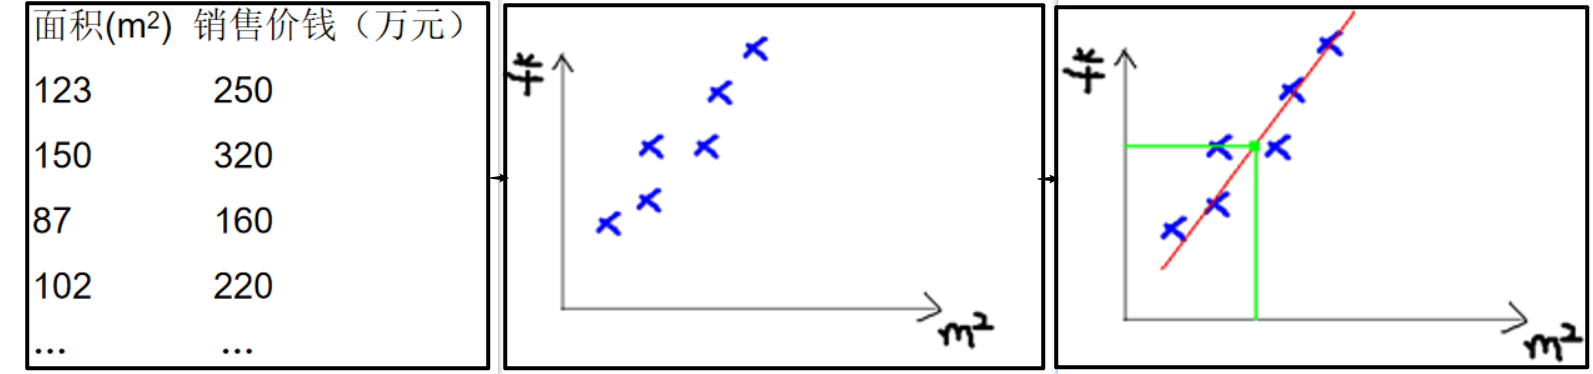
利用线性关系来模拟面积和房价之间的关系
让直线尽可能多的通过这些点,不通过的点尽量分布在直线的两侧,利用这条直线所表示的线性关系,我们就可以预测房价。
直线可以写成 ,若a,b已知,我们就能够预测房价。机器学习中a,b称为 参数 , 称为 模型 。通常a,b未知,是我们需要求解的量(训练模型的参数)。
,其中 :偏置, :权重
*机器学习 应用领域和发展史
应用领域
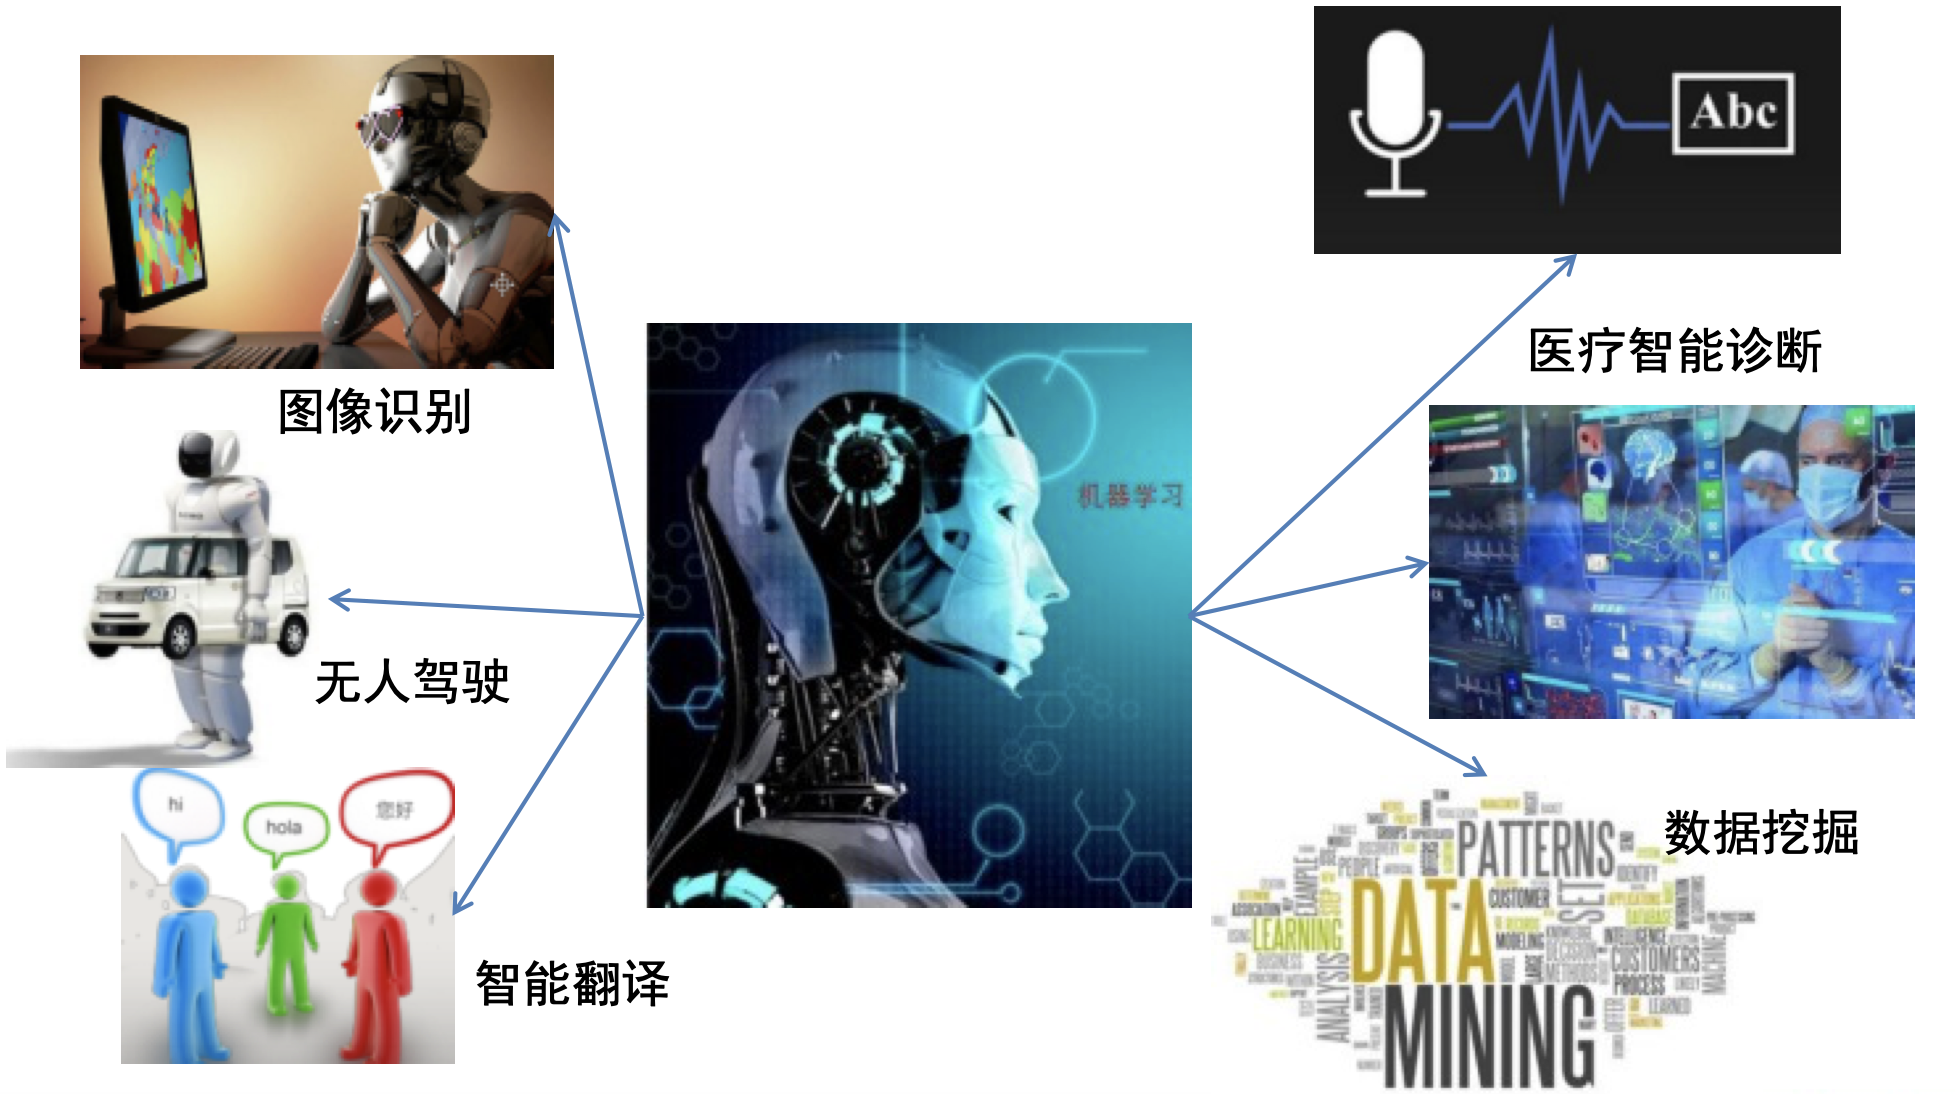
用户分析:社交网络、影评、商品评论
搜素引擎:网页、图片、规频、新闻、学术、地图
信息推荐:新闻、商品、游戏、书籍
图片识别:人像、用品、劢物、交通工具
机器翻译、摘要生成 … …
生物信息学习 … … 多模态 AR/VR
发展史
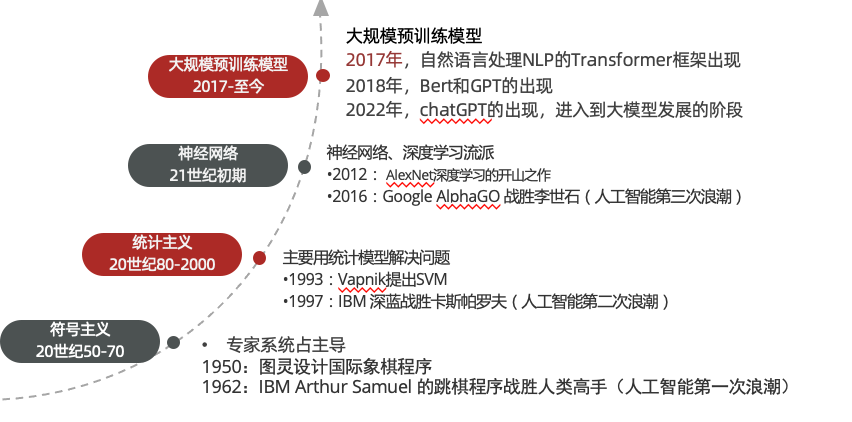
1956年夏季,以约翰·麦卡赛(人工智能之父)、马文·闵斯基(人工智能与认知学专家)、罗切斯特和克劳德·香农(信息论的创始人)等为首的一批有远见卓识的年轻科学家在一起聚会(达特茅斯会议),共同研究和探讨用机器模拟智能的一系列有关问题,并首次提出了“人工智能”这一术语,它标志着“人工智能”这门新兴学科的正式诞生。
1956 年被认为是人工智能元年
1950-1970
符号主义流派:专家系统占主导地位
阿瑟·塞缪尔(Arthur Samuel)被广泛誉为“机器学习之父”。
- 1952 年开发首个自学习跳棋程序;
- 1959 年首次提出“机器学习”术语。
1950:图灵设计国际象棋程序
1962:IBM Arthur Samuel 的跳棋程序战胜人类高手(人工智能第一次浪潮)
1980-2000
统计主义流派:主要用统计模型解决问题
1993:Vapnik提出SVM
1997:IBM 深蓝战胜卡斯帕罗夫(人工智能第二次浪潮)
2010-2017
神经网络、深度学习流派
2012:AlexNet深度学习的开山之作
2016:Google AlphaGO 战胜李世石(人工智能第三次浪潮)
2017-至今
大规模预训练模型
2017年,自然语言处理NLP的Transformer框架出现
2018年,Bert和GPT的出现
2022年,ChatGPT的出现,进入到大规模模型AIGC发展的阶段
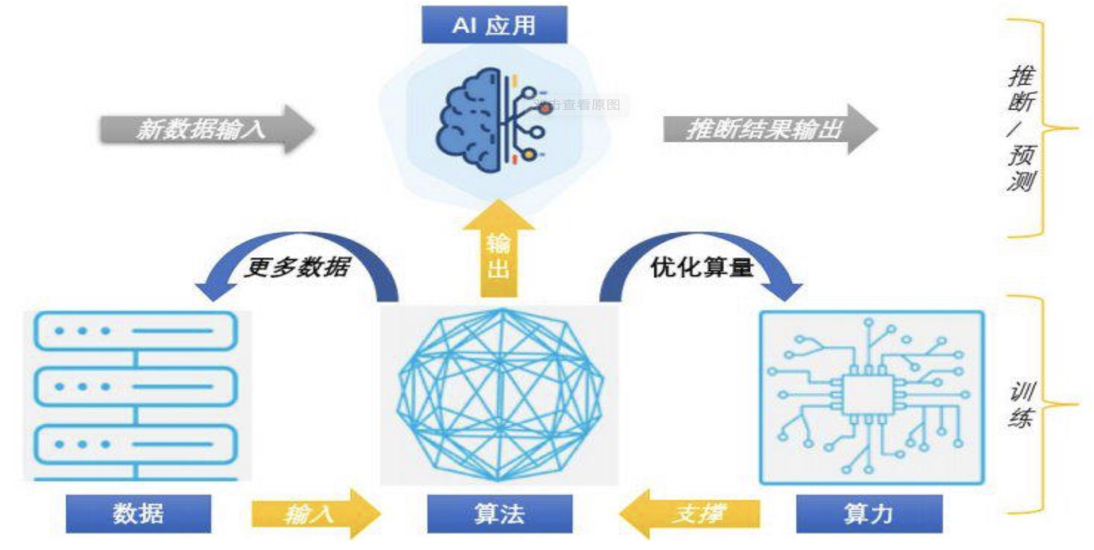
AI 发展三要素
数据、算法、算力三要素相互作用,是AI发展的基石
CPU(中央处理器)
通用性强,擅长处理复杂逻辑、分支判断和串行任务;
是系统调度和通用计算的核心,并非专为 I/O 或大规模并行计算设计。
GPU(图形处理器)
拥有数千个计算核心,擅长大规模并行、规则的计算密集型任务(如矩阵运算、卷积);
是当前深度学习训练的主流硬件。
TPU(张量处理单元)
Google 定制的专用芯片(ASIC),针对神经网络张量运算(尤其是 TensorFlow)优化;
在特定模型上吞吐量和能效优于 GPU,但灵活性较低。
机器学习 常见术语
常见术语
样本,特征,标签/目标值
样本(sample) :一行数据就是一个样本;多个样本组成数据集;
指数据集中的一条独立观测记录,代表一个待分析的对象。
一行数据就是一个样本、多个样本组成数据集
例如,在房价预测中,一套房子的所有信息(面积、位置等)构成一个样本。
特征(feature) :一列数据一个特征,有时也被称为属性
描述样本的可测量属性或输入变量,是模型用于学习和预测的依据。
一列数据一个特征
例如,“房屋面积”“卧室数量”就是房价预测中的特征。特征质量直接影响模型性能。
标签/目标(label/target) :模型要预测的那一列数据。
样本的预期输出或真实答案,是监督学习中模型要预测的目标。
模型要预测的那一列数据
例如,房价预测中的“实际售价”就是标签。无监督学习中则没有标签。
特征如何理解(重点):特征是从数据中抽取出来的,对结果预测有用的信息 eg:房价预测、车图片识别
数据集划分
数据集可划分两部分:训练集、测试集,划分比例:8 : 2,7 : 3
训练集(training set) :用来训练模型(model)的数据集
测试集(testing set):用来测试模型的数据集
验证集(Validation):用于调参和模型选择;(非必须)
7:1.5:1.5 或 8:1:1 划分数据
命名惯例:
-
x_train 训练集中的特征x(输入)
-
y_train 训练集中的标签y(目标)
-
x_test 测试集中的特征x(输入)
-
y_test 测试集中的标签y(目标)
机器学习 算法分类
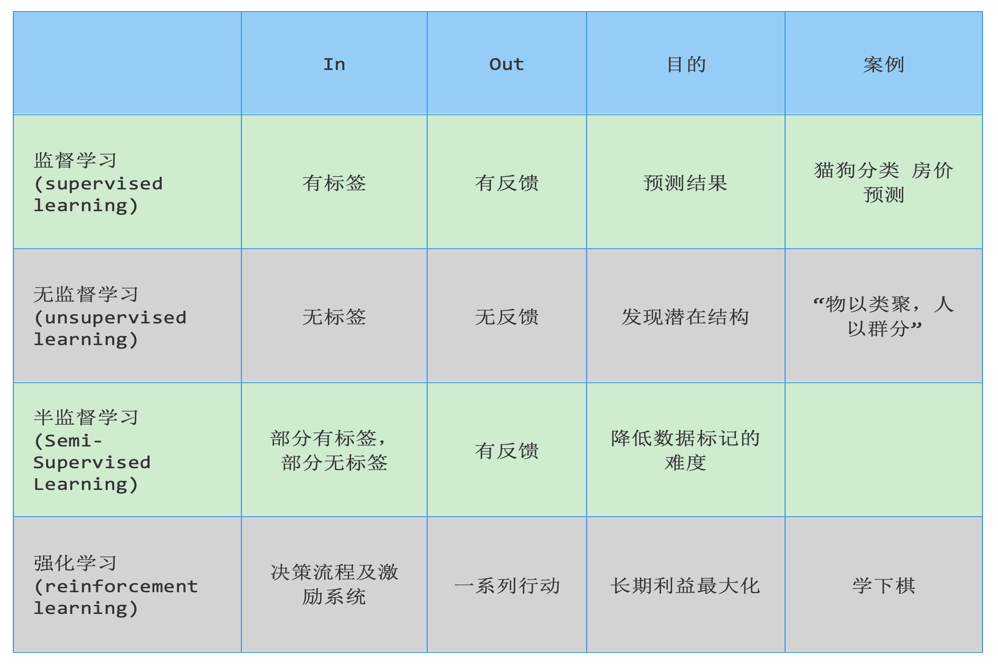
有监督学习
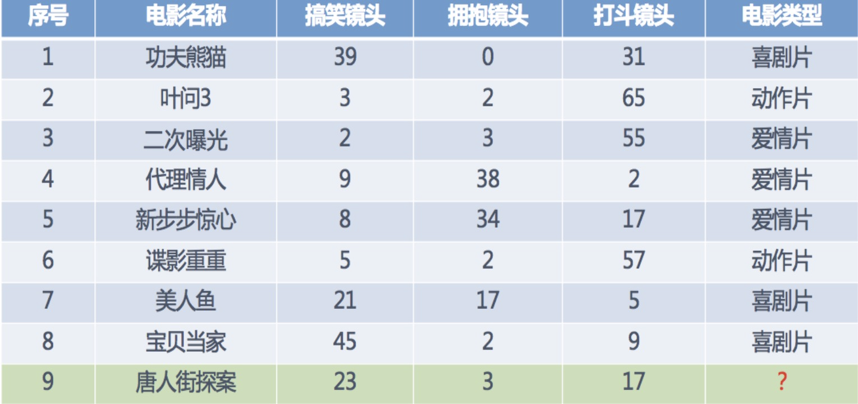
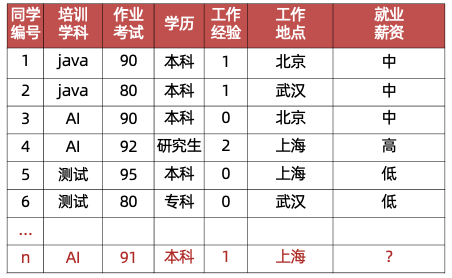
定义:输入数据是由输入特征值和目标值所组成,即输入的训练数据有标签的
数据集:需要人工标注数据
分类问题(classification)
目标值(标签值)是不连续的
分类种类:二分类、多分类任务
回归问题(Regression)
- 目标值(标签值)是连续的
无监督学习
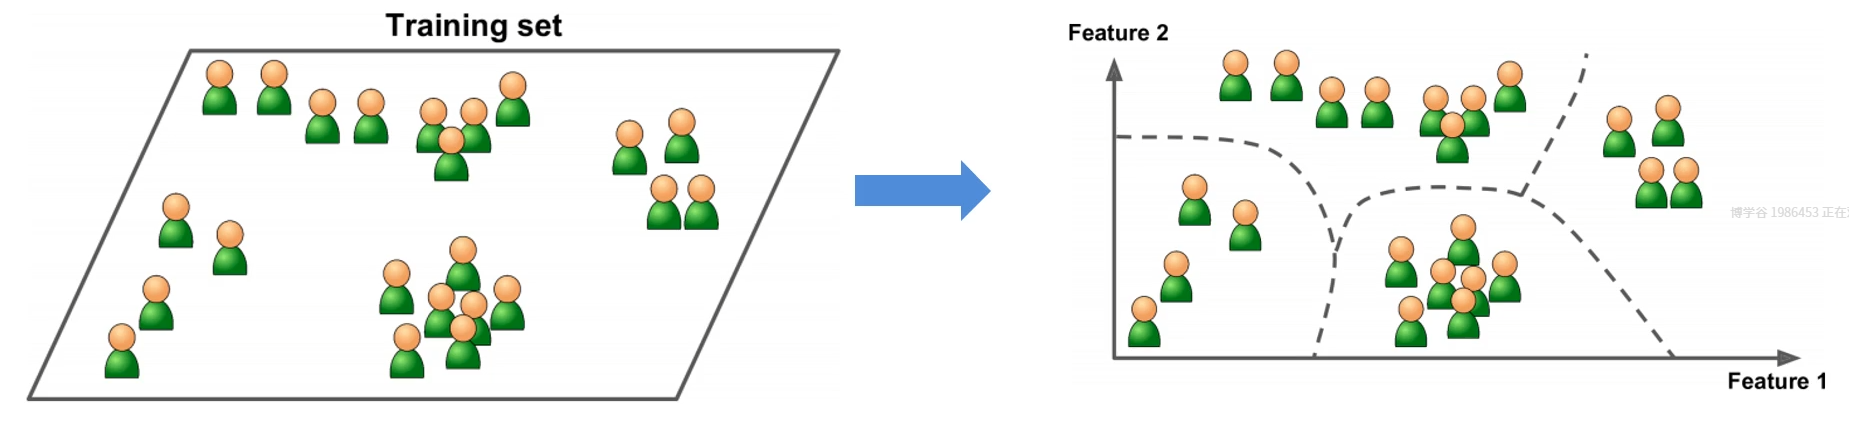
定义:输入数据没有被标记,即样本数据类别未知,没有标签,根据样本间的相似性,对样本集聚类,以发现事物内部 结构及相互关系。
数据集:不需要标注数据
特点:
训练数据有特征无标签(无目标值)
根据样本间的相似性对样本集进行聚类,发现事物内部结构及相互关系
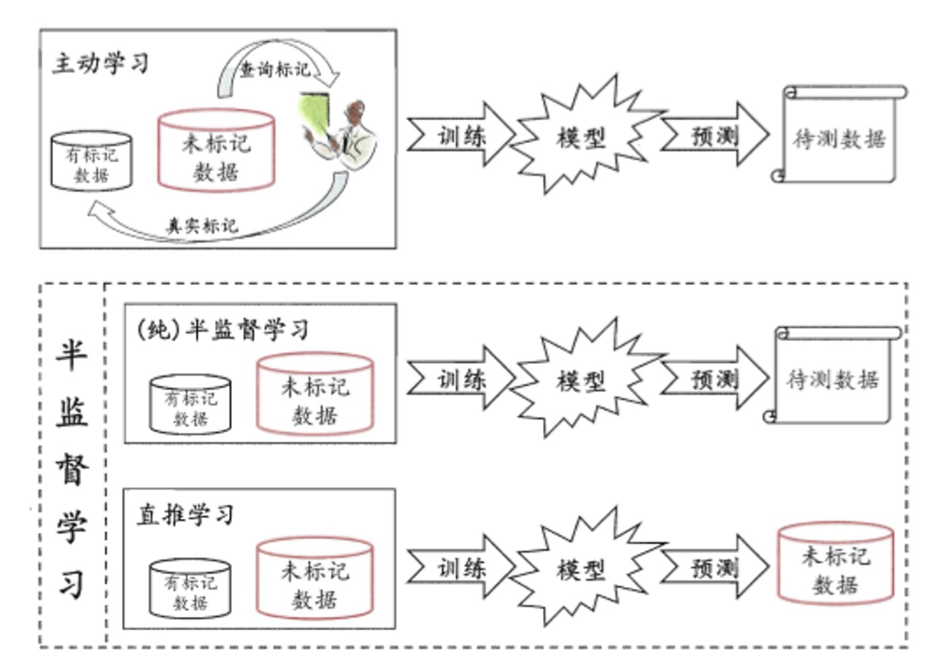
半监督学习
工作原理:
让专家标注少量数据,利用已经标记的数据(也就是带有类标签)训练出一个模型
再利用该模型去套用未标记的数据
通过询问领域专家分类结果与模型分类结果做对比,从而对模型做进一步改善和提高
特点:训练数据部分有标签
优点:半监督学习方式可大幅降低标记成本
强化学习
强化学习(Reinforcement Learning):机器学习的一个重要分支
应用场景:里程碑AlphaGo围棋、各类游戏、对抗比赛、无人驾驶场景
基本原理:构建四个要素
Agent, Environment, Action, Reward角色(Agent)
环境状态(State / Environment)
行动(Action)
奖励(Reward)
agent根据环境状态进行行动获得最多的累计奖励
目标:寻找最短路径(最优解),以便获取最多的奖励
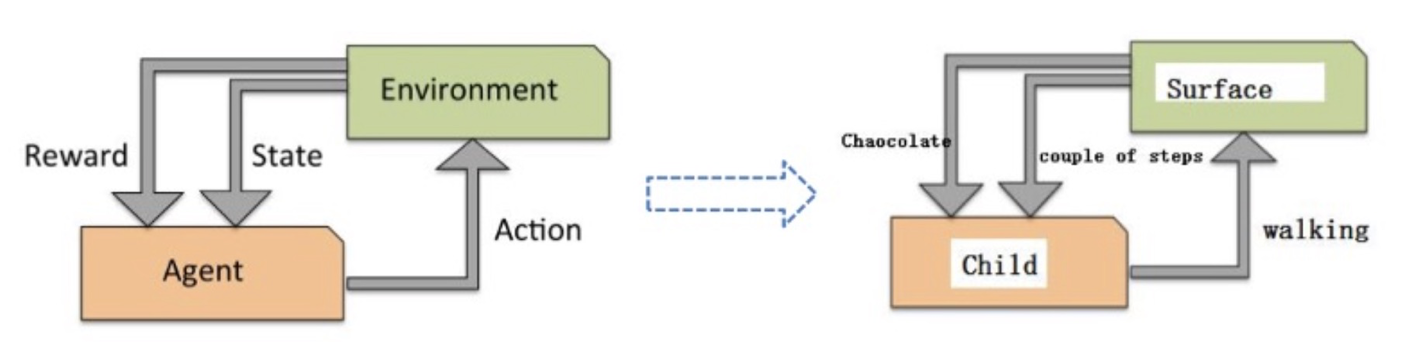
例子:小孩子学走路
(1) 小孩就是 <span data-type="text" style="background-color: var(--b3-card-success-background); color: var(--b3-card-success-color);">agent</span>,他试图通过采取<span data-type="text" style="background-color: var(--b3-card-success-background); color: var(--b3-card-success-color);">行</span>(即行走)来操纵<span data-type="text" style="background-color: var(--b3-card-success-background); color: var(--b3-card-success-color);">环境</span>(地面),


(2) 并且<span data-type="text" style="background-color: var(--b3-card-success-background); color: var(--b3-card-success-color);">从一个状态转变到另一个状态</span>(即他走的每一步),


(3) 当他完成任务的子任务(即走了几步)时,孩子得到<span data-type="text" style="background-color: var(--b3-card-success-background); color: var(--b3-card-success-color);">奖励</span>(给巧克力吃),


(4) 并且当他不能走路时,就不会给巧克力。
【小结】
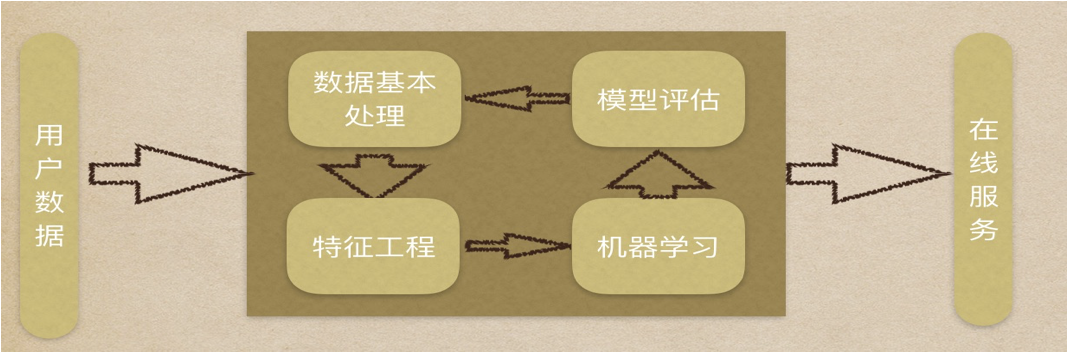
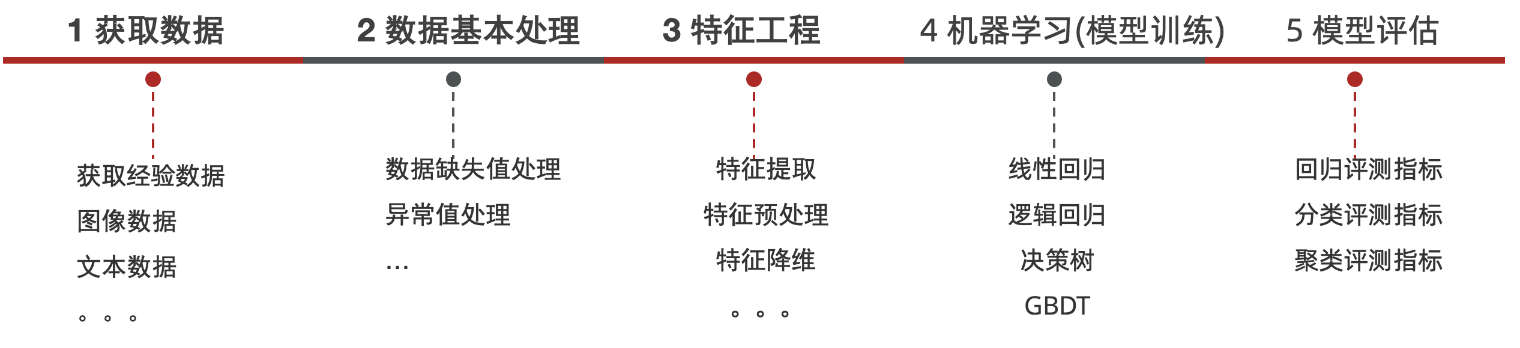
机器学习 建模流程
模型拟合问题
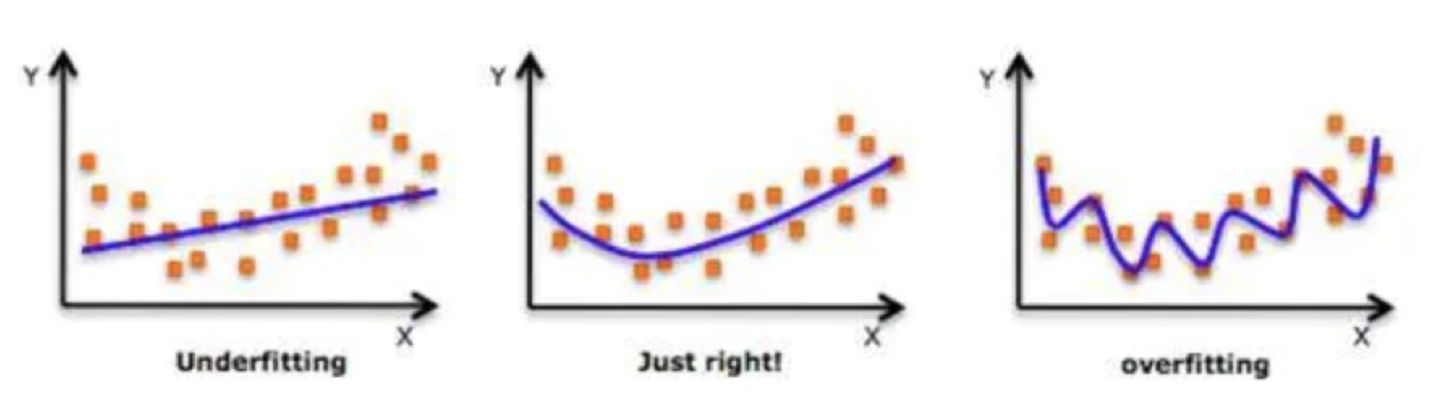
拟合(fitting):模型在训练集和测试集上 的表现情况,用来表示模型对样本分布点的模拟情况
欠拟合(under-fitting):模型在训练集、测试集表现都不好
过拟合(over-fitting):模型在训练集表现好、在测试集表现不好
泛化(Generalization):模型在其它新数据集(非训练数据)上的表现好坏的能力
奥卡姆剃刀原则:给定两个具有相同泛化误差的模型,较简单的模型比较复杂的模型更可取
过拟合和欠拟合
【示例】欠拟合&过拟合
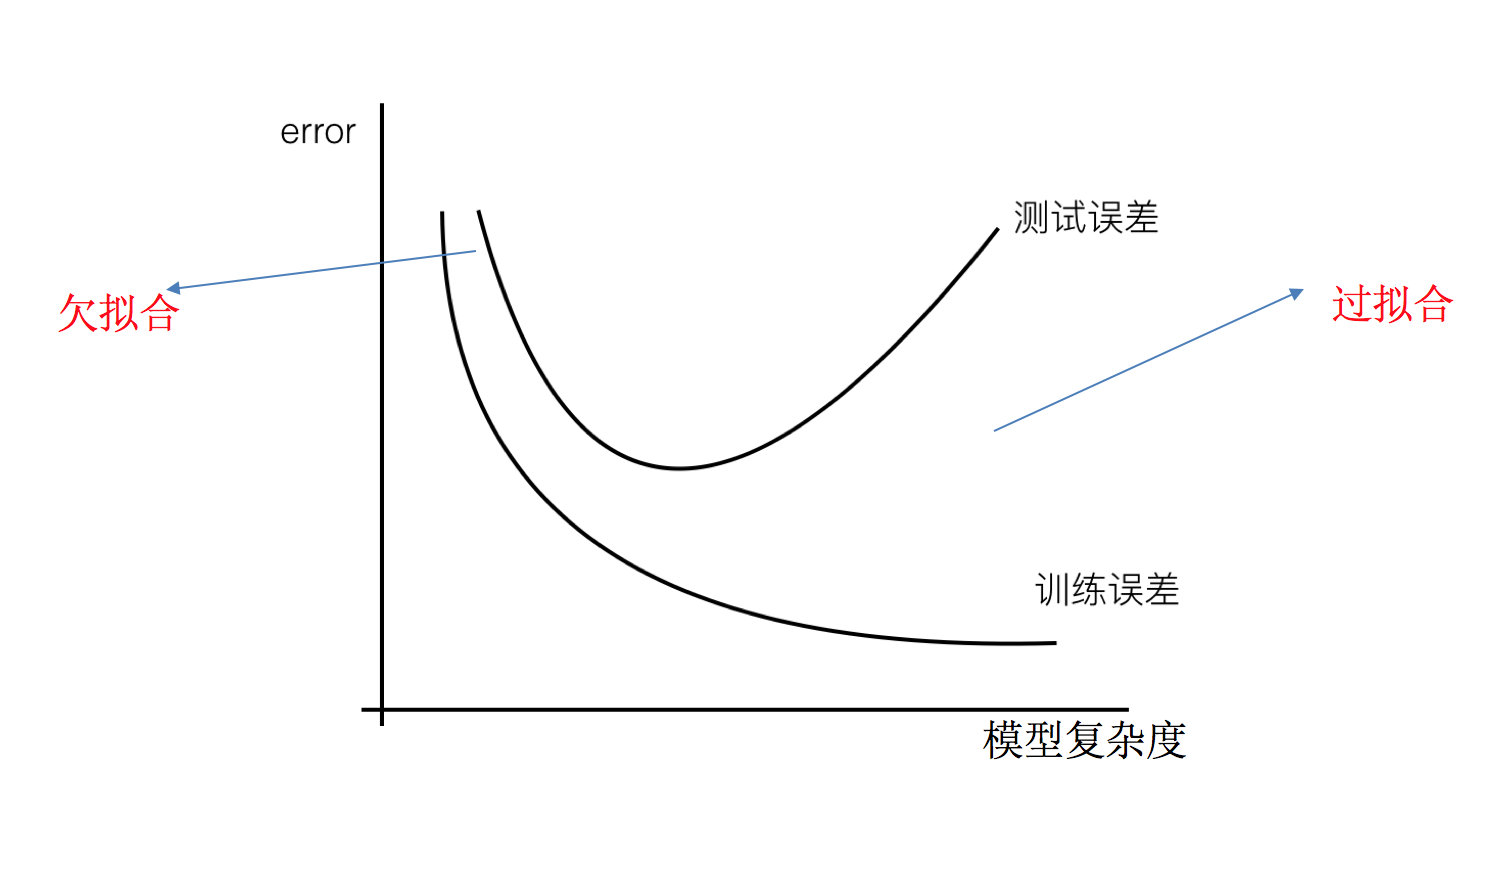
欠拟合(under-fitting):模型在训练集、测试集表现都不好
原因:模型过于简单
解决办法:
添加其他特征项
添加多项式特征
过拟合(over-fitting):模型在训练集表现好、在测试集表现不好
原因:
模型太过于复杂、数据不纯
原始特征过多,存在一些嘈杂特征,模型尝试去兼顾各个测试数据点
解决办法:
重新清洗数据:对于过多异常点数据、数据不纯的地方再处理
增大数据的训练量:对原来的说训练
正则化
减少特征维度,防止胃灾难:由于特征多,样本数量少,导致学习不充分,泛化能力差。
正则化
异常点数据会造成权重系数过大、过小。尽量减少这些特征的影响(甚至删除某个特征的影响)
目的:为了减少过拟合的影响,控制模型的参数。尤其是高次项的权重参数
L1 正则化(Lasso 回归)
在损失函数中,添加 L1正则化项:
惩罚系数,该值越大则权重调整的幅度就越大,即:表示对特征权重惩罚力度就越大
L1 正则化会使权重趋向于 ,甚至等于 ,使得某些特征失效,达到特征筛选的目的
L2 正则化(岭回归,Ridge Regression)
在损失函数中,添加 L2正则化项:
惩罚系数,该值越大则权重调整的幅度就越大,即:表示对特征权重惩罚力度就越大
L2 正则化会使权重趋向于 ,一般不等于
# L1正则化


from sklearn.linear_model import Lasso


# Lasso:在线性回归损失函数上添加 L1 正则项(|w|_1),可实现特征选择(稀疏解)


model_lasso = Lasso(


    alpha=1.0,                # 正则化强度(λ)。值越大,系数越趋近于 0;alpha=0 等价于普通线性回归(但不推荐,应使用 LinearRegression)


    fit_intercept=True,       # 是否计算截距项(b)


    precompute=False,         # 是否预先计算 Gram 矩阵以加速(仅当 n_features > n_samples 时可能有用)


    copy_X=True,              # 是否复制输入数据 X(避免原始数据被修改)


    max_iter=1000,            # 最大迭代次数(Lasso 使用坐标下降法,需迭代求解)


    tol=1e-4,                 # 收敛容忍度(若参数更新小于 tol,则停止迭代)


    warm_start=False,         # 是否使用前一次训练结果作为初始化(用于多次调参)


    positive=False,           # 是否强制所有系数为非负(仅适用于某些物理意义场景)


    random_state=None,        # 随机种子(Lasso 本身无随机性,此参数仅在 solver='sag' 或 'saga' 时生效,但默认 solver 不是它们)


    selection='cyclic'        # 特征更新顺序:'cyclic'(循环)或 'random'(随机);'random' 有时收敛更快


)


# L2正则化


from sklearn.linear_model import Ridge


# Ridge:在线性回归损失函数上添加 L2 正则项(||w||²_2),防止过拟合,但不会产生稀疏解


model_ridge = Ridge(


    alpha=1.0,                # 正则化强度(λ)。值越大,系数越小(但不为 0);alpha=0 等价于普通线性回归


    fit_intercept=True,       # 是否计算截距项(b)


    copy_X=True,              # 是否复制输入数据 X


    max_iter=None,            # 最大迭代次数(None 表示使用解析解,无需迭代;仅当 solver='sparse_cg'、'lsqr' 等时才用迭代)


    tol=1e-3,                 # 收敛容忍度(仅在使用迭代求解器时生效)


    solver='auto',            # 求解器选择:


                              #   'auto':根据数据自动选择(默认)


                              #   'svd':使用 SVD 分解(稳定,适合小数据)


                              #   'cholesky':使用 Cholesky 分解(默认用于 dense 数据)


                              #   'sparse_cg'、'lsqr'、'sag'、'saga':适用于大规模或稀疏数据


    positive=False,           # 是否强制系数为非负(实验性功能)


    random_state=None         # 随机种子(仅在 solver='sag' 或 'saga' 时生效)


)
机器学习开发
基于Python的 scikit-learn 库:
简单高效的数据挖掘和数据分析工具
可供大家使用,可在各种环境中重复使用
建立在NumPy,SciPy和matplotlib上
开源,可商业使用-获取BSD许可证