激活函数 (Activation Functions)
1. SwiGLU
基于 GLU 改进,结合 Swish 激活函数,提升非线性表达能力。
- 基础组件: ,其中 为 Sigmoid 函数。
- 完整公式:
2. GELU (Gaussian Error Linear Unit)
引入高斯分布特性的平滑激活函数,负值区域表现优于 ReLU。
- 公式: 其中 为标准正态分布的累积分布函数。
3. GeGLU
将 SwiGLU 中的 Swish 替换为 GELU,兼顾平滑性与门控机制。
- 公式:
归一化技术 (Normalization)
1. 标准 LayerNorm
在特征维度上对单个样本进行归一化,引入可学习参数 。
- 公式: 其中 , 。
2. RMSNorm (Root Mean Square Normalization)
省略均值计算,仅使用均方根归一化,计算更高效且能更好保留信号。
- 公式:
3. DeepNorm
专为极深 Transformer 设计,通过缩放残差连接防止梯度爆炸/消失。
- 标准残差:
- DeepNorm 残差: 其中 为经验缩放因子。
位置编码:RoPE (Rotary Positional Embedding)
通过旋转矩阵将绝对位置信息注入 Query 和 Key 向量,使 Self-Attention 的内积结果仅依赖于相对位置。
- 核心思想:对 和 按位置 应用旋转变换 :
- 优势:具备优异的长度外推能力,是目前主流大模型的位置编码方案。
主流大模型与注意力机制对比
| 模型 | 核心升级特性 |
|---|---|
| Llama 3 | 词表扩至 128K;全面采用 GQA;预训练数据 >15T tokens;支持 30+ 非英语语言;利用 Llama 2 生成高质量合成数据。 |
| GLM-4 | 9B 参数效果超越 Llama3-8B;支持 1M 上下文;26 种语言;多模态与工具调用能力突出。 |
| Qwen2 | 全系采用 GQA;开源性能强劲,体验接近 GPT-4o。 |
🔍 注意力机制演进
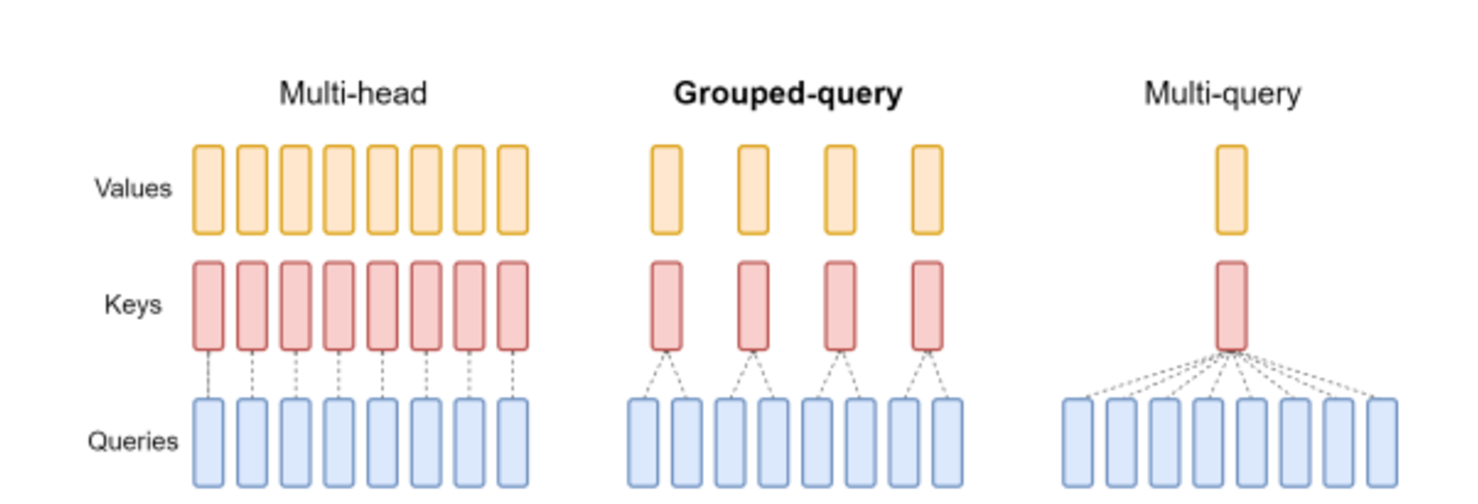
- MHA (Multi-Head Attention):每个 Head 独立拥有 参数,效果最好但显存占用高。
- MQA (Multi-Query Attention):所有 Head 共享同一组 ,参数最少,速度最快但精度略降。
- GQA (Grouped-Query Attention):折中方案。将 Query 分组,组内共享 参数。兼顾推理速度与模型效果。
推理加速与缓存机制
1. KV Cache

- 作用:在自回归生成中,复用已计算过的历史 Token 的 Key/Value 状态,避免重复计算 Scaled Dot-Product Attention。
- 性能对比:使用 KV Cache 可大幅降低生成延迟(如 T4 GPU 生成 1000 tokens 从 56s 降至 11s)。
2. vLLM 与 PageAttention
- vLLM:高效推理框架,通过
use_cache=True默认启用 KV Cache。 - PageAttention:将 KV Cache 划分为固定大小的物理块(Block),支持非连续内存分配,解决显存碎片化问题,提升吞吐率。
使用vLLM框架进行Qwen2.5-7B模型推理:
python
from transformers import AutoTokenizer
from vllm import LLM, SamplingParams

# 初始化分词器
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-7B-Instruct")

# 定义采样参数
sampling_params = SamplingParams(
    temperature=0.7,         # 控制生成文本的多样性
    top_p=0.8,              # 核心采样概率控制生成时考虑的词汇范围
    repetition_penalty=1.05, # 重复惩罚,防止重复内容生成
    max_tokens=512          # 最大生成长度
)

# 初始化LLM模型
llm = LLM(model="Qwen/Qwen2.5-7B-Instruct")

# 准备输入提示
prompt = "Tell me something about large language models."

# 进行推理
outputs = llm.generate([prompt], sampling_params)

# 打印输出结果
for output in outputs:
    generated_text = output.outputs.text
    print(f"Generated text: {generated_text!r}")
3. FlashAttention
- 目标:优化 Attention 的显存访问(IO)瓶颈,避免将中间矩阵 写入 HBM。
- 核心技术:
- Softmax Tiling:分块计算并局部归一化。
- Recomputation:前向传播仅保存归一化因子,反向传播时在芯片上快速重算 Attention 矩阵,大幅减少 HBM 读写。
4. 首字延迟 vs 单字延迟
- TTFT (Time To First Token):处理完整上下文+预填充,通常 100~几百 ms。
- TPOT (Time Per Output Token):依赖 KV Cache 自回归生成,通常 10~50 ms。
- 比值:
模型调用接口区别
| 方法 | 特点 | 适用场景 |
|---|---|---|
model.generate() | 原生方法,支持 max_length, num_beams, top_p 等精细参数控制。 | 批量文本生成、评测任务 |
model.chat() | 高级封装,内置对话历史管理,一次性返回完整回复。 | 常规问答、非实时交互 |
model.stream_chat() | 流式生成,逐 Token/段返回。 | 聊天机器人、提升用户实时体验 |
| 示例: |
python
# 模型加载
from transformers import AutoTokenizer, AutoModelForCausalLM
device = "cuda:0"
model_path = "./model/chatglm-6b"
tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(model_path, trust_remote_code=True, device_map=device)
python
# model.generate()
text = 'What is machine learning?'
inputs = tokenizer(text, return_tensors="pt").to(device)
outputs = model.generate(**inputs, max_new_tokens=50)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
python
# model.chat()
response, history = model.chat(tokenizer, "你好!你能帮我做些什么?", history=[])
print(response)
python
# model.stream_chat()
for part in model.stream_chat(tokenizer,"你好!你能帮我做些什么?", history=[]):
    print(part)
向量数据库 Milvus 核心操作
1. 架构映射
| Milvus 概念 | 关系型数据库对应 | 说明 |
|---|---|---|
| Collection | Table | 数据集合,共享维度与度量方式 |
| Field | Column | 字段 Schema(主键、向量、标量) |
| Partition | Partition | 逻辑分区,支持定向搜索 |
2. 索引类型与度量
- FLAT:暴力搜索,精度高但慢,适合小规模数据。
- IVF_FLAT:聚类+倒排索引。通过
nprobe平衡精度与速度。 - IVF_SQ8:在 IVF 基础上加入标量量化(4字节→1字节),节省内存。
- IVF_PQ:乘积量化,大幅压缩存储,适合超大规模高维向量。
- HNSW:基于图的索引,搜索效率极高。
- 度量方式:欧氏距离
L2、内积IP、余弦相似度COSINE。
3. 数据操作 (CRUD)
python
# 插入
client.insert(collection_name="demo", data=[{"id": 1, "vector": [...], "color": "red"}])
# Upsert(存在则更新,不存在则插入)
client.upsert(collection_name="demo", data=[...])
# 删除(支持 ID 或过滤器)
client.delete(collection_name="demo", filter="id in [1, 2]")
4. 检索操作
- 基础检索:
client.search(data=[query_vec], limit=5, metric_type="IP") - 过滤检索:
filter='color like "red%"' - 范围检索:通过
search_params设置radius(外边界)和range_filter(内边界)。 - 混合检索 (Hybrid Search):多向量字段联合查询 + 重排序策略(如
WeightedRanker加权融合)。
检索与重排序技术
1. BM25 算法
基于词频与文档长度的概率检索模型,TF-IDF 的改进版。
- 公式: 其中 控制词频饱和, 控制长度惩罚。
2. Rerank (重排序)
使用交叉编码器(如 BAAI/bge-reranker-large)对候选段落与 Query 进行深度语义交互打分,分数越高相关性越强。
3. 混合检索流程
- 稀疏检索:BM25 基于关键词召回候选集。
- 稠密检索:Embedding 模型(如 BGE-M3)基于语义向量召回候选集。
- 融合重排:合并去重后,送入 Rerank 模型精排,输出 Top-K 结果。
RAG 评估与 Embedding 微调
1. RAGAS 评估指标
| 指标 | 含义 |
|---|---|
| Context Precision | 检索上下文中有效信息的占比(精准度) |
| Context Recall | 是否召回了回答问题所需的全部关键信息 |
| Faithfulness | 生成答案是否严格基于检索内容(防幻觉) |
| Answer Relevancy | 生成答案与用户问题的语义关联程度 |
2. Embedding 模型微调(对比学习)
输入三元组: ,其中 为正样本, 为负样本。
- 对比损失函数: 通过优化该损失,拉近 Query 与正样本的向量距离,推远与负样本的距离。
大模型推理延迟:TTFT vs TPOT
1. 核心概念定义
| 术语 | 全称 | 含义 |
|---|---|---|
| TTFT | Time To First Token | 从用户发送请求到模型输出第一个完整 Token 所需的时间 |
| TPOT | Time Per Output Token | 生成后续每个 Token 所需的平均时间 |
2. 时间差异的根本原因
┌─────────────────────────────────────────┐
│ 首个 Token (TTFT) 的计算流程:            │
│ 1️⃣ 输入预处理:分词 → Token IDs          │
│ 2️⃣ Embedding 查找:Token → 向量表示      │
│ 3️⃣ 预填充(Prefill):                  │
│    • 对整个输入序列执行前向传播          │
│    • 计算并缓存所有位置的 K/V 状态        │
│    • 复杂度:O(n²),n 为输入长度          │
│ 4️⃣ 解码第一个输出 Token                  │
└─────────────────────────────────────────┘

┌─────────────────────────────────────────┐
│ 后续 Token (TPOT) 的计算流程:            │
│ 1️⃣ 仅处理新生成的 1 个 Token             │
│ 2️⃣ 复用已缓存的历史 K/V 状态(KV Cache) │
│ 3️⃣ 单次前向传播 → 输出下一个 Token       │
│    • 复杂度:O(1) 每步(忽略缓存增长)    │
└─────────────────────────────────────────┘
3. 典型时间范围与比值
💡 经验规律:输入越长,TTFT 增长越明显;而 TPOT 相对稳定。
4. 影响因素分析
| 因素 | 对 TTFT 的影响 | 对 TPOT 的影响 |
|---|---|---|
| 输入序列长度 | ⬆️ 显著增加(预填充复杂度 ) | ➖ 几乎无影响 |
| KV Cache 启用 | ➖ 无直接影响 | ⬇️ 大幅降低(避免重复计算) |
| 模型参数量 | ⬆️ 增加(前向计算量增大) | ⬆️ 轻微增加 |
| 解码策略(如 Beam Search) | ➖ 无影响 | ⬆️ 增加(多候选并行计算) |
| 硬件加速(如 FlashAttention) | ⬇️ 降低显存带宽瓶颈 | ⬇️ 同样受益 |